Cómo clasificamos los modelos para SillyTavern
La evidencia principal es el September 2026 AI Roleplay Bench, que evaluó 14 modelos oficiales en 10 categorías y calificó 840 respuestas. Sus categorías cubren chat de compañía, comportamiento de Game Master, voz estricta del personaje, villanos, robustez, temas maduros y límites de seguridad. Kimi K3, GLM-5.3 y DeepSeek V4.1 Flash están separados por menos de dos puntos, por lo que el benchmark mismo aconseja interpretarlos como un empate técnico en lugar de tratar un decimal como una victoria decisiva.
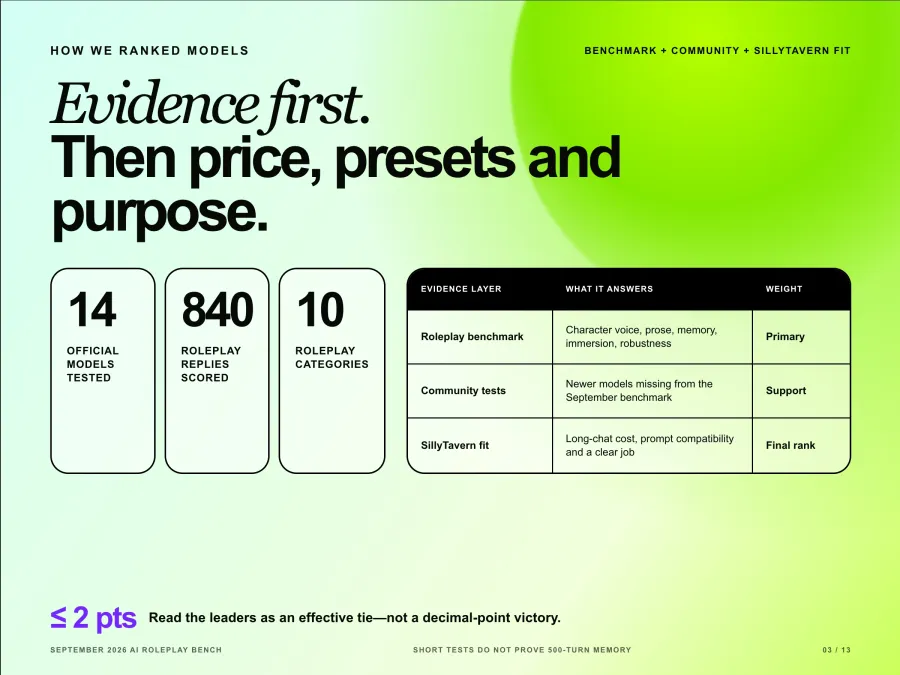
El benchmark también tiene límites. Su metodología publicada utiliza escenarios cortos de múltiples turnos, no mide la deriva a lo largo de cientos de mensajes y excluye los ajustes finos de la comunidad. Lanzamientos más recientes como Gemini 4 Argon también llegaron después de esa prueba. Para esos modelos, utilizo comparaciones de la comunidad como evidencia de respaldo y marco la recomendación como menos certera.
La clasificación final añade tres factores específicos de SillyTavern:
Economía de chats largos. Los tokens de entrada suelen dominar los turnos posteriores porque SillyTavern envía nuevamente la tarjeta del personaje, las instrucciones, la historia relevante y el historial de la conversación.
Compatibilidad con prompts y ajustes preestablecidos. Chat Completion, Text Completion, plantillas de instrucciones, muestreadores y controles de razonamiento no son intercambiables.
Un trabajo claro para cada modelo. Un modelo más económico solo se gana su lugar si tiene un rol útil, no simplemente porque su precio sea bajo.
Los 8 mejores modelos de IA para el juego de rol en SillyTavern
1 Kimi K3: El mejor modelo general para SillyTavern
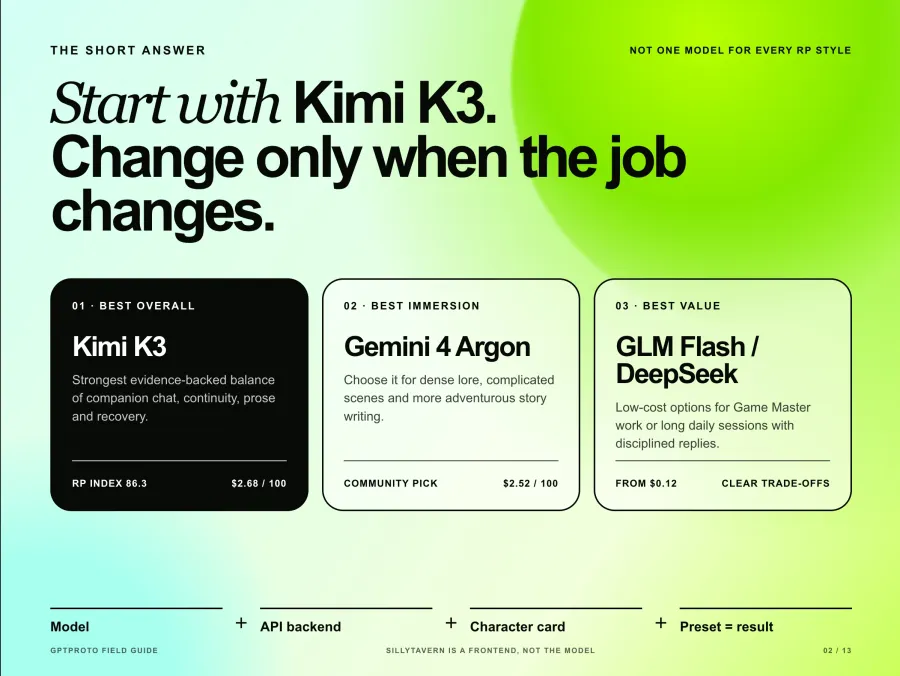
Kimi K3 es la primera opción más segura cuando aún no sabes qué estilo de juego de rol prefieres. Obtuvo 86.3 en general, 90.0 en Compañía y 88.3 en Robustez en el benchmark de juego de rol. También lideró las calificaciones del benchmark en cuanto a personaje, prosa, memoria e inmersión.
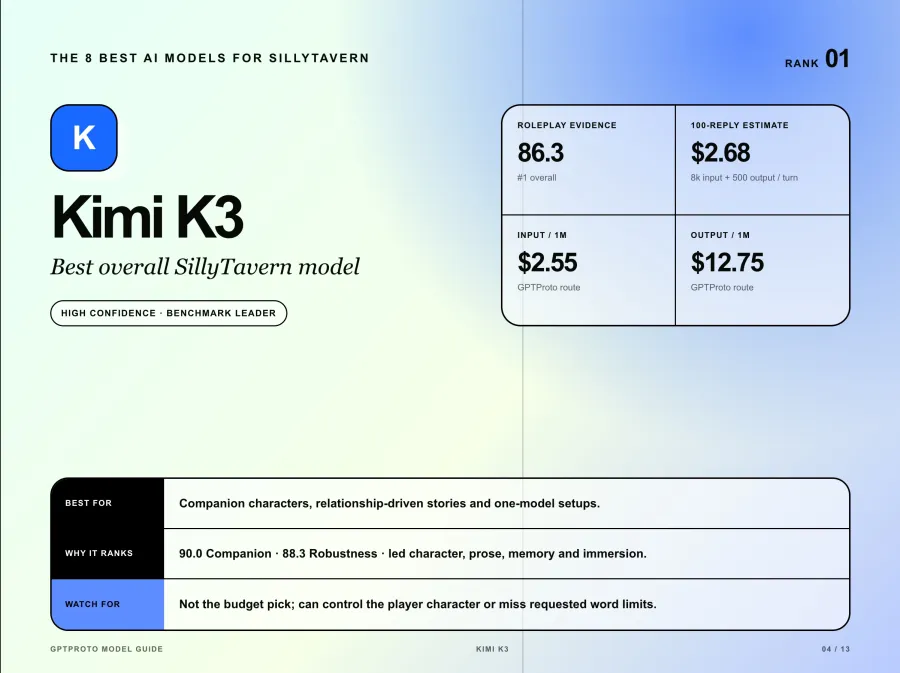
Ese equilibrio importa más en SillyTavern que una sola respuesta llamativa. Kimi manejó mensajes de usuario de una sola palabra, recordó detalles plantados y mantuvo al personaje activo en lugar de convertirse en un asistente genérico. Sus debilidades fueron concretas: a veces controlaba al personaje del jugador como Game Master e ignoraba los límites de palabras solicitados.
Mejor uso: personajes de compañía, historias impulsadas por relaciones y usuarios que desean un solo modelo para varios estilos de juego de rol. Punto de partida en SillyTavern: usa Chat Completion, el ID de modelo exacto kimi-k3 y una longitud de respuesta moderada antes de añadir reglas preestablecidas más complejas. A $2.55 por entrada y $12.75 por salida por cada millón de tokens, no es la opción económica.
2 Gemini 4 Argon: El mejor para juegos de rol inmersivos
Gemini 4 Argon es el favorito reciente más sólido de la comunidad para historias densas, escenas complicadas y escritura de relatos largos. Los usuarios de SillyTavern han elogiado su precisión con prompts extensos y su capacidad para añadir detalles útiles a la escena en lugar de limitarse a parafrasear la tarjeta del personaje. Una discusión detallada de la comunidad sobre el uso en historias largas describió una mejora clara después de que la misma historia se volviera monótona en otros modelos.
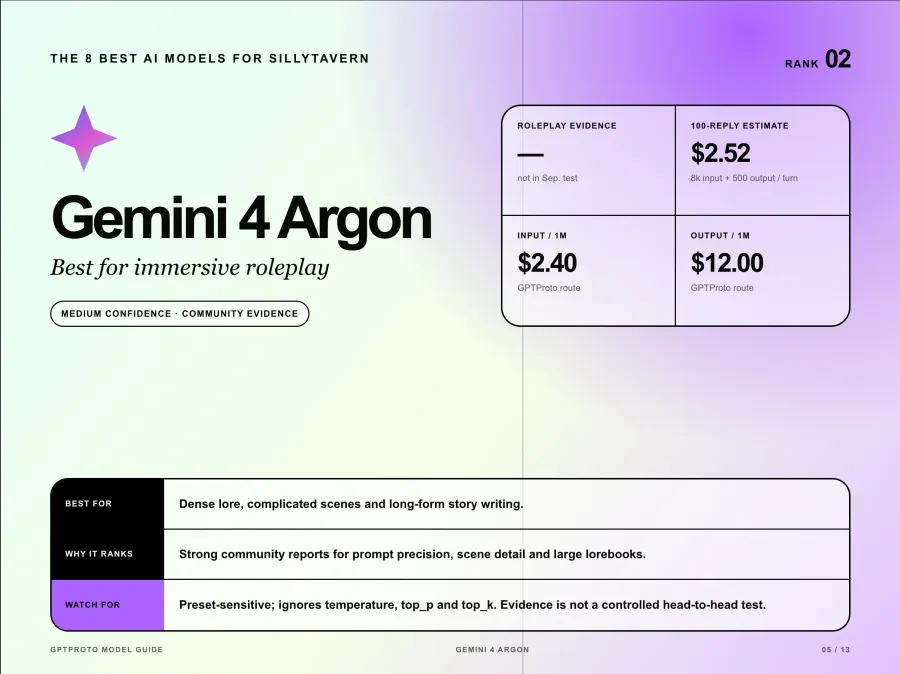
El nivel de confianza es menor que para Kimi o GLM porque Argon no se incluyó en la evaluación comparativa de juegos de rol de septiembre. El entusiasmo de la comunidad es una prueba, pero no es una prueba controlada comparativa.
Argon también necesita su propio ajuste preestablecido. Su API ignora temperature, top_p y top_k, por lo que copiar un ajuste preestablecido de Gemini antiguo cargado de muestreadores crea la ilusión de control sin cambiar esos valores. Comienza con un nivel de razonamiento medio para chats de personajes uno a uno y prueba el razonamiento alto solo para juegos de rol con muchas reglas o libros de lore extensos. La desventaja es el costo: sus tarifas de $2.40 por entrada y $12 por salida sitúan una prueba fija de 100 respuestas cerca de los $2.52 antes de que el historial se expanda.
3 GLM 5.3: El mejor modelo equilibrado para historias
GLM-5.3 es la alternativa más convincente a Kimi K3 cuando quieres que el modelo lleve el peso de la historia. Obtuvo 85.1 en general, 92.5 en Voz Estricta y 85.8 en Robustez. La evaluación lo describe como particularmente efectivo para juegos de rol basados en historias, ficción oscura y bots de aventura.
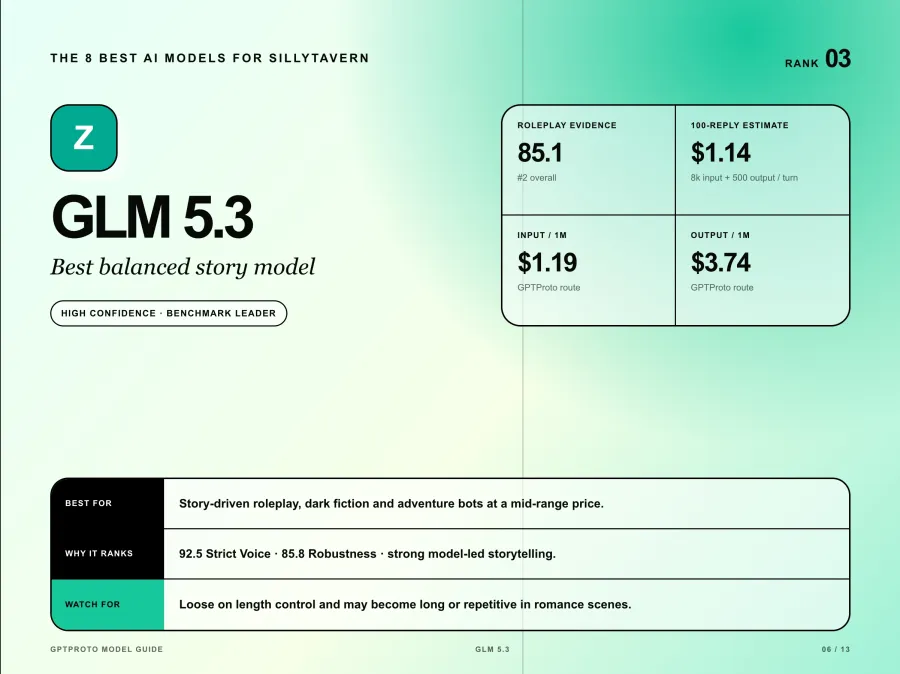
El compromiso es el control sobre la longitud y el ritmo. GLM-5.3 fue el más flexible de los modelos líderes en cuanto a límites de palabras y tuvo un desempeño mucho peor en el escenario de romance de la evaluación, donde las respuestas se volvieron largas y repetitivas. Una longitud máxima de respuesta estricta y una instrucción clara sobre el historial ayudan, pero no garantizan una salida concisa.
A $1.19 por entrada y $3.74 por salida por millón de tokens, GLM-5.3 cuesta menos de la mitad que Kimi K3 en el ejemplo fijo de 100 respuestas. Usa el ID de modelo glm-5.3. Es una opción predeterminada sensata para los usuarios que desean una gran calidad en juegos de rol sin pagar tarifas de modelos premium en cada turno.
4 DeepSeek V4.1 Flash: La mejor opción para sesiones largas y económicas
DeepSeek V4.1 Flash ofrece la mejor relación calidad-costo de la lista. Obtuvo una puntuación general de 84.4, se mantuvo dentro del límite de palabras en las 28 de 28 respuestas de juego de rol principales y empató en el primer lugar en la categoría de Villano. Sus tarifas de $0.24 por entrada y $0.96 por salida sitúan el ejemplo fijo de 100 respuestas en aproximadamente $0.24.
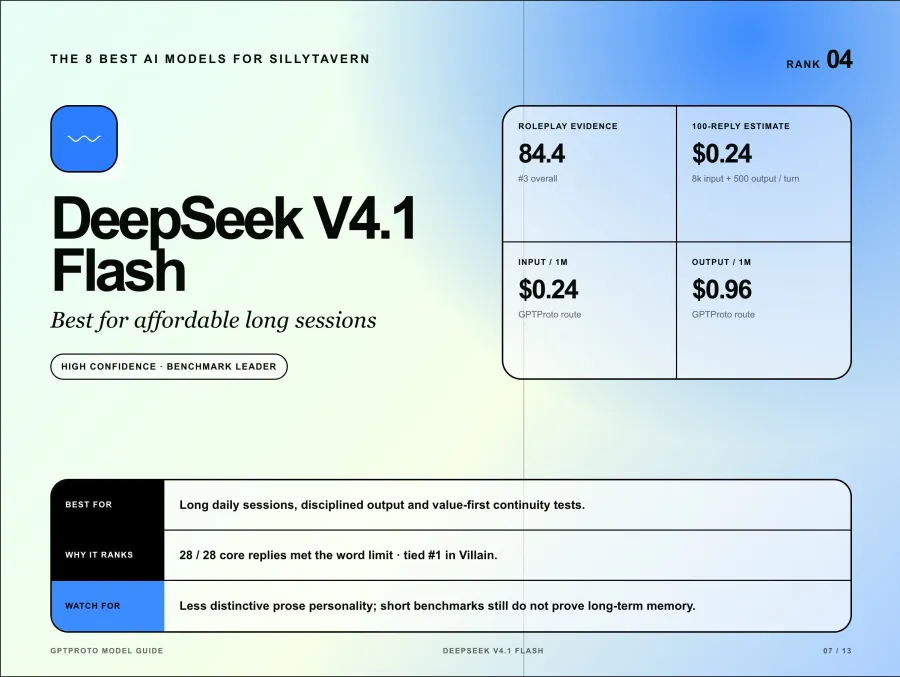
El modelo es menos distintivo como estilista de prosa que Kimi, Argon u Opus. Eso puede ser una ventaja cuando la tarjeta de personaje ya contiene una voz fuerte: es menos probable que el modelo la sobrescriba con su propio estilo característico. También es útil cuando esperas sesiones diarias largas y deseas reservar un modelo más costoso para escenas fundamentales.
Usa deepseek-flash en SillyTavern. Mi opinión es que esta es la mejor prueba de valor inicial para chats de larga duración, pero el benchmark aún utilizó escenarios cortos. Deberías realizar tu propia prueba de continuidad de 30 a 50 turnos antes de considerar que su bajo precio es prueba de una memoria a largo plazo.
5 GLM 5.3 Flash: El mejor Game Master económico
GLM-5.3 Flash es el especialista en presupuesto. Obtuvo 89.2 como Game Master y 98.3 en Voz Estricta, la puntuación individual más alta en el benchmark de septiembre. A $0.1275 por entrada y $0.425 por salida por millón de tokens, el ejemplo fijo de 100 respuestas cuesta aproximadamente $0.12.
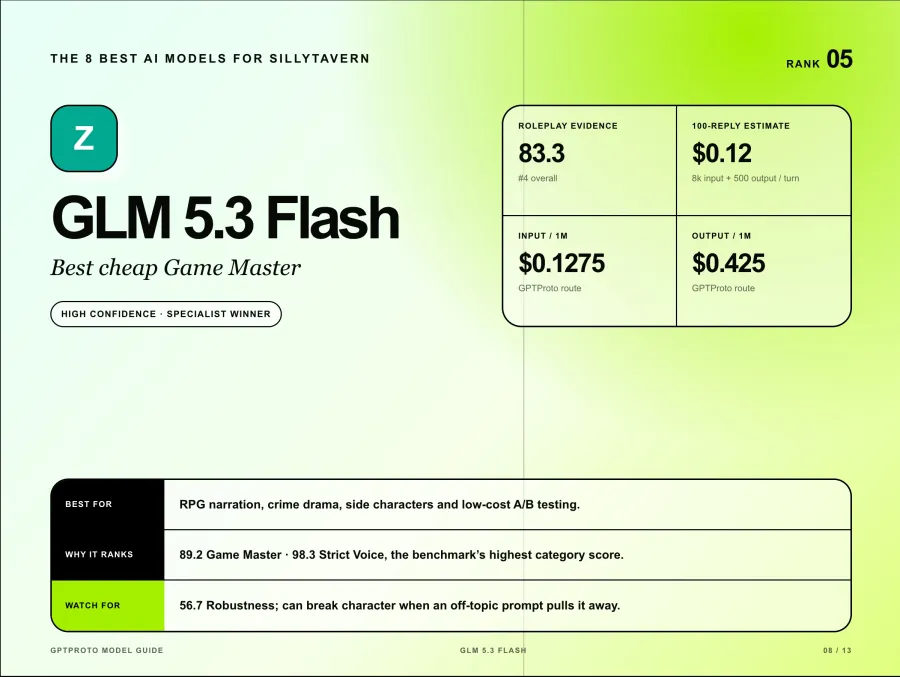
Su punto débil es igual de importante. GLM-5.3 Flash obtuvo solo 56.7 en Robustez tras romper el personaje para responder a una solicitud fuera de tema como un asistente general. También excedió más límites de palabras en el juego de rol principal que los otros líderes.
Elígelo para narración de RPG, dramas criminales, personajes secundarios o pruebas A/B económicas. No asumas que el bajo precio lo convierte en el mejor modelo de compañía. En SillyTavern, mantén las reglas del personaje cerca del final del prompt y prueba intentos deliberados de descarrilamiento antes de comprometerte a un chat largo con él. El ID del modelo es glm-5.3-flash.
6 Gemini 3.8 Flash: El mejor modelo rápido para el día a día
Gemini 3.8 Flash merece un lugar destacado en esta lista en lugar de una mención pasajera. Un benchmark de juego de rol de la comunidad reciente probó hasta 64 respuestas por modelo en ocho capítulos y le otorgó a Gemini 3.8 Flash una puntuación de calidad de 91.9. Esa prueba ponderó la preferencia de escritura en un 75 por ciento y la robustez en un 25 por ciento. Es una evidencia útil, pero su puntuación no es directamente comparable con AI Roleplay Bench porque los prompts y el método de puntuación difieren.
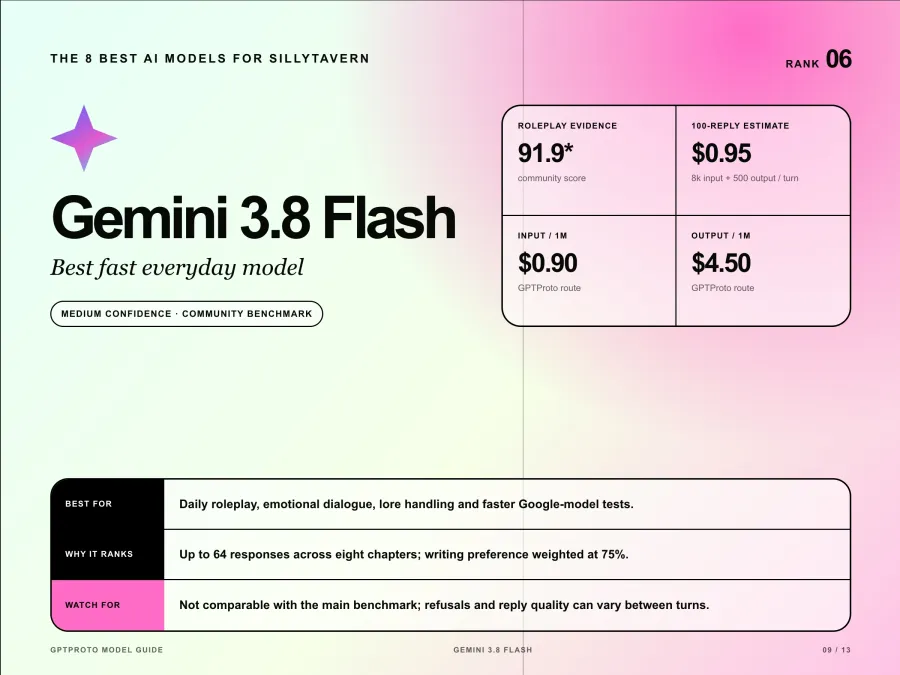
Los informes de la comunidad también elogian su diálogo emocional, el manejo de la historia y el ritmo conversacional. El punto débil es la consistencia: algunos usuarios reportan rechazos aleatorios o respuestas irregulares, incluso cuando los turnos anteriores funcionan bien.
Usa gemini-3.8-flash y comienza con un nivel de razonamiento medio. Sus tarifas de $0.90 por entrada y $4.50 por salida lo hacen mucho más económico que Argon, aunque el ejemplo fijo de 100 respuestas sigue costando alrededor de $0.95. Elígelo cuando quieras un modelo de Google para uso diario pero no necesites el razonamiento premium de Argon en cada turno.
7 Claude Opus 5.5: El mejor modelo de prosa premium
Claude Opus 5.5 es la opción premium para prosa, no el ganador universal. Los usuarios que lo prefieren destacan su conciencia espacial, conocimiento del mundo, ritmo y la capacidad de hacer que un entorno se sienta activo. Un informe detallado de la comunidad de SillyTavern lo recomienda para juegos de rol de historia general, sugiriendo cambiar de modelo cuando una escena requiera un manejo de contenido diferente.
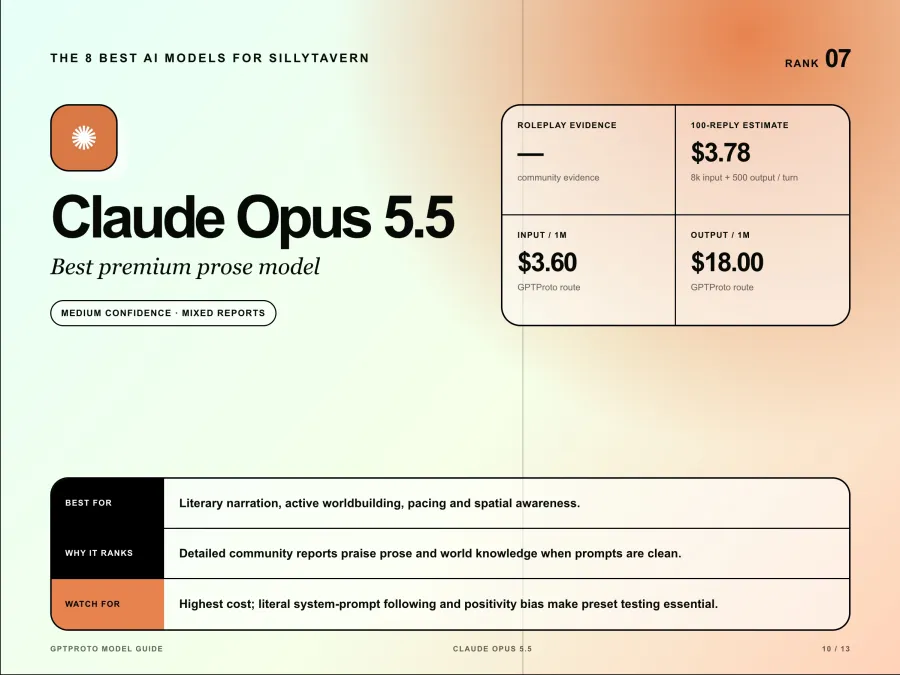
Otros usuarios reportan que Opus sigue los prompts del sistema tan literalmente que las instrucciones contradictorias en una tarjeta de personaje o preajuste pueden distorsionar al personaje. El sesgo de positividad es otra queja recurrente. Esa división explica por qué no lo clasificaría por encima de los líderes del benchmark sin probar la tarjeta exacta.
El precio es la desventaja más clara: $3.60 por entrada y $18 por salida por millón de tokens, o alrededor de $3.78 en el ejemplo fijo de 100 respuestas. Usa claude-opus-5-5, comienza con un prompt limpio y elimina las reglas de preajuste heredadas que no puedas explicar. Vale la pena probar Opus para la narración literaria. Es difícil justificarlo para chats casuales de alto volumen.
8 GPT 6 Luna: El mejor modelo GPT ultra económico
GPT-6 Luna es la razón por la que GPT no debería faltar en una guía de SillyTavern, aunque no sea el mejor modelo de juego de rol en general. Luna obtuvo una puntuación de 71.1 en total, muy por debajo de los cuatro líderes de referencia, con 68.3 en Compañero, 60.0 en Voz estricta y 54.2 en Robustez. Su cautela lo sacaba repetidamente de la ficción.
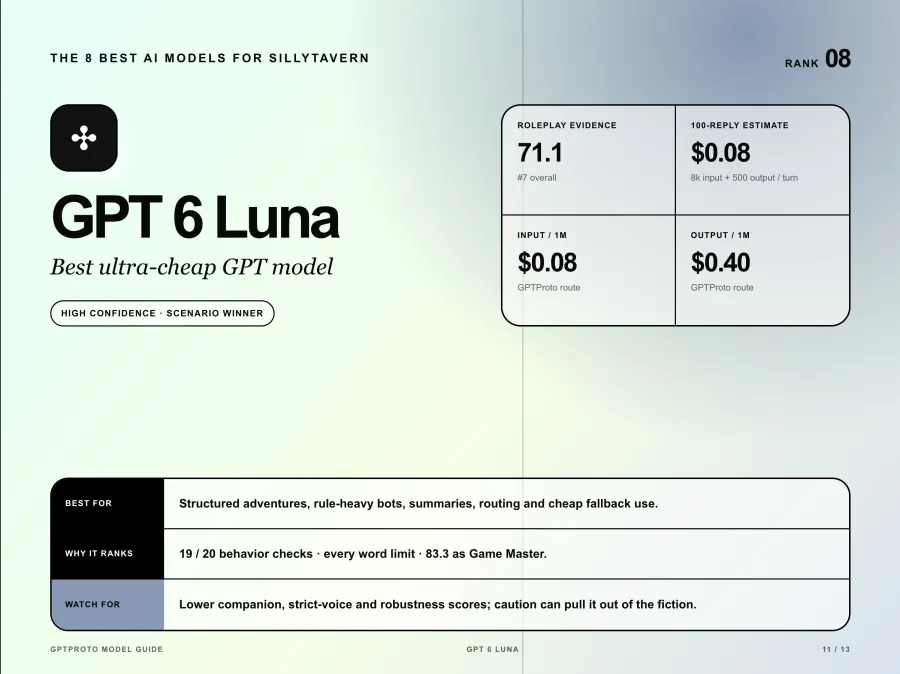
La otra mitad del resultado es útil. GPT-6 Luna superó 19 de 20 comprobaciones de comportamiento, cumplió con todos los límites de palabras probados y obtuvo 83.3 como Game Master. A $0.08 de entrada y $0.40 de salida por millón de tokens, el ejemplo fijo de 100 respuestas cuesta alrededor de ocho centavos.
Usa gpt-6-luna para aventuras estructuradas, bots con reglas estrictas, resúmenes, enrutamiento o como una alternativa económica. No lo elijas por encima de Kimi, GLM o Gemini cuando el objetivo principal sea la inmersión emocional. Este es un ganador en escenarios específicos, no una afirmación disfrazada de que el séptimo modelo del benchmark sea el mejor en general.
Por qué no hay más modelos de GPT, Claude y Gemini
Una clasificación útil no debería reservar el mismo espacio para cada proveedor. Cada modelo adicional necesita evidencia sólida de juego de rol o una función claramente diferente.
| Familia de modelos |
Elección de la lista principal |
Otro modelo que vale la pena probar |
Por qué la alternativa no está clasificada por separado |
| GPT |
GPT-6 Luna |
GPT-6.1 Terra a $0.80 / $4.00 |
Terra tiene precios atractivos y capacidad de escritura general, pero aún no tiene un benchmark de juego de rol comparable |
| Claude |
Claude Opus 5.5 |
Claude Sonnet 5.5 a $1.80 / $9.00 |
Es una opción de Claude más barata, pero la evidencia actual específica para juegos de rol es demasiado escasa para declararlo un ganador por separado |
| Claude |
Claude Opus 5.5 |
Claude Haiku 5.5 a $0.09 / $0.45 |
Haiku está posicionado para trabajo ligero de alto volumen; el bajo precio por sí solo no garantiza una prosa sólida o consistencia en sesiones largas |
| Gemini |
Gemini 4 Argon y 3.8 Flash |
Variantes de Gemini Flash Lite |
Los modelos Lite más baratos carecen de la misma evidencia comunitaria específica para juegos de rol |
| Kimi |
Kimi K3 |
Kimi K3.1 Pro a $2.00 / $10.00 |
Es más nuevo y prometedor, pero no ha reemplazado a K3 en el benchmark especializado |
Esta es también la razón por la que GPT-6 Luna ocupa el octavo lugar en lugar de desaparecer. Tiene evidencia para una función específica. Es posible que Terra lo supere más adelante, pero hacer esa afirmación ahora confundiría la capacidad general con el rendimiento probado en juegos de rol.
El mejor modelo local para SillyTavern según la VRAM
Ejecutar SillyTavern de forma local no significa que el modelo de lenguaje sea local. La interfaz en sí tiene requisitos modestos, mientras que la inferencia local necesita suficiente memoria de GPU para los pesos del modelo y el caché de contexto. La descripción general oficial de SillyTavern recomienda al menos 6 GB de VRAM como punto de partida para la inferencia local.
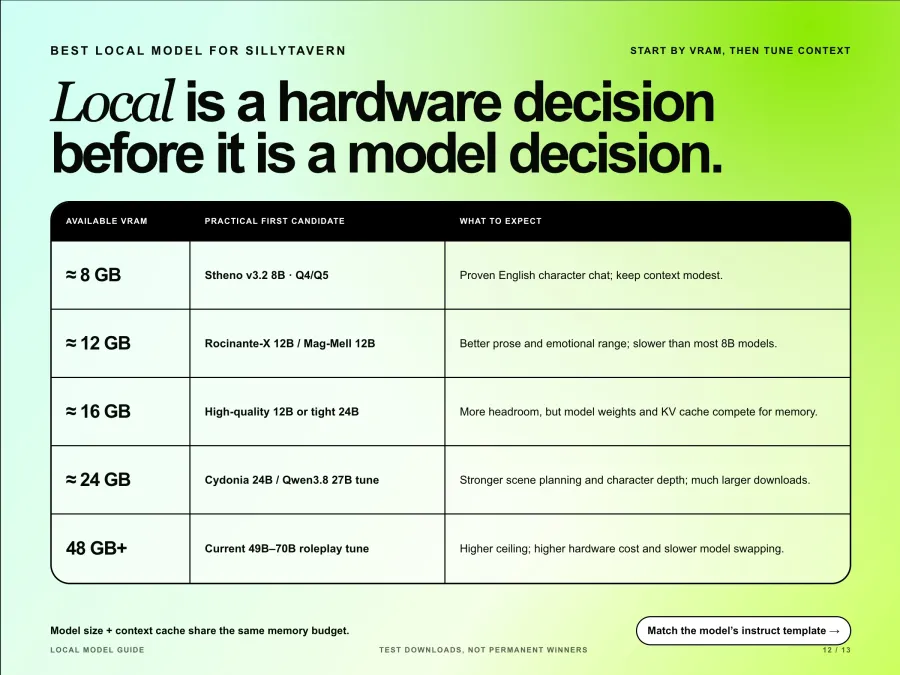
Las recomendaciones de modelos locales cambian rápidamente, así que considéralas como primeras descargas para probar en lugar de ganadores permanentes. El directorio de modelos de juego de rol de Hugging Face actual contiene miles de variantes de la comunidad con plantillas y cuantizaciones muy diferentes.
| VRAM disponible |
Primer candidato práctico |
Qué esperar |
| Aproximadamente 8 GB |
Stheno v3.2 8B en Q4 o Q5 |
Un punto de entrada probado para el chat de personajes en inglés, pero el contexto debe mantenerse modesto |
| Aproximadamente 12 GB |
Rocinante-X 12B o Mag-Mell 12B |
Mejor prosa y rango emocional que la mayoría de los modelos de 8B, con una generación más lenta |
| Aproximadamente 16 GB |
Una cuantización de 12B de mayor calidad, o un modelo de 24B con contexto corto y descarga parcial |
Más margen de calidad, pero que un archivo de modelo quepa en la VRAM no garantiza que quepa un caché KV grande |
| Aproximadamente 24 GB |
Cydonia 24B o un ajuste de juego de rol Qwen3.8 27B |
Mejor planificación de escenas y profundidad de personajes, con descargas mucho más grandes |
| 48 GB en adelante |
Un ajuste de juego de rol actual de 49B a 70B |
Techo más alto, pero con un costo de hardware elevado y un intercambio de modelos mucho más lento |
Para tarjetas de 8 GB, el compromiso central es simple: el tamaño del modelo y el contexto compiten por la misma memoria. Comienza con un contexto más pequeño, confirma la voz del personaje y luego aumenta el límite mientras observas la VRAM y la velocidad de generación.
Para los backends de finalización de texto local, selecciona la plantilla de instrucciones real del modelo. La documentación del Modo Instruct de SillyTavern advierte que la plantilla elegida debe coincidir con el formato esperado por el modelo. Un ajuste fino sólido con la plantilla incorrecta puede verse peor que un modelo más pequeño configurado correctamente.
El mejor modelo para juegos de rol a largo plazo
Kimi K3 es la opción con mayor respaldo para la continuidad de personajes a largo plazo, mientras que DeepSeek V4.1 Flash es la opción más económica cuando el historial se vuelve costoso. Gemini 4 Argon es atractivo para libros de lore extensos, pero una ventana de un millón de tokens no debe confundirse con una memoria confiable.
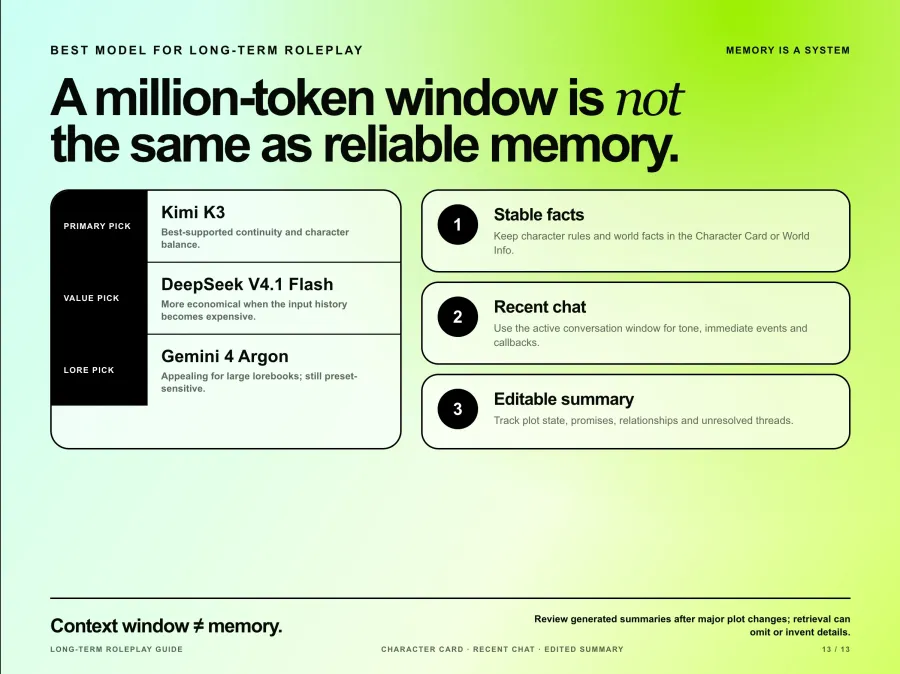
La documentación de contexto de SillyTavern explica que solo los mensajes dentro del rango de contexto activo se envían al modelo. La información del personaje, los prompts del sistema, la información del mundo (World Info), los resúmenes y el espacio de respuesta consumen ese mismo presupuesto. Una vez que los mensajes antiguos quedan fuera de este rango, el modelo no puede recordarlos a menos que vuelvas a insertar los hechos relevantes.
Utiliza tres capas en lugar de depender únicamente del tamaño del contexto:
Mantén los hechos estables del personaje y las reglas del mundo en la tarjeta del personaje o en la World Info.
Usa el historial de chat reciente para el tono y los eventos inmediatos.
Mantén un resumen breve y editable para el estado de la trama, las relaciones, las promesas y los hilos sin resolver.
La extensión de resumen (Summarize) puede automatizar la tercera capa, pero su propia documentación advierte que los resúmenes generados por el modelo pueden omitir detalles o inventarlos. Revisa el resumen después de cambios importantes en la trama. La vectorización de chat es experimental y puede hacer que la recuperación sea menos efectiva, por lo que debe probarse en lugar de habilitarse a ciegas.
Cómo cambiar de modelo en SillyTavern
Cambiar de modelo no elimina el chat, pero puede alterar la voz, el formato, el comportamiento ante rechazos y cómo se interpretan los mensajes anteriores. Guarda un ajuste preestablecido (preset) diferente para cada familia de modelos en lugar de forzar uno solo para GPT, Claude, Gemini y modelos locales de completado de texto.
Para GPT Proto, la configuración rápida es:
Abre API Connections en SillyTavern.
Selecciona Chat Completion y Custom OpenAI compatible.
Establece la URL base en https://gptproto.com/v1. No añadas /chat/completions; SillyTavern lo añade automáticamente.
Pega la clave API e ingresa un ID de modelo exacto como kimi-k3, glm-5.3-flash o gemini-3.8-flash.
Comienza con el procesamiento posterior del prompt (Prompt Post-Processing) configurado en None, conéctate y ejecuta Test Message.
La guía ilustrada de integración de API de SillyTavern cubre la instalación, tarjetas de personajes, capturas de pantalla y errores de conexión comunes.
Si deseas verificar la misma clave y modelo fuera de SillyTavern, esta solicitud utiliza la misma ruta compatible con OpenAI:
export GPTPROTO_API_KEY="TU_CLAVE"

curl --request POST "https://gptproto.com/v1/chat/completions" \
  --header "Authorization: Bearer $GPTPROTO_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "kimi-k3",
    "messages": [
      {"role": "user", "content": "Responde en personaje con una oración corta."}
    ],
    "max_tokens": 120
  }'
Después de cambiar, prueba al menos cinco turnos con la misma tarjeta de personaje. Incluye una respuesta corta, un prompt fuera de tema, una instrucción sobre la longitud de la respuesta y una referencia a un detalle anterior. Eso detecta más problemas que juzgar solo el mensaje inicial.
Qué modelo de SillyTavern deberías elegir
Elige Kimi K3 cuando desees una opción predeterminada respaldada por evidencia.
Elige Gemini 4 Argon para una narrativa compleja y un desarrollo de escenas inmersivo, aceptando un costo más alto y una menor certeza en los benchmarks.
Elige GLM-5.3 cuando busques un narrador sólido a un precio de gama media.
Elige DeepSeek V4.1 Flash para sesiones largas y asequibles con una salida disciplinada.
Elige GLM-5.3 Flash para una narración de RPG económica y voces de personajes estrictas.
Elige Gemini 3.8 Flash para un Gemini más rápido y barato con pruebas comunitarias alentadoras.
Elige Claude Opus 5.5 cuando la calidad de la prosa sea lo suficientemente importante como para justificar el gasto.
Elige GPT-6 Luna para el juego de rol estructurado, resúmenes o enrutamiento de respaldo más económico.
Elige un ajuste fino de juego de rol local cuando la privacidad, el uso sin conexión y la generación ilimitada sean más importantes que el tiempo de configuración y la calidad de los modelos en la nube.
Puedes comparar las señales de uso actuales y los precios de los modelos en la página de modelos de SillyTavern de GPT Proto, luego prueba el mismo personaje y el historial en diferentes modelos a través del playground de la API de juego de rol.