Si estás decidiendo entre GPT 6.1 Terra y Sonnet 5.5 hoy, aquí tienes la regla de decisión rápida que uso antes de ejecutar un benchmark:
Elige GPT-6.1 Terra si tu flujo de trabajo ejecuta inspección de capturas de pantalla de alto volumen, automatización de formularios y facturas, depuración de diseño de interfaz de usuario o tareas de codificación delimitadas donde una tarifa de $0.80/$4.00 por token y una ejecución de tareas 3 veces más rápida importan más que la profundidad de refactorización autónoma máxima, y tus entradas de solicitud única se mantienen en o por debajo de los 272K tokens.
Quédate con Claude Sonnet 5.5 si tu agente ejecuta migraciones de repositorios de múltiples archivos, depuración profunda de terminal donde una edición omitida es más costosa que la factura de tokens, o prompts de una sola pasada de entre 300K y 900K tokens donde el recargo por contexto largo de OpenAI elimina la ventaja de precio de entrada de Terra.
Puedes consultar las tarifas del catálogo en tiempo real o calcular tu volumen mensual de tokens a través del centro de comparación de modelos de GPT Proto antes de comprometerte con cualquiera de las dos opciones. Todo lo que aparece a continuación es una comparación basada en documentación y benchmarks verificada el 5 de noviembre de 2026; los benchmarks reportados por los proveedores están etiquetados por separado de las mediciones independientes de Artificial Analysis y los comentarios iniciales de los desarrolladores.
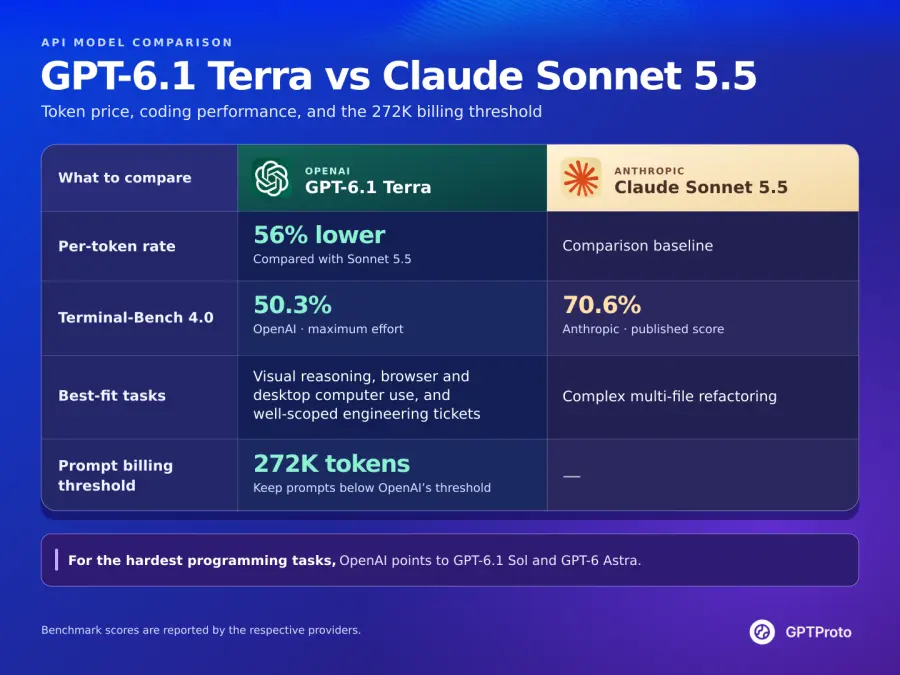
Comparativa rápida: GPT-6.1 Terra vs Claude Sonnet 5.5
Los desarrolladores que buscan información sobre ChatGPT 6.1 Terra vs Sonnet 5.5 o Anthropic Claude Sonnet 5.5 vs GPT 6.1 Terra a menudo encuentran hojas de especificaciones contradictorias porque ambos proveedores estructuran de manera diferente sus controles de razonamiento, puntos de conexión de herramientas y recargos por contexto largo. La siguiente tabla alinea ambos modelos con la documentación oficial de OpenAI gpt-6.1-terra, la descripción general de Claude Sonnet 5.5 de Anthropic y las tarifas actuales del catálogo de GPT Proto.
| Especificación |
GPT-6.1 Terra (gpt-6.1-terra) |
Claude Sonnet 5.5 (claude-sonnet-5-5) |
| Proveedor |
OpenAI |
Anthropic |
| Fecha de lanzamiento |
26 de octubre de 2026 |
28 de septiembre de 2026 |
| Entrada / salida estándar oficial (por 1M de tokens) |
$1.00 / $5.00 |
$2.00 / $10.00 |
| Entrada / salida de GPT Proto (por 1M de tokens) |
$0.80 / $4.00 (−20% vs oficial) |
$1.80 / $9.00 (−10% vs oficial) |
| Lectura de entrada en caché oficial (por 1M de tokens) |
$0.05 (5% de la entrada base) |
$0.10 (reducido de $0.20 el 7 de octubre de 2026) |
| Escritura en caché oficial (por 1M de tokens) |
$1.25 (TTL de 30m) / $2.50 (TTL de 12h) |
$2.50 (TTL de 5m) |
| Lectura / escritura en caché de GPT Proto (por 1M de tokens) |
$0.04 / $1.00 |
$0.09 / $2.25 (verificar página del modelo en vivo) |
| Ventana de contexto |
1,050,000 tokens |
1,000,000 tokens |
| Regla de precios para contexto largo |
>272K de entrada factura la solicitud completa al doble de entrada/caché y 1.5x de salida |
Tarifa plana en toda la ventana de contexto de 1M |
| Máximo de tokens de salida |
128,000 tokens |
128,000 tokens |
| Modalidades de entrada / salida |
Texto, Imagen, Documento en → Texto fuera |
Texto, Imagen, Documento en → Texto fuera |
| Fecha de corte de conocimiento |
1 de junio de 2026 |
Principios a mediados de 2026 (conserva el tokenizador de Sonnet 5) |
| Controles de razonamiento / esfuerzo |
none, low, medium (predeterminado), high, xhigh, max |
Pensamiento adaptativo activado por defecto; medium, high (predeterminado de API), max, between_tools |
| Punto de conexión requerido para llamadas a herramientas |
/v1/responses requerido por la documentación de OpenAI |
/v1/messages (nativo) o compatible con OpenAI /v1/chat/completions |
| Disponibilidad en clientes e IDE |
ChatGPT Work y Codex (no el chat normal), GitHub Copilot, Claude Code (vía API) |
Claude.ai, Claude Code, GitHub Copilot, Cursor |
| Índice de Inteligencia AA (v4.3.2) |
41 (medium) / 48 (max) |
56 (max, alternativa predeterminada) |
| Costo promedio de tarea de evaluación AA |
$0.10 (`medium`) / $0.40 (max) |
$5.46 (max, alternativa predeterminada) |
| Terminal-Bench 4.0 (reportado por el proveedor) |
50.3% (max esfuerzo) |
70.6% |
Tres filas en esa tabla hacen casi todo el trabajo cuando estás presupuestando una aplicación. Primero, en solicitudes estándar de menos de 272K tokens, GPT-6.1 Terra es un 56% más barato por token en GPT Proto tanto para entrada como para salida, por lo que las finalizaciones largas no alteran la clasificación de costos. Segundo, Sonnet 5.5 mantiene una ventaja de 20.3 puntos porcentuales en Terminal-Bench 4.0, lo cual se alinea estrechamente con el comportamiento de ambos modelos en ediciones de repositorios sin guía. Tercero, a diferencia de GPT-6.1 Sol, GPT-6.1 Terra restaura el soporte para reasoning.effort: "none", brindando a los desarrolladores de OpenAI una verdadera ruta rápida sin razonamiento nuevamente.
Desglose de precios y costos: ¿Cuál es más caro y cuál es más rentable?
Cuando los desarrolladores buscan "GPT 6.1 Terra vs Sonnet 5.5 cuál es más caro" o "cuál es más rentable", generalmente intentan reconciliar dos cifras diferentes: la tarifa por millón de tokens en la página de precios y el costo real en dólares de una tarea terminada por un agente. Esas dos proporciones no son iguales.
A nivel de token, Claude Sonnet 5.5 es el modelo con el precio más alto por un margen amplio. El precio oficial de Anthropic es de $2.00 por millón de tokens de entrada y $10.00 por millón de tokens de salida, el doble del precio de lista de $1.00/$5.00 de OpenAI para Terra. Debido a que GPT Proto aplica un descuento del 20% en GPT-6.1 Terra ($0.80 entrada / $4.00 salida) y un descuento del 10% en Claude Sonnet 5.5 ($1.80 entrada / $9.00 salida), Sonnet 5.5 cuesta 2.25 veces más por token en la plataforma. Ambos proveedores ahora fijan el precio de las lecturas de entrada en caché al 5% de la entrada base ($0.05 oficial para Terra frente a $0.10 oficial para Sonnet 5.5 después de que Anthropic redujo a la mitad el precio de lectura de caché de Sonnet en octubre de 2026), y ambos cobran 1.25 veces la entrada base por escrituras de caché estándar ($1.25 frente a $2.50 oficial). Ten en cuenta que un prompt largo de un solo uso escrito en caché en realidad añade un recargo del 25% en cualquiera de los modelos si nunca vuelves a leer ese prefijo.
A nivel de tarea, la brecha se vuelve mucho más pronunciada. En el Intelligence Index v4.3.2 de Artificial Analysis (publicado el 26-27 de octubre de 2026), la configuración de Claude Sonnet 5.5 (max effort con Default Fallback) probada registró un costo promedio ponderado de $5.46 por tarea de evaluación. En la misma suite de evaluación, [GPT-6.1 Terra con esfuerzo `max`](https://artificialanalysis.ai/models/gpt-6-1-terra) promedió $0.40 por tarea, y GPT-6.1 Terra con esfuerzo medium promedió solo $0.10 por tarea. Esa es una diferencia de 13.6 veces con esfuerzo max y una diferencia de 54.6 veces al comparar la configuración superior de Sonnet con la configuración predeterminada medium de Terra.
¿Por qué una diferencia de 2 veces por token se convierte en una brecha de facturación de 13 a 54 veces? Los modelos de razonamiento facturan los tokens de pensamiento como tokens de salida. Cuando Sonnet 5.5 funciona con esfuerzo alto o máximo en un benchmark abierto, genera largas cadenas de razonamiento a $10.00 por millón de tokens ($9.00 en GPT Proto). El anuncio de Terra también señala que, con esfuerzo máximo en el Agents' Last Exam, Terra utilizó menos de un tercio de los tokens que Claude Opus 5.5. Aún más importante es el hallazgo de la frontera de Pareto de Artificial Analysis: para GPT-6.1 Terra, los ajustes de esfuerzo low y medium son óptimos en el sentido de Pareto para la relación entre inteligencia y costo. Subir Terra a max eleva su puntuación de 41 a 48, lo que empata con GPT-6.1 Sol con esfuerzo medium, excepto que Sol medium cuesta $0.21 por tarea, mientras que Terra `max` cuesta $0.40. En resumen, si deseas la configuración más rentable en Terra, mantenla en low o medium; si una tarea es lo suficientemente difícil como para exigir esfuerzo max, ya deberías estar probando Sol o Sonnet 5.5.
Cálculo de costos reales: dos escenarios de producción
Para ver dónde realmente vale la pena la tarifa de tokens más económica (y dónde resulta contraproducente), hagamos el cálculo exacto con las tarifas del catálogo en vivo de GPT Proto ($0.80/$4.00 para Terra; $1.80/$9.00 para Sonnet 5.5), asumiendo solicitudes sin caché de menos de 272K tokens.
El Escenario A es un ciclo de agente de control de calidad visual y extracción de formularios de 20 pasos. Cada paso envía una captura de pantalla y un fragmento de DOM que suman 15,000 tokens de entrada y genera 1,500 tokens de salida (incluyendo medium tokens de razonamiento). En 20 pasos, un solo flujo de trabajo consume 300,000 tokens de entrada (0.3M) y 30,000 tokens de salida (0.03M):
GPT-6.1 Terra en GPT Proto: (0.3 * $0.80) + (0.03 * $4.00) = $0.24 + $0.12 = $0.36 por flujo de trabajo.
Claude Sonnet 5.5 en GPT Proto: (0.3 * $1.80) + (0.03 * $9.00) = $0.54 + $0.27 = $0.81 por flujo de trabajo.
Con 10,000 flujos de trabajo al mes, Terra cuesta $3,600 frente a los $8,100 de Sonnet, un ahorro mensual de $4,500. Incluso si Terra falla la validación en el 20% de sus ejecuciones y tiene que reintentar esos 2,000 flujos de trabajo desde cero (añadiendo $720), tu factura total es de $4,320, lo que sigue ahorrando $3,780 al mes en comparación con una ejecución de Sonnet sin reintentos.
El Escenario B es una refactorización de backend de múltiples archivos en una solicitud de extracción (pull request) activa. Supongamos que cada intento lee 80,000 tokens de entrada y emite 10,000 tokens de salida. Una pasada limpia en Sonnet 5.5 cuesta (0.08 * $1.80) + (0.01 * $9.00) = $0.234. Una pasada en Terra cuesta (0.08 * $0.80) + (0.01 * $4.00) = $0.104. Ahorras 13 centavos en la llamada a la API. El problema es que si Terra pasa por alto una dependencia de tipo entre módulos (lo cual coincide con su brecha de 50.3% frente a 70.6% en Terminal-Bench) y fuerza tres reintentos más 12 minutos del tiempo de un ingeniero senior a $90/hora ($18.00 de mano de obra), ese ahorro de 13 centavos en tokens le acaba de costar a tu equipo $18.18. En una frase: Terra gana abrumadoramente en ciclos repetibles y verificables por máquina, mientras que Sonnet 5.5 justifica su tarifa más alta cada vez que una edición fallida consume tiempo de revisión humana.
Contexto de ventana (1.05M vs 1M): Por qué superar los 272K cambia la factura
En teoría, la comparación del contexto de ventana de GPT 6.1 Terra vs Sonnet 5.5 parece un empate técnico con una ligera ventaja para OpenAI: Terra acepta 1,050,000 tokens de entrada y emite hasta 128,000 tokens de salida, mientras que Claude Sonnet 5.5 acepta 1,000,000 de tokens de entrada y emite hasta 128,000 tokens de salida. La mayoría de las tablas comparativas se detienen ahí.
Sin embargo, si lees la documentación del modelo gpt-6.1-terra de OpenAI, existe un límite de facturación en los 272,000 tokens de entrada que cambia por completo la economía del contexto largo. Siempre que un prompt supera los 272K tokens de entrada en GPT-6.1 Terra, OpenAI factura toda la solicitud —no solo los tokens por encima de 272K— al doble de las tarifas de entrada y caché, y a 1.5 veces la tarifa de salida.
Esto es lo que sucede con la tarifa oficial por millón de tokens en el momento en que tu prompt pasa de 272,000 tokens a 272,001 tokens:
| Rango de contexto |
GPT-6.1 Terra (Tarifa oficial) |
Claude Sonnet 5.5 (Tarifa oficial) |
Relación de precio de entrada |
| Prompt estándar (≤272K tokens de entrada) |
$1.00 entrada / $5.00 salida / $0.05 lectura de caché |
$2.00 entrada / $10.00 salida / $0.10 lectura de caché |
Terra es 50% más barato en entrada y salida |
| Prompt de contexto largo (>272K a 1M+ tokens de entrada) |
$2.00 entrada / $7.50 salida / $0.10 lectura de caché |
$2.00 entrada / $10.00 salida / $0.10 lectura de caché |
Las tarifas de entrada y lectura de caché son idénticas ($2.00 / $0.10) |
A diferencia del modelo más pequeño Haiku 5.5 de Anthropic (que aplica un recargo de 5x por encima de los 100K tokens), Claude Sonnet 5.5 mantiene una tarifa plana en toda su ventana de contexto de 1,000,000 de tokens.
Haz el cálculo para una auditoría de repositorio de 400,000 tokens que genera 10,000 tokens de salida a las tarifas oficiales de lista:
Una vez que tu prompt supera los 272K tokens, el descuento del 50% en la entrada de Terra desaparece por completo, dejando una diferencia total de $0.025 en una llamada de 400K tokens. Mi recomendación es sencilla: nunca envíes prompts monolíticos de >272K tokens a GPT-6.1 Terra esperando una economía a mitad de precio. Ya sea que fragmentes/recuperes tu contexto por debajo de los 272K tokens para que Terra se mantenga en su rango de $1.00 ($0.80 GPT Proto), o que dirijas los volcados de repositorio de 300K–900K directamente a Claude Sonnet 5.5, donde pagas la misma tarifa oficial de entrada y obtienes una mejor comprensión de código a largo plazo. (Antes de ejecutar prompts de >272K en producción a través de GPT Proto, confirma con el soporte de la plataforma cómo se refleja el ajuste de nivel de 272K en el saldo de tu cuenta.)
Benchmarks y comentarios de la comunidad: Programación, frontend y trabajo con agentes
Las puntuaciones compuestas de los titulares ocultan dónde tiene éxito realmente cada modelo. En el Artificial Analysis Intelligence Index v4.3.2, Claude Sonnet 5.5 (max, Default Fallback) obtiene 56 puntos, GPT-6.1 Sol (max) obtiene 52, y GPT-6.1 Terra obtiene 48 con esfuerzo max y 41 con esfuerzo medium. (En la instantánea del índice del 3 de noviembre de 2026 que se muestra en la tarjeta de comparación de GPT Proto, Sonnet 5.5 registra 54.2 y Terra max registra 51: una diferencia más estrecha de 3.2 puntos que aún favorece a Sonnet). Para tomar una decisión de enrutamiento práctica para código, interfaz de usuario (frontend) o bucles de agentes, tenemos que desglosar esos agregados por tipo de tarea y compararlos con lo que los desarrolladores reportan en el uso real.
1. Programación de backend y terminal (GPT 6.1 Terra vs Sonnet 5.5 para código)
Para la ingeniería de software pura desde la línea de comandos, Anthropic sigue manteniendo una clara ventaja. En Terminal-Bench 4.0, Anthropic reporta un 70.6% para Claude Sonnet 5.5 (frente al 10.3% de Sonnet 5), mientras que OpenAI reporta un 50.3% para GPT-6.1 Terra en esfuerzo máximo (frente al 21.5% de GPT-5.6 Terra). En el recién publicado Coding Agent Index v2.0 de Artificial Analysis, Terra obtiene una puntuación de 48, 17 puntos por delante del ligero GPT-6 Luna (31), pero 6 puntos por detrás de GPT-6.1 Sol (54). Artificial Analysis también señala que, específicamente para agentes de programación, los ajustes de esfuerzo bajo y xalto de Terra se sitúan en la frontera de la rentabilidad, mientras que otros ajustes de esfuerzo se quedan atrás.
Las primeras pruebas en el mundo real señalan el límite exacto entre ambos modelos:
El registro de cambios de la versión del 26 de octubre de 2026 de GitHub Copilot informó que, en las primeras pruebas internas, GPT-6.1 Terra resolvió notablemente más tareas de terminal y programación en C# que GPT-5.6 Terra, añadiendo una observación conductual crucial: "Trabaja en pasos enfocados y consolidados en tareas bien definidas." GitHub no publicó los porcentajes brutos de tasa de éxito en esa nota, por lo que debe tratarse como un hallazgo cualitativo de la plataforma en lugar de un benchmark controlado.
Por parte de Claude, una prueba comparativa temprana de desarrolladores en r/ClaudeAI (ejecutando diez tareas de programación personales tres veces por configuración con esfuerzo alto en Claude Code y pi-agent) encontró que Sonnet 5.5 completó consistentemente las implementaciones en menos turnos de conversación y menos tokens de salida que su predecesor, en gran parte porque Sonnet 5.5 procesa llamadas a herramientas en paralelo de forma más agresiva. Del mismo modo, en la evaluación externa CursorBench 4.0 de Cursor, Sonnet 5.5 con esfuerzo alto obtuvo un 47.8% a un costo de $1.67 por tarea.
La conclusión para los desarrolladores de backend: si el ticket está bien definido (escribir un método de servicio en C#, añadir una prueba unitaria o corregir un script de CLI aislado), Terra con esfuerzo bajo o medio lo terminará rápidamente a menos de la mitad del precio por token. Si el ticket requiere rastrear el estado a través de diez archivos donde un bucle de reintento adicional arruina el flujo de trabajo, la competencia terminal del 70.6% de Sonnet 5.5 justifica la tarifa más alta. Cuando se trata de computación científica, OpenAI también informa que en Terminal-Bench-Science 0.1 (como escribir código para rastrear divisiones celulares en videos de lapso de tiempo), Terra con esfuerzo máximo supera a GPT-6.1 Sol y se queda a cinco puntos de Claude Opus 5.5 a menos de una quinta parte del costo estimado.
2. GPT-6.1 Terra vs Sonnet 5.5 para programación frontend
Buscar GPT 6.1 Terra vs Sonnet 5.5 para programación frontend merece su propia respuesta porque la ingeniería frontend son dos trabajos diferentes unidos: el trabajo de diseño visual/DOM y la lógica de estado/arquitectura.
Cuando OpenAI presentó la puntuación del 50.3% de GPT-6.1 Terra en Terminal-Bench 4.0, el único ejemplo de codificación concreto que destacó en el anuncio fue un error de frontend: "corregir una página web cuyo diseño se desplaza mientras se carga" (Cumulative Layout Shift, o CLS). Al mismo tiempo, OpenAI informó que en MMMU-Pro —un benchmark para el razonamiento visual sobre diagramas, capturas de pantalla y diseños densos—, GPT-6.1 Terra supera a GPT-5.6 Terra en todos los niveles de esfuerzo y casi iguala a los modelos de frontera GPT-6 Astra y GPT-6.1 Sol a una fracción del costo. En el hilo del día de lanzamiento en el foro de la Comunidad de Desarrolladores de OpenAI, una de las primeras reacciones de los desarrolladores resumió a Terra como "una gran relación calidad-precio, especialmente en lo que respecta a la comprensión visual. También es decente en programación."
Esa división ofrece a los equipos de frontend una clara distribución del trabajo:
Usa GPT-6.1 Terra para el trabajo de frontend visual y de capa de interfaz de usuario: convertir capturas de pantalla de Figma o wireframes en marcado inicial de Tailwind/HTML, comparar capturas de pantalla renderizadas de Playwright con las especificaciones de diseño para detectar nodos DOM superpuestos o regresiones en puntos de interrupción móviles, y diagnosticar desplazamientos de diseño CSS. Debido a que Terra procesa imágenes de forma nativa, se ejecuta más de 3 veces más rápido que GPT-6.1 Sol y Astra en benchmarks de acción visual, y cuesta $0.80/$4.00 en GPT Proto, tu pipeline de CI puede permitirse ejecutar comprobaciones de regresión visual en cada commit.
Usa Claude Sonnet 5.5 para la arquitectura frontend con mucha lógica: refactorizar árboles de estado complejos de acciones de servidor en React/Next.js, resolver restricciones genéricas intrincadas de TypeScript o migrar un almacén de Redux heredado sin romper la hidratación. Cuando no hay una captura de pantalla que inspeccionar y la dificultad radica puramente en la coherencia del estado entre múltiples archivos, Sonnet 5.5 sigue siendo la opción más segura.
3. Trabajo agéntico, uso de computadora y veracidad (para trabajo agéntico)
Si tu definición de GPT 6.1 Terra vs Sonnet 5.5 para trabajo agéntico se centra en la automatización de interfaces gráficas (GUI), el análisis de documentos y el uso de computadoras en tareas administrativas, GPT-6.1 Terra es posiblemente el lanzamiento de mayor valor de OpenAI en 2026.
En las evaluaciones reportadas por el proveedor de OpenAI en Agents' Last Exam v1 (que pone a prueba flujos de trabajo profesionales de varios pasos, como convertir dibujos arquitectónicos en un modelo 3D o registrar códigos de tiempo toma por toma en una película animada), GPT-6.1 Terra con un esfuerzo medio obtuvo una puntuación 15 puntos porcentuales más alta que GPT-5.6 Terra a aproximadamente un tercio del costo, igualando al modelo insignia GPT-6 Astra a una décima parte del precio por token. Con un esfuerzo máximo, OpenAI informa que Terra es más de 3 veces más eficiente en tokens que Claude Opus 5.5 y cuesta 1/4 de su precio por token, lo que resulta en un costo por tarea aproximadamente 9 veces menor, mientras completa flujos de trabajo más de 3 veces más rápido que GPT-6 Astra y GPT-6.1 Sol.
En OSWorld 2.1 (control de aplicaciones de escritorio), OpenAI informa que Terra con un esfuerzo medio supera la mejor puntuación de GPT-5.6 Terra a una fracción del costo por tarea. Para mantener el equilibrio, la puntuación publicada por Anthropic en OSWorld 2.1 (fuera de línea) para Claude Sonnet 5.5 es un 83.9% muy alto (revelado en la tabla de referencia de Haiku 5.5 de Anthropic de octubre de 2026). Ambos modelos son motores de uso de computadora de primer nivel; la diferencia es que los agentes de captura de pantalla envían una captura nueva en cada clic, lo que consume tokens de entrada rápidamente y hace que la tarifa de entrada de $0.80/M GPT Proto de Terra sea mucho más fácil de mantener a escala.
Igual de importante para los agentes autónomos es saber cuándo el modelo no sabe algo. En el benchmark AA-Omniscience independiente de Artificial Analysis, la tasa de alucinación de GPT-6.1 Terra (la frecuencia con la que el modelo adivina cuando carece de conocimiento) cayó 50 puntos porcentuales —del 88% en GPT-5.6 Terra al 38%— mientras que simultáneamente ganó 2 puntos en precisión general. Esa medición independiente respalda la evaluación de veracidad interna de OpenAI (detallada más a fondo en la Tarjeta del Sistema de GPT-6.1 Terra), donde las tasas de error factual con poco esfuerzo en prompts difíciles cayeron del 53.6% al 16.7% (y hasta un 4.3% con esfuerzo máximo). Tasas de alucinación más bajas significan menos llamadas a herramientas erróneas en etapas posteriores.
Experiencia del desarrollador y dificultades de la API (GPT 6.1 Terra vs Sonnet 5.5 para desarrolladores)
Cambiar entre gpt-6.1-terra y claude-sonnet-5-5 en producción rara vez es un reemplazo de una sola línea de código. Si estás evaluando la ergonomía de GPT 6.1 Terra vs Sonnet 5.5 para desarrolladores, cuatro restricciones a nivel de API determinarán tu trabajo de integración.
Primero, GPT-6.1 Terra admite reasoning.effort: "none", mientras que GPT-6.1 Sol no lo hace. Cuando OpenAI lanzó GPT-6.1 Sol el 29 de septiembre de 2026, eliminó los niveles de razonamiento none y minimal, forzando cada solicitud a un nivel low o superior, lo que afectó a temperature y top_p en todos los ámbitos. Según la guía oficial de migración y prompts de OpenAI para gpt-6.1-terra, Terra admite todo el espectro: none, low, medium (predeterminado), high, xhigh y max. Si configuras reasoning_effort: "none", Terra se ejecuta sin generar tokens de razonamiento ocultos y permite parámetros de muestreo estándar. Sin embargo, en el momento en que utilizas low, medium, high, xhigh o max, debes eliminar temperature, top_p, top_logprobs y logprobs de la carga útil de tu solicitud, o la API rechazará la llamada con un error HTTP 400.
Segundo, OpenAI requiere la API de Respuestas (/v1/responses) para la invocación de herramientas en GPT-6.1 Terra. Si bien los prompts de texto e imagen simples funcionan en /v1/chat/completions, la documentación del modelo de OpenAI establece explícitamente que la invocación de herramientas requiere /v1/responses. Una vez en la API de Respuestas, Terra admite las nueve herramientas nativas integradas de OpenAI (búsqueda web, búsqueda de archivos, generación de imágenes, intérprete de código, shell alojado, apply_patch, habilidades, uso de computadora, MCP y búsqueda de herramientas), además de async: true en herramientas de funciones personalizadas, para que el modelo pueda seguir razonando mientras se ejecuta una herramienta lenta en segundo plano. Además, Terra admite el envío de un elemento de entrada configuration_update a mitad de la conversación para aumentar o disminuir reasoning.effort en un turno difícil sin tener que reescribir el prefijo del prompt o invalidar tu caché de prompts de 30 minutos (prompt_cache_options.ttl: "30m").
Tercero, Claude Sonnet 5.5 tiene sus propias trampas estrictas de error 400. Según la guía de migración de Sonnet 5.5 de Anthropic, Sonnet 5.5 utiliza pensamiento adaptativo de forma predeterminada (con un esfuerzo high en la API y medium en Claude Code, como se indica en la documentación de configuración de Claude Code de Anthropic). Si tu integración heredada de Claude envía thinking: {"type": "disabled"}, debes actualizarla a between_tools para obtener la configuración de pensamiento más baja. Más importante aún, Sonnet 5.5 rechaza las elecciones forzadas de herramientas (tool_choice: {"type": "any"} o una herramienta nombrada forzada) con un error 400 cuando el pensamiento adaptativo está activo; debes usar auto y guiar la selección de herramientas en el prompt. También necesitas analizar los bloques de contenido de respuesta por type en lugar de asumir que content[0] es texto, porque el primer bloque suele ser un bloque de thinking.
Cuarto, la integración con IDE y CLI ya está configurada para ambos. Ten en cuenta que, en las suscripciones de consumo, las notas de la versión de OpenAI confirman que GPT-6.1 Terra se implementó en ChatGPT Work y Codex (para los planes Plus, Pro, Business, Enterprise y Edu), no en la interfaz estándar de ChatGPT Chat, y no admite la residencia de inferencia en los EAU (aunque el modo rápido admite la residencia de datos en la UE). Para los desarrolladores que trabajan en terminales locales, ambos modelos pueden conectarse a Claude Code y OpenAI Codex a través de GPT Proto. En la página del modelo GPT-6.1 Terra, al hacer clic en Probar este modelo se abre un panel de inicio rápido donde puedes seleccionar Claude Code o ChatGPT (Codex) en Dejar que la IA finalice la integración, o hacer clic en Copiar Markdown para IA para permitir que tu asistente de programación configure las variables de entorno automáticamente.
Creación de aplicaciones: Cómo enrutar ambos modelos con una sola clave API
Cuando los equipos preguntan sobre GPT 6.1 Terra vs Sonnet 5.5 para crear aplicaciones, la mejor arquitectura casi nunca consiste en elegir un solo modelo para el 100% del tráfico. Debido a que ambos modelos residen bajo un saldo prepagado único en GPT Proto, puedes enrutar por paso en lugar de por proveedor: envía la inspección visual de alta frecuencia, la clasificación de capturas de pantalla y las correcciones de interfaz de usuario (UI) delimitadas a gpt-6.1-terra a $0.80/$4.00, y escala la síntesis de código de múltiples archivos a claude-sonnet-5-5 a $1.80/$9.00.
1. Verificación inicial con cURL (Chat Completions compatible con OpenAI)
Ambos modelos pueden ser llamados para análisis de texto y visual a través del endpoint unificado de GPT Proto compatible con OpenAI /v1/chat/completions usando un token Bearer estándar. Cambiar entre ellos requiere modificar únicamente la cadena "model" :
# Llamada 1: GPT-6.1 Terra ($0.80 entrada / $4.00 salida por cada 1M de tokens en GPT Proto)
curl --fail-with-body https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-terra",
    "messages": [
      {
        "role": "user",
        "content": "Inspecciona esta regla CSS y explica en dos oraciones por qué provoca un desplazamiento de diseño en dispositivos móviles: .hero-banner { width: 100%; height: auto; }"
      }
    ]
  }'

# Llamada 2: Claude Sonnet 5.5 ($1.80 entrada / $9.00 salida por cada 1M de tokens en GPT Proto)
curl --fail-with-body https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "claude-sonnet-5-5",
    "messages": [
      {
        "role": "user",
        "content": "Escribe un asistente en TypeScript que valide firmas de webhook usando Web Crypto API con comparación de tiempo constante."
      }
    ]
  }'
2. Ejemplo de enrutador de pasos en Python para pipelines de frontend y aplicaciones
Aquí tienes un patrón práctico en Python que utiliza el SDK estándar de openai apuntando a https://gptproto.com/v1. En este flujo de trabajo, el Paso 1 utiliza gpt-6.1-terra para clasificar un reporte de error de UI (donde el volumen de tokens es alto y el diagnóstico visual/DOM es económico), y el Paso 2 enruta dinámicamente el parche de código real ya sea a gpt-6.1-terra (para correcciones CSS de componentes aislados) o a claude-sonnet-5-5 (cuando la clasificación marca un cambio de estado entre archivos o cuando el prompt se acerca al límite de 272K):
import os
import json
from openai import OpenAI

# Una sola clave API y saldo compartido entre los modelos de OpenAI y Anthropic
client = OpenAI(
    api_key=os.environ["GPTPROTO_API_KEY"],
    base_url="https://gptproto.com/v1",
)

def triage_and_patch_ui_issue(dom_snapshot: str, screenshot_url: str, approx_tokens: int) -> dict:
    # Paso 1: Ejecuta siempre el triaje visual/DOM en GPT-6.1 Terra ($0.80 / $4.00 por 1M)
    triage_response = client.chat.completions.create(
        model="gpt-6.1-terra",
        messages=[
            {
                "role": "system",
                "content": (
                    "Eres un agente de triaje de QA frontend. Inspecciona la captura de pantalla y el DOM. "
                    "Devuelve un JSON con las claves: 'root_cause', 'scope' ('isolated_css' o 'multi_file_state'), "
                    "y 'target_files' (arreglo de cadenas)."
                ),
            },
            {
                "role": "user",
                "content": [
                    {"type": "text", "text": f"Instantánea del DOM: {dom_snapshot}"},
                    {"type": "image_url", "image_url": {"url": screenshot_url}},
                ],
            },
        ],
        response_format={"type": "json_object"},
    )

    triage_data = json.loads(triage_response.choices[0].message.content)

    # Paso 2: Enrutar según el alcance de la tarea Y el límite de facturación de contexto largo de 272K
    # Si la corrección afecta el estado de múltiples archivos O supera los 272K tokens de entrada, escala a Sonnet 5.5
    if triage_data.get("scope") == "multi_file_state" or approx_tokens > 272_000:
        selected_model = "claude-sonnet-5-5"
    else:
        selected_model = "gpt-6.1-terra"

    patch_response = client.chat.completions.create(
        model=selected_model,
        messages=[
            {
                "role": "user",
                "content": (
                    f"Diagnóstico de triaje: {json.dumps(triage_data)} | "
                    f"Genera un parche mínimo y listo para producción para el DOM/componente: {dom_snapshot}"
                ),
            }
        ],
    )

    return {
        "triage": triage_data,
        "routed_to": selected_model,
        "patch": patch_response.choices[0].message.content,
    }

if __name__ == "__main__":
    sample_dom = "<div class='card-grid'><img src='/hero.webp' /><h2>Checkout</h2></div>"
    result = triage_and_patch_ui_issue(
        dom_snapshot=sample_dom,
        screenshot_url="https://example.com/cls-regression-frame.png",
        approx_tokens=12_000,
    )
    print(f"Parche enrutado a: {result['routed_to']}")
    print(result["patch"])
Nota previa al despliegue (se requiere prueba de humo): Verifica las cadenas exactas del modelo (gpt-6.1-terra y claude-sonnet-5-5) en los paneles de uso de la API en vivo en sus páginas de modelos de GPT Proto antes de desplegar bucles facturables. Si tu agente depende de las herramientas de la API de respuestas nativas de OpenAI (apply_patch, shell alojado, o llamadas a funciones async: true) o de los parámetros de pensamiento adaptativo nativos de Anthropic /v1/messages (output_config.effort), ejecuta una prueba de humo rápida contra los puntos finales nativos respectivos de GPT Proto (/v1/responses y /v1/messages) para confirmar el paso de parámetros en tu ruta.
Veredicto: ¿Cuál deberías usar?
Si deseas una tabla única para pegar en un documento de revisión de arquitectura, ajusta tu carga de trabajo principal al modo de falla y al límite de facturación que más te importe:
| Carga de trabajo / Escenario |
Modelo recomendado |
Configuración recomendada |
Por qué gana |
| Control de calidad de capturas de pantalla de alto volumen, lectura de facturas/formularios y uso de computadora en navegador |
GPT-6.1 Terra |
low o medium effort |
Tasa de tokens de GPT Proto 56% más baja ($0.80/$4.00), finalización de tareas >3 veces más rápida que Sol/Astra y visión de nivel MMMU-Pro similar a Astra. |
| Depuración de interfaz de usuario (desplazamientos de diseño CLS, Figma a CSS, regresiones visuales) |
GPT-6.1 Terra |
medium effort |
Diseñado para inspección visual y de DOM; evaluado explícitamente en correcciones de desplazamiento de diseño de páginas web. |
Clasificación, enrutamiento o extracción de JSON de baja latencia donde se necesita temperature |
GPT-6.1 Terra |
reasoning.effort: "none" |
Restaura el nivel none sin razonamiento que GPT-6.1 Sol eliminó, manteniendo la latencia y el conteo de tokens de salida al mínimo. |
| Refactorización de backend de múltiples archivos y cambios de estado complejos en TypeScript/React |
Claude Sonnet 5.5 |
medium o high effort |
70.6% frente a 50.3% en Terminal-Bench 4.0; agrupa llamadas a herramientas en menos turnos, ahorrando tiempo costoso de revisión por parte del desarrollador. |
| Análisis de repositorio de contexto largo en una sola solicitud (300K a 900K tokens de entrada) |
Claude Sonnet 5.5 |
medium o high effort |
Terra activa un recargo de 2x en entrada / 1.5x en salida por encima de los 272K tokens (saltando a $2.00 de entrada oficial), eliminando su ventaja de precio. |
Codificación de terminal nativa de OpenAI más profunda cuando Terra max no es suficiente |
GPT-6.1 Sol |
medium effort |
Obtiene 54 frente a los 48 de Terra en el AA Coding Agent Index v2.0, y Sol medium ($0.21/tarea) es en realidad más barato por tarea que Terra `max` ($0.40/tarea). |
Para resumir el veredicto sin rodeos: comienza cada paso repetible de uso visual, uso de computadora y codificación limitada en GPT-6.1 Terra con esfuerzo low o medium para aprovechar la tarifa de $0.80/$4.00, y mantén a Claude Sonnet 5.5 en los pasos de codificación de múltiples archivos y prompts de >272K tokens donde su mayor precisión en la primera pasada y su precio fijo de 1M de contexto se pagan solos. Para ingresar tus propias proporciones mensuales de entrada y salida, abre la calculadora de comparación de GPT Proto y prueba ambos modelos lado a lado en un solo balance.