Alternativas a la API de OpenAI de un vistazo
| Alternativa |
Mejor uso |
Método de acceso |
Consideración principal de migración |
| GPT Proto |
Múltiples familias de modelos y acceso con descuento |
Plataforma de modelos unificada |
Confirmar capacidades para el modelo y endpoint elegidos |
| Anthropic Claude |
Flujos de trabajo de programación y agentes |
API de modelo directo |
Las funciones nativas de Claude y la compatibilidad con SDK difieren |
| Google Gemini |
Aplicaciones multimodales |
API de modelo directo |
Las funciones avanzadas pueden requerir integración nativa con Gemini |
| DeepSeek |
Cargas de trabajo de razonamiento enfocadas en presupuesto |
API de modelo directo |
Incluir caché y precios de hora pico frente a hora valle |
| Groq |
Aplicaciones sensibles a la velocidad |
Inferencia alojada |
Evaluar la combinación de modelo y función admitida |
| Mistral |
Aplicaciones centradas en documentos |
Modelos más API de documentos |
OCR, estado de conversación e inferencia son preocupaciones separadas |
| OpenRouter |
Exploración de modelos y enrutamiento de proveedores |
Puerta de enlace multiproveedor |
Definir requisitos de enrutamiento y considerar tarifas de plataforma |
Cómo comparamos estas alternativas a la API de OpenAI
Publicada por GPT Proto, esta comparación utiliza documentación oficial, precios públicos y funciones de aplicación documentadas verificadas el 29 de octubre de 2026. Las recomendaciones son juicios editoriales sobre la adecuación al flujo de trabajo; no se realizó ningún benchmark de rendimiento privado entre proveedores. Distinguimos las API de modelos directos de las puertas de enlace y los servicios de inferencia porque reemplazan diferentes partes de una configuración de OpenAI.
Las 7 mejores alternativas a la API de OpenAI
1. GPT Proto para acceso a múltiples modelos y precios con descuento
GPT Proto se adapta a un equipo de SaaS cuyo producto necesita varios modelos: uno para soporte de rutina, otro para programación difícil y quizás otros separados para generación de imágenes o video. Su catálogo de modelos reúne opciones de texto, imagen, video y audio bajo una sola cuenta, clave de API y saldo compartido.
Esto permite una migración gradual. Mantén las solicitudes de GPT que ya funcionan, mueve una tarea definida a Claude o DeepSeek y compara los resultados antes de cambiar el resto de la aplicación. Una cuenta compartida reduce la configuración de facturación y credenciales involucrada en esa evaluación.
También existe una opción sencilla para los equipos que desean conservar GPT. La página de la API de GPT-6.1 Sol enumera $1.60 por entrada y $8 por salida por millón de tokens, en comparación con las tarifas estándar de OpenAI de $2 y $10. Eso es una reducción del 20% en esas tarifas de tokens. Claude Sonnet 5.5 aparece a $1.80 y $9, un 10% por debajo de las tarifas estándar correspondientes de Anthropic.
Elige GPT Proto cuando la elección del modelo y el acceso consolidado sean las prioridades. Revisa la sección de Uso de API del modelo seleccionado para ver las interfaces y campos admitidos; una clave compartida no hace que todos los modelos o endpoints de medios sean intercambiables. Mantener GPT a través de otro proveedor también preserva la dependencia de la familia de modelos GPT.
2. Anthropic Claude para programación y flujos de trabajo de agentes
Claude debe estar en tu lista de opciones cuando la aplicación pase la mayor parte del tiempo editando código, analizando documentos o decidiendo qué herramienta usar a continuación. Comienza con Sonnet para tareas cotidianas de programación y agentes, evalúa Opus para tareas más exigentes y considera Haiku para clasificación, extracción o enrutamiento repetitivos.
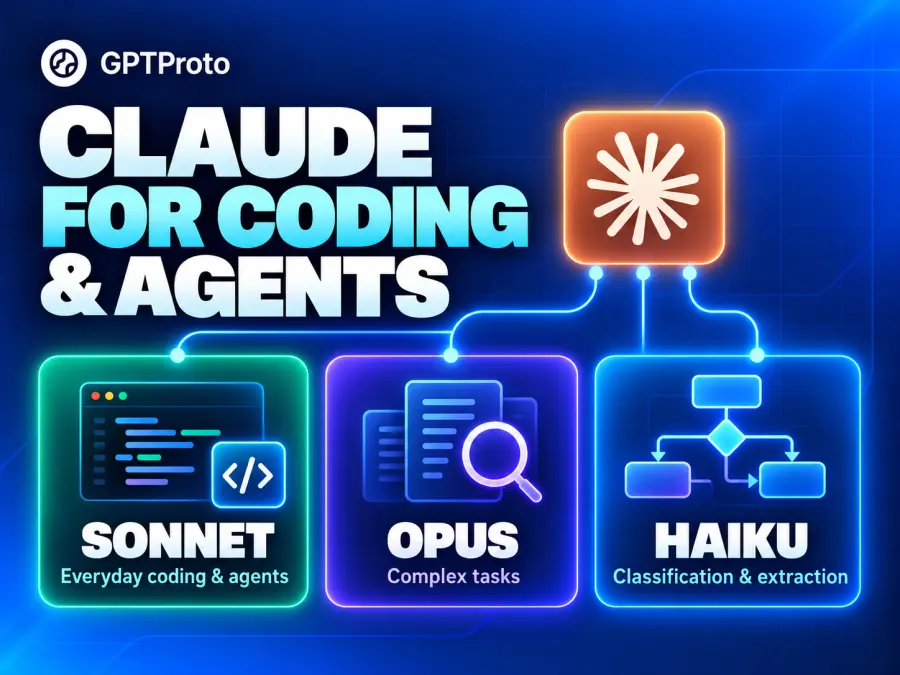
Por ejemplo, un agente de soporte podría usar un modelo ligero para categorizar solicitudes y reservar un modelo más potente para investigar un problema técnico complejo. La política de precios de modelos de Anthropic hace que estos niveles sean visibles: Sonnet 3.5 cuesta $2 por entrada y $10 por salida por millón de tokens, mientras que Haiku 3.5 comienza en $0.10 y $0.50 para prompts de hasta 100 mil tokens de entrada.
La migración requiere prestar atención a la interfaz. La documentación de compatibilidad con el SDK de OpenAI de Anthropic indica que la capa de compatibilidad ignora el campo strict del esquema de herramientas. Las aplicaciones que dependen de una validación estricta deben evaluar el soporte de salida estructurada de la API nativa de Claude.
Usa la colección de modelos Claude en GPT Proto para comparar las rutas disponibles. Claude es una alternativa basada en capacidades; elegir Sonnet a su tarifa estándar oficial no reduce automáticamente la factura en relación con GPT-4o.
3. Google Gemini para aplicaciones multimodales
Gemini es un candidato útil para productos que combinan texto con capturas de pantalla, audio grabado, video o documentos. Una aplicación de aprendizaje que revisa la grabación de un estudiante y una herramienta de soporte que interpreta capturas de pantalla necesitan más que solo generación de texto.
Google documenta la compatibilidad con el SDK de OpenAI, lo que incluye cambiar la URL base, la clave y el modelo para las solicitudes admitidas. Eso puede simplificar una evaluación inicial. Su guía de integración también explica que las funciones avanzadas de Gemini y las herramientas del lado del servidor pueden requerir un manejo adicional o una integración nativa.
Selecciona el modelo según los requisitos reales de entrada y salida. Un modelo Flash-Lite puede ser una opción rentable para un procesamiento más sencillo, mientras que una API Live independiente maneja la interacción en tiempo real. El acceso a un endpoint de texto de Gemini no garantiza el soporte para todos los productos de Gemini.
Explora los modelos de Google en GPT Proto o inspecciona Gemini 1.5 Flash por sus entradas multimodales listadas. Google también ofrece niveles gratuitos para modelos seleccionados, con límites y términos de uso de datos diferentes a los del acceso de pago, como se muestra en su documentación de precios.
4. DeepSeek para cargas de trabajo de razonamiento enfocadas en el presupuesto
Vale la pena evaluar DeepSeek para el análisis repetido de documentos, asistencia en programación y tareas de razonamiento donde los costos de tokens se acumulan rápidamente. Es particularmente relevante cuando las solicitudes reutilizan una cantidad sustancial de información o pueden ejecutarse fuera de las horas pico de precios.
La tabla de precios oficial de DeepSeek lista a Flash en $0.30 por millón de tokens de entrada no almacenados en caché y $1.20 por millón de tokens de salida durante los períodos pico. Las tarifas fuera de horario pico son de $0.15 y $0.60. La entrada almacenada en caché tiene una tarifa separada y más baja, por lo que un flujo de trabajo de documentos recurrente puede tener una economía diferente a la de los prompts cortos y no relacionados.
La guía de la API de DeepSeek documenta el acceso compatible con OpenAI y Anthropic. Utiliza el identificador de modelo exacto para el servicio elegido; la compatibilidad con un formato de solicitud aún deja pendiente la validación del comportamiento del modelo y el manejo de herramientas.
La página de la API de DeepSeek Flash proporciona una ruta de acceso de GPT Proto. Para una lista más amplia, compara los principales proveedores de LLM chinos o explora LLMs chinos para programación.
Sus bajas tarifas justifican una evaluación, pero no lo hacen más barato que todos los modelos pequeños de OpenAI.
5. Groq para aplicaciones sensibles a la velocidad
Groq es una opción para aplicaciones donde los usuarios esperan directamente por la salida generada: asistentes interactivos, funciones de respuesta corta y flujos de trabajo con varias llamadas secuenciales al modelo. Su valor depende de encontrar un modelo compatible que cumpla con los requisitos de calidad de la tarea.
Utiliza la documentación de modelos compatibles de Groq para verificar la disponibilidad, los límites y las especificaciones de servicio publicadas. Mide el tiempo hasta la primera respuesta útil y el tiempo total del flujo de trabajo en tu aplicación; la cifra de velocidad de generación de un proveedor no incluye todos los retrasos de red o de herramientas.
Groq proporciona acceso compatible con OpenAI, con campos documentados que no son compatibles. También tiene una API de respuestas, pero la documentación indica que las aplicaciones deben mantener y reenviar el historial de la conversación por sí mismas.
Elige Groq cuando la velocidad de respuesta sea un requisito significativo del producto y el modelo disponible se ajuste a tus necesidades. Si la aplicación existente depende en gran medida de conversaciones almacenadas, incluye la gestión de estado en la estimación de la migración. Reemplazar el servicio de alojamiento y reemplazar al desarrollador del modelo son decisiones separadas.
6. Mistral para aplicaciones centradas en documentos
Vale la pena considerar a Mistral para aplicaciones creadas en torno a la recepción, extracción y respuesta a preguntas sobre documentos. Una herramienta de procesamiento de facturas, por ejemplo, necesita una extracción de texto confiable antes de poder clasificar un documento o explicar una discrepancia.
Su catálogo de API y precios distingue los modelos generales de los servicios de OCR. Esto ayuda a los equipos a estimar la extracción y la generación por separado en lugar de tratar todo el flujo de trabajo del documento como una única solicitud de chat.
La guía de migración de Mistral cubre las Chat Completions al estilo de OpenAI. Su API de respuestas admite generación de texto, entradas de archivos e imágenes, llamadas a funciones y streaming. Al momento de esta revisión, se encuentra en vista previa pública y no tiene estado: tu aplicación proporciona el historial de la conversación.
Mistral es un candidato sensato cuando el procesamiento de documentos es fundamental para el producto. Evalúa el resultado de la extracción, la calidad de las respuestas posteriores y el costo de ambas etapas. Una migración de chat funcional por sí sola no valida un flujo de trabajo completo de procesamiento de documentos.
7. OpenRouter para enrutamiento de proveedores y exploración de modelos
OpenRouter es adecuado para equipos que desean comparar modelos y controlar qué proveedores subyacentes atienden sus solicitudes. También puede ayudar cuando una aplicación necesita una estrategia explícita de proveedor de respaldo.
El enrutamiento introduce sus propias decisiones. Decide si las solicitudes pueden moverse entre proveedores, si se debe admitir cada parámetro solicitado y qué requisitos de manejo de datos se aplican. OpenRouter expone las preferencias de proveedores, la configuración de respaldo y los controles de soporte de parámetros; esos ajustes merecen atención cuando una aplicación depende de una función específica.
Para una evaluación inicial, mantén el proveedor y el modelo fijos para que los cambios en los resultados sean más fáciles de investigar. Luego, prueba la configuración de respaldo prevista, incluidos los fallos y las diferencias en los informes de uso. Las tarifas de compra de créditos y cualquier cargo BYOK aplicable también deben incluirse en la estimación de costos.
Elige OpenRouter cuando los controles de enrutamiento sean un requisito principal. Nuestra comparación de proveedores de API de LLM explica en qué se diferencian las puertas de enlace, las plataformas administradas y los especialistas en inferencia.
¿Qué alternativas a la API de OpenAI son realmente más económicas?
Existen dos decisiones de costos independientes. Puedes mantener el mismo modelo a través de un proveedor de acceso diferente, o cambiar el modelo que realiza el trabajo. La primera opción ofrece una comparación de precios por token relativamente directa. La segunda requiere una evaluación de calidad junto con la factura.
El siguiente ejemplo asume 10 millones de tokens de entrada sin caché y 2 millones de tokens de salida facturados por mes. Es un escenario de uso calculado, no un punto de referencia de calidad de tarea equivalente. La salida facturada incluye tokens de razonamiento cuando el proveedor los cobra como salida. Se excluyen las tarifas de herramientas, impuestos, escrituras en caché y descuentos por lotes.
| Modelo y ruta de acceso |
Entrada por 1M |
Salida por 1M |
Costo de ejemplo |
| GPT-6.1 Sol vía OpenAI Standard |
$2.00 |
$10.00 |
$40.00 |
| GPT-6.1 Sol vía GPT Proto |
$1.60 |
$8.00 |
$32.00 |
| GPT-6 Luna vía OpenAI Standard |
$0.10 |
$0.50 |
$2.00 |
| Haiku 5.5 directo, prompts hasta 100K |
$0.10 |
$0.50 |
$2.00 |
| DeepSeek Flash directo, hora pico |
$0.30 |
$1.20 |
$5.40 |
| DeepSeek Flash directo, fuera de hora pico |
$0.15 |
$0.60 |
$2.70 |
| Gemini 3.1 Flash-Lite directo, texto estándar |
$0.25 |
$1.50 |
$5.50 |
Las tarifas provienen de la página de precios de OpenAI, la página de Sol de GPT Proto y las páginas de precios de Anthropic, DeepSeek y Google enlazadas arriba.
El ejemplo de Sol ahorra $8, o un 20%, al volumen de tokens indicado. Las filas de modelos ligeros muestran por qué una alternativa debe compararse con el modelo de OpenAI que realmente necesitas. Un modelo pequeño de OpenAI puede costar menos que una alternativa más capaz.
El umbral de 100K de Haiku se aplica a la entrada de cada solicitud, no al volumen mensual. Las dos filas de DeepSeek asumen que todo el uso cae dentro del período de precios indicado; el tráfico mixto produce una factura combinada. Los tokenizadores, el esfuerzo de razonamiento y los reintentos también pueden cambiar cuántos tokens consume una tarea. Para cargas de trabajo de agentes, compara APIs de LLM asequibles según la adecuación a la tarea y luego realiza un seguimiento del costo por resultado aceptado.
Cuánto de tu integración con OpenAI puedes conservar
Comienza identificando las interfaces y comportamientos que utiliza la aplicación. Una solicitud de saludo exitosa dice muy poco sobre un agente que utiliza herramientas.
| Dependencia existente |
Verificar antes de la migración |
Posible cambio en la aplicación |
| Chat y streaming |
Campos de solicitud, formato de evento, terminación |
Configuración del cliente o analizador de respuestas |
| Llamada a herramientas |
Argumentos, resultados de herramientas, turno de seguimiento |
Adaptador de herramientas y validación |
| Salida estructurada |
Reglas de esquema aplicadas y casos de falla |
Cambios en el esquema y comprobaciones del lado de la aplicación |
| Conversaciones almacenadas |
Almacenamiento y recuperación del historial |
Persistencia y reproducción del historial |
| Archivos o herramientas integradas |
Funcionalidad equivalente y facturación |
Servicio de recuperación o de herramientas independiente |
El relato de un desarrollador sobre la portabilidad de la salida estructurada describe cómo se manejan las restricciones de manera diferente entre proveedores. Tómalo como la experiencia de un profesional y luego verifica tu esquema exacto con la documentación y las respuestas actuales.
Ejecuta solicitudes representativas a través de la integración candidata: tráfico normal, entradas largas, una herramienta fallida y una salida que viole el formato esperado. Registra los resultados aceptados, el uso facturado, el tiempo de respuesta y los reintentos. Para aplicaciones de programación, ejecuta también el cambio generado a través de las propias comprobaciones del proyecto.
Mantén una forma de devolver el tráfico a la configuración anterior mientras evalúas el reemplazo. Si aún estás eligiendo una plataforma general para un nuevo producto, la guía de API de IA para desarrolladores más amplia cubre esa decisión.
Alternativas a las API de Realtime Assistants y Moderation de OpenAI
Alternativas a la API Realtime de OpenAI
Gemini Live API es una candidata para la interacción de voz y visión en tiempo real. Evalúa el manejo de interrupciones, los formatos de audio, el comportamiento de la sesión y el tiempo de respuesta de voz. Una canalización que combine reconocimiento de voz, un LLM y síntesis de voz es otra arquitectura, pero sus etapas separadas añaden trabajo de integración y latencia. El texto transmitido ordinario no es un reemplazo equivalente para una sesión de audio en vivo.
Alternativas a la API Assistants de OpenAI para agentes de producción
La API Assistants fue retirada el 26 de agosto de 2026, según la guía de migración de OpenAI. Los equipos que permanezcan con OpenAI deben seguir su ruta de migración de Respuestas.
Para un diseño independiente del proveedor, combina una API de modelo elegida con un entorno de ejecución de orquestación como LangGraph. Sus componentes de estado y puntos de control pueden admitir flujos de trabajo persistentes, pero tu equipo aún necesita implementar la ejecución de herramientas, la recuperación, el almacenamiento y la recuperación de datos. Cambiar el punto final del modelo no migra esas responsabilidades ni recrea hilos antiguos automáticamente.
Alternativas a la API de moderación de OpenAI para aplicaciones de chat
Azure AI Content Safety ofrece análisis de texto e imágenes para detectar contenido potencialmente dañino. Compara las categorías admitidas, los idiomas, los umbrales, los tiempos de respuesta y los falsos positivos con los ejemplos de tu aplicación.
La moderación es una selección independiente del modelo conversacional. Para chats creativos o juegos de rol, nuestra comparativa de API de LLM sin censura aborda el comportamiento del modelo; una aplicación aún necesita tomar sus propias decisiones sobre qué contenido permitir y cómo aplicarlas.
Cómo probar alternativas a la API de OpenAI en GPT Proto
Comienza con una carga de trabajo que puedas evaluar de manera consistente, como responder preguntas de soporte o extraer campos de un documento.
Elige un modelo. Abre el catálogo de GPT Proto y compara las opciones relevantes de Claude, Gemini o DeepSeek.
Abre las instrucciones de configuración del modelo. Usa la opción "Probar este modelo" (Try This Model) donde esté disponible, o la sección de uso de la API. Copia las instrucciones específicas del modelo en tu asistente de programación o sigue el ejemplo mostrado.
Configura la integración. Crea una clave de API de GPT Proto y utiliza el ID del modelo, el endpoint y el formato de solicitud que se muestran en esa página. Mantén las credenciales en la configuración secreta de tu aplicación.
Evalúa un conjunto pequeño de solicitudes. Compara los resultados útiles, el uso facturado y el tiempo de respuesta antes de aumentar el tráfico. Prueba las herramientas requeridas y las salidas estructuradas por separado.