Resumen de los mejores proveedores de API para aplicaciones de compañía con IA
| Proveedor |
Mejor uso |
Capacidades a evaluar |
Principal inconveniente |
| GPT Proto |
Combinación de modelos de diferentes laboratorios con contenido visual |
Modelos de chat, imagen y video compatibles bajo una misma clave y saldo |
Tu aplicación aún debe gestionar el estado del personaje y la memoria persistente |
| OpenAI |
Integración directa con modelos de voz en tiempo real de OpenAI |
Texto, generación de imágenes, voz e interacción de audio en tiempo real |
El acceso a otras familias de modelos requiere integraciones adicionales |
| Google Gemini API |
Productos que utilizan el ecosistema de IA de Google |
Chat con Gemini, interacción en vivo, generación de imágenes y modelos de video |
La entrada en vivo y los medios generados utilizan diferentes capacidades de modelo |
| Inworld |
Experiencias de voz en tiempo real configurables |
STT, LLM seleccionables, TTS, además de inferencia de imagen y video |
La memoria entre sesiones requiere almacenamiento y restauración por parte de la aplicación |
| ElevenLabs |
Productos basados en voz que también necesitan contenido visual |
Agentes, voces configurables y API de generación de imagen/video |
El acceso a la API de medios requiere una suscripción |
| xAI |
Productos creados en torno a Grok |
Chat, generación de imágenes/video con Imagine y API de voz |
Cada función tiene sus propios requisitos de solicitud y facturación |
Cómo seleccionamos estos proveedores de API
Esta es una guía de selección basada en documentación, verificada el 27 de octubre de 2026. Las recomendaciones reflejan las capacidades disponibles, los requisitos de integración y las estructuras de facturación publicadas. No representan una clasificación medida de la calidad del diálogo o la velocidad de respuesta.
Prioricé los proveedores que un desarrollador podría evaluar para un producto de compañía, y luego consideré la elección del modelo, el soporte de medios, el trabajo de la aplicación y el costo. Una comparación útil debe explicar si un servicio proporciona inferencia de modelo, un flujo de trabajo de conversación por voz o infraestructura de producto adicional.
Los proyectos reales muestran por qué esa distinción es importante. El proyecto de compañía de código abierto Utsuwa companion project configura los proveedores de LLM y de texto a voz por separado. Su aplicación recupera el historial de conversación, inyecta recuerdos relevantes y ajusta el contexto para adaptarse al modelo seleccionado. La selección del proveedor es solo una parte de ese sistema.
Para ver más ejemplos, explora las aplicaciones de chat de personajes y su uso de modelos de GPT Proto. Utiliza los listados para investigar patrones de aplicación y opciones de modelos. Estos no establecen qué proveedor funcionará mejor para tu propia aplicación.
6 proveedores de API a considerar para tu aplicación de compañía
1. GPT Proto para combinar modelos de chat, imagen y video
GPT Proto es el punto de partida más sólido en esta lista cuando deseas comparar diferentes familias de modelos y añadir elementos visuales generados a través de la misma cuenta. Su API de IA para juegos de rol te brinda un espacio para evaluar prompts de personajes y comparar modelos compatibles antes de comprometerte con uno.
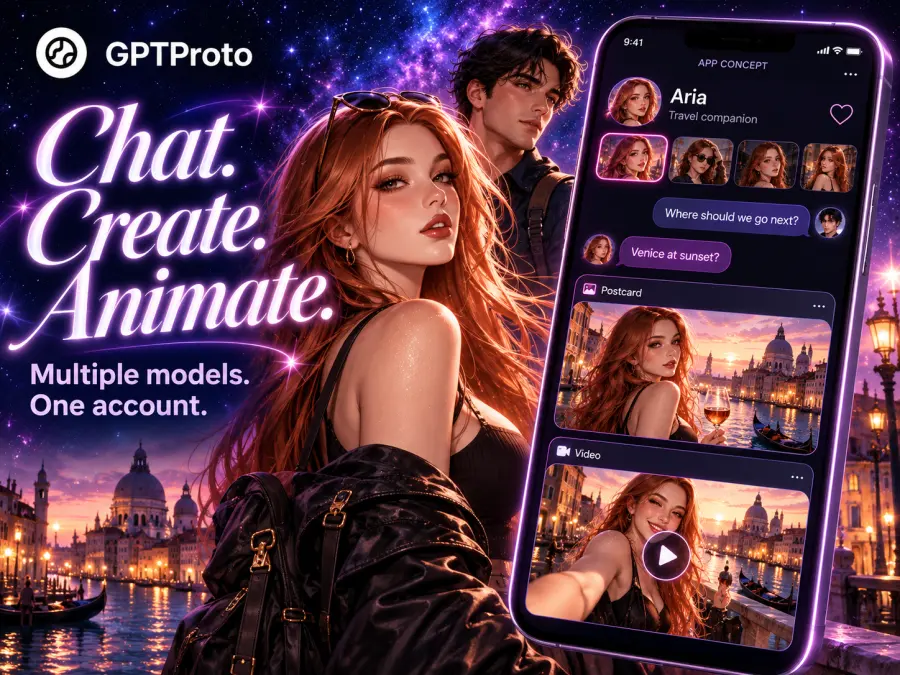
Considera un compañero de viaje ficticio: un modelo de chat escribe la conversación, un modelo de imagen crea una postal del personaje y un modelo de video anima una escena. Esas tareas pueden utilizar diferentes modelos. GPT Proto tiene páginas dedicadas para opciones como generación de imágenes Nano Banana 2.1 y generación de video Kling 4.0, con ejemplos de solicitudes específicos para cada modelo.
El acceso compartido reduce la cantidad de cuentas y saldos que tu equipo debe gestionar. La integración aún requiere un manejo por separado para cada tarea. Una solicitud de chat-completions y un trabajo de video asíncrono tienen ciclos de vida diferentes.
Para una referencia de presupuesto concreta, GPT-6 Luna en GPT Proto lista $0.08 por millón de tokens de entrada y $0.40 por millón de tokens de salida. Eso lo convierte en un candidato para experimentos de chat económicos; la calidad del personaje requiere su propia evaluación.
Elige GPT Proto cuando la flexibilidad de los modelos y las funciones visuales sean una prioridad. Incorpora memoria, permisos de usuario y estado del personaje en tu aplicación, y verifica cualquier función de voz en tiempo real necesaria por separado.
2. OpenAI para acceso directo a modelos de voz en tiempo real
OpenAI es una opción práctica cuando los requisitos de tu producto se centran en sus modelos y en la interacción de voz en tiempo real. La API en tiempo real procesa audio directamente, mantiene el estado de la conversación y admite herramientas. Su flujo de navegador documentado utiliza un secreto de cliente efímero y WebRTC; las conexiones al servidor pueden usar WebSocket.
Esto es útil para un compañero de voz que necesita manejar interrupciones o llamar a una herramienta durante la conversación. Puedes desarrollar sobre la API original y sus SDK, con menos servicios intermedios que investigar cuando una función específica del modelo se comporta de manera inesperada.
La limitación es la elección de modelos entre proveedores. Si tu producto necesita más adelante el estilo de diálogo de otro laboratorio o un modelo de imagen diferente, tendrás que añadir esa integración tú mismo. El estado de la conversación almacenado también requiere un diseño explícito para el historial del usuario y la recuperación de memoria.
Para video, verifica cuidadosamente la disponibilidad actual. El aviso de obsolescencia de OpenAI lista el cierre de la API de Videos y la API de Sora 2 para el 24 de septiembre de 2026. Un tutorial antiguo accesible no es evidencia suficiente de que su endpoint siga disponible.
Elige OpenAI cuando el acceso directo a sus capacidades en tiempo real supere la necesidad de cambiar entre familias de modelos.
3. Google Gemini API para aplicaciones creadas en torno a Google AI
Vale la pena considerar a Google si ya utilizas su ecosistema de desarrolladores y deseas evaluar funciones de conversación, entrada visual, generación de imágenes y video dentro de ese entorno.
La Gemini Live API admite interacciones en tiempo real con conexiones WebSocket de frontend o backend. Google recomienda tokens efímeros para conexiones de clientes en producción. Esto puede adaptarse a un compañero que responda a entradas de voz e información proveniente de una cámara o pantalla compartida.
El video generado es una selección independiente. La guía de video de Gemini actual orienta a los desarrolladores hacia Gemini Omni Flash y lo distingue de los endpoints descontinuados de Veo 3.1 Preview. Para un personaje que envía un mensaje animado corto, evalúa un modelo de generación en lugar de asumir que la entrada de video en vivo proporciona esa salida.
El trabajo práctico consiste en seleccionar y probar los modelos adecuados para cada función. Un producto puede requerir diferentes configuraciones, límites de uso y cálculos de facturación para chat, voz y multimedia. Mantén esos costos separados en tu pronóstico.
Elige Google cuando su ecosistema se ajuste a tu aplicación y te sientas cómodo seleccionando diferentes modelos para distintas interacciones.
4. Inworld para canales de voz en tiempo real configurables
Inworld merece una mirada detallada cuando la conversación hablada es fundamental para la experiencia. Su Realtime API combina conversión de voz a texto, el LLM que elijas y conversión de texto a voz, mientras gestiona la detección de turnos e interrupciones a través de WebSocket o WebRTC.
También tiene una cobertura multimedia más amplia. Inworld Inference expone modelos de texto, imagen y video, por lo que describir la plataforma solo como un servicio de voz omitiría parte de su oferta.
El límite importante es la memoria persistente. Su documentación sobre memoria a largo plazo explica que las sesiones en tiempo real son temporales. Tu cliente debe guardar la memoria externamente y restaurarla para una sesión futura. Esta es una responsabilidad concreta de la aplicación que debes incluir en las estimaciones de desarrollo.
Para la evaluación de costos, realiza un seguimiento del reconocimiento de voz, el consumo del LLM y la voz generada por separado, y luego suma el uso de medios. Un precio unitario bajo de TTS no establece el precio de una conversación completa.
Elige Inworld cuando la interacción de voz configurable sea un requisito principal y desees menos trabajo de orquestación. Planifica el flujo de la base de datos y la restauración de memoria junto con la integración de voz.
5. ElevenLabs para aplicaciones guiadas por voz con funciones visuales
ElevenLabs es una opción a considerar cuando deseas que la configuración de voz y los controles de conversación formen parte de la plataforma que adquieres. ElevenAgents admite la selección de modelos de lenguaje, turnos de palabra, interrupciones y despliegue a través de integraciones web y móviles.
Su oferta de imagen y video cambia la comparación. La guía de la API de imagen y video documenta puntos finales de generación asíncrona separados, con resultados recopilados mediante webhooks o sondeo. El acceso requiere un plan Pro o superior y los permisos de API correspondientes.
Ese requisito de suscripción es importante para un prototipo pequeño. Compara el uso esperado de las funciones con los servicios disponibles en el plan que pretendes comprar. Las generaciones de medios consumen créditos según el modelo, la configuración y las entradas seleccionadas; una asignación de voz no debe tratarse como un presupuesto de medios ilimitado.
Existe otra distinción de costos: la documentación del modelo de agente contabiliza el uso de LLM de terceros por separado. Estima la configuración de conversación que realmente implementarás en lugar de usar el precio de voz principal como el total.
Elige ElevenLabs cuando la configuración de voz y las herramientas de agente justifiquen los requisitos de la plataforma. Verifica el acceso a medios antes de diseñar funciones de imagen o video de personajes en torno a ello.
6. xAI para aplicaciones creadas en torno a los modelos Grok
xAI es relevante cuando deseas específicamente a Grok como modelo conversacional y quieres evaluar las capacidades de medios y voz relacionadas.
La documentación de Imagine cubre la generación y edición de imágenes junto con la generación de video. Esto brinda a los desarrolladores una ruta para probar una conversación de personajes y contenido visual generado dentro del ecosistema del mismo proveedor.
La voz debe evaluarse a través de su propia documentación de la API de voz. Mantén la interacción por voz, el chat de texto y los clips generados como elementos de integración y presupuesto separados, incluso cuando compartan una cuenta.
Todavía estás construyendo el producto complementario. Una API de modelo no proporciona automáticamente los activos del personaje, el estado de relación persistente o la interfaz que se encuentran en una aplicación complementaria de consumo. Verifica las entradas, salidas y controles reales de la API frente a las funciones de tu especificación.
Elige xAI cuando Grok sea parte de la decisión del producto. Si tu prioridad es comparar muchas familias de modelos, incluye también un servicio de modelos múltiples en la evaluación.
¿Cuánto cuesta realmente una aplicación de compañía de IA?
Una cotización por token se vuelve útil cuando la conectas a una carga de trabajo definida. Las conversaciones largas pueden reenviar instrucciones del personaje, memorias recuperadas e historial reciente con cada solicitud. Mide la entrada que envía tu aplicación.
Aquí tienes una carga de trabajo hipotética solo de texto: 1,000 sesiones, 50 respuestas por sesión, un promedio de 2,000 tokens de entrada por solicitud y 200 tokens de salida facturados por respuesta. Eso genera 100 millones de tokens de entrada y 10 millones de tokens de salida.
| Mismo modelo y carga de trabajo |
GPT Proto GPT-6 Luna |
OpenAI GPT-6 Luna |
| Precio de entrada por millón de tokens |
$0.08 |
$0.10 |
| Precio de salida por millón de tokens |
$0.40 |
$0.50 |
| Costo por 100 millones de tokens de entrada |
$8 |
$10 |
| Costo por 10 millones de tokens de salida |
$4 |
$5 |
| Estimación total de inferencia de texto |
$12 |
$15 |
Las tarifas provienen de la página de modelos de GPT Proto y la documentación del modelo OpenAI GPT-6 Luna. Este cálculo utiliza tarifas de texto estándar sin caché y no asume ninguna salida de razonamiento más allá de la asignación de tokens establecida. Excluye cargos por escritura en caché, reintentos, medios, procesamiento de memoria, almacenamiento e impuestos. Es una ilustración de costos de compra, no una comparación medida de la calidad de la compañía.
Para un producto multimodal, añade el siguiente uso al pronóstico:
| Funcionalidad |
Qué medir |
| Memoria persistente |
Llamadas de extracción o resumen, embeddings donde se utilicen, recuperación y almacenamiento |
| Imágenes de personajes |
Imágenes solicitadas, resolución, entradas de referencia y generaciones repetidas |
| Videos cortos |
Duración generada, resolución, activos de entrada, configuración de audio y reintentos facturados |
| Conversación hablada |
Reconocimiento, uso de LLM, salida de voz y cualquier cargo de plataforma o conexión |
La latencia también es parte de la evaluación del producto. En una cuenta de desarrollo de compañía de escritorio, el autor combinó la inferencia en la nube con voz local y memoria de base de datos, y luego reportó retrasos por la llamada de herramientas. Es una experiencia individual, pero ilustra por qué un modelo de texto rápido por sí solo no puede determinar el tiempo de espera que experimentan los usuarios.
Conecta un modelo de chat y planifica tu flujo de trabajo multimedia
Comienza con una breve conversación con el personaje. Crea una clave de API de GPT Proto, añade crédito y configura la variable de entorno GPTPROTO_API_KEY en tu servidor. La página del modelo GPT-6 Luna proporciona el ejemplo de uso de la API actual.
curl --fail-with-body --silent --show-error \
  https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  --data '{
    "model": "gpt-6-luna",
    "messages": [
      {
        "role": "system",
        "content": "You are Mira, a fictional travel companion. Be warm and concise."
      },
      {
        "role": "user",
        "content": "I have one free afternoon in Kyoto and prefer quiet places."
      }
    ]
  }'
Lee la respuesta de choices[0].message.content. Esta solicitud proporciona una instrucción de personaje y un mensaje. Para continuar el diálogo, tu backend debe ensamblar la conversación y los recuerdos relevantes para cada llamada. Mantén la clave de API permanente fuera del código del navegador y de los paquetes móviles.
A continuación, selecciona un modelo de imagen o video desde su propia página. Utiliza las instrucciones de uso de la API de la página del modelo al pedirle a tu asistente de programación que cree la integración. Conserva el endpoint documentado, la autenticación, los parámetros y el flujo de manejo de resultados.
Una tarea multimedia asíncrona necesita un ID de trabajo guardado y un controlador de finalización. Tu interfaz puede mostrar una imagen o video pendiente mientras el chat continúa. Conectar cada tarea al endpoint de chat-completions no reproducirá esas capacidades por separado.
¿Qué proveedor de API deberías elegir?
| Tu primer hito de producto |
Lista de candidatos |
Qué validar antes de comprometerte |
| MVP de compañero de texto |
GPT Proto o una API de modelo directo |
Comportamiento del personaje, costo por conversación, manejo de memoria |
| Chat más imágenes y clips de personajes |
GPT Proto, Google, Inworld, ElevenLabs o xAI |
Disponibilidad exacta del modelo, acceso a medios, referencias y flujo de finalización de tareas |
| Compañero hablado en tiempo real |
OpenAI, Inworld, ElevenLabs o Gemini Live |
Interrupciones, primera respuesta audible, consistencia de voz y costo total de la sesión |
| Producto construido específicamente en torno a Grok |
xAI |
Funciones de API requeridas y el trabajo de la aplicación más allá del acceso al modelo |
Para un equipo que aún está explorando su modelo de diálogo y funciones visuales, yo comenzaría con GPT Proto y una pequeña evaluación repetible. Usa las mismas instrucciones de personaje e historial de conversación, luego compara los modelos compatibles antes de construir el resto del producto en torno a uno.
La selección del modelo merece un análisis por separado. Nuestra guía de mejores modelos de IA para juegos de rol se centra en los modelos de diálogo subyacentes. Úsala para reducir los candidatos, luego prueba tus propios personajes y patrones de sesión.
Comienza con la API de IA de GPT Proto para juegos de rol para comparar una conversación de personaje y añade generación visual una vez que la experiencia de chat cumpla con tus requisitos.