Resumen de los mejores modelos LLM chinos
| Rango |
Modelo |
Uso recomendado |
Principal desventaja |
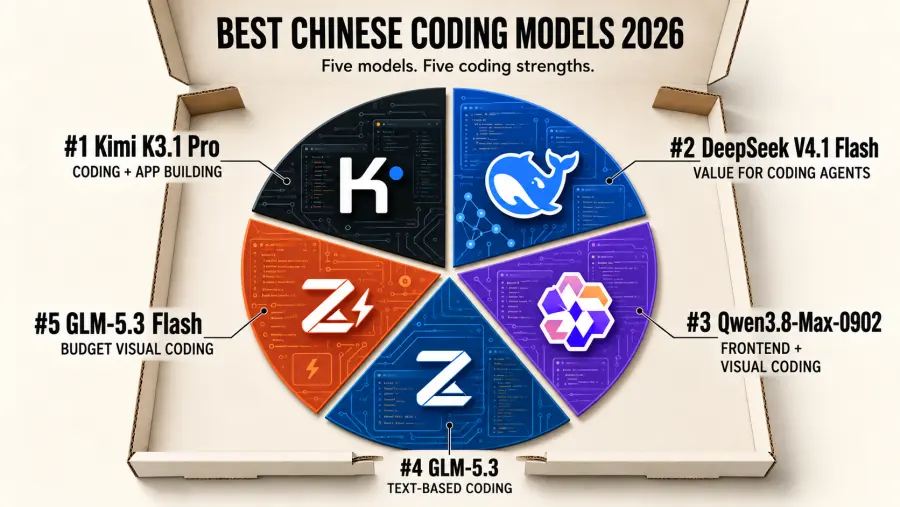
| 1 |
Kimi K3.1 Pro |
Programación compleja, creación de aplicaciones y tareas de agentes extendidas |
Tarifas de tokens más altas que las opciones económicas |
| 2 |
DeepSeek V4.1 Flash |
Agentes de programación conscientes del costo y trabajo de implementación repetitivo |
Confirma el punto de control (checkpoint) utilizado antes de aplicar los resultados del benchmark 1017 |
| 3 |
Qwen3.8-Max-0902 |
Implementación de frontend y depuración visual |
Tarifas de tokens más altas que DeepSeek y GLM Flash |
| 4 |
GLM-5.3 |
Investigación de repositorios basada en texto y tareas de terminal |
La evidencia visual nativa requiere otra ruta |
| 5 |
GLM-5.3 Flash |
Programación visual económica y subtareas frecuentes de agentes |
Prueba tareas difíciles antes de establecerlo como el único modelo de producción |
La comparación de precios aparece a continuación. Mantener el precio separado de la capacidad facilita ver por qué un modelo más costoso aún podría valer la pena para una tarea específica.
Las mediciones de velocidad provienen de la API de cada creador de modelos, según lo medido por Artificial Analysis. Son instantáneas útiles, no garantías de latencia para GPT Proto. La carga del proveedor, la longitud del prompt, el esfuerzo de razonamiento, el comportamiento de la caché y la longitud de salida pueden cambiar el rendimiento en producción.
La columna de modalidad describe las rutas expuestas por GPT Proto. Un punto de control descargable y una API alojada con un nombre similar pueden no exponer características idénticas.
Cómo clasificamos los modelos chinos para programación
Un gran número de parámetros o una ventana de contexto de un millón de tokens no te indican si un modelo puede completar una tarea de repositorio. Los cinco modelos en este ranking se encuentran aproximadamente en la misma categoría de contexto largo. Sus diferencias prácticas aparecen en otros aspectos.
Consideramos seis preguntas:
¿Cómo se desempeña el modelo en evaluaciones independientes en lugar de solo en los gráficos de referencia de su desarrollador?
¿Puede mantener la programación de múltiples archivos, el trabajo en terminal, las llamadas a herramientas y los ciclos de planificar-ejecutar-verificar?
¿Puede inspeccionar capturas de pantalla, diagramas, documentos o flujos de productos grabados cuando la evidencia no es solo de texto?
¿Cuál es el costo real de una tarea de API después de incluir los tokens de salida, el razonamiento y los posibles reintentos?
¿Se pueden descargar realmente los pesos del modelo y qué licencia rige su implementación comercial?
¿Existe una ruta de GPT Proto en vivo que los lectores puedan probar a través de la misma cuenta y formato de API?
El tablero de clasificación de Artificial Analysis actual enumera puntuaciones del Índice de Inteligencia de 46 para Kimi K3.1 Pro, 34 para Qwen3.8 Max 0902, y 32 para cada uno de DeepSeek V4.1 Flash 1017 en razonamiento máximo y GLM-5.3 en razonamiento máximo. El índice es una medida amplia de capacidad. No mide directamente el costo de corregir un error en tu aplicación.
Esas puntuaciones pertenecen al Índice de Inteligencia v5.0. No las combines con versiones anteriores del índice ni interpretes un cambio entre versiones de evaluación como una disminución en el modelo en sí. También evitamos asignar a GLM-5.3 Flash una puntuación de índice antigua cuando el tablero actual no muestra un valor comparable.
Coding results can point in different directions. In Artificial Analysis's DeepSeek–GLM comparison, GLM leads Terminal-Bench 4.0, while DeepSeek leads FrontierCode 2.0. That split is why this shortlist includes task-specific recommendations and gives cost a role in the order.
1. Kimi K3.1 Pro: Best Overall Coding Candidate
Kimi K3.1 Pro moves into first place because the new release brings stronger evidence for difficult, extended software work. Moonshot's technical blog reports 65.7% on Terminal-Bench 4.0 and 61.2% on its internal Kimi Code Bench 3.0 Long-horizon, compared with K3's 55.95% on the latter. These are vendor-reported results.
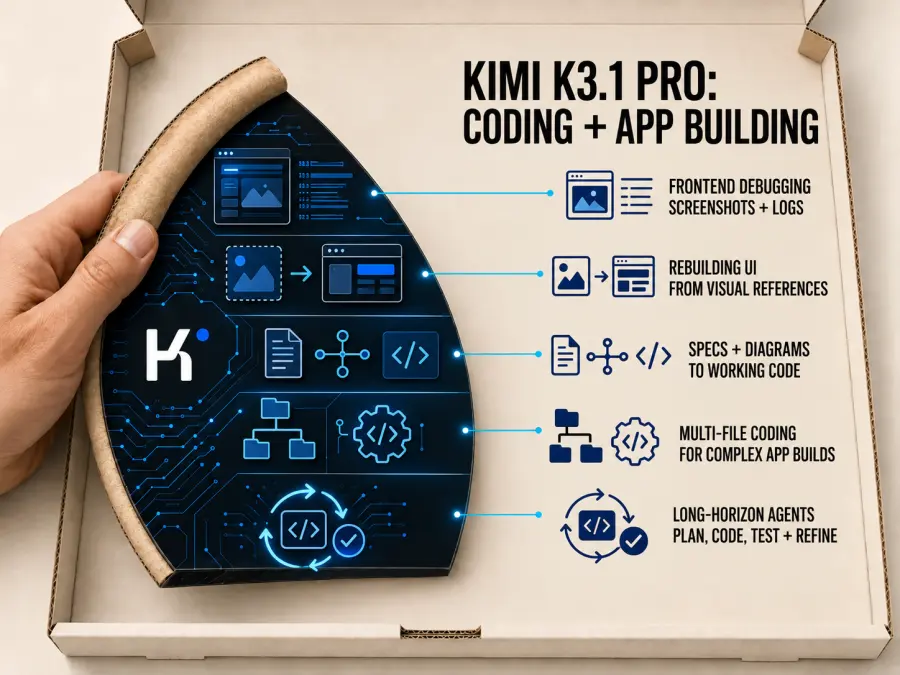
Existe también una señal independiente: Artificial Analysis registra aproximadamente un 67% en Terminal-Bench 4.0. Ese resultado pertenece a su propia configuración de evaluación; debe mantenerse separado de la cifra oficial de Moonshot.
I would test K3.1 Pro first when an agent must understand an unfamiliar application, change several connected files, and keep working after a failed test. For app builders, the useful question is whether it can deliver a feature that meets the brief after implementation and correction.
Its GPT Proto route accepts text and visual input. That makes it a candidate for work combining source code, a design reference, and a rendered interface. It is still worth starting with a bounded task: define the expected behavior and give the agent a way to verify it.
El costo más elevado en tokens es el compromiso a considerar. Resérvalo para tareas donde una mejor calidad de finalización justifique el gasto. Asimismo, mantén precisión sobre el estado de implementación: a fecha de esta actualización, Moonshot tiene programado el lanzamiento de los pesos completos de K3.1 Pro para el 4 de noviembre. Los pesos actuales de K3 no garantizan que K3.1 Pro ya esté disponible para descarga.
Verdict: Start with Kimi K3.1 Pro for a difficult feature or app build, then compare accepted changes and total spend with a cheaper candidate.
2. DeepSeek V4.1 Flash: Best Value for Coding Agents
DeepSeek deserves a higher position when the goal is to keep useful coding capability within a repeatable production budget. It is a candidate for agents that read code, propose patches, inspect test output, and make another attempt.
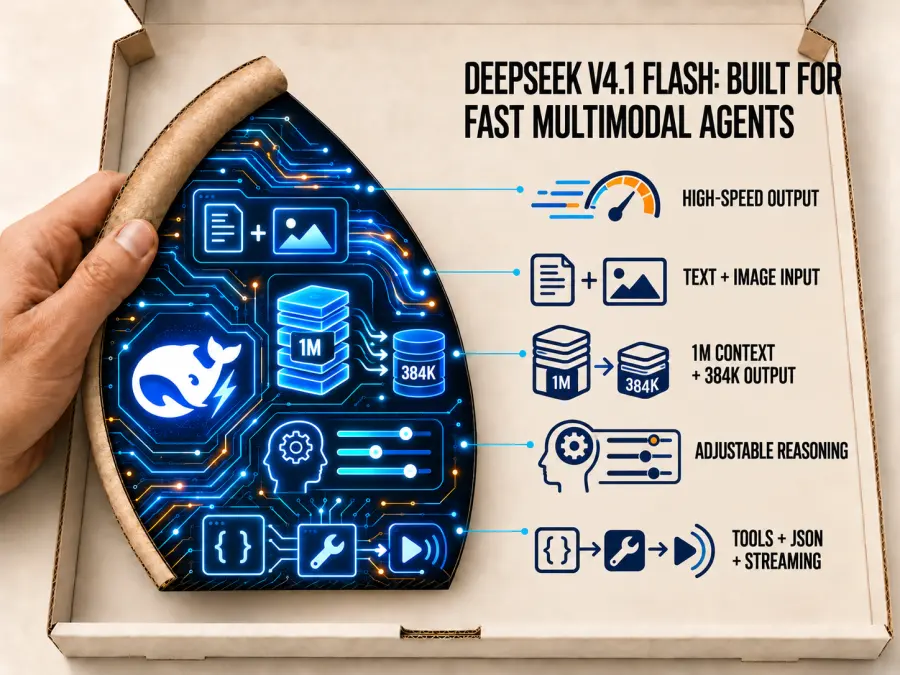
La tarjeta del modelo DeepSeek V4.1 Flash 1017 reporta mejoras respecto a la versión anterior V4.1 Flash: Terminal-Bench 4.0 sube de 31.2 a 42.3, DeepSWE v1.1 de 74.2 a 77.0 y ProgramBench de 20.3 a 29.1. Estas son evaluaciones reportadas por DeepSeek, no una reproducción de GPT Proto.
That update strengthens the case for including DeepSeek in a coding trial. It does not make every other model redundant. Independent coding evaluations still show different winners depending on the task, and a production agent must be judged on the tools and limits it will actually use.
Keep the route distinction explicit. GPT Proto exposes DeepSeek Flash using deepseek-flash; its public page describes V4.1 Flash without identifying the 1017 checkpoint. Confirm the deployed revision before treating the newer results as evidence about that exact endpoint.
Verdict: Test DeepSeek as the value-first implementation model. Record the model revision alongside success rate, retries, latency, and spend so a later alias update does not make the comparison ambiguous.
3. Qwen3.8-Max-0902: La mejor opción para frontend y depuración visual
Qwen sigue siendo una opción útil cuando una tarea de programación comienza con algo visual: una página de referencia, un diseño roto, un gráfico o una secuencia de estados de interfaz. La ruta Qwen3.8-Max-0902 admite entrada multimodal, lo que permite a una aplicación combinar material visual con código e instrucciones.
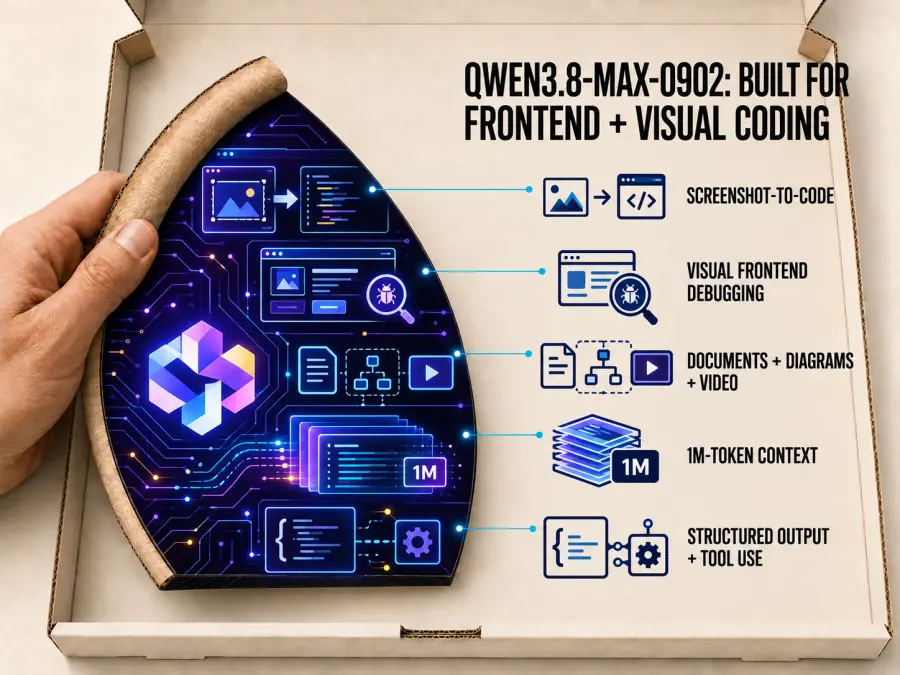
Para una evaluación de frontend, proporciónale la misma referencia de diseño y acceso al repositorio que a los otros candidatos. Pídele al agente que implemente la página, la renderice, verifique los estados importantes y corrija el resultado. Evalúa el espaciado, la jerarquía, la capacidad de respuesta y las interacciones funcionales junto con la precisión del código.
Es por eso que Qwen mantiene un lugar destacado aquí incluso después de la actualización de Kimi. Una selección para frontend requiere criterios de aceptación visual, y una puntuación de inteligencia general solo describe parcialmente ese trabajo. Esta es nuestra recomendación de flujo de trabajo; no es una afirmación de que Qwen haya ganado una nueva prueba de frontend de cinco modelos.
La relación costo-beneficio es sencilla: sus tarifas de tokens mostradas son más altas que las de DeepSeek y GLM Flash. Para un pequeño parche de solo texto, incluye una de esas rutas más económicas en la prueba. Además, mantén la instantánea alojada 0902 exacta separada de cualquier punto de control descargable relacionado al documentar las características.
Veredicto: Incluye a Qwen en tu lista de preseleccionados cuando hacer coincidir un resumen visual sea fundamental para el éxito de la implementación.
4. GLM-5.3: La mejor opción para trabajo en repositorios basado en texto
GLM-5.3 sigue siendo relevante para la investigación de código, tareas de terminal y cambios cuya evidencia esté disponible como texto. La clasificación actualizada otorga a Kimi la recomendación general, mientras mantiene a GLM como un candidato enfocado en la programación entre los modelos LLM chinos.
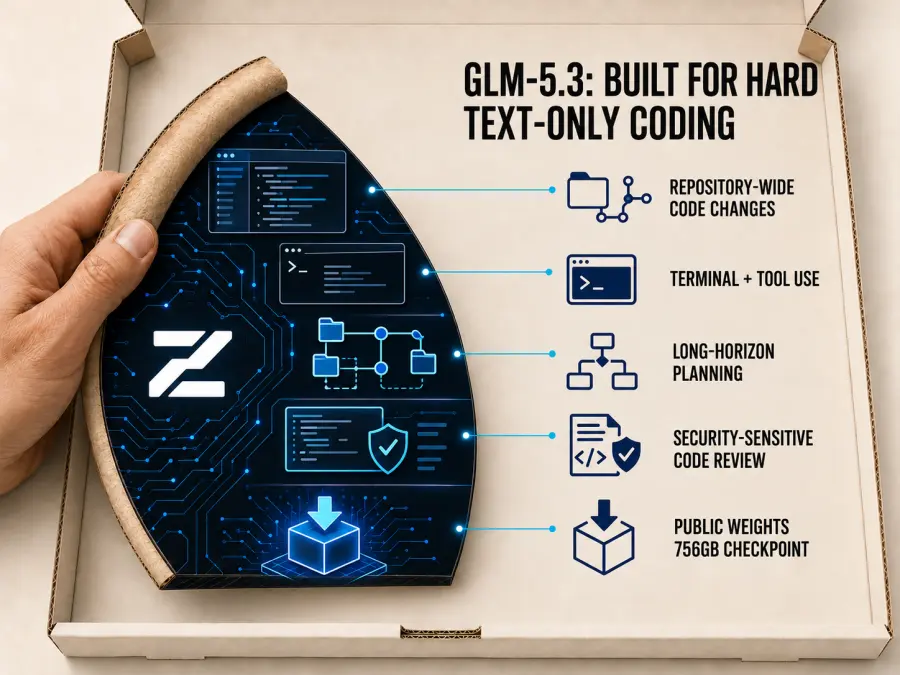
La comparativa independiente entre DeepSeek y GLM ilustra su posición: GLM obtiene un 42% en Terminal-Bench 4.0 frente al 34% de DeepSeek 1017, mientras que FrontierCode 2.0 favorece a DeepSeek con un 28% frente al 22%. Esos resultados describen la configuración de ese evaluador, por lo que no deben sustituirse por las ejecuciones configuradas de manera diferente de los proveedores.
Yo mantendría a GLM en una prueba que involucre una integración de backend fallida, una dependencia desconocida o un cambio en el repositorio que requiera varios ciclos de comando y prueba. Los criterios de aceptación deben incluir una prueba de reproducción exitosa y una explicación de lo que cambió.
La página de GPT Proto sobre GLM-5.3 documenta la entrada y salida de texto. Si el agente necesita inspeccionar una captura de pantalla directamente, utiliza una ruta visual para ese paso. Sus tarifas de tokens más altas en comparación con los modelos económicos también hacen que valga la pena medir los reintentos repetidos.
Veredicto: Mantén GLM-5.3 para flujos de trabajo de repositorio y terminal donde pase tus pruebas de manera consistente. Compáralo con Kimi para tareas difíciles y con DeepSeek por costo.
5. GLM-5.3 Flash: Best Budget Visual-Coding Candidate
GLM-5.3 Flash keeps its place because frequent agent calls can make token rates matter more than a small difference in headline capability. It has the lowest displayed input and output rates among these five GPT Proto entries in the pricing snapshot below.
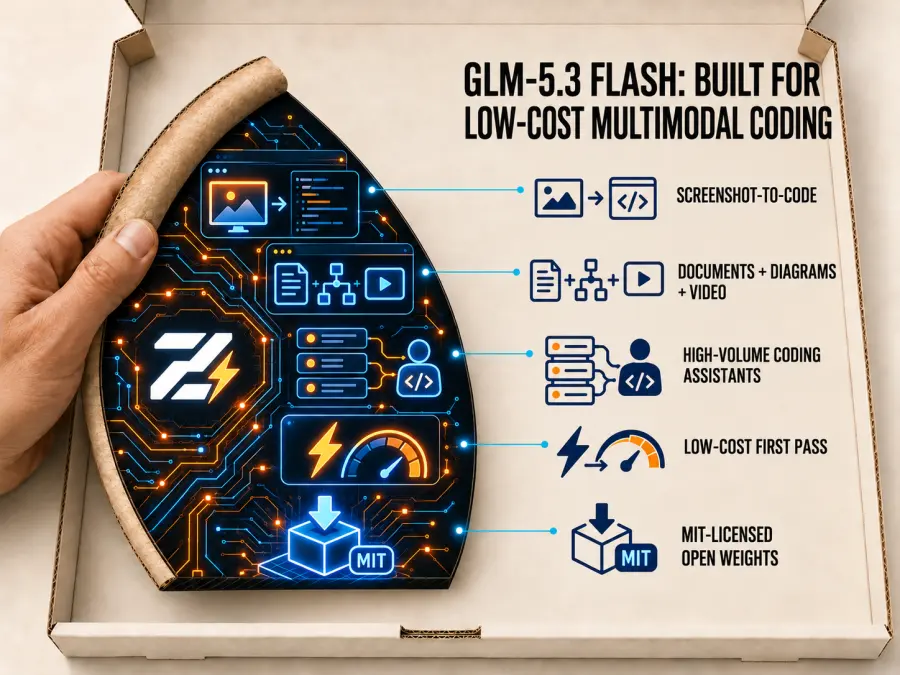
The model page documents text, image, video, and file input, along with MIT-licensed weights. It also explains that Flash uses a different multimodal base from standard GLM-5.3. Treat the two as separate candidates when building a routing policy.
A practical evaluation would assign Flash a bounded issue, a visual layout check, or an initial implementation. Keep the same acceptance tests used for the larger models. If the result fails, count the failed attempt and the escalation in the total cost.
Low rates leave room for iteration, but repeated unproductive attempts can erase that advantage. Measure how often the task succeeds before choosing it as the default. Reasoning is always enabled on the documented model, so include reasoning-token use and response time in that check.
Verdict: Test GLM-5.3 Flash as the budget default for visual coding and recurring subtasks, with a clear escalation path for failures.
Honorable Mentions
MiniMax M3.1 Flash
MiniMax's current candidate deserves attention beyond the older M3 entry. The October 19 release announcement reports 73.7% on DeepSWE v1.1 and emphasizes lower-cost agent execution. That makes M3.1 Flash relevant to the same budget discussion as DeepSeek and GLM Flash.
Keep it in the research shortlist until the exact GPT Proto route, model ID, pricing, and supported features are confirmed. An existing MiniMax M3 endpoint should not be labeled M3.1 Flash without verification.
Xiaomi MiMo-V2.6 and Other Emerging Models
MiMo-V2.6 remains worth monitoring; Artificial Analysis includes MiMo-V2.6-Pro in its evaluations. Give a new model a main-list position after checking both its task evidence and the actual access path being recommended.
Older Kimi K3 and DeepSeek V4 Pro deployments may still be worth keeping when an application depends on validated behavior. Test a replacement on those same tasks before moving existing traffic.
Models to Watch
Step 5 Preview and Xiaomi’s MiMo-V2.6 family are relevant new Chinese models, but they are not included in the main ranking because GPT Proto did not have confirmed live routes for them at the time of this update. Add them to the ranked list only after the exact model page, API string, price, and supported request fields are live and tested.
Una tarea de programación real, cinco opciones diferentes
Imagina que debes añadir un sistema de suscripción a una aplicación SaaS en TypeScript existente. El agente debe comprender el modelo de usuario actual, implementar un flujo de pago, gestionar eventos de webhook de forma segura, actualizar los permisos de la cuenta y verificar el resultado.
| Requisito |
Candidato a evaluar |
Qué verificar |
| Implementar la función conectada en varios archivos |
Kimi K3.1 Pro |
Comportamiento correcto, cambios coherentes y recuperación tras pruebas fallidas |
| Ejecutar intentos repetidos de implementación y corrección |
DeepSeek V4.1 Flash |
Correcciones aceptadas por dólar; registrar la revisión entregada |
| Ajustar la interfaz de facturación a una referencia de diseño |
Qwen3.8-Max-0902 |
Precisión visual, comportamiento responsivo y estados de funcionamiento |
| Diagnosticar fallos en el backend y la terminal |
GLM-5.3 |
Calidad de reproducción, uso de comandos y resultados de pruebas |
| Gestionar implementaciones acotadas o comprobaciones visuales a bajo costo |
GLM-5.3 Flash |
Tasa de fallos, reintentos y costo incluyendo escalaciones |
Para este ejemplo, un botón de pago atractivo es solo una parte del resultado. El webhook debe verificarse, los eventos duplicados no deben otorgar beneficios duplicados y los cambios de suscripción deben actualizar la cuenta correcta. Escribe esas pruebas de aceptación antes de comparar los modelos.
¿Cuánto costaría la misma tarea de programación?
Para una comparación simple del costo por token, supongamos 100,000 tokens de entrada no almacenados en caché y 20,000 tokens de salida facturables por intento. Lo siguiente utiliza los paneles de precios mostrados por GPT Proto verificados el 29 de octubre de 2026. Las tarifas están en USD por millón de tokens; no se asumen ahorros por caché ni por horas de baja demanda.
El cálculo es 0.1 × tarifa de entrada + 0.02 × tarifa de salida. La fila de DeepSeek muestra los precios de la ruta de GPT Proto; no establece el punto de control servido por ese alias.
Estos son cargos ilustrativos por token. La salida real debe incluir el razonamiento facturable cuando corresponda, y una tarea completa puede implicar más turnos, resultados de herramientas, reintentos u otro modelo. Consulta el panel de precios en vivo al planificar tu gasto.
Mide el gasto total de la API dividido por los cambios que superan tus pruebas de aceptación. Eso ofrece una comparación más útil que asumir que cada modelo completa la tarea con la misma cantidad de tokens.
Why the Benchmark Winner May Not Be the Best Coding Agent
Your coding agent controls which files the model sees, how tools are called, when tests run, and what happens after failure. Changing that setup can change the result even when the model stays the same.
Before comparing candidates, hold the repository, task instructions, tools, acceptance tests, and time limit constant. Allow each model the request format it requires, and record its reasoning settings. Then measure completed tasks, regressions, retries, elapsed time, and API spend.
For this shortlist, use Kimi to test the capability ceiling, DeepSeek and GLM Flash to test production economics, Qwen for visual acceptance, and GLM for text-based repository execution. Let the results determine which stages share a model and which need a different route.
Which Chinese Coding Model Should You Use?
Choose Kimi K3.1 Pro first when completing a difficult feature or app is the priority and you can justify a higher per-token budget.
Choose DeepSeek V4.1 Flash when repeated agent calls make cost important. Confirm the deployed revision before basing a rollout on 1017-specific evidence.
Choose Qwen3.8-Max-0902 when the implementation must match screenshots, layouts, or other visual references.
Choose GLM-5.3 when your evaluation centers on source code, terminal output, and backend behavior.
Choose GLM-5.3 Flash when you want a low-rate visual-coding candidate and can detect failures before escalating them.
For an initial comparison, use one bounded task that already has a reliable acceptance test. A small verified change gives you more useful deployment evidence than a large generated application that nobody has checked.
Cómo llamar a estos modelos LLM chinos a través de una sola API
Abre la página del modelo que deseas probar y utiliza Probar este modelo → Inicio rápido. Crea o selecciona una clave de API de GPT Proto y usa Copiar Markdown para IA para proporcionar las instrucciones de integración actuales a tu asistente de programación.
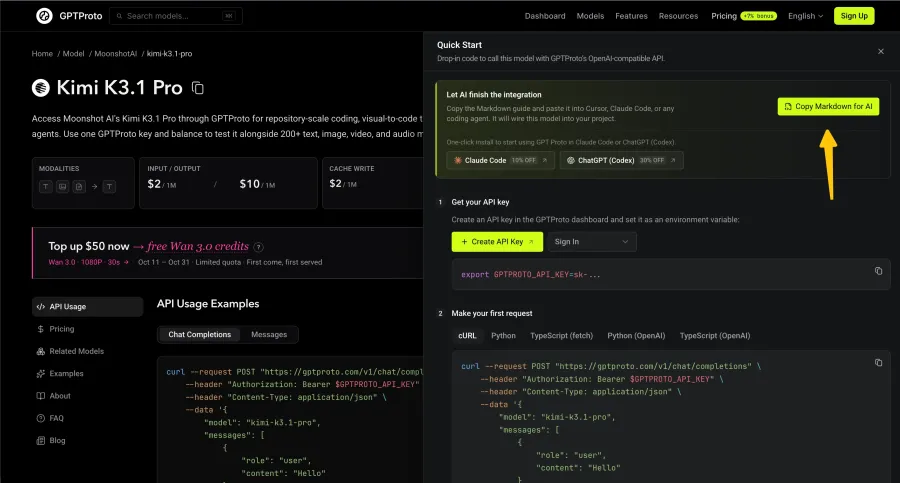
Pídele que inspeccione tu proyecto, siga los endpoints y campos de solicitud copiados, mantenga la clave en la configuración del lado del servidor y añada una pequeña verificación de conexión. Configura la clave real de forma local en lugar de pegarla en un prompt público o en un repositorio.
Los siguientes IDs de modelo identifican las rutas públicas de GPT Proto revisadas para esta actualización:
| Modelo |
ID de modelo de GPT Proto |
| Kimi K3.1 Pro |
kimi-k3.1-pro |
| DeepSeek Flash |
deepseek-flash |
| Qwen3.8-Max-0902 |
qwen3.8-max-0902 |
| GLM-5.3 |
glm-5.3 |
| GLM-5.3 Flash |
glm-5.3-flash |
Utiliza la guía de la página del modelo en vivo para cada ruta. Los modelos pueden diferir en los campos de razonamiento, el manejo de llamadas a herramientas y el formato de solicitud multimodal, por lo que cambiar la cadena del modelo es solo una parte de la migración. Una solicitud única exitosa debe ir seguida de una prueba de uso de herramientas de múltiples turnos antes de su uso en producción.
Conectar una API de modelo a tu aplicación es también una tarea distinta a la de cambiar el modelo que impulsa tu asistente de programación. Verifica el formato de conexión compatible del cliente para esto último.
Compara todos los modelos de GPT Proto antes de asignar tráfico de producción. Puedes usar una sola clave de API y un saldo compartido para evaluar diferentes modelos compatibles sin necesidad de mantener una integración separada ni una cuenta prepagada para cada proveedor.
Abre Kimi K3.1 Pro para comenzar con una tarea de programación compleja, o compara DeepSeek Flash y GLM-5.3 Flash cuando la prioridad sea el costo por llamadas repetidas. Utiliza la guía de integración de la página del modelo y verifica un pequeño cambio antes de ampliar la carga de trabajo.