アプリ開発、コーディングエージェント、ビジュアルデバッグ、APIコストの観点から、Kimi K3.1 Pro、DeepSeek V4.1 Flash、Qwen3.8-Max-0902、GLM-5.3、GLM-5.3 Flashを比較します。
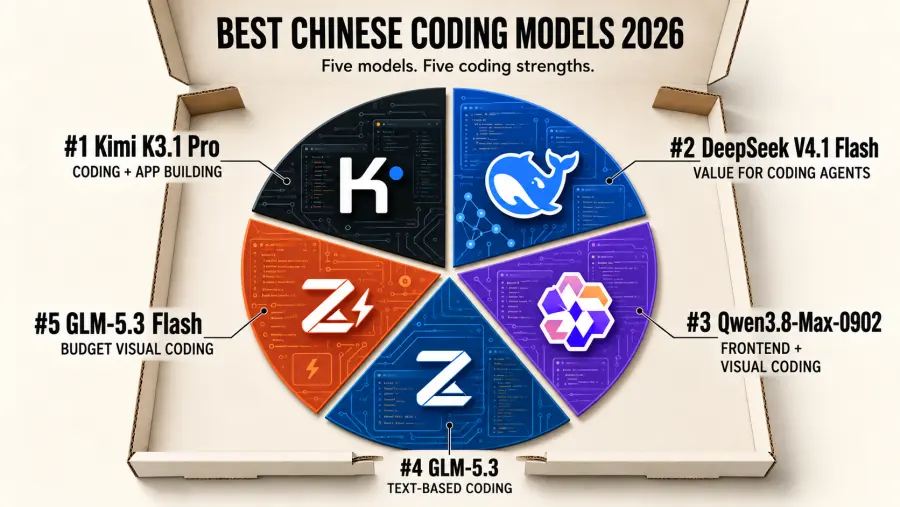
10月29日更新のこの記事では、高度なコーディングやアプリ構築作業において、Kimi K3.1 Proを第一の推奨モデルとして挙げます。DeepSeek V4.1 Flashは、コーディングエージェントによる繰り返し呼び出しにおいてコストパフォーマンスに優れた候補です。Qwen3.8-Max-0902はフロントエンドの視覚的作業、GLM-5.3はテキストベースのリポジトリタスク、GLM-5.3 Flashは小規模な開発予算向けとして、それぞれ選定リストに残しています。
最適な選択は、リポジトリのテストスイート、視覚的な比較、動作する統合環境、あるいはコスト上限など、何を優先すべきかによって決まります。あるモデルが特定の判断基準で優れていても、別の基準では劣る場合があるためです。
今回の更新では、Kimi K3をK3.1 Proに差し替え、DeepSeek 1017リリースの情報を追加し、価格比較を最新のものに更新しました。順序は、能力、タスクへの適合性、コストなど、コーディングに焦点を当てた選定優先順位を反映しています。これは特定のベンチマーク結果をそのまま再現したものではなく、編集部による推奨です。
2026年10月29日更新。主要な5つのモデルには、公開されているGPTProtoモデルページがあります。ベンチマークのスナップショットとプロバイダーのルートは個別に識別されています。以下のDeepSeek 1017の結果は、バージョン指定のないAPIエイリアスが現在どのチェックポイントを提供しているかを確定させるものではありません。
要約
総合的に最適なコーディング候補: Kimi K3.1 Pro
コスト重視のコーディングエージェント候補: DeepSeek V4.1 Flash(デプロイ前に1017アップグレードを確認する価値あり)
フロントエンドおよびビジュアルデバッグに最適: Qwen3.8-Max-0902
テキストベースのリポジトリおよびターミナルワークフローに最適: GLM-5.3
本リスト内で最も低いトークン単価: GLM-5.3 Flash
困難な実装がボトルネックとなっている場合は、まずKimiから試してください。繰り返し呼び出しがコストの大半を占める場合は、DeepSeekとGLM Flashを比較検討しましょう。スクリーンショットが受け入れテストの一部に含まれる場合は、Qwenなどの視覚モデルを評価対象に含めてください。
中国製LLMモデルの概要
| 順位 |
モデル |
推奨用途 |
主なトレードオフ |
| 1 |
Kimi K3.1 Pro |
難易度の高いコーディング、アプリ構築、拡張エージェントタスク |
予算重視の候補よりもトークン単価が高い |
| 2 |
DeepSeek V4.1 Flash |
コスト意識の高いコーディングエージェントおよび反復的な実装作業 |
1017ベンチマーク結果を適用する前に、提供されているチェックポイントを確認すること |
| 3 |
Qwen3.8-Max-0902 |
フロントエンド実装および視覚的なデバッグ |
DeepSeekやGLM Flashよりもトークン単価が高い |
| 4 |
GLM-5.3 |
テキストベースのリポジトリ調査およびターミナルタスク |
ネイティブな視覚的エビデンスには別のルートが必要 |
| 5 |
GLM-5.3 Flash |
予算重視の視覚的コーディングおよび頻繁なエージェントサブタスク |
本番環境で唯一のモデルとして採用する前に、困難なタスクでテストすること |
価格比較を以下に示します。価格と機能を分けて考えることで、特定のタスクにおいて高価なモデルを試す価値がある理由を理解しやすくなります。
速度測定値は、Artificial Analysisによって測定された各モデル作成者のAPIに基づいています。これらは有用なスナップショットであり、GPT Protoのレイテンシを保証するものではありません。プロバイダーの負荷、プロンプトの長さ、推論の負荷、キャッシュの動作、出力の長さによって、本番環境のパフォーマンスは変化する可能性があります。
モダリティ列は、GPT Protoによって公開されているルートを説明しています。ダウンロード可能なチェックポイントと、同じ名前のホスト型APIでは、提供される機能が同一ではない場合があります。
中国製コーディングモデルのランキング評価方法
パラメータ数や100万トークンのコンテキストウィンドウの大きさだけでは、そのモデルがリポジトリ単位のタスクを完遂できるかどうかは分かりません。本ランキングの5つのモデルは、いずれもほぼ同等のロングコンテキストクラスに属しています。それらの実用的な違いは、別の部分に現れます。
私たちは以下の6つの質問を考慮しました:
開発者が公開するベンチマークチャートだけでなく、独立した評価においてモデルはどのようなパフォーマンスを示すか?
複数ファイルのコーディング、ターミナル作業、ツール呼び出し、そして「計画・実行・検証」のループを維持できるか?
テキスト以外の証拠(スクリーンショット、図、ドキュメント、記録された製品フローなど)を検証できるか?
出力トークン、推論、および発生しうる再試行を含めた場合、現実的なAPIタスクのコストはいくらか?
モデルの重みは実際にダウンロード可能か、また商用展開にはどのようなライセンスが適用されるか?
読者が同じアカウントとAPI形式を通じてテストできる、ライブのGPT Protoルートは存在するか?
現在の Artificial Analysisリーダーボード に掲載されているIntelligence Indexスコアは、Kimi K3.1 Proが46、Qwen3.8 Max 0902が34、DeepSeek V4.1 Flash 1017(最大推論時)が32、GLM-5.3(最大推論時)が32となっています。このインデックスは広範な能力指標であり、アプリケーションのバグ修正にかかるコストを直接測定するものではありません。
これらのスコアはIntelligence Index v5.0のものです。以前のインデックスバージョンと混同したり、評価バージョン間の変化をモデル自体の性能低下と解釈したりしないでください。また、現在のリーダーボードに比較可能な値が表示されていない場合、GLM-5.3 Flashに古いインデックススコアを割り当てることは避けています。
コーディングの結果は、評価によって異なる方向を示すことがあります。Artificial AnalysisによるDeepSeekとGLMの比較 では、Terminal-Bench 4.0ではGLMがリードし、FrontierCode 2.0ではDeepSeekがリードしています。このような評価の分かれがあるため、本リストではタスク別の推奨事項を盛り込み、順位付けにおいてコストの要素を考慮しています。
1. Kimi K3.1 Pro:コーディングにおける総合評価第1位
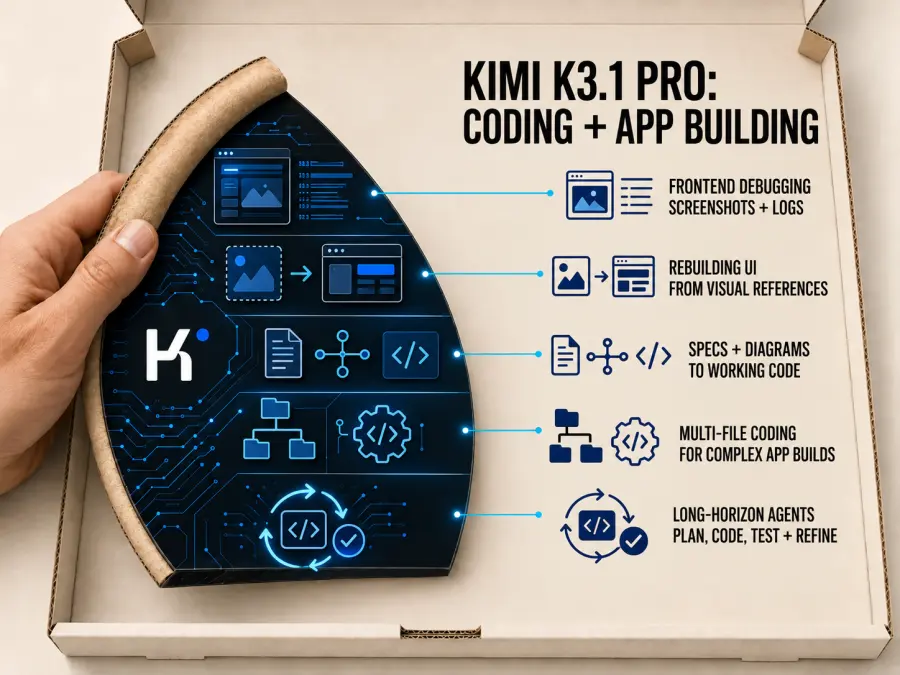
Kimi K3.1 Proが首位に躍り出た理由は、今回の新リリースにより、困難で長期にわたるソフトウェア開発タスクにおいて、より強力なパフォーマンスが実証されたためです。Moonshotの技術ブログによると、Terminal-Bench 4.0で65.7%、独自のKimi Code Bench 3.0 Long-horizonで61.2%を記録しており、後者についてはK3の55.95%から向上しています。これらはベンダーが報告した結果です。
独立した指標も存在します。Artificial Analysisは、Terminal-Bench 4.0で約67%を記録しています。この結果は同社の評価環境によるものであり、Moonshotの数値とは分けて考えるべきです。
エージェントが未知のアプリケーションを理解し、関連する複数のファイルを修正し、テスト失敗後も作業を継続しなければならない場合、私はまずK3.1 Proをテストします。アプリ開発者にとって重要なのは、実装と修正を経て、要件を満たす機能を納品できるかどうかです。
そのGPT Protoルートは、テキストと視覚情報の入力を受け付けます。そのため、ソースコード、デザインリファレンス、レンダリングされたインターフェースを組み合わせる作業の候補となります。まずは期待される動作を定義し、エージェントがそれを検証できる方法を与えるといった、範囲を限定したタスクから始めるのが賢明です。
トークンコストの上昇はトレードオフとなります。完成度の向上がコストを正当化できる作業のために確保しておきましょう。また、デプロイ状況を正確に把握しておくことも重要です。本アップデート時点で、MoonshotはK3.1 Proのフルウェイトを11月4日までにリリースする予定です。既存のK3ウェイトが存在するからといって、K3.1 Proがすでにダウンロード可能であるとは限りません。
結論: 困難な機能実装やアプリ構築にはまずKimi K3.1 Proを試し、その後、より安価なモデルと比較して、採用した変更内容と総コストを検討してください。
2. DeepSeek V4.1 Flash:コーディングエージェントにおけるコストパフォーマンスの最適解
実用的なコーディング能力を反復可能な本番環境の予算内に収めることが目標である場合、DeepSeekはより高い評価に値します。コードを読み込み、パッチを提案し、テスト結果を検証して再試行を行うようなエージェントにとって有力な候補です。
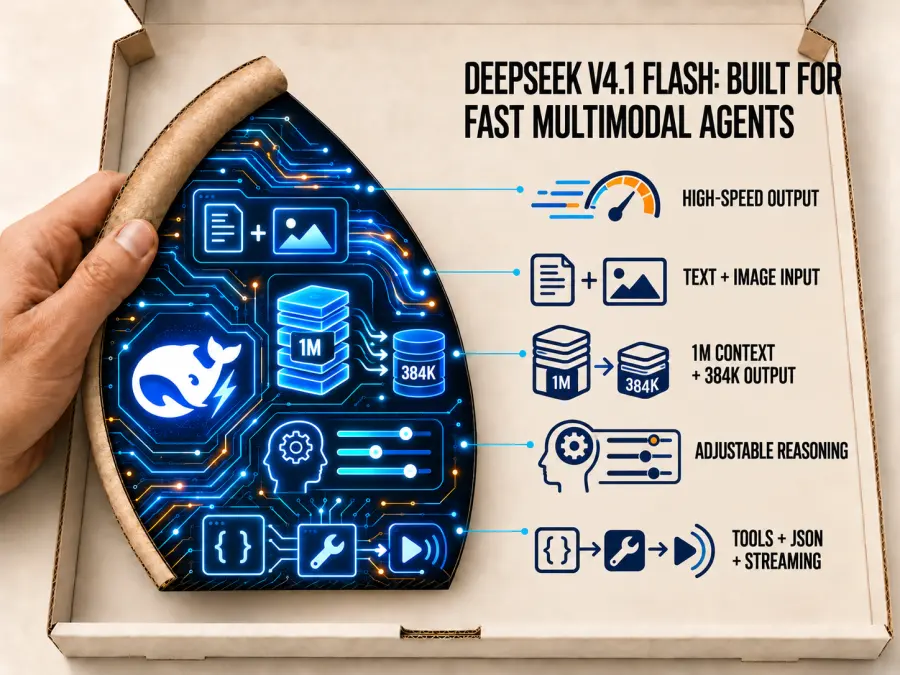
DeepSeek V4.1 Flash 1017モデルカードでは、以前のV4.1 Flashリリースからの改善が報告されています。Terminal-Bench 4.0は31.2から42.3へ、DeepSWE v1.1は74.2から77.0へ、ProgramBenchは20.3から29.1へと向上しました。これらはGPT Protoによる再現結果ではなく、DeepSeekが報告した評価結果です。
このアップデートにより、コーディングの試行にDeepSeekを含める根拠が強化されました。ただし、他のすべてのモデルが不要になるわけではありません。独立したコーディング評価ではタスクに応じて勝者が異なることが依然として示されており、本番環境のエージェントは、実際に使用するツールと制限に基づいて判断されるべきです。
ルートの区別を明確にしてください。GPT ProtoはDeepSeek Flashをdeepseek-flashとして公開していますが、公開ページでは1017チェックポイントを明記せずにV4.1 Flashについて説明しています。新しい結果をそのエンドポイントの証拠として扱う前に、デプロイされているリビジョンを確認してください。
結論: コスト重視の実装モデルとしてDeepSeekをテストしてください。モデルのリビジョンを成功率、再試行回数、レイテンシ、コストとともに記録し、後でエイリアスが更新されても比較が曖昧にならないようにしましょう。
3. Qwen3.8-Max-0902:フロントエンド開発とビジュアルデバッグに最適
コーディングタスクが、参照ページ、壊れたレイアウト、チャート、インターフェース状態のシーケンスなど、視覚的な要素から始まる場合、Qwenは依然として有用な選択肢です。Qwen3.8-Max-0902ルートはマルチモーダル入力をサポートしており、アプリケーションで視覚資料とコード、指示を組み合わせて処理することが可能です。
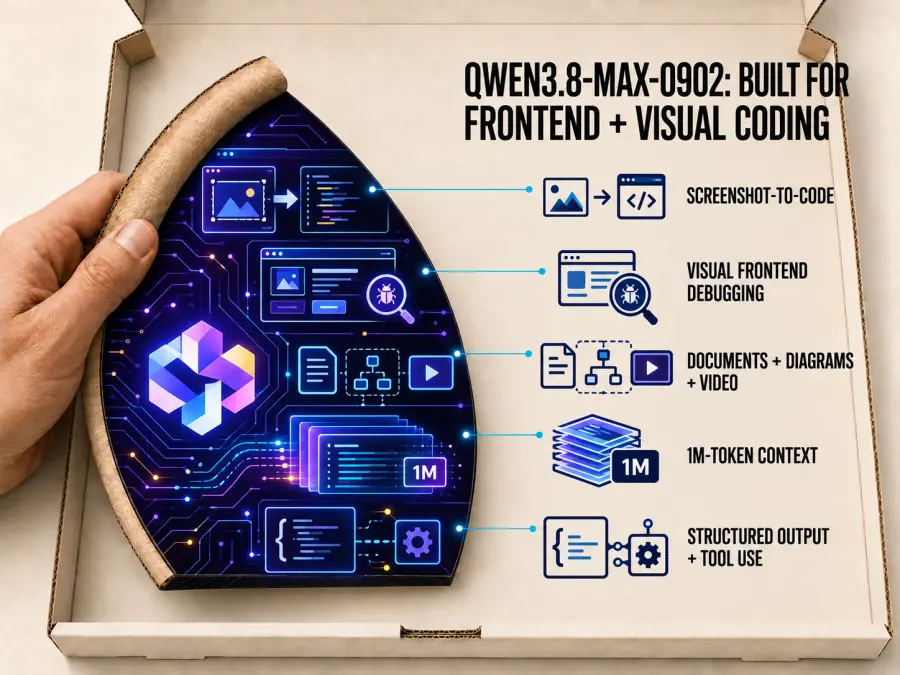
フロントエンドの評価を行う際は、他の候補モデルと同じデザインリファレンスとリポジトリへのアクセス権を与えてください。エージェントにページの実装、レンダリング、重要な状態のチェック、そして結果の修正を指示します。コードの正確性に加え、間隔、階層、レスポンシブ対応、インタラクションの動作を評価してください。
Kimiのアップグレード後もQwenがこのリストに残り続けている理由はそこにあります。フロントエンドの選定には視覚的な合格基準が必要であり、一般的なインテリジェンススコアだけではその作業を完全には記述できないからです。これはあくまで推奨されるワークフローであり、Qwenが5つのモデルによる新しいフロントエンドテストで勝利したと主張するものではありません。
コストのトレードオフは明確です。表示されているトークン単価はDeepSeekやGLM Flashよりも高くなっています。テキストのみの小さな修正であれば、より安価なルートを試用することをお勧めします。また、機能を文書化する際は、特定の0902ホストスナップショットと、関連するダウンロード可能なチェックポイントを混同しないよう注意してください。
結論: 実装の成功が視覚的な要件を満たせるかどうかにかかっている場合は、Qwenを候補リストに入れてください。
4. GLM-5.3:テキストベースのリポジトリ作業に最適
GLM-5.3は、コード調査、ターミナルタスク、およびテキストとして証拠が確認できる変更において、依然として重要な役割を果たします。最新のランキングではKimiを総合的な推奨モデルとしていますが、GLMもコーディングに特化した候補として維持しています。
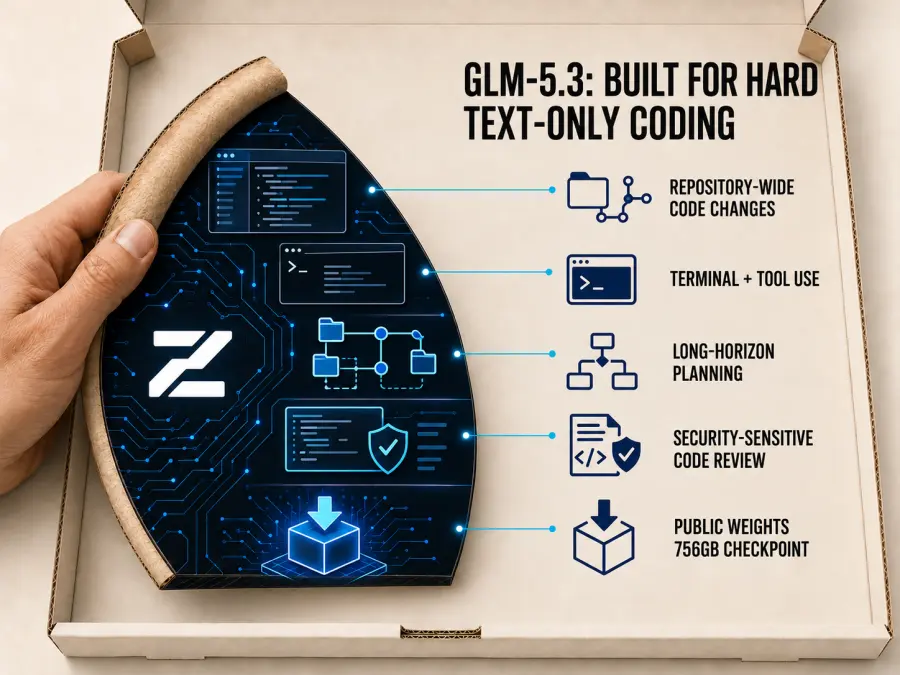
独立したDeepSeekとGLMの比較がその立ち位置を示しています。Terminal-Bench 4.0ではGLMが42%のスコアを記録し、DeepSeek 1017の34%を上回る一方、FrontierCode 2.0ではDeepSeekが28%対22%で優位に立っています。これらの結果はあくまでその評価環境におけるものであり、ベンダーが独自に設定した実行結果の代わりとして扱うべきではありません。
バックエンド統合の失敗、不慣れな依存関係、または複数のコマンドとテストのサイクルを必要とするリポジトリ変更を含む試行には、GLMを検討することをお勧めします。合格基準には、再現テストの通過と変更内容の説明を含めるべきです。
GPT Proto GLM-5.3ページには、テキスト入力とテキスト出力に関するドキュメントが記載されています。エージェントがスクリーンショットを直接確認する必要がある場合は、そのステップにビジュアル対応のルートを使用してください。また、予算重視のモデルよりもトークン単価が高いため、繰り返しの再試行にかかるコストを測定する価値があります。
結論: テストを一貫して通過できるリポジトリやターミナルのワークフローにはGLM-5.3を維持してください。難しいタスクについてはKimiと比較し、コスト面ではDeepSeekと比較検討してください。
5. GLM-5.3 Flash:予算重視のビジュアルコーディングに最適な候補
GLM-5.3 Flashがランクインし続けている理由は、エージェントによる頻繁な呼び出しを行う場合、わずかな性能差よりもトークン単価が重要になるためです。以下の価格比較表で示す通り、今回取り上げた5つのGPT Proto対応モデルの中で、入力および出力の単価が最も低く設定されています。
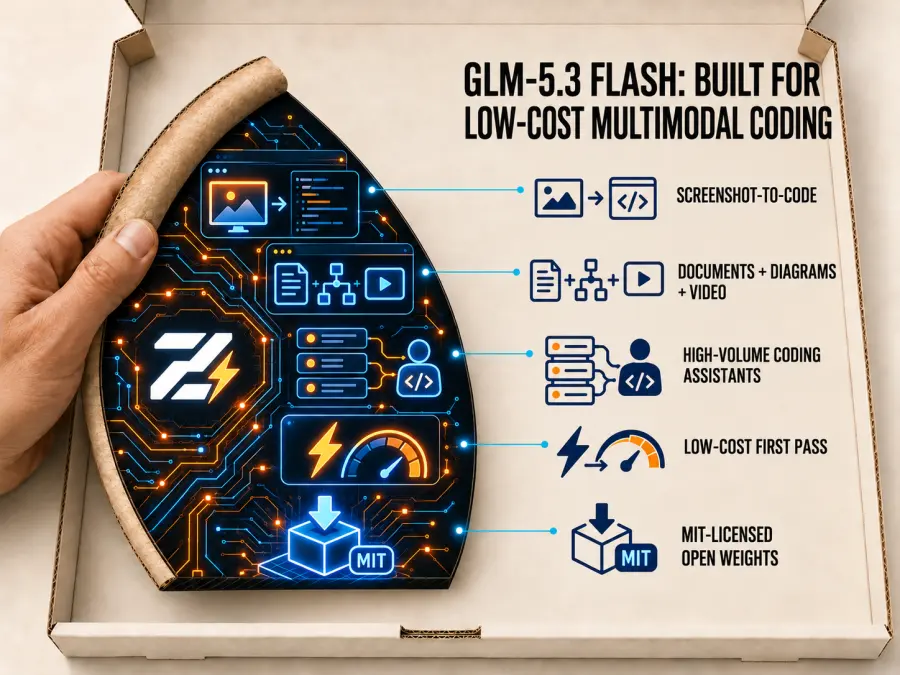
モデルページには、テキスト、画像、動画、ファイルの入力に関するドキュメントと、MITライセンスのウェイトが公開されています。また、Flashは標準のGLM-5.3とは異なるマルチモーダルベースを使用していることも説明されています。ルーティングポリシーを構築する際は、両者を別々の候補として扱うようにしてください。
実用的な評価を行うには、Flashに対して限定的な課題、ビジュアルレイアウトのチェック、または初期実装を割り当ててみてください。より大規模なモデルで使用しているものと同じ受け入れテストを適用します。結果が失敗した場合は、その試行回数とエスカレーションにかかる総コストを計算に含めてください。
低コストであれば試行錯誤の余地は広がりますが、非効率な試行を繰り返すとその利点は相殺されてしまいます。デフォルトとして選択する前に、タスクの成功率を測定してください。ドキュメント化されたモデルでは推論機能が常に有効になっているため、その確認には推論トークンの使用量と応答時間を含める必要があります。
結論: ビジュアルコーディングや繰り返し発生するサブタスクの予算重視のデフォルトとしてGLM-5.3 Flashをテストし、失敗時の明確なエスカレーションパスを準備してください。
次点(Honorable Mentions)
MiniMax M3.1 Flash
MiniMaxの現在の候補は、旧来のM3エントリーを超えて注目に値します。10月19日のリリース発表では、DeepSWE v1.1で73.7%のスコアを記録したことと、低コストなエージェント実行が強調されています。これにより、M3.1 FlashはDeepSeekやGLM Flashと同様の予算に関する議論において重要な存在となります。
正確なGPT Protoのルート、モデルID、価格、サポートされている機能が確認されるまでは、調査対象の候補リストに留めておいてください。既存のMiniMax M3エンドポイントを、検証なしにM3.1 Flashとラベル付けすべきではありません。
Xiaomi MiMo-V2.6およびその他の新興モデル
MiMo-V2.6は監視する価値があります。Artificial Analysisは評価にMiMo-V2.6-Proを含めています。新しいモデルをメインリストに加える際は、そのタスクの証拠と、推奨される実際のアクセスパスの両方を確認してからにしてください。
アプリケーションが検証済みの動作に依存している場合、古いKimi K3やDeepSeek V4 Proのデプロイメントを維持する価値があるかもしれません。既存のトラフィックを移行する前に、同じタスクで代替モデルをテストしてください。
注目のモデル
Step 5 PreviewやXiaomiのMiMo-V2.6ファミリーは関連性の高い新しい中国製モデルですが、本アップデート時点でGPT Protoにおいて確認済みのライブルートが存在しなかったため、メインランキングには含まれていません。正確なモデルページ、API文字列、価格、サポートされているリクエストフィールドが公開され、テストされた後にランキングリストに追加してください。
1つの実際のコーディングタスク、5つの異なる選択肢
既存のTypeScript SaaSアプリケーションにサブスクリプション課金機能を追加することを検討してください。エージェントは、現在のユーザーモデルを理解し、チェックアウトフローを実装し、Webhookイベントを安全に処理し、アカウント権限を更新し、結果を検証する必要があります。
| 要件 |
評価対象の候補 |
確認事項 |
| 複数のファイルにまたがる接続機能の実装 |
Kimi K3.1 Pro |
正しい動作、一貫性のある変更、テスト失敗後の復旧 |
| 繰り返し実装と修正を試行 |
DeepSeek V4.1 Flash |
コストあたりの承認済み修正数、提供されたリビジョンの記録 |
| 課金インターフェースをデザインリファレンスに合わせる |
Qwen3.8-Max-0902 |
視覚的な正確性、レスポンシブな動作、動作状態 |
| バックエンドおよびターミナルの障害診断 |
GLM-5.3 |
再現品質、コマンドの使用、テスト結果 |
| 限定的な実装や視覚チェックを低コストで処理 |
GLM-5.3 Flash |
失敗率、再試行、エスカレーションを含むコスト |
この例では、見栄えの良いチェックアウトボタンは結果の一部に過ぎません。Webhookは検証される必要があり、重複するイベントによって特典が二重に付与されてはならず、サブスクリプションの変更は正しいアカウントを更新する必要があります。モデルを比較する前に、それらの受け入れテストを作成してください。
同じコーディングタスクのコストは?
単純なトークンコスト比較のために、1回の試行でキャッシュされていない入力トークンを100,000、課金対象の出力トークンを20,000と仮定します。以下は、2026年10月29日に確認されたGPT Protoの表示価格パネルを使用しています。料金は100万トークンあたりの米ドルであり、キャッシュやオフピーク時の割引は考慮していません。
計算式は 0.1 × 入力レート + 0.02 × 出力レート です。DeepSeekの行は表示されているGPT Protoルートの価格であり、そのエイリアスによって提供されるチェックポイントを確定するものではありません。
これらは例示的なトークン料金です。実際の出力には、該当する場合は課金対象の推論が含まれる必要があり、完全なタスクにはより多くのターン、ツール結果、再試行、または別のモデルが含まれる可能性があります。支出を計画する際は、最新の価格パネルを確認してください。
受け入れテストに合格した変更数で割ったAPI総支出を測定してください。すべてのモデルが同じトークン数でタスクを完了すると仮定するよりも、より有用な比較が得られます。
ベンチマークの勝者が最高のコーディングエージェントとは限らない理由
コーディングエージェントは、モデルがどのファイルを参照するか、ツールをどのように呼び出すか、テストをいつ実行するか、そして失敗後に何が起こるかを制御します。その設定を変更すると、モデルが同じであっても結果が変わる可能性があります。
候補を比較する前に、リポジトリ、タスクの指示、ツール、受け入れテスト、制限時間を一定に保ってください。各モデルが必要とするリクエスト形式を許可し、その推論設定を記録します。その上で、完了したタスク、リグレッション(退行)、再試行回数、経過時間、APIコストを測定してください。
このショートリストでは、Kimiを使用して能力の限界をテストし、DeepSeekとGLM Flashを使用して本番環境の経済性をテストし、Qwenを視覚的な受け入れテストに、GLMをテキストベースのリポジトリ実行に使用します。結果に基づいて、どの段階でモデルを共有し、どの段階で異なるルートが必要かを判断してください。
どの中国製コーディングモデルを使用すべきか?
困難な機能やアプリの完成が優先され、トークンあたりの予算を高く設定できる場合は、まず Kimi K3.1 Pro を選択してください。
エージェントの呼び出しが繰り返され、コストが重要になる場合は、DeepSeek V4.1 Flash を選択してください。1017固有の証拠に基づいて展開を決定する前に、デプロイされたリビジョンを確認してください。
実装がスクリーンショット、レイアウト、その他の視覚的な参照と一致する必要がある場合は、Qwen3.8-Max-0902 を選択してください。
評価がソースコード、ターミナル出力、バックエンドの動作を中心とする場合は、GLM-5.3 を選択してください。
低レートの視覚的コーディング候補が必要で、エスカレーションの前に失敗を検出できる場合は、GLM-5.3 Flash を選択してください。
最初の比較には、信頼できる受け入れテストが既に存在する限定的なタスクを1つ使用してください。検証済みの小さな変更の方が、誰もチェックしていない大規模な生成アプリケーションよりも、デプロイメントにおいて有用な証拠となります。
これらの中国製LLMモデルを単一のAPIで呼び出す方法
試したいモデルのページを開き、モデルを試す → クイックスタートを使用してください。GPT Proto APIキーを作成または選択し、AI用Markdownをコピーを使用して、現在の統合手順をコーディングアシスタントに伝えてください。
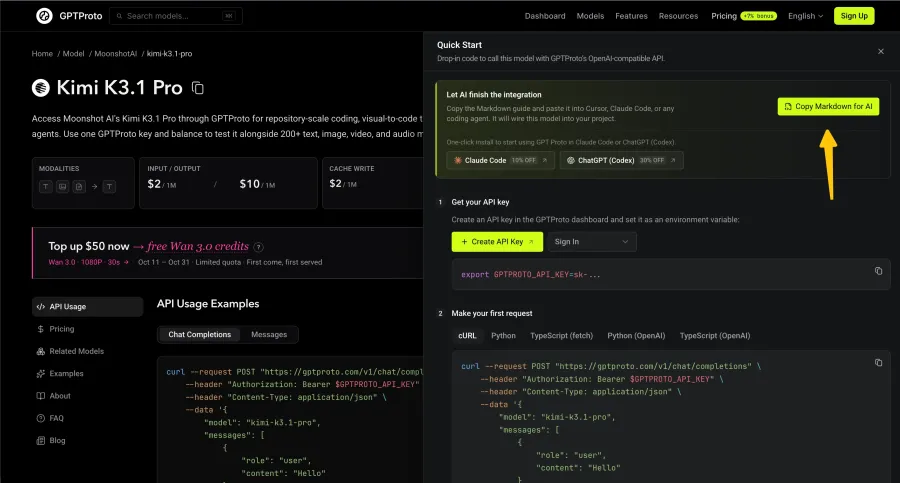
プロジェクトを検査し、コピーしたエンドポイントとリクエストフィールドに従い、キーをサーバー側の設定に保持し、簡単な接続チェックを追加するよう指示してください。キーは公開プロンプトやリポジトリに貼り付けるのではなく、ローカルで設定してください。
以下のモデルIDは、本アップデートでレビューされた公開GPT Protoルートを識別するものです:
| モデル |
GPT ProtoモデルID |
| Kimi K3.1 Pro |
kimi-k3.1-pro |
| DeepSeek Flash |
deepseek-flash |
| Qwen3.8-Max-0902 |
qwen3.8-max-0902 |
| GLM-5.3 |
glm-5.3 |
| GLM-5.3 Flash |
glm-5.3-flash |
各ルートのライブモデルページガイドを使用してください。モデルによって推論フィールド、ツール呼び出しの処理、マルチモーダルリクエストの形式が異なるため、モデル文字列の変更は移行の一部に過ぎません。単一のリクエストが成功した後は、本番環境で使用する前にマルチターンのツール使用テストを行う必要があります。
モデルAPIをアプリケーションに接続することは、コーディングアシスタントを動かすモデルを変更することとは別の作業です。後者については、クライアントがサポートする接続形式を確認してください。
すべてのGPT Protoモデルを比較してから本番トラフィックを割り当ててください。1つのAPIキーと共有残高を使用することで、プロバイダーごとに個別の統合やプリペイドアカウントを維持することなく、サポートされているさまざまなモデルを評価できます。
難しいコーディングタスクから始める場合はKimi K3.1 Proを開くか、繰り返し呼び出しのコストを優先する場合はDeepSeek FlashとGLM-5.3 Flashを比較してください。モデルページの統合ガイドを使用し、ワークロードを拡大する前に小さな変更を1つ検証してください。