Обзор лучших китайских LLM в 2026 году
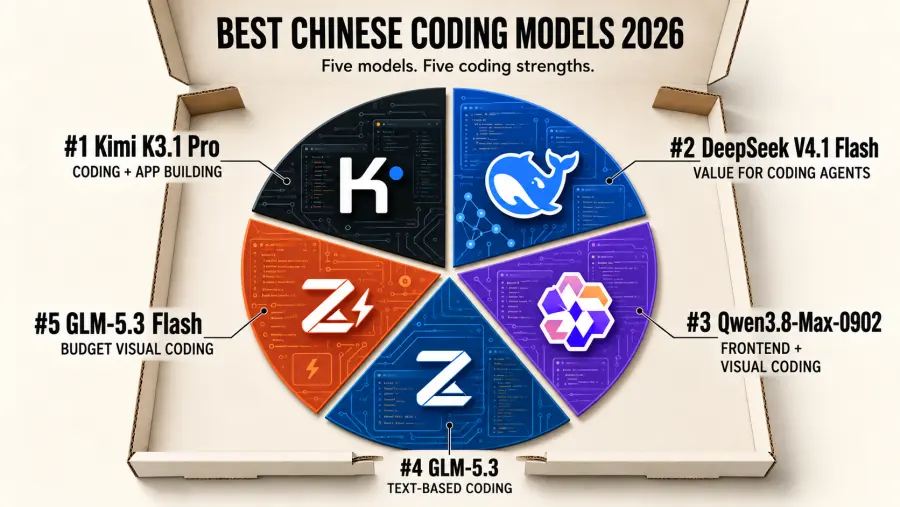
| Рейтинг |
Модель |
Рекомендуемое использование |
Основные компромиссы |
| 1 |
Kimi K3.1 Pro |
Сложное программирование, создание приложений и расширенные задачи для агентов |
Более высокая стоимость токенов по сравнению с бюджетными вариантами |
| 2 |
DeepSeek V4.1 Flash |
Экономичные агенты для программирования и повторяющиеся задачи по реализации |
Проверяйте используемый чекпоинт перед применением результатов бенчмарка 1017 |
| 3 |
Qwen3.8-Max-0902 |
Реализация фронтенда и визуальная отладка |
Более высокая стоимость токенов, чем у DeepSeek и GLM Flash |
| 4 |
GLM-5.3 |
Анализ репозиториев на основе текста и терминальные задачи |
Для работы с визуальными данными требуются другие инструменты |
| 5 |
GLM-5.3 Flash |
Бюджетное визуальное программирование и частые подзадачи для агентов |
Протестируйте сложные задачи, прежде чем делать модель единственной в продакшене |
Сравнение цен представлено ниже. Разделение цены и возможностей позволяет лучше понять, почему более дорогая модель может быть оправдана для конкретной задачи.
Измерения скорости основаны на API от создателей каждой модели, как зафиксировано Artificial Analysis. Это полезные срезы, а не гарантии задержки для GPT Proto. Нагрузка на провайдера, длина промпта, сложность рассуждений, кэширование и длина вывода могут влиять на производительность в реальных условиях.
Столбец модальности описывает маршруты, предоставляемые GPT Proto. Загружаемый чекпоинт и хостинг-API с похожим названием могут не обладать идентичными функциями.
Как мы составляли рейтинг китайских LLM для программирования
Большое количество параметров или контекстное окно в миллион токенов еще не гарантируют, что модель справится с задачей в репозитории. Все пять моделей в этом списке относятся примерно к одному классу по работе с длинным контекстом, поэтому их реальные различия кроются в другом.
Мы проанализировали шесть ключевых аспектов:
Как модель показывает себя в независимых оценках, а не только в бенчмарках от разработчиков?
Способна ли она поддерживать многофайловое программирование, работу в терминале, вызов инструментов и циклы «планирование–выполнение–проверка»?
Может ли она анализировать скриншоты, диаграммы, документы или записи рабочих процессов, когда данные представлены не только в текстовом виде?
Какова реальная стоимость использования API с учетом выходных токенов, рассуждений и вероятных повторных попыток?
Можно ли скачать веса модели и какая лицензия регулирует коммерческое использование?
Есть ли доступный маршрут GPT Proto, который читатели могут протестировать через тот же аккаунт и формат API?
Текущий рейтинг Artificial Analysis показывает индекс интеллекта 46 для Kimi K3.1 Pro, 34 для Qwen3.8 Max 0902 и по 32 для DeepSeek V4.1 Flash 1017 (с максимальным уровнем рассуждений) и GLM-5.3 (с максимальным уровнем рассуждений). Этот индекс является общей мерой возможностей. Он не измеряет напрямую стоимость исправления ошибки в вашем приложении.
Эти оценки относятся к Intelligence Index v5.0. Не сравнивайте их с предыдущими версиями индекса и не считайте изменение показателей между версиями оценки признаком деградации самой модели. Мы также избегаем присвоения GLM-5.3 Flash старого индекса, если текущий рейтинг не отображает сопоставимое значение.
Результаты в программировании могут быть противоречивыми. В сравнении DeepSeek и GLM от Artificial Analysis модель GLM лидирует в Terminal-Bench 4.0, тогда как DeepSeek опережает в FrontierCode 2.0. Именно поэтому данный шорт-лист включает рекомендации по конкретным задачам и учитывает стоимость при определении порядка моделей.
1. Kimi K3.1 Pro: лучший выбор для программирования
Kimi K3.1 Pro выходит на первое место, так как новый релиз демонстрирует более высокую эффективность в сложных и длительных задачах по разработке ПО. В техническом блоге Moonshot сообщается о результатах 65,7% в Terminal-Bench 4.0 и 61,2% во внутреннем тесте Kimi Code Bench 3.0 Long-horizon (по сравнению с 55,95% у K3 в последнем). Это данные, предоставленные самим разработчиком.
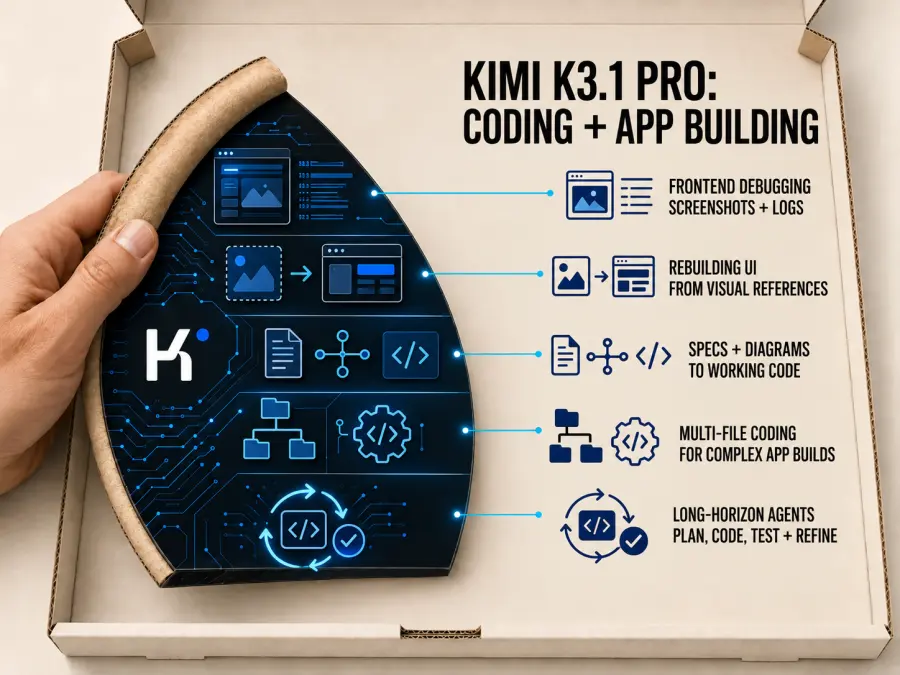
Существуют и независимые подтверждения: Artificial Analysis фиксирует около 67% в Terminal-Bench 4.0. Этот результат получен в рамках их собственной методологии тестирования, поэтому его следует рассматривать отдельно от данных Moonshot.
Я бы рекомендовал начать тестирование с K3.1 Pro, если агенту необходимо разобраться в незнакомом приложении, внести изменения в несколько связанных файлов и продолжить работу после неудачного теста. Для разработчиков приложений ключевой вопрос заключается в том, сможет ли модель реализовать функцию, соответствующую техническому заданию, после внедрения и исправления ошибок.
Маршрут GPT Proto поддерживает текстовый и визуальный ввод. Это делает модель отличным кандидатом для задач, сочетающих исходный код, дизайн-макеты и отрисованный интерфейс. Тем не менее, стоит начинать с ограниченных задач: определите ожидаемое поведение и предоставьте агенту способ его проверки.
Более высокий расход токенов — это компромисс. Используйте эту модель для задач, где улучшенное качество выполнения кода оправдывает затраты. Также уточняйте статус развертывания: на момент обновления Moonshot планирует выпуск полных весов K3.1 Pro к 4 ноября. Наличие весов K3 не означает, что K3.1 Pro уже доступна для скачивания.
Вердикт: Начните с Kimi K3.1 Pro для реализации сложной функции или сборки приложения, а затем сравните принятые изменения и общие расходы с более бюджетным вариантом.
2. DeepSeek V4.1 Flash: лучшее соотношение цены и качества для ИИ-агентов
DeepSeek заслуживает более высокой позиции, когда цель состоит в том, чтобы сохранить полезные возможности программирования в рамках фиксированного производственного бюджета. Это отличный кандидат для агентов, которые читают код, предлагают патчи, проверяют результаты тестов и делают повторные попытки.
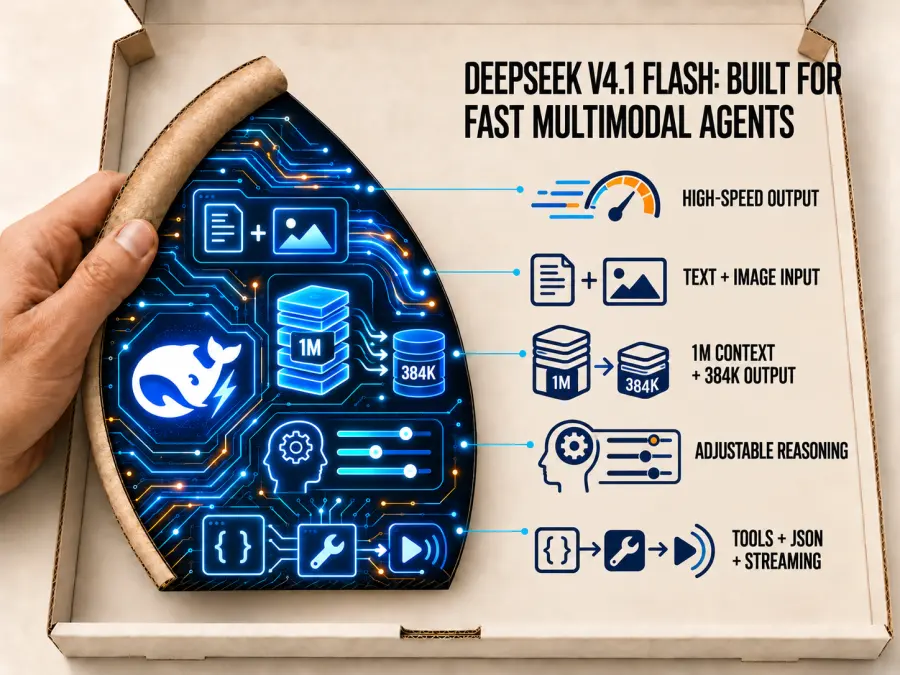
В карточке модели DeepSeek V4.1 Flash 1017 сообщается об улучшениях по сравнению с предыдущим релизом V4.1 Flash: результат в Terminal-Bench 4.0 вырос с 31,2 до 42,3, в DeepSWE v1.1 — с 74,2 до 77,0, а в ProgramBench — с 20,3 до 29,1. Это оценки, предоставленные DeepSeek, а не результаты воспроизведения GPT Proto.
Это обновление усиливает аргументы в пользу включения DeepSeek в тестирование для программирования. Это не делает другие модели избыточными. Независимые оценки кодинга по-прежнему показывают разных лидеров в зависимости от задачи, а производственный агент должен оцениваться по инструментам и ограничениям, которые он будет реально использовать.
Четко различайте маршруты. GPT Proto предоставляет доступ к DeepSeek Flash через deepseek-flash; публичная страница описывает V4.1 Flash без указания чекпоинта 1017. Уточните развернутую версию, прежде чем рассматривать новые результаты как доказательство работы конкретного эндпоинта.
Вердикт: Тестируйте DeepSeek как модель для реализации с упором на экономию. Фиксируйте версию модели вместе с показателями успешности, количеством повторных попыток, задержкой и расходами, чтобы обновление псевдонима в будущем не сделало сравнение неоднозначным.
3. Qwen3.8-Max-0902: лучший выбор для фронтенда и визуальной отладки
Qwen остается полезным инструментом, когда задача по программированию начинается с визуальных элементов: референса страницы, сломанной верстки, графика или последовательности состояний интерфейса. Модель Qwen3.8-Max-0902 поддерживает мультимодальный ввод, позволяя приложению объединять визуальные материалы с кодом и инструкциями.
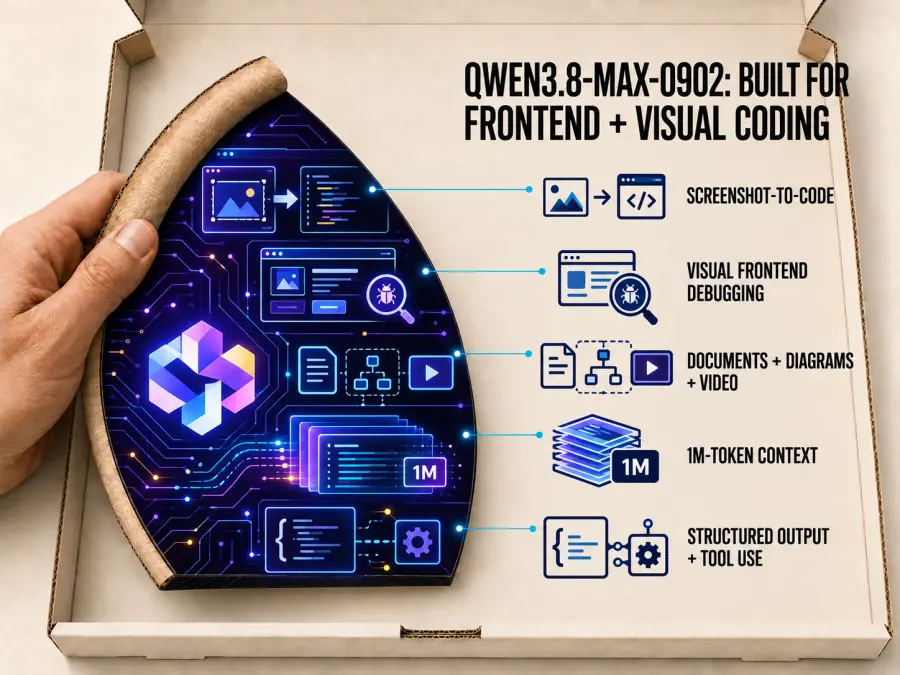
Для оценки фронтенда предоставьте модели тот же дизайн-референс и доступ к репозиторию, что и другим кандидатам. Попросите агента реализовать страницу, отрендерить её, проверить важные состояния и исправить результат. Оценивайте отступы, иерархию, адаптивность и работу интерактивных элементов наряду с корректностью кода.
Именно поэтому Qwen сохраняет свое место в нашем списке даже после обновления Kimi. Для фронтенд-задач требуются визуальные критерии приемки, а общий балл интеллекта лишь частично описывает эту работу. Это наша рекомендация по рабочему процессу; мы не утверждаем, что Qwen победил в новом тесте фронтенд-моделей.
Компромисс по стоимости очевиден: тарифы на токены у этой модели выше, чем у DeepSeek и GLM Flash. Для небольших правок только в текстовом формате включите в тестирование один из этих более бюджетных вариантов. Также при документировании функций держите точный хостинг-снимок 0902 отдельно от любых связанных загружаемых чекпоинтов.
Вердикт: Добавьте Qwen в шорт-лист, если соответствие визуальному брифу является ключевым фактором успеха реализации.
4. GLM-5.3: лучший выбор для работы с репозиторием на основе текста
GLM-5.3 остается актуальным для анализа кода, терминальных задач и изменений, доказательства которых доступны в текстовом виде. В обновленном рейтинге Kimi получает общую рекомендацию, в то время как GLM остается специализированным кандидатом для программирования среди китайских LLM.
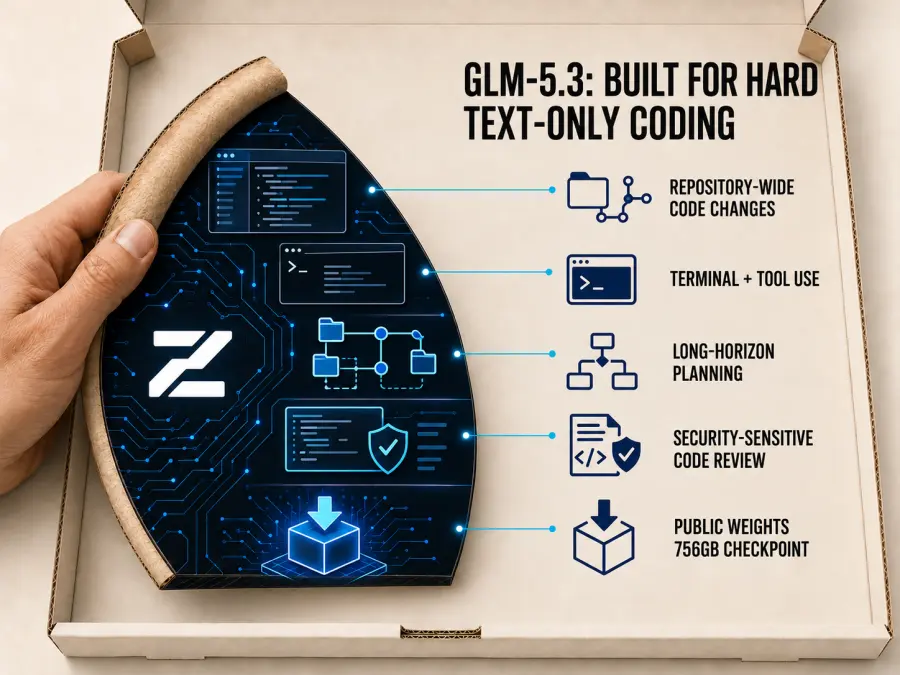
Независимое сравнение DeepSeek и GLM иллюстрирует его позицию: GLM набирает 42% в Terminal-Bench 4.0 против 34% у DeepSeek 1017, в то время как FrontierCode 2.0 отдает предпочтение DeepSeek (28% против 22%). Эти результаты описывают настройки конкретного оценщика, поэтому их не следует подменять результатами, полученными в других конфигурациях вендоров.
Я бы оставил GLM для тестирования, включающего сбои интеграции бэкенда, незнакомые зависимости или изменения в репозитории, требующие нескольких циклов «команда-тест». Критерии приемки должны включать успешный тест на воспроизведение и объяснение того, что именно изменилось.
На странице GPT Proto GLM-5.3 задокументированы текстовый ввод и вывод. Если агенту нужно изучить скриншот напрямую, используйте для этого шага визуальную модель. Более высокие тарифы на токены по сравнению с бюджетными моделями также делают целесообразным измерение затрат при повторных попытках.
Вердикт: Используйте GLM-5.3 для рабочих процессов в репозитории и терминале, где модель стабильно проходит ваши тесты. Сравнивайте её с Kimi для сложных задач и с DeepSeek для оптимизации затрат.
5. GLM-5.3 Flash: лучший бюджетный кандидат для визуального программирования
GLM-5.3 Flash сохраняет свои позиции, поскольку при частых вызовах агентов стоимость токенов может оказаться важнее, чем небольшая разница в базовых возможностях. В приведенной ниже таблице цен эта модель из списка GPT Proto имеет самые низкие тарифы на входные и выходные данные.
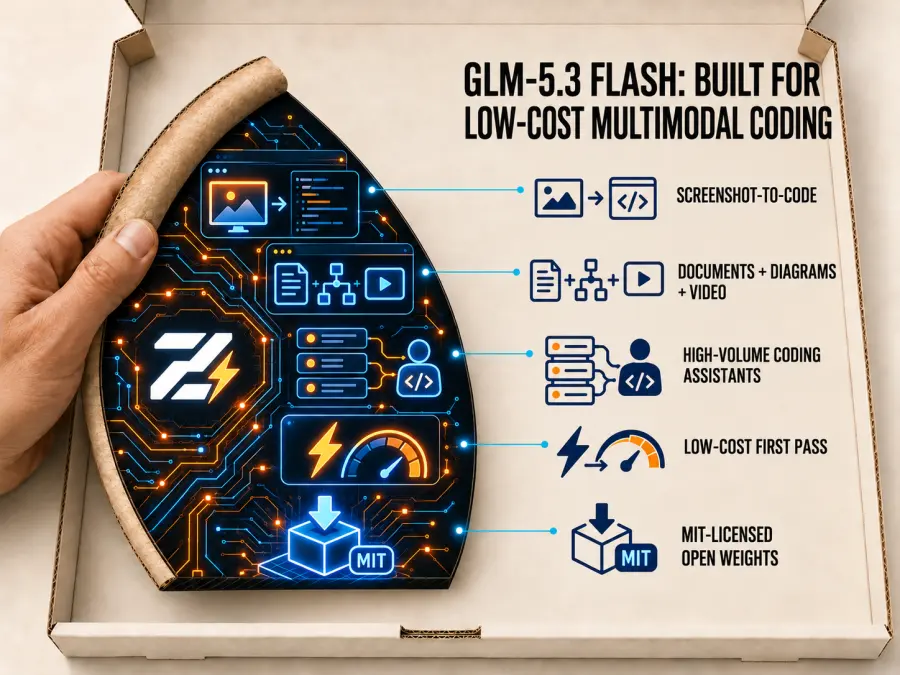
На странице модели указана поддержка ввода текста, изображений, видео и файлов, а также наличие весов с лицензией MIT. Там также поясняется, что Flash использует иную мультимодальную базу, чем стандартная GLM-5.3. Рассматривайте их как отдельных кандидатов при настройке политики маршрутизации среди лучших китайских LLM.
Для практической оценки можно поручить Flash задачу с ограниченным контекстом, проверку визуальной верстки или начальную реализацию кода. Используйте те же приемочные тесты, что и для более крупных моделей. Если результат не соответствует требованиям, учитывайте как неудачную попытку, так и затраты на эскалацию задачи.
Низкие тарифы оставляют пространство для итераций, но повторяющиеся непродуктивные попытки могут свести это преимущество на нет. Оцените частоту успешного выполнения задач, прежде чем выбирать эту модель в качестве основной. Функция рассуждения (reasoning) всегда включена в документации модели, поэтому обязательно учитывайте использование токенов рассуждения и время отклика при проверке.
Вердикт: Тестируйте GLM-5.3 Flash как бюджетный вариант по умолчанию для визуального программирования и повторяющихся подзадач, предусмотрев четкий план эскалации на случай сбоев.
Достойны упоминания
MiniMax M3.1 Flash
MiniMax's current candidate deserves attention beyond the older M3 entry. The October 19 release announcement reports 73.7% on DeepSWE v1.1 and emphasizes lower-cost agent execution. That makes M3.1 Flash relevant to the same budget discussion as DeepSeek and GLM Flash.
Keep it in the research shortlist until the exact GPT Proto route, model ID, pricing, and supported features are confirmed. An existing MiniMax M3 endpoint should not be labeled M3.1 Flash without verification.
Xiaomi MiMo-V2.6 and Other Emerging Models
MiMo-V2.6 remains worth monitoring; Artificial Analysis includes MiMo-V2.6-Pro in its evaluations. Give a new model a main-list position after checking both its task evidence and the actual access path being recommended.
Старые развертывания Kimi K3 и DeepSeek V4 Pro могут быть полезны, если ваше приложение зависит от уже проверенного поведения моделей. Протестируйте замену на тех же задачах, прежде чем переводить на нее существующий трафик.
Models to Watch
Step 5 Preview and Xiaomi’s MiMo-V2.6 family are relevant new Chinese models, but they are not included in the main ranking because GPT Proto did not have confirmed live routes for them at the time of this update. Add them to the ranked list only after the exact model page, API string, price, and supported request fields are live and tested.
Одна реальная задача по программированию, пять разных вариантов
Представьте, что вам нужно добавить подписочную модель оплаты в существующее SaaS-приложение на TypeScript. Агент должен понимать текущую модель пользователя, реализовать процесс оформления заказа, безопасно обрабатывать вебхуки, обновлять права доступа к аккаунту и проверять результат.
| Требование |
Кандидат для оценки |
Что проверить |
| Реализация функции подключения в нескольких файлах |
Kimi K3.1 Pro |
Корректность поведения, согласованность изменений и восстановление после неудачных тестов |
| Запуск повторных попыток реализации и исправления |
DeepSeek V4.1 Flash |
Принятые исправления на доллар затрат; запись обслуженной ревизии |
| Соответствие интерфейса оплаты дизайн-макету |
Qwen3.8-Max-0902 |
Визуальная точность, адаптивность и рабочие состояния |
| Диагностика сбоев бэкенда и терминала |
GLM-5.3 |
Качество воспроизведения, использование команд и результаты тестов |
| Недорогая обработка ограниченной реализации или визуальных проверок |
GLM-5.3 Flash |
Частота сбоев, повторные попытки и стоимость с учетом эскалации |
В этом примере красивая кнопка оплаты — лишь часть результата. Вебхук должен быть верифицирован, дублирующиеся события не должны приводить к повторному начислению бонусов, а изменения подписки должны обновлять правильный аккаунт. Напишите эти приемочные тесты перед сравнением моделей, чтобы выбрать лучшие китайские LLM для ваших задач.
Сколько будет стоить такая же задача по программированию?
Для простого сравнения стоимости токенов предположим, что на одну попытку уходит 100 000 некэшированных входных токенов и 20 000 оплачиваемых выходных токенов. Ниже приведены данные на основе панелей цен GPT Proto по состоянию на 29 октября 2026 года. Тарифы указаны в долларах США за миллион токенов; экономия за счет кэширования или работы в непиковые часы не учитывается.
Расчет выглядит так: 0.1 × стоимость входа + 0.02 × стоимость выхода. В строке DeepSeek указана цена отображаемого маршрута GPT Proto; она не определяет конкретный чекпоинт, обслуживаемый этим алиасом.
Это лишь иллюстративные расходы на токены. Фактический результат должен включать оплачиваемое рассуждение (reasoning), где это применимо, а полная задача может потребовать больше итераций, результатов инструментов, повторных попыток или использования другой модели. Проверяйте актуальную панель цен при планировании бюджета.
Измеряйте общие затраты на API, деленные на количество изменений, прошедших ваши приемочные тесты. Это дает более полезное сравнение, чем предположение, что каждая модель выполняет задачу с одинаковым количеством токенов.
Why the Benchmark Winner May Not Be the Best Coding Agent
Your coding agent controls which files the model sees, how tools are called, when tests run, and what happens after failure. Changing that setup can change the result even when the model stays the same.
Before comparing candidates, hold the repository, task instructions, tools, acceptance tests, and time limit constant. Allow each model the request format it requires, and record its reasoning settings. Then measure completed tasks, regressions, retries, elapsed time, and API spend.
For this shortlist, use Kimi to test the capability ceiling, DeepSeek and GLM Flash to test production economics, Qwen for visual acceptance, and GLM for text-based repository execution. Let the results determine which stages share a model and which need a different route.
Which Chinese Coding Model Should You Use?
Choose Kimi K3.1 Pro first when completing a difficult feature or app is the priority and you can justify a higher per-token budget.
Choose DeepSeek V4.1 Flash when repeated agent calls make cost important. Confirm the deployed revision before basing a rollout on 1017-specific evidence.
Choose Qwen3.8-Max-0902 when the implementation must match screenshots, layouts, or other visual references.
Choose GLM-5.3 when your evaluation centers on source code, terminal output, and backend behavior.
Choose GLM-5.3 Flash when you want a low-rate visual-coding candidate and can detect failures before escalating them.
For an initial comparison, use one bounded task that already has a reliable acceptance test. A small verified change gives you more useful deployment evidence than a large generated application that nobody has checked.
Как использовать эти китайские LLM через единый API
Откройте страницу модели, которую хотите протестировать, и выберите Попробовать эту модель → Быстрый старт. Создайте или выберите API-ключ GPT Proto и используйте Скопировать Markdown для ИИ, чтобы передать текущие инструкции по интеграции вашему помощнику по программированию.
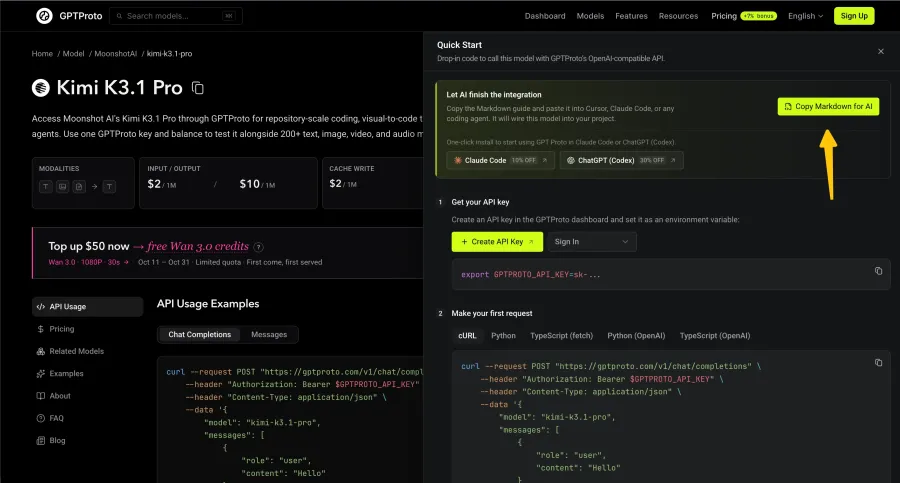
Попросите его проанализировать ваш проект, следовать скопированным конечным точкам и полям запроса, хранить ключ в конфигурации на стороне сервера и добавить небольшую проверку соединения. Настраивайте реальный ключ локально, а не вставляйте его в публичные промпты или репозитории.
Идентификаторы моделей ниже соответствуют публичным маршрутам GPT Proto, рассмотренным в этом обновлении:
| Модель |
Идентификатор модели GPT Proto |
| Kimi K3.1 Pro |
kimi-k3.1-pro |
| DeepSeek Flash |
deepseek-flash |
| Qwen3.8-Max-0902 |
qwen3.8-max-0902 |
| GLM-5.3 |
glm-5.3 |
| GLM-5.3 Flash |
glm-5.3-flash |
Используйте руководство на странице модели для каждого маршрута. Модели могут различаться по полям рассуждения, обработке вызовов инструментов и формату мультимодальных запросов, поэтому изменение строки модели — это лишь часть миграции. Успешный единичный запрос должен сопровождаться тестом многоходового использования инструментов перед запуском в продакшн.
Подключение API модели к вашему приложению — это задача, отличная от смены модели, на которой работает ваш помощник по программированию. Проверьте поддерживаемый формат подключения клиента для последнего.
Сравните все модели GPT Proto перед распределением продакшн-трафика. Один API-ключ и общий баланс позволяют оценивать различные поддерживаемые модели без необходимости поддерживать отдельную интеграцию и предоплатный аккаунт для каждого провайдера.
Откройте Kimi K3.1 Pro, чтобы начать со сложной задачи по программированию, или сравните DeepSeek Flash и GLM-5.3 Flash, если приоритетом является стоимость повторных вызовов. Используйте руководство по интеграции на странице модели и проверьте одно небольшое изменение перед расширением рабочей нагрузки.