¿Qué es un proveedor de API de LLM?
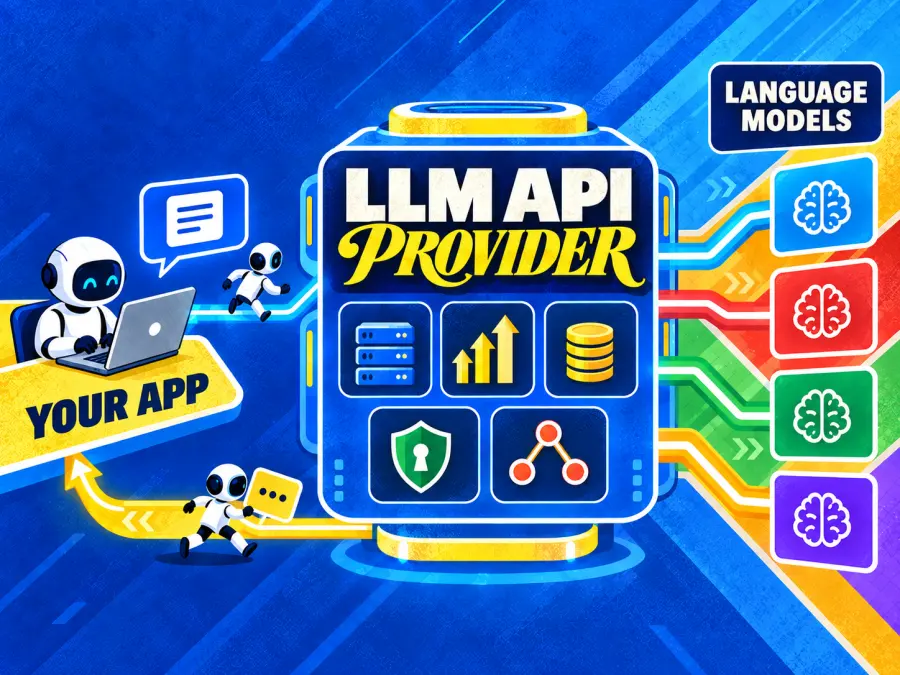
Un proveedor de API de LLM ofrece a los desarrolladores acceso alojado a modelos de lenguaje sin necesidad de aprovisionar y operar la infraestructura de inferencia subyacente. El proveedor se encarga del despliegue, el escalado, la medición, la autenticación y, dependiendo de la plataforma, el enrutamiento, la observabilidad, los controles de seguridad o el ajuste fino (fine-tuning).
Esta etiqueta abarca varios tipos de negocios:
API de modelos de primera parte: ofrecen modelos creados por la misma empresa, como un laboratorio de modelos que expone sus propios modelos de vanguardia.
Proveedores de API de modelos múltiples: colocan modelos de varios creadores bajo una misma cuenta y, a menudo, bajo una misma convención de API.
Enrutadores y puertas de enlace (gateways): envían una solicitud a uno de los varios hosts subyacentes según el precio, la disponibilidad, la latencia o las reglas definidas por el usuario.
Plataformas de IA en la nube gestionadas: combinan el acceso a modelos con identidad empresarial, redes privadas, gobernanza y otros servicios en la nube.
Especialistas en inferencia: optimizan modelos seleccionados de pesos abiertos para mejorar la velocidad, el costo, el ajuste fino o el despliegue dedicado.
Estas categorías se superponen. Lo que importa no es simplemente: "¿Este proveedor incluye el modelo?", sino: "¿Puede entregar el modelo con el protocolo, la economía, la fiabilidad y los controles que requiere nuestra aplicación?"
Cómo clasificamos a los mejores proveedores de API de LLM
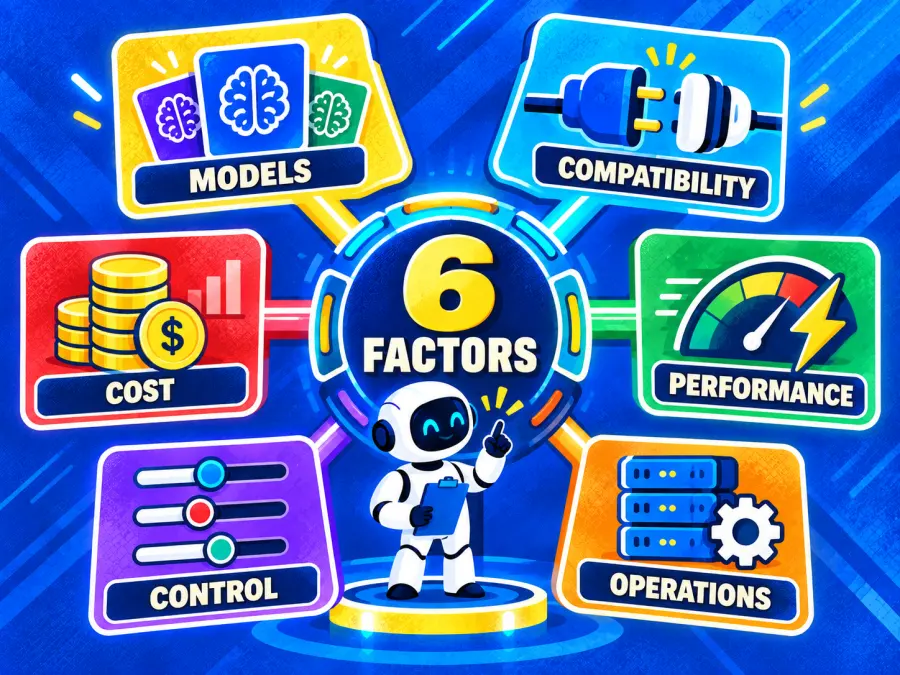
Evaluamos a cada proveedor en seis grupos de factores:
Selección de modelos: la cantidad y variedad de modelos útiles, no solo el tamaño bruto del catálogo.
Compatibilidad: consistencia de la API, herramientas, salidas estructuradas y streaming.
Costo real: tarifas por token, comisiones de plataforma, almacenamiento en caché, descuentos por lotes y reintentos.
Rendimiento: tiempo hasta el primer token, rendimiento (throughput), latencia de cola y comportamiento de capacidad.
Control: fijación de proveedor, reglas de respaldo, semántica de errores y ciclo de vida del modelo.
Operaciones: identidad, regiones, redes, gobernanza, documentación y esfuerzo de migración.
Ningún proveedor gana en todos los factores. Nuestro orden favorece a la mejor plataforma de propósito general para equipos que valoran un amplio acceso a modelos, y luego identifica los casos en los que un proveedor más especializado es la mejor decisión.
Comparativa de proveedores de API de LLM
| Rango |
Proveedor |
Ideal para |
Perfil del catálogo |
Enfoque de API |
Principal desventaja |
| 1 |
GPT Proto |
Una clave de API para modelos LLM y multimodales |
232 modelos en total, incluidos 124 modelos de texto al momento de la revisión |
Endpoint de chat compatible con OpenAI para LLM admitidos; API específicas para otras modalidades |
Plataforma más reciente con un ecosistema empresarial más pequeño que los hiperescaladores |
| 2 |
OpenRouter |
Máxima variedad de LLM y enrutamiento entre proveedores |
Más de 500 modelos de más de 80 proveedores |
API enrutada compatible con OpenAI con preferencias de proveedor y alternativas de respaldo |
El enrutamiento puede complicar el almacenamiento en caché, la consistencia del rendimiento y la atribución de costos |
| 3 |
Amazon Bedrock |
Gobernanza de AWS e implementación empresarial |
Más de 100 modelos a través de Bedrock Marketplace |
Interfaces gestionadas consistentes, incluida la API Converse |
Los conceptos de AWS, la disponibilidad regional y el comportamiento específico de cada modelo añaden complejidad |
| 4 |
Together AI |
Modelos de pesos abiertos, ajuste fino y experimentación |
Amplio catálogo de modelos abiertos |
API sin servidor compatible con OpenAI, además de opciones de ajuste fino y dedicadas |
El soporte de funciones varía según el modelo |
| 5 |
Fireworks AI |
Inferencia de modelos abiertos para producción |
Más de 100 modelos disponibles |
API compatibles con OpenAI con despliegue sin servidor y dedicado |
Su mejor uso se concentra en cargas de trabajo de modelos abiertos |
| 6 |
GroqCloud |
Generación muy rápida en un catálogo enfocado |
Selección de modelos más pequeña y curada |
API mayormente compatible con OpenAI |
Menor variedad y brechas de compatibilidad documentadas |
Los totales del catálogo son orientativos, no directamente comparables. Una empresa puede contar las versiones de los modelos, las modalidades, los proveedores o los ajustes finos de manera diferente a otra. La disponibilidad también cambia más rápido de lo que una lista anual puede capturar.
1. GPT Proto: el mejor proveedor de API de LLM multimodelo en general
GPT Proto ocupa el primer lugar para los desarrolladores que desean una sola cuenta y clave de API que pueda crecer más allá de la generación de texto. Al momento de la revisión, su catálogo mostraba 232 modelos, incluidos 124 modelos de texto, además de opciones de imagen, video y audio.
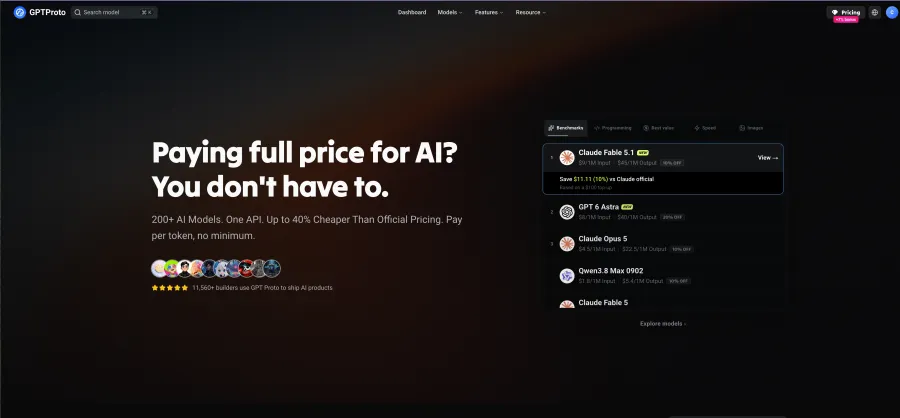
Para los LLM compatibles, GPT Proto expone un patrón de chat-completions compatible con OpenAI. Los desarrolladores pueden explorar el catálogo de modelos de texto, inspeccionar las tarifas específicas de cada modelo y probar un modelo antes de la integración.
Cada página de modelo expone las tarifas de entrada y salida. La API de GLM-5.3, por ejemplo, figuraba a $1.26 por millón de tokens de entrada y $3.96 por millón de tokens de salida cuando se revisó, un 10% por debajo de las tarifas directas de Z.ai mostradas. Los precios pueden cambiar, así que consulta la página del modelo.
GPT Proto no es el ganador predeterminado para todas las empresas: Bedrock tiene una gobernanza de AWS más profunda, OpenRouter un catálogo de LLM enrutados más amplio, y los especialistas pueden tener un mejor rendimiento para un modelo abierto específico. Su ventaja es la amplitud práctica en todas las familias de modelos y modalidades.
Ideal para: productos SaaS, agencias de IA, prototipos que avanzan hacia la producción y aplicaciones multimodales.
A tener en cuenta: Trata la compatibilidad con OpenAI como algo específico del modelo y del endpoint. Los modelos de imagen y video utilizan cuerpos de solicitud específicos para cada tarea en lugar del formato de chat de LLM.
2. OpenRouter: el mejor para la amplitud del catálogo de LLM y enrutamiento
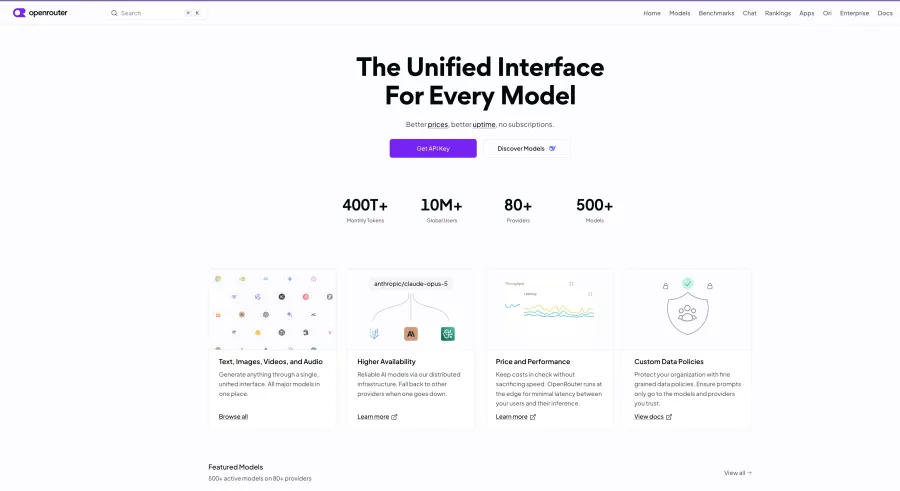
OpenRouter es la opción más sólida cuando la amplitud del catálogo es el requisito principal. Su oferta publicada supera los 500 modelos de más de 80 proveedores. Un único endpoint puede enrutar solicitudes entre hosts subyacentes, y los desarrolladores pueden establecer preferencias de proveedor, permitir alternativas (fallbacks) o utilizar la selección automática.
La contrapartida es que el enrutamiento se convierte en parte del comportamiento de la aplicación. El mismo nombre de modelo puede ejecutarse en un host, pila de hardware o variante de modelo diferente. Eso puede cambiar la latencia, el contexto admitido, el manejo de errores y la economía del caché de prompts. OpenRouter también incluye una tarifa del 5.5% en compras de crédito para su plan estándar de pago por uso, que debe incluirse en los cálculos del costo total.
En debates recientes de desarrolladores, los usuarios informaron una menor consistencia en los aciertos de caché cuando el tráfico se movía entre proveedores. Un análisis de la comunidad independiente examinó miles de turnos. Estos informes son anecdóticos, pero los equipos con prompts largos y repetidos deberían probar configuraciones de proveedor fijo y sin alternativas frente al enrutamiento predeterminado.
Ideal para: descubrimiento de modelos, acceso amplio a LLM, enrutamiento de respaldo y aplicaciones que pueden beneficiarse de la elección del proveedor al momento de la solicitud.
A tener en cuenta: tarifas de plataforma, diferencias a nivel de proveedor, fallos de caché y la tensión entre el respaldo automático y el rendimiento determinista.
3. Amazon Bedrock: la mejor opción para empresas centradas en AWS
Amazon Bedrock es la opción más atractiva para las organizaciones que ya operan dentro de AWS. Bedrock Marketplace ofrece acceso a más de 100 modelos, mientras que servicios como Agents, Knowledge Bases y Guardrails conectan la inferencia de modelos a una infraestructura gestionada más amplia.
Su valor principal es la gobernanza, más que la cantidad bruta de modelos. Los clientes de AWS pueden alinear el acceso a los modelos con sus patrones habituales de identidad, registro, regiones, redes, adquisiciones y seguridad. La API Converse proporciona a los modelos compatibles una interfaz basada en mensajes más consistente, lo que reduce algunas diferencias de integración entre proveedores. AWS también afirma que el contenido enviado a través de esta API no se almacena, una consideración importante para la revisión empresarial.
La consistencia no significa que todos los modelos se comporten de forma idéntica. La disponibilidad varía según la región, el soporte de capacidades difiere y los conceptos de límites de cuenta o servicio de AWS añaden trabajo. Esos costos tienen menos sentido para un equipo pequeño que solo necesita una clave y un endpoint de chat.
Ideal para: cargas de trabajo reguladas, equipos establecidos en AWS y empresas que desean acceso a modelos dentro de un límite de gobernanza en la nube ya existente.
A tener en cuenta: disponibilidad específica por región, características específicas de cada modelo, cuotas de servicio y la sobrecarga de la arquitectura en la nube.
4. Together AI: la mejor opción para experimentación con modelos de pesos abiertos y ajuste fino (fine-tuning)
Together AI es un proveedor de API de modelos LLM sólido para equipos que trabajan principalmente con modelos de pesos abiertos. Su servicio serverless utiliza precios por token sin necesidad de aprovisionar réplicas ni comprometerse a un costo mínimo de implementación. La plataforma también admite el ajuste fino y endpoints dedicados, lo que brinda a los equipos un camino desde la evaluación rápida hasta una implementación más controlada.
La interfaz compatible con OpenAI reduce el esfuerzo de migración para las cargas de trabajo de chat estándar. Together también publica indicadores de capacidad para funciones como la llamada a funciones (function calling) y salidas estructuradas. Estos indicadores son importantes porque el soporte de funciones no es uniforme en todo el catálogo; un modelo excelente para la generación simple puede no satisfacer un flujo de trabajo de agentes que dependa de un JSON estricto o de llamadas a herramientas confiables.
Together ofrece más profundidad que un simple enrutador para los equipos que desean ajustar un modelo abierto, probarlo a través de un endpoint alojado y, más tarde, elegir un servicio dedicado. Los equipos aún deben seleccionar el modelo, el modo de servicio y el conjunto de funciones adecuados. Para conocer otra forma de evaluar esas opciones de implementación, compara las alternativas a Together AI antes de comprometerte con un modelo de servicio.
Ideal para: investigación de modelos abiertos, ajuste fino, evaluación y equipos que puedan pasar de un modelo serverless a una inferencia dedicada.
A tener en cuenta: soporte por modelo para herramientas, salidas estructuradas, contexto y modos de servicio.
5. Fireworks AI: la mejor opción para el despliegue de modelos abiertos en producción
Fireworks AI se centra en ofrecer modelos abiertos para su uso en producción. Cuenta con más de 100 modelos disponibles y ofrece tanto acceso sin servidor (serverless) como despliegues dedicados. Su interfaz de API incluye Chat Completions compatibles con OpenAI e interfaces de estilo Responses, lo que puede reducir los cambios de código necesarios para las aplicaciones de LLM más comunes.
La plataforma es especialmente relevante cuando un equipo quiere comenzar con inferencia sin servidor por token y, más adelante, trasladar una carga de trabajo estable a una capacidad más aislada. La inferencia por lotes tiene un costo del 50% de las tarifas sin servidor para cargas de trabajo que pueden esperar, lo que crea una ruta de optimización clara para tareas de enriquecimiento offline, clasificación, resumen y procesamiento de datos.
Las pruebas de referencia de inferencia independientes también muestran por qué a ningún proveedor se le debe asignar una etiqueta de "velocidad" permanente. El rendimiento varía según el modelo, la región, la carga y el método de medición. Prueba el par proveedor-modelo exacto con prompts realistas en lugar de transferir un resultado de un modelo a toda la plataforma.
Ideal para: inferencia de modelos abiertos en producción, cargas de trabajo que pueden requerir capacidad dedicada y trabajos por lotes que toleran demoras.
A tener en cuenta: la variación del rendimiento según el modelo y si el despliegue sin servidor, por lotes o dedicado se ajusta a la carga de trabajo.
6. GroqCloud: la mejor opción para la generación de texto de baja latencia
GroqCloud es el especialista de esta lista. Su catálogo enfocado se ejecuta en la arquitectura de inferencia de Groq, y las mediciones públicas han posicionado repetidamente a los modelos compatibles entre los más rápidos para la generación de tokens. Esto lo hace atractivo para agentes interactivos, canales de voz, herramientas de programación y otras experiencias donde los usuarios sienten cada pausa.
Groq describe su API como mayormente compatible con OpenAI, y ese matiz es importante. Su documentación identifica los campos no compatibles, incluidos logprobs, logit_bias, top_logprobs y messages[].name; n debe establecerse en 1. El procesamiento Flex permite límites de tasa mucho más altos, pero puede devolver una respuesta 498 capacity_exceeded cuando no hay capacidad disponible. Los modelos de vista previa también pueden ser discontinuados con poco aviso.
Elige GroqCloud cuando un modelo compatible se ajuste a la tarea y la latencia tenga un valor de producto medible. No lo elijas solo porque un framework ya tenga un adaptador de OpenAI.
Ideal para: asistentes en tiempo real, bucles de agentes, aplicaciones de voz y generación sensible a la latencia en modelos compatibles.
A tener en cuenta: selección de modelos más pequeña, campos de solicitud no compatibles, comportamiento de la capacidad y riesgo del ciclo de vida de los modelos de vista previa.
Por qué el mismo LLM puede comportarse de manera diferente según el proveedor
Un estudio de medición de 2026, “¿Cuándo el mismo modelo no es el mismo servicio?”, argumenta que un modelo alojado debe tratarse como un objeto de servicio específico del proveedor. Su comportamiento observado incluye la variante del modelo, el protocolo, la capacidad de contexto, el precio, la latencia, el rendimiento, la confiabilidad y la viabilidad de la tarea, no solo el nombre del modelo.
Esta distinción ofrece a los desarrolladores un mejor marco de comparación de proveedores de API de LLM:
Identidad y versión del modelo
Dos endpoints pueden mostrar la misma familia de modelos mientras sirven diferentes puntos de control (checkpoints), cuantizaciones, niveles de precisión o cronogramas de actualización. Pregunta si el identificador del modelo está fijado a una versión y qué sucede cuando un modelo upstream cambia.
Compatibilidad más allá de la URL base
“Compatible con OpenAI” a menudo significa que el proveedor acepta una solicitud de chat-completions familiar. Esto no garantiza la compatibilidad con todos los parámetros, esquemas de herramientas, eventos de streaming, campos de respuesta o códigos de error. Crea una prueba de contrato para las funciones que tu aplicación realmente utiliza.
Enrutamiento y estabilidad de la caché
El enrutamiento automático puede mejorar la disponibilidad, pero cambiar de proveedor puede reducir la reutilización de la caché de prompts. Si el contexto repetido domina tu factura de entrada, prueba un host fijo frente al tráfico enrutado. Compara el costo efectivo por tarea completada, no el precio anunciado por millón de tokens.
Latencia, rendimiento y errores
Mide toda la distribución. La latencia P50 describe una llamada típica; P95 o P99 exponen los casos extremos lentos. Rastrea el tiempo hasta el primer token por separado de la velocidad de generación. Registra los límites de tasa, tiempos de espera, errores de capacidad y el éxito de los reintentos, ya que un endpoint barato que requiere reintentos frecuentes puede resultar costoso tanto en términos de cómputo como de paciencia del usuario.
El mismo estudio ofrece una indicación útil de los beneficios: en los casos medidos, el enrutamiento redujo el costo de una carga de trabajo de Qwen3-32B en un 37.8%, mientras que la elección del proveedor aumentó el rendimiento para una carga de trabajo de DeepSeek-V3.2 en aproximadamente un 90%. Esos resultados son específicos de la carga de trabajo, pero muestran por qué la capa del proveedor merece su propia evaluación.
¿Qué proveedor de API de LLM deberías elegir?
Usa el ranking como una lista corta y luego decide según la carga de trabajo:
Elige GPT Proto para un acceso amplio a texto y medios bajo una sola clave.
Elige OpenRouter para obtener la máxima variedad de LLMs y enrutamiento de proveedores.
Elige Amazon Bedrock para gobernanza y servicios administrados de AWS.
Elige Together AI para experimentación con modelos abiertos y ajuste fino (fine-tuning).
Elige Fireworks AI para el despliegue de modelos abiertos en producción.
Elige GroqCloud para generación sensible a la latencia en modelos compatibles.
Mantén una API de primera parte en la comparación cuando un modelo propietario sea una dependencia estable. De lo contrario, prueba al menos dos proveedores con conversaciones en caché, llamadas a herramientas, respuestas estructuradas, concurrencia máxima y fallos; no solo prompts de demostración cortos.
Cómo acceder a múltiples LLMs con una clave de API de GPT Proto
Comienza en el catálogo de modelos de texto de GPT Proto, abre la página de un modelo y usa la opción Probar este modelo para confirmar la salida antes de la integración. Después de crear una clave de API, envía una solicitud estándar de chat-completions:
export GPTPROTO_API_KEY="reemplaza_con_tu_clave"

curl https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.3",
    "messages": [
      {
        "role": "user",
        "content": "Devuelve una comparación en JSON de dos estrategias de caché."
      }
    ]
  }'
Para otro LLM compatible, cambia el valor de model por el identificador que aparece en la página de dicho modelo. Mantén la selección del modelo en la configuración en lugar de codificarla de forma rígida en toda la aplicación, y valida la compatibilidad de las funciones antes de realizar el cambio. Los modelos de imagen, video y audio utilizan sus propios endpoints y cuerpos de solicitud específicos para cada tarea.
Veredicto final
El mejor proveedor de API de LLM es aquel que convierte el modelo correcto en un servicio confiable para tu carga de trabajo. La calidad del modelo establece el límite máximo, pero la compatibilidad, el comportamiento de la caché, la latencia, el manejo de errores, la política de ciclo de vida y el costo total determinan lo que los usuarios experimentan realmente.
Para un uso diario general, GPT Proto ofrece el punto de partida más equilibrado en esta comparativa de seis proveedores: una clave, un amplio catálogo de texto, páginas de modelos transparentes y acceso a otras API de medios generativos. OpenRouter gana en amplitud de LLM enrutados; Amazon Bedrock en controles empresariales de AWS; Together AI y Fireworks AI en diferentes etapas del ciclo de vida de modelos abiertos; y GroqCloud en inferencia enfocada en la velocidad.
Haz una lista corta de la categoría de proveedor que se ajuste a tus necesidades operativas y, luego, realiza pruebas comparativas de la combinación exacta de proveedor-modelo-tarea. En 2026, esa combinación de servicio —no solo el logotipo o el nombre del modelo— es la unidad que vale la pena elegir.