Resumen de las mejores APIs de LLM asequibles para agentes
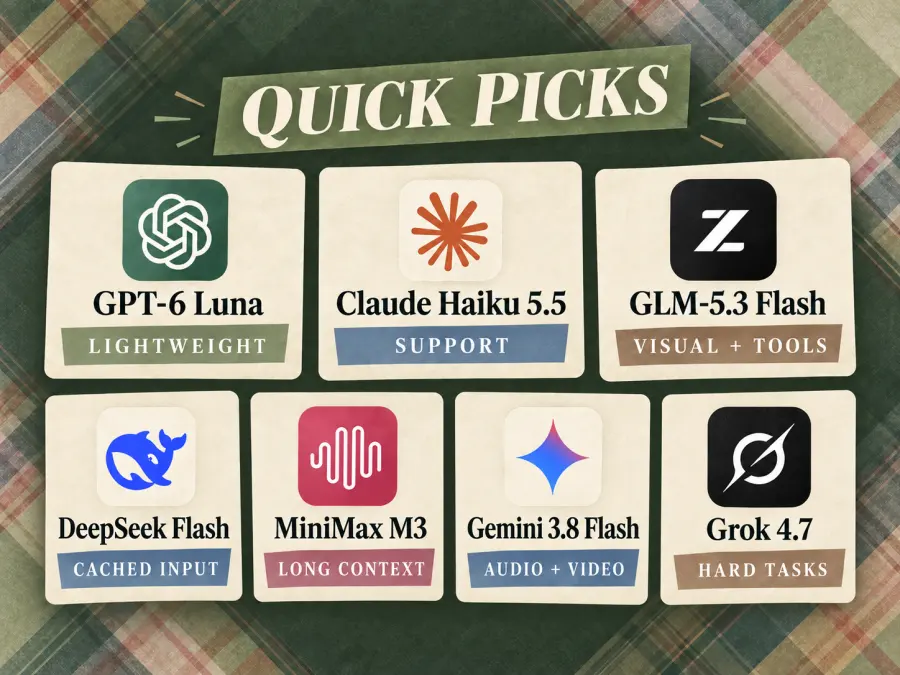
Esta lista agrupa los modelos según el trabajo para el que vale la pena probarlos. Es una selección editorial basada en las capacidades publicadas y los precios, no una clasificación de rendimiento comparativa privada.
| Modelo |
Cadena del modelo GPT Proto |
Entrada / salida de GPT Proto publicada por cada 1M de tokens |
Primera carga de trabajo a probar |
| GPT-6 Luna |
gpt-6-luna |
$0.08 / $0.40 |
Clasificación, extracción y enrutamiento |
| Claude Haiku 5.5 |
Consulta el inicio rápido en la página del modelo |
$0.09 / $0.45 para prompts ≤100K tokens |
Tareas de soporte repetitivas y subtareas de programación |
| GLM-5.3 Flash |
glm-5.3-flash |
$0.15 / $0.50 |
Flujos de trabajo visuales y basados en herramientas |
| DeepSeek Flash |
deepseek-flash |
$0.30 / $1.20 |
Instrucciones repetidas y entradas con uso intensivo de caché |
| MiniMax M3 |
MiniMax-M3 |
$0.48 / $0.96 |
Sesiones de investigación y documentos largos |
| Gemini 3.8 Flash |
gemini-3.8-flash |
$0.90 / $4.50 |
Flujos de trabajo de audio, video, imagen y PDF |
| Grok 4.7 |
grok-4.7 |
$1.20 / $3.60 |
Programación difícil y escalada de varios pasos |
Tarifas verificadas o confirmadas el 8 de octubre de 2026. Estas son las tarifas de GPT Proto, no precios promocionales directos del proveedor. Haiku 5.5 cuesta $0.45 de entrada y $2.25 de salida por millón de tokens para prompts superiores a 100K tokens. Confirma el nivel de contexto aplicable, los cargos por caché, el nivel de servicio y la tarifa vigente en la página de cada modelo antes de presupuestar.
Compara antes de comprometerte: Explora los modelos de IA disponibles en GPT Proto y mantén los IDs de los modelos preseleccionados en la configuración para que puedas cambiar sin tener que reconstruir todo el agente.
Cómo clasificamos estos LLM asequibles para IA de agentes
Simon Willison ofrece una definición de trabajo útil: un agente de LLM ejecuta herramientas en un bucle para lograr un objetivo. Ese bucle cambia la forma en que se debe medir la asequibilidad. Una comparación normal de chatbots puede centrarse en el costo de una respuesta; una comparación de agentes también debe contar las llamadas a herramientas, los resultados de las herramientas, los reintentos, los tokens de razonamiento y las ejecuciones fallidas.
Utilizamos el siguiente orden de evaluación.
1. El modelo debe superar una prueba de capacidad de agente
Un modelo no se incluyó simplemente porque tuviera un precio bajo por token. Cada opción preseleccionada necesitaba una ruta documentada para la llamada a funciones o el uso de herramientas, además de una forma utilizable de devolver datos estructurados o continuar un flujo de trabajo de varios turnos.
2. La evidencia de agentes públicos es más importante que una puntuación de conocimiento general
El Berkeley Function Calling Leaderboard es especialmente útil para entender qué debe examinar una evaluación de uso de herramientas: la selección correcta de funciones, argumentos válidos, comportamiento de múltiples turnos y casos en los que el modelo debe evitar llamar a una herramienta. Sin embargo, su tabla de clasificación pública se actualizó por última vez el 12 de abril de 2026, lo que es anterior a la mayoría de los modelos en este artículo. Por lo tanto, utilizamos su metodología en lugar de asignar sus puntuaciones más antiguas a lanzamientos más recientes.
También hacemos referencia a Artificial Analysis. Su índice de inteligencia (Intelligence Index) incluye trabajo de conocimiento agéntico, trabajo en el mundo real, automatización de SaaS, uso de terminales y evaluaciones de contexto largo. Sigue siendo un índice mixto —no una puntuación pura de llamada a funciones— y debe tratarse como evidencia de selección en lugar de una garantía para un agente en particular.
3. El costo por tarea exitosa es más importante que el precio por token
La métrica de producción útil es:
Costo por tarea exitosa = Costo total de API de todos los intentos y reintentos / Tareas completadas aceptadas
Este cálculo debe incluir la entrada sin caché, la entrada en caché, la salida, los tokens de razonamiento ocultos o facturados cuando corresponda, los intentos fallidos y las llamadas de recuperación. Si un modelo termina 90 de 100 tareas y otro termina 60, comparar solo sus tarifas de tokens principales oculta el costo de reparar las otras 40 tareas.
4. La velocidad, la verbosidad y la fricción de integración afectan el costo
Los tokens de salida por segundo miden solo la fase de generación. No capturan el tiempo hasta la primera respuesta, el razonamiento interno, la ejecución de herramientas, los retrasos por límites de tasa o las llamadas repetidas. Un modelo verboso también puede convertir un precio de salida bajo en una factura final más alta.
Finalmente, las API similares aún tienen reglas específicas del modelo. Los campos de razonamiento, los parámetros de muestreo no admitidos, los ID de respuesta de función y el uso de mayúsculas en los nombres de los modelos pueden romper un flujo de trabajo que de otro modo sería portátil. Es por esto que la cadena exacta del modelo GPT Proto se incluye para cada entrada.
1. GPT-6 Luna: la mejor opción para pasos de agentes ligeros y de alto volumen
GPT-6 Luna es nuestra primera elección para solicitudes frecuentes y delimitadas: clasificar un ticket, extraer atributos de productos, seleccionar un flujo de trabajo o resumir el resultado de una herramienta. GPT Proto lo lista a $0.08 por millón de tokens de entrada y $0.40 por millón de tokens de salida, las tarifas de entrada y salida más bajas en esta lista corta.
El modelo acepta texto e imágenes, admite salidas estructuradas y ofrece una ventana de contexto de 1.05M de tokens. El razonamiento ajustable permite a los desarrolladores probar cuánto esfuerzo requiere una tarea. Una decisión de enrutamiento simple rara vez necesita la misma configuración que un problema de codificación ambiguo.
Hay un detalle de compatibilidad que debes verificar antes de usarlo como controlador de llamadas a herramientas. OpenAI documenta la llamada a funciones con razonamiento habilitado a través de Responses; Chat Completions admite llamadas a funciones solo con reasoning_effort: "none". Usa la función Try this model (Prueba este modelo) de inicio rápido en la página del modelo de GPT Proto para verificar la ruta y los campos admitidos.
El rol de Luna es ser la primera capa económica. Puede manejar pasos rutinarios mientras un modelo más capaz toma el control tras una falla clara o una señal de complejidad. Una tarifa baja por token solo ayuda si esos primeros pasos siguen siendo precisos. Para ver más de cerca esa compensación, compara GPT-6 Luna y GPT-6 Sol para cargas de trabajo de codificación y agentes.
Elige GPT-6 Luna cuando:
el flujo de trabajo contenga grandes volúmenes de clasificación, extracción o resumen;
cada paso tenga un esquema claro y un resultado que tu aplicación pueda verificar;
desees una base de bajo costo para una aplicación existente compatible con OpenAI;
los casos difíciles puedan ser escalados en lugar de reintentarse indefinidamente.
Ten en cuenta: el soporte de herramientas específico del endpoint y las fallas de validación repetidas. Usa Luna para trabajos delimitados; evalúa un modelo más potente para planificación y recuperación complejas.
2. Claude Haiku 5.5 — La mejor opción para soporte de bajo costo y pasos de agentes con Claude
Claude Haiku 5.5 es una alternativa sólida para tareas repetitivas de soporte, resúmenes de conversaciones, clasificación y tareas de programación más pequeñas. Lanzado el 7 de octubre de 2026, aporta un esfuerzo ajustable al nivel Haiku y puede servir como el trabajador menos costoso en un flujo de trabajo que también utiliza modelos Claude más grandes.
GPT Proto ofrece Haiku 5.5 a un 10% por debajo de las tarifas oficiales. Para solicitudes de hasta 100K tokens de entrada, esto significa $0.09 por millón de tokens de entrada y $0.45 por millón de tokens de salida. Por encima de los 100K tokens de entrada, las tarifas correspondientes son $0.45 de entrada y $2.25 de salida.
Ese umbral es más importante que la ventana de contexto máxima. Haiku admite 1M de contexto, pero una conversación en crecimiento puede cruzar al nivel de precio más alto mucho antes de alcanzar esa capacidad. El umbral se aplica a la entrada de cada solicitud, incluyendo la conversación retenida y los resultados de las herramientas.
El razonamiento adaptativo está habilitado de forma predeterminada, y el esfuerzo controla cuánto trabajo dedica el modelo a una tarea. Comienza con solicitudes enfocadas y compara la calidad de finalización, la latencia y los tokens facturados antes de aumentar el esfuerzo.
Elige Claude Haiku 5.5 cuando:
un agente maneje preguntas de soporte repetidas o triaje de tickets;
los resúmenes y el estado de conversación compactado sean pasos frecuentes en el flujo de trabajo;
un flujo de trabajo de programación basado en Claude necesite ayuda con subtareas enfocadas;
la mayoría de las solicitudes se mantengan dentro del nivel de precio de longitud de prompt más bajo.
Ten cuidado con: las solicitudes que superen los 100K tokens de entrada. Mantén el estado reutilizable compacto y verifica el costo total de la solicitud, especialmente en conversaciones largas.
3. GLM-5.3 Flash — La mejor opción para agentes visuales y basados en herramientas de bajo costo
GLM-5.3 Flash sigue siendo uno de los candidatos más útiles para flujos de trabajo que combinan evidencia visual con herramientas externas. Sus tarifas publicadas en GPT Proto son de $0.15 por millón de tokens de entrada y $0.50 por millón de tokens de salida.
Z.ai documenta soporte de entrada nativo para texto, imágenes, video y archivos, junto con una ventana de contexto de 1M de tokens. La llamada a funciones, JSON estructurado, almacenamiento en caché, streaming y argumentos de herramientas transmitidos lo hacen relevante para agentes que inspeccionan documentos o interfaces y luego dan otro paso.
Un ejemplo práctico es un flujo de trabajo de control de calidad visual: inspeccionar una captura de pantalla, identificar un problema de diseño, proponer un cambio de código y revisar el resultado renderizado a través de las herramientas de la aplicación. El modelo proporciona decisiones y argumentos; el agente circundante proporciona el navegador, la ejecución de código y la verificación.
La principal desventaja es el razonamiento siempre activo. Eso puede ayudar con decisiones ambiguas, pero también crea una sobrecarga para el etiquetado o la extracción básica. GPT-6 Luna y Haiku 5.5 tienen tarifas de token para solicitudes cortas más bajas en esta lista.
Elige GLM-5.3 Flash cuando:
capturas de pantalla, gráficos, documentos o evidencia en video influyan en la siguiente acción;
el flujo de trabajo necesite llamadas a herramientas y resultados estructurados;
la programación visual o las comprobaciones de interfaz iterativas sean parte de la tarea;
los pesos abiertos sean útiles junto con el acceso a la API alojada.
Ten cuidado con: el razonamiento y el volumen de salida. Establece límites en los tokens generados y en los pasos del flujo de trabajo; el nombre Flash no garantiza una latencia de extremo a extremo.
4. DeepSeek Flash: la mejor opción para agentes de peso de entrada con caché
DeepSeek Flash es el nombre de ruta para DeepSeek V4.1 Flash. Usa deepseek-flash en la solicitud en lugar de tratar el nombre de la versión como un nivel de API independiente. Las tarifas de entrada/salida mostradas en GPT Proto son de $0.30 / $1.20 por millón de tokens.
El modelo combina entrada de texto e imagen, una ventana de contexto de hasta 1M de tokens, llamadas a herramientas, salida JSON, streaming y operación con o sin razonamiento (thinking). Esa combinación es ideal para agentes que leen repetidamente archivos de repositorios, instrucciones, documentos o el historial de herramientas antes de generar un resultado comparativamente pequeño.
El almacenamiento en caché es la razón para incluirlo en una lista de opciones con gran volumen de entrada. Las instrucciones y definiciones de herramientas estables pueden reutilizarse en muchas llamadas, pero el ahorro depende de los aciertos de caché reales. Un prompt largo que cambia sustancialmente en cada turno debe presupuestarse de manera diferente.
El manejo del estado también requiere atención. En flujos de trabajo de herramientas con modo de razonamiento nativo, es posible que el estado de razonamiento deba conservarse entre llamadas. Verifica cómo el endpoint de GPT Proto seleccionado representa ese estado antes de migrar un bucle de múltiples turnos. Una primera respuesta válida no garantiza que toda la conversación seguirá siendo compatible.
Elige DeepSeek Flash cuando:
las instrucciones repetidas o el material de referencia hacen que el almacenamiento en caché sea útil;
la inspección de repositorios o el análisis de documentos dominen el volumen de entrada;
el flujo de trabajo se beneficia de alternar entre el trabajo con razonamiento y sin razonamiento;
la evidencia en imágenes deba acompañar al texto en la misma tarea.
Ten cuidado con: los fallos de caché, la salida verbosa y la pérdida del estado de las llamadas a herramientas. Mide el bucle completo en lugar de estimar los ahorros basándote solo en la tasa de caché.
5. MiniMax M3 — La mejor opción para agentes de investigación y documentos extensos
MiniMax M3 vale la pena considerarlo cuando un agente necesita un gran volumen de documentos o un historial de trabajo extenso. En GPT Proto, la cadena del modelo es MiniMax-M3, con tarifas mostradas de $0.48 por millón de tokens de entrada y $0.96 por millón de tokens de salida.
El modelo admite el uso de herramientas, así como flujos de trabajo de codificación y agentes con contexto largo, con una ventana de contexto de hasta aproximadamente 1M de tokens. Su función aquí es el trabajo con gran carga documental: comparar políticas, revisar historiales de soporte, rastrear relaciones entre archivos de referencia o retener resultados de investigación intermedios.
El equilibrio en el precio merece una explicación clara. Las tarifas directas actuales de MiniMax para prompts de hasta 512K tokens de entrada son de $0.30 para entrada y $1.20 para salida por millón de tokens. Con esas tarifas, GPT Proto tiene el precio de salida más bajo, mientras que la ruta directa tiene el precio de entrada más bajo. Ninguna tarifa principal determina cuál factura será más económica para cada carga de trabajo.
Una ventana de contexto grande tampoco reemplaza la recuperación o validación. Alimentar a un agente con un archivo completo puede aumentar su factura sin ayudarle a encontrar la evidencia correcta.
Elige MiniMax M3 cuando:
una tarea dependa de varios documentos o de un historial de trabajo extendido;
el agente necesite retener hallazgos intermedios a través de múltiples pasos;
los informes o explicaciones generados hagan que el costo de salida sea relevante;
desees evaluar un modelo de pesos abiertos a través de acceso alojado.
Ten cuidado con: el costo acumulado de entrada y la pérdida de evidencia en documentos largos. Prueba el razonamiento entre documentos y confirma las capacidades de entrada de la ruta seleccionada.
6. Gemini 3.8 Flash — La mejor opción para agentes de audio, video y multimedia
Gemini 3.8 Flash se gana su lugar cuando la tarea incluye audio, video, imágenes o archivos PDF, además de texto. GPT Proto muestra $0.90 por millón de tokens de entrada y $4.50 por millón de tokens de salida para la ruta gemini-3.8-flash.
El modelo tiene una ventana de entrada de aproximadamente 1M de tokens, razonamiento ajustable, llamada a funciones y salida estructurada. Es un candidato práctico para un flujo de trabajo que revisa un video de un cliente, lee un documento de respaldo y prepara la siguiente acción de la aplicación.
Su valor proviene del trabajo que esas entradas pueden reemplazar. Un agente que comprende varios tipos de medios puede necesitar menos etapas de procesamiento por separado. Verifica los formatos de archivo compatibles y el mapeo de solicitudes en la ruta de GPT Proto antes de asumir que el ecosistema completo de herramientas del modelo original está disponible.
No es la opción con el precio por token más bajo aquí. Las tarifas introductorias directas de Google son de $0.75 para entrada y $3.75 para salida por millón de tokens hasta el 31 de diciembre de 2026, por debajo de las tarifas mostradas actualmente en GPT Proto. La razón para usar esta ruta es el acceso junto con otros modelos a través de una sola cuenta y saldo.
Elige Gemini 3.8 Flash cuando:
el audio o video sea fundamental para la tarea;
el mismo flujo de trabajo deba inspeccionar varios tipos de medios;
un modelo multimodal pueda simplificar etapas de preprocesamiento separadas;
el razonamiento ajustable sea útil en solicitudes rutinarias y difíciles.
Ten cuidado con: el costo de salida y el soporte de herramientas específico del proveedor. Evalúa el flujo de trabajo terminado en lugar de confiar en una cifra de velocidad de generación.
7. Grok 4.7: la mejor opción para programación compleja y escalamiento de múltiples pasos
Grok 4.7 es la opción de escalamiento en esta lista. Ya aparece en GPT Proto a $1.20 por millón de tokens de entrada y $3.60 por millón de tokens de salida, igualando las tarifas mostradas para Grok 4.6.
El modelo acepta texto e imágenes, admite llamadas a funciones y salidas estructuradas, y ofrece una ventana de contexto de 500K tokens. Sus cuatro niveles de razonamiento (bajo, medio, alto y extra alto) permiten a los desarrolladores probar cuánto esfuerzo requiere una tarea difícil.
Esto lo hace relevante cuando un agente debe diagnosticar un cambio de código fallido, coordinar varios resultados de herramientas dependientes o reconsiderar un plan después de que la validación falla. Un modelo de menor costo puede manejar la preparación rutinaria mientras Grok se encarga del paso difícil.
El límite es económico más que técnico. Enviar cada solicitud de extracción o enrutamiento a un modelo de escalamiento aumenta el costo antes de que se necesite su razonamiento más potente. Una versión más reciente con las mismas tarifas de tokens tampoco garantiza una factura menor por tarea completada; compara ambas versiones si una aplicación existente ya depende de Grok 4.6.
Elige Grok 4.7 cuando:
una tarea de programación o investigación necesite varias decisiones dependientes;
la ruta de menor costo falle repetidamente en una verificación de aceptación definida;
la evidencia de imagen y el razonamiento deban considerarse juntos;
la recuperación exitosa valga el gasto adicional del modelo.
Ten cuidado con: los reintentos costosos y el esfuerzo de razonamiento excesivo. Mantenlo en una ruta de escalamiento definida y detente cuando la tarea necesite un permiso o una entrada faltante que otro modelo no pueda proporcionar.
Por qué los tokens baratos aún pueden generar tareas de agente costosas
Una tarifa de token baja ayuda con la clasificación o reescritura repetida. Dice mucho menos sobre un agente que debe elegir herramientas, interpretar sus resultados y recuperarse de errores.
Un modelo puede producir respuestas baratas mientras selecciona repetidamente la función incorrecta u omite un argumento requerido. Cada reparación añade otra llamada al modelo, más historial de conversación y, potencialmente, otra operación de herramienta. La tarea puede volverse costosa antes de que el agente produzca un resultado aceptable.
Antes de darle a un modelo el control de un flujo de trabajo, verifica si puede:
distinguir entre herramientas similares;
producir argumentos que satisfagan tanto el esquema como las reglas de negocio;
continuar después de un resultado de herramienta o un error recuperable;
reconocer cuándo ninguna herramienta disponible es apropiada.
Comienza con tu umbral de aceptación y luego compara el costo total de los modelos que lo superen. Un paso de extracción limitado y un controlador de múltiples herramientas no necesitan el mismo modelo.
Una estrategia práctica de enrutamiento de modelos de bajo costo
Puedes asignar diferentes pasos a distintos modelos dentro de un mismo agente. La preparación rutinaria se dirige a una ruta de bajo costo; el razonamiento complejo se dirige a una ruta de escalamiento. La aplicación toma esa decisión utilizando el tipo de tarea, los resultados de validación y los límites de gasto.
| Tarea del agente |
Primer modelo a evaluar |
Escalar o cambiar de ruta cuando |
| Clasificación, extracción y enrutamiento de solicitudes |
GPT-6 Luna |
El resultado no supera la validación o la solicitud es ambigua |
| Soporte repetitivo y subtareas de programación de Claude |
Claude Haiku 5.5 |
Se necesita una planificación más amplia o los intentos repetidos fallan; revisa los costos si la entrada supera los 100K |
| Verificaciones visuales y flujos de trabajo basados en documentos |
GLM-5.3 Flash |
El modelo no puede resolver evidencia contradictoria o completar la verificación |
| Contexto repetitivo y con uso intensivo de caché |
DeepSeek Flash |
Se pierde el estado, falla el manejo de herramientas o los ahorros de caché medidos no se materializan |
| Sesiones de investigación y documentos largos |
MiniMax M3 |
Se pasan por alto relaciones importantes entre documentos |
| Entrada de audio, video y multimedia mixta |
Gemini 3.8 Flash |
La evidencia extraída requiere un paso de planificación separado y más difícil |
| Programación difícil y recuperación de varios pasos |
Grok 4.7 |
El flujo de trabajo alcanza su límite de tiempo, pasos o gasto |
Estos son puntos de partida para la evaluación. Un error de validación puede provenir del prompt, la definición de la herramienta o la aplicación, así como del modelo; inspecciona la causa antes de pagar por una ruta más potente.
Mantén el costo del agente bajo control con cinco reglas:
Usa un modelo de bajo costo solo después de que pase las verificaciones de aceptación de la tarea.
Valida los argumentos de la herramienta antes de la ejecución.
Limita las llamadas al modelo, los tokens de salida, el tiempo transcurrido y el gasto para cada ejecución.
Define una regla de recuperación o escalamiento en lugar de reintentar la misma solicitud indefinidamente.
Detente para obtener aprobación cuando una acción exceda los permisos del agente.
GPT Proto proporciona acceso a modelos compatibles con una sola clave API y un saldo compartido. La aplicación o el framework sigue gestionando el enrutamiento, el estado, la ejecución de herramientas y las condiciones de detención. Consulta la página LLM API para agentes de IA para comparar el acceso a modelos y estimar los costos de un flujo de trabajo existente. Para pasos de enrutamiento y clasificación acotados, compara Jev y LLMs de propósito general antes de asignar la decisión a un modelo de agente más costoso.
Solicitud mínima de llamada a herramientas con GPT Proto
Este ejemplo utiliza glm-5.3-flash y define get_order_status como una herramienta que la aplicación puede ejecutar. Una respuesta del modelo puede solicitar esa función; la solicitud en sí no le da al modelo acceso a tu sistema de pedidos.
Abre la página del modelo GLM-5.3 Flash y selecciona Probar este modelo para el inicio rápido actual, luego proporciona tu clave de API del lado del servidor al ejemplo.
curl https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.3-flash",
    "messages": [
      {
        "role": "user",
        "content": "¿Dónde está el pedido A-1042?"
      }
    ],
    "tools": [
      {
        "type": "function",
        "function": {
          "name": "get_order_status",
          "description": "Devuelve el estado actual de un pedido.",
          "parameters": {
            "type": "object",
            "properties": {
              "order_id": {
                "type": "string",
                "description": "El identificador del pedido."
              }
            },
            "required": ["order_id"],
            "additionalProperties": false
          }
        }
      }
    ],
    "tool_choice": "auto"
  }'
Para obtener una respuesta de Chat Completions compatible con OpenAI, inspecciona choices[0].message.tool_calls. Para cada llamada devuelta:
verifica que la función esté permitida para este usuario y tarea;
analiza y valida los argumentos;
ejecuta la función en tu aplicación;
devuelve su resultado en un mensaje de herramienta con el tool_call_id correspondiente;
solicita la siguiente respuesta del modelo, manteniendo cualquier estado de razonamiento requerido.
Cambiar de modelo requiere una verificación de compatibilidad. La llamada a herramientas de Chat Completions de GPT-6 Luna requiere reasoning_effort: "none"; la llamada a funciones con razonamiento habilitado utiliza Responses. Otras rutas pueden tener diferentes requisitos de estado o parámetros. Consulta el inicio rápido de cada modelo en lugar de asumir que una carga útil idéntica funciona en todas partes.
Esta es la primera solicitud en un bucle de herramientas. Tu aplicación debe proporcionar la ejecución de la herramienta y los mensajes subsiguientes.
Cómo probar una API de LLM asequible para tu agente
Utiliza tareas representativas de tu aplicación. Un benchmark general puede ayudar a crear la lista de candidatos, pero un modelo también debe funcionar con los nombres de tus herramientas, tus datos y tus reglas de aceptación.
Comienza con cuatro categorías:
Selección de herramientas: Ofrece funciones similares y verifica si el modelo elige la correcta.
Múltiples herramientas: Proporciona una solicitud que necesite dos resultados independientes. Prueba llamadas en paralelo donde la ruta las admita, o completa ambas a través de turnos sucesivos.
Solicitudes sin herramientas: Incluye preguntas para las cuales no se deba llamar a ninguna de las herramientas disponibles.
Recuperación: Devuelve un error de herramienta realista y verifica si el modelo corrige su siguiente paso sin entrar en un bucle infinito.
Mantén las instrucciones, las definiciones de herramientas, los datos de entrada y los criterios de aceptación consistentes. Utiliza la configuración admitida para cada ruta y registra su endpoint y su configuración de razonamiento; los nombres de parámetros idénticos no siempre son portables entre proveedores.
Ejecuta cada categoría al menos cinco veces por modelo. Con siete modelos, cuatro categorías y cinco repeticiones, la comparación inicial contiene 140 ejecuciones. Este es un diseño de evaluación piloto, no una afirmación de que esas ejecuciones ya se hayan completado o que cinco repeticiones establezcan la confiabilidad en producción.
Registra:
finalizaciones de tareas aceptadas;
elecciones de herramientas correctas y argumentos válidos;
llamadas innecesarias y fallas de recuperación;
turnos del modelo y tiempo total del flujo de trabajo;
entrada sin caché, lecturas o escrituras de caché, y tokens de salida o razonamiento facturados;
niveles de longitud de prompt aplicables y otros componentes facturados;
costo total de la API, incluidos reintentos e intentos fallidos.
Calcula:
Costo por tarea aceptada = Gasto total en API durante la evaluación / Número de finalizaciones aceptadas
Reporta las fallas por separado, especialmente si un modelo no acepta ninguna tarea. Compara los costos solo después de verificar el umbral de calidad; luego, expande la evaluación en torno a los casos de falla que importan en producción.
Qué dicen los creadores de agentes sobre la latencia
Los informes de la comunidad añaden contexto que las páginas de precios no pueden proporcionar. En una discusión de la comunidad de Agentes de IA, un sistema de recuperación simple supuestamente respondió en menos de un segundo, mientras que una versión más orientada a agentes tardó casi tres segundos. Para el servicio al cliente, esa diferencia se describió como un factor decisivo.
Otros participantes no estuvieron de acuerdo con la conclusión universal. Señalaron que los usuarios de investigación y análisis internos pueden aceptar esperas mucho más largas cuando el uso de herramientas mejora materialmente la respuesta. La lección útil no es que tres segundos siempre sea demasiado lento. Es que el mismo modelo puede ser asequible para un agente e inadecuado para otro porque la latencia, la calidad y los costos de falla tienen valores diferentes.
Trata los comentarios de la comunidad como informes de experiencia, no como resultados de benchmarks. Úsalos para identificar casos de falla para tu propia evaluación.
Para tu propio agente, mide el tiempo hasta la primera respuesta útil y el tiempo hasta la tarea completada junto con la velocidad de generación. Un modelo puede comenzar rápidamente pero tomar varios turnos adicionales para terminar. Por lo tanto, el soporte interactivo y la investigación de fondo pueden necesitar diferentes objetivos de latencia, incluso cuando utilizan la misma ruta de API.
Recomendación final
Para pasos frecuentes y limitados, comienza con GPT-6 Luna. Tiene las tarifas base de entrada y salida más bajas de esta lista y se ajusta a las solicitudes que tu aplicación puede validar.
Elige Claude Haiku 5.5 para soporte repetitivo y subtareas de programación en Claude, manteniendo visible el umbral de precios de entrada de 100K. Usa GLM-5.3 Flash cuando capturas de pantalla, documentos u otra evidencia visual guíen la siguiente acción de la herramienta.
Evalúa DeepSeek Flash para entradas repetidas con uso intensivo de caché y MiniMax M3 para sesiones de documentos largos. Elige Gemini 3.8 Flash cuando la comprensión de audio o video reduzca el número de etapas de procesamiento separadas. Reserva Grok 4.7 para programación difícil y recuperación de varios pasos.
La elección final debe ser el modelo que alcance tu objetivo de aceptación al costo de flujo de trabajo medido más bajo. Usa las tarifas de tokens para crear la lista, luego incluye las ejecuciones fallidas, el razonamiento, las herramientas y los reintentos en la decisión.
¿Listo para conectar tu lista? Explora la API de LLM para agentes de IA de GPT Proto para ver modelos compatibles, estimaciones de carga de trabajo y acceso a través de una sola clave y saldo compartido. Usa el panel de Probar este modelo en la página de cada modelo para su inicio rápido y revisa los precios de GPT Proto antes de escalar.