Claude vs ChatGPT para programar: veredicto rápido
La mejor elección depende de cómo programas y de cuánta de la tarea quieres que la IA complete de forma independiente.
| Tarea de programación |
Mejor punto de partida |
Por qué |
| Funciones pequeñas y scripts |
Empate |
La calidad del prompt y el nivel del modelo suelen importar más que el proveedor |
| Programación en pareja interactiva |
Claude Code |
Comentarios rápidos y personalización profunda de la terminal |
| Trabajos de programación autónomos largos |
Codex |
Sólidos flujos de trabajo de delegación y revisión, y en segundo plano |
| Generación de frontend e interfaz de usuario |
Claude |
Una ligera ventaja cualitativa para la implementación visual y la iteración |
| Depuración intensiva en terminal |
ChatGPT/Codex |
GPT-5.6 Sol lidera por poco la comparación compartida de Terminal-Bench |
| Refactorización de todo el repositorio |
Claude Opus 5 |
Fuerte rendimiento en migración de código e ingeniería de múltiples archivos |
| Desarrollo en Python |
Empate |
El ganador cambia según la tarea, las bibliotecas, las pruebas y el acceso al repositorio |
| Bases de código grandes |
Claude, ligera ventaja |
Fuerte razonamiento sobre repositorios, aunque ambas familias ahora admiten contextos muy grandes |
| Suscripción de programación de nivel básico |
ChatGPT Plus |
Su asignación publicada de Codex suele ser más fácil de estimar y estirar |
| Implementación de API |
Depende del nivel del modelo |
El costo por resultado aceptado importa más que la solicitud individual más barata |
Elige Claude para colaboración cercana y cambios grandes e interconectados. Elige ChatGPT con Codex cuando prefieras delegar y revisar. Los equipos de API deberían evaluar modelos individuales en lugar de tratar a cualquiera de los proveedores como un producto fijo.
¿Qué estamos comparando: Claude, ChatGPT, Claude Code o Codex?
La diferencia entre Claude y ChatGPT comienza con la superficie del producto.
Claude.ai y ChatGPT son aplicaciones generales para explicar, generar y revisar código. Claude Code y Codex son agentes de programación que pueden inspeccionar repositorios, editar archivos, ejecutar comandos y pruebas, y corregir fallos. Eso cambia la tarea de “escribir código” a “producir y verificar un cambio que funcione”.
Las API son otra capa: la aplicación circundante selecciona archivos y herramientas, ejecuta comandos, devuelve errores y decide cuándo el trabajo está completo. Por lo tanto, un modelo que escribe una función correcta en el chat puede comportarse de manera diferente dentro de un agente. Una comparación justa entre Claude AI y ChatGPT debe evaluar tanto el modelo como su entorno de trabajo.
Modelos actuales de Claude y GPT para programar
Una guía actual de Claude vs ChatGPT para programar debe comparar niveles de modelo equivalentes. Anthropic recomienda Claude Opus 5 para las cargas de trabajo más complejas y Fable 5.1 para trabajos de largo horizonte especialmente exigentes. OpenAI posiciona GPT-5.6 Sol como su buque insignia para programación compleja, con Terra y Luna para cargas de trabajo más ligeras.
| Modelo |
Mejor encaje para programar |
Ventana de contexto |
Principal compensación |
| Claude Fable 5.1 |
Programación agéntica exigente y de larga duración |
1M tokens |
Precio más alto de la API de Claude y latencia más lenta |
| Claude Opus 5 |
Programación compleja, migraciones y trabajo de repositorio |
1M tokens |
Más caro que los modelos de gama media |
| Claude Sonnet 5 |
Programación diaria con menor latencia |
1M tokens |
Techo más bajo en las tareas de ingeniería más difíciles |
| GPT-5.6 Sol |
Programación compleja, agentes y trabajo en terminal |
1.05M tokens |
Mayor costo y latencia que los modelos GPT más pequeños |
| GPT-5.6 Terra |
Tareas diarias de desarrollo y producción |
1.05M tokens |
Menos capaz que Sol en el trabajo más difícil |
| GPT-5.6 Luna |
Scripts enfocados y transformaciones de gran volumen |
1.05M tokens |
No está pensado para las tareas de ingeniería más ambiguas |
Puedes revisar la actual familia de modelos Claude y familia de modelos OpenAI en GPT Proto. Para cargas de trabajo de programación difíciles, las páginas individuales más relevantes son Claude Fable 5.1, Claude Opus 5, y GPT-5.6 Sol. Para el trabajo de producción rutinario, GPT-5.6 Terra es un punto de comparación más económico.
Empareja los modelos según la carga de trabajo y luego mide el costo total necesario para obtener un resultado aceptable.
Lo que realmente muestran los benchmarks de programación
La evidencia actual de benchmarks no respalda un ganador universal. Claude lidera algunas evaluaciones de repositorio y generación de código, mientras que GPT-5.6 Sol lidera por poco un benchmark de terminal compartido.
| Benchmark |
Resultado de Claude |
Resultado de GPT |
Lo que sugiere |
| Terminal-Bench 2.1 |
Fable 5.1: 85.02% |
GPT-5.6 Sol: 85.77% |
GPT mantiene una ligera ventaja en tareas de agente basadas en terminal |
| SWE-bench Verified |
Opus 5: 97.00% |
GPT-5.6 Sol: 96.20% |
Ambos son muy competitivos en problemas reales de repositorio |
| Vibe Code Bench |
Fable 5.1: 90.26% |
GPT-5.6 Sol: 80.50% |
Claude muestra una ventaja en la generación de aplicaciones de extremo a extremo |
| LiveCodeBench |
Fable 5.1: 90.52% |
— |
Fuerte resolución de problemas de código, pero no una comparación completa de productos |
Estos resultados provienen de evaluaciones de Vals de Claude Fable 5.1, Claude Opus 5, y GPT-5.6 Sol, pero aún requieren contexto.
Por ejemplo, Fable 5.1 se evaluó con respaldos del lado del servidor de Claude para rechazos. Vals informa que su puntuación en Terminal-Bench 2.1 cae del 85.02% al 79.03% cuando las tareas asistidas por respaldo se cuentan como fallos. La configuración de evaluación también difiere: Fable 5.1 y GPT-5.6 Sol usaron esfuerzo máximo, mientras que Opus 5 usó esfuerzo alto para Terminal-Bench.
Claude rinde especialmente bien en evaluaciones de generación de código, migración y creación de aplicaciones. GPT-5.6 Sol está cerca en resolución de repositorios y ligeramente por delante en el benchmark de terminal compartido. Esas diferencias pueden invertirse con diferentes agentes, herramientas o bases de código.
Claude vs ChatGPT para la generación de código
Para tareas pequeñas y claramente especificadas de generación de código, Claude y ChatGPT son tan similares que no hay un ganador universal confiable. Ambos pueden generar funciones, transformaciones de datos, controladores de API, casos de prueba y aplicaciones pequeñas cuando el prompt contiene los requisitos relevantes.
Claude es un buen punto de partida para la planificación de la implementación y la coordinación entre varios archivos. ChatGPT es igualmente práctico para scripts enfocados, salidas estructuradas y tareas con una definición precisa de terminado. Dentro de Codex, los modelos GPT pueden implementar y verificar cambios en lugar de solo sugerir código.
Cuando compares Claude o ChatGPT para programar, dale a ambos los mismos lenguajes y versiones de dependencias, archivos editables, comportamiento esperado, restricciones de compatibilidad y pruebas requeridas. Una respuesta más corta aún puede ser mejor si el código pasa en el primer intento. Mide la salida aceptada, no lo impresionante que parezca la respuesta.
Claude vs ChatGPT para la depuración
Claude vs ChatGPT para la depuración no es una sola comparación. Depurar una traza de pila pegada es diferente de encontrar una regresión distribuida en un repositorio desconocido. 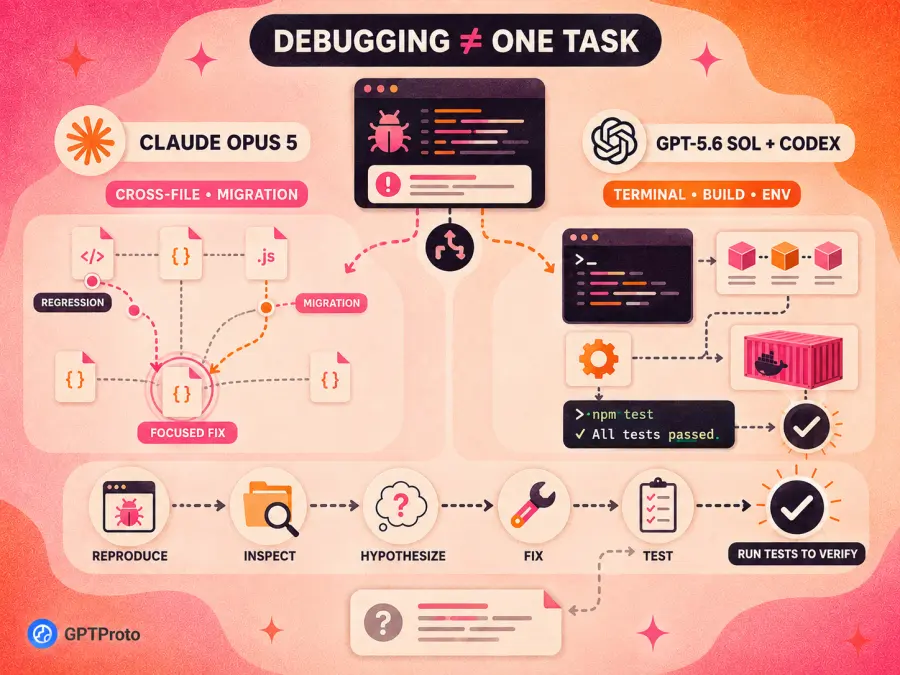
Para un solo mensaje de error, ambos productos suelen explicar las causas probables y proponer comprobaciones. El resultado depende en gran medida de si el usuario incluye el código circundante, la versión del entorno de ejecución, las versiones de dependencias, los datos de entrada y el error completo, en lugar de solo su línea final.
Para problemas de terminal, dependencias, compilación y entorno, GPT-5.6 Sol con Codex es un buen punto de partida. Su estrecha ventaja en Terminal-Bench sugiere fortaleza en tareas que requieren interacción con la línea de comandos, aunque la diferencia con Fable 5.1 es menor de un punto porcentual bajo la configuración reportada.
Para errores lógicos entre archivos, migraciones y regresiones arquitectónicas, Claude Opus 5 es una primera opción razonable. Sus sólidos resultados en repositorios y migración de código indican que puede ser eficaz cuando una corrección depende de comprender relaciones entre varios módulos.
En la práctica, la calidad de la depuración depende de si el agente puede reproducir el fallo, inspeccionar los archivos relevantes, formular una hipótesis comprobable, aplicar una corrección enfocada y ejecutar las pruebas afectadas. Si no puede acceder al entorno, trata su respuesta como una hipótesis, no como una corrección verificada.
Claude vs ChatGPT para programación frontend
Claude tiene una ligera ventaja cualitativa para la programación frontend, especialmente cuando la tarea implica traducir una dirección visual a componentes, diseños, comportamiento responsivo, animaciones o estados interactivos. Los primeros informes sobre Claude Opus 5 también han destacado mejoras en la creación de aplicaciones full-stack, incluido el trabajo visual e interactivo.
Eso no significa que cada resultado de Claude vaya a verse pulido. Ambos productos pueden recurrir a tarjetas genéricas, degradados y diseños centrados en escritorio cuando el brief es vago. Dales la misma referencia de diseño, tamaños de viewport, framework, reglas de marca, estados de interacción, requisitos de accesibilidad y criterios de aceptación.
Ningún modelo debería juzgar su propia salida visual solo a partir del código fuente. El rendimiento mejora cuando el agente puede abrir la página, inspeccionar capturas de pantalla, compararlas con la referencia y revisar el CSS. Claude puede ofrecer el mejor primer intento; el mejor flujo de trabajo es el que incluye verificación visual.
Claude vs ChatGPT para Python
No hay un ganador general en Claude vs ChatGPT para Python porque “programación en Python” abarca desde un script de diez líneas para renombrar archivos hasta un gran servicio Django o un pipeline de aprendizaje automático.
| Tarea de Python |
Mejor punto de partida |
| Script de automatización pequeño |
Claude o ChatGPT |
| Limpieza y transformación de datos |
Un modelo equilibrado como Sonnet 5 o GPT-5.6 Terra |
| Refactorización de una aplicación Python grande |
Claude Opus 5 |
| Solución de problemas de CLI, paquetes o entorno |
GPT-5.6 Sol con Codex |
| Explicación extensa de notebook |
Claude suele ser más fácil de seguir |
| Transformación repetitiva de gran volumen |
Un modelo más pequeño y económico después de la validación |
Evalúa ambos en el mismo entorno y comprueba la compatibilidad de dependencias, los casos límite, el manejo de archivos, las comprobaciones de tipos, el linting y los resultados de pytest. Una explicación clara importa menos que el comportamiento verificado.
Claude vs ChatGPT para bases de código grandes
Claude es la primera opción más sólida para muchos análisis de todo el repositorio, migraciones de código y cambios coordinados en varios archivos. Claude Opus 5 rinde muy bien en benchmarks de migración de código y repositorios, mientras que Fable 5.1 está pensado para trabajo agéntico exigente y de larga duración.
Sin embargo, el tamaño de la ventana de contexto por sí solo no establece esta ventaja. Los actuales modelos insignia de Claude ofrecen una ventana de contexto de hasta 1M de tokens, mientras que la familia GPT-5.6 ofrece aproximadamente 1,05M de tokens. Ambos son lo suficientemente grandes para contener código sustancial, pero insertar ciegamente un repositorio completo puede desperdiciar tokens y ocultar las dependencias relevantes.
El rendimiento en bases de código grandes depende de si el agente puede mapear el repositorio, localizar los archivos relevantes, seguir las instrucciones del proyecto, preservar las interfaces y verificar sus cambios. Una selección y compactación eficaces del contexto pueden importar más que el máximo anunciado.
Elige Claude Opus 5 cuando la tarea implique una migración amplia, razonamiento arquitectónico o cambios coordinados entre módulos interconectados. Elige GPT-5.6 Sol con Codex cuando la tarea esté bien especificada, sea intensiva en terminal y sea adecuada para una ejecución autónoma más larga. Para cualquiera de las dos opciones, divide los cambios muy grandes en etapas verificables y exige pruebas en cada límite.
Claude Code vs Codex: El agente puede importar tanto como el modelo
Claude Code y Codex difieren en su flujo de trabajo incluso antes de considerar sus modelos predeterminados.
| Dimensión |
Claude Code |
Codex |
| Flujo de trabajo típico |
Desarrollo interactivo en terminal |
Delegar, ejecutar y revisar |
| Instrucciones del repositorio |
CLAUDE.md |
AGENTS.md |
| Personalización |
Hooks profundos, habilidades y configuración del agente |
Más valores predeterminados gestionados y controles de sandbox |
| Estilo de retroalimentación |
Rápido e interactivo |
Más deliberado y autónomo |
| Buen encaje |
Desarrolladores que permanecen muy involucrados |
Trabajo en segundo plano, revisión y tareas en paralelo |
| Principal compromiso |
Las sesiones complejas pueden consumir los límites rápidamente |
Algunas tareas tardan más en finalizar |
Una útil prueba de terceros de Composio ayuda a separar el harness del modelo subyacente. El evaluador ejecutó el mismo modelo DeepSeek V4 Flash a través de Claude Code y Codex, usando 30 tareas idénticas de múltiples aplicaciones, la misma configuración alojada de MCP, razonamiento máximo y un límite de 900 segundos por tarea.
| Resultado |
Claude Code |
Codex |
| Tareas superadas |
16/30 |
16/30 |
| Tiempo de finalización mediano |
122.7 segundos |
245.0 segundos |
| Llamadas a herramientas |
358 |
448 |
| Costo total estimado |
$3.116 |
$1.294 |
| Costo por éxito |
$0.195 |
$0.081 |
Los dos harness lograron el mismo número de aprobados. Claude Code terminó en aproximadamente la mitad del tiempo mediano, mientras que Codex costó aproximadamente un 58% menos. La comparación completa de Composio respalda una conclusión limitada: Claude Code ofreció retroalimentación más rápida en esta configuración, mientras que Codex estiró más el presupuesto. No demuestra que los modelos Claude sean más inteligentes porque la prueba usó el mismo modelo de terceros en ambas herramientas.
Tasas de uso de Claude Pro en comparación con ChatGPT Pro
Las tasas de uso de Claude Pro en comparación con ChatGPT Pro se describen con frecuencia con recuentos fijos de mensajes engañosos. Ambos proveedores varían el consumo según el modelo seleccionado, la longitud del contexto, el esfuerzo de razonamiento, las herramientas y la complejidad de la tarea.
La comparación de precios actual más cercana es:
| Precio mensual |
Plan de Anthropic |
Plan de OpenAI |
| $20 |
Claude Pro |
ChatGPT Plus |
| $100 |
Claude Max 5x |
ChatGPT Pro 5x |
| $200 |
Claude Max 20x |
ChatGPT Pro 20x |
El uso de Claude se comparte entre Claude.ai, Claude Desktop y Claude Code. Sus planes combinan límites de sesión de cinco horas con límites semanales; los usuarios pueden esperar un restablecimiento, actualizar de plan o habilitar créditos de uso facturados por separado.
ChatGPT Work y Codex también comparten el presupuesto de uso aplicable. OpenAI publica estimaciones amplias para mensajes locales de Codex por ventana de cinco horas. Para GPT-5.6 Sol, los rangos actuales son aproximadamente 10–100 en Plus, 50–500 en Pro 5x y 200–2,000 en Pro 20x. Las tareas en la nube pueden consumir más que los mensajes locales, y dos tareas aparentemente similares pueden usar cantidades diferentes.
Estos son rangos de planificación, no garantías. Una tarea larga de repositorio puede consumir más capacidad que varias ediciones enfocadas. A $20, ChatGPT Plus suele ser el punto de partida más seguro para un uso sostenido de agentes; los usuarios intensivos de Claude Code pueden necesitar capacidad Max o créditos de uso. A $100 y $200, el flujo de trabajo preferido importa más que el multiplicador destacado.
Claude vs ChatGPT API para desarrolladores
Los planes de suscripción están pensados para personas que trabajan dentro de los productos Claude o ChatGPT. Los desarrolladores que crean una aplicación deberían comparar en su lugar modelos de API y facturación basada en uso.
| Carga de trabajo |
Opción de Claude |
Opción de GPT |
| Trabajo agéntico de horizonte largo más difícil |
Claude Fable 5.1 |
GPT-5.6 Sol |
| Programación diaria compleja |
Claude Opus 5 |
GPT-5.6 Sol |
| Carga de trabajo de producción equilibrada |
Claude Sonnet 5 |
GPT-5.6 Terra |
| Tareas enfocadas de alto volumen |
Claude Haiku 4.5 |
GPT-5.6 Luna |
Los precios oficiales de tokens pueden ayudar a seleccionar un modelo inicial, pero no revelan el costo completo de un flujo de trabajo de programación. Un modelo más capaz puede terminar con menos reintentos. Un modelo más barato puede ser económico para tareas repetitivas, pero costoso si los ingenieros deben reparar repetidamente su resultado.
En tu propio conjunto de tareas, registra la finalización al primer intento, las pruebas superadas, los reintentos, las intervenciones humanas, las llamadas a herramientas fallidas, los tokens totales, el tiempo y el costo por resultado aceptado. El ganador puede cambiar según la etapa: Claude podría encargarse del análisis del repositorio, GPT de la implementación con mucho terminal y un modelo más pequeño de transformaciones repetitivas.
¿Puedes usar modelos Claude y GPT juntos?
No necesitas seleccionar un solo proveedor para cada carga de trabajo de programación. Las aplicaciones pueden enrutar tareas según la complejidad, la latencia, el costo o el tipo de trabajo de ingeniería involucrado.
GPT Proto proporciona acceso a las familias de modelos Claude y GPT a través de una única clave de API y un saldo compartido. Esto facilita enviar las mismas tareas de evaluación a ambos proveedores, comparar calidad y costo, y cambiar de modelo sin mantener cuentas de facturación separadas para cada proveedor.
Esto no significa que una clave de GPT Proto reemplace una suscripción de Claude o ChatGPT dentro de cada cliente de programación nativo. Los desarrolladores pueden llamar a las API compatibles de Claude y GPT desde sus propias aplicaciones; la compatibilidad del cliente aún depende del soporte para endpoints personalizados y esquemas de solicitud.
Claude o ChatGPT para programar: decisión final
Elige Claude si pasas la mayor parte del tiempo en un flujo de trabajo interactivo de terminal, te importa la implementación de frontend o necesitas un modelo que razone a través de un repositorio grande e interconectado. Claude Opus 5 es el punto de partida sensato para la mayoría de los trabajos de desarrollo complejos, mientras que Fable 5.1 está pensado para las tareas de horizonte largo más difíciles.
Elige ChatGPT con Codex si prefieres flujos de trabajo de delegar y revisar, tareas autónomas con mucho terminal o acceso de programación integrado con una suscripción más amplia de ChatGPT. GPT-5.6 Sol es la opción GPT más sólida para trabajo difícil, mientras que Terra y Luna pueden reducir el costo en tareas más claras y repetitivas.
Para el desarrollo de API, resuelve la decisión Claude vs ChatGPT para programar con tus propias pruebas de aceptación. Ejecuta las mismas tareas, herramientas y pruebas contra niveles comparables, y luego mide resultados exitosos, correcciones, latencia y costo. La evidencia pública muestra dos familias muy competitivas, no un campeón permanente.