Lo que necesitas antes de conectar GPT Proto a Janitor AI
Antes de abrir la configuración de proxy de Janitor AI, prepara lo siguiente:
| Elemento requerido |
Para qué se utiliza |
| Cuenta de Janitor AI |
Abrir y gestionar un chat con un personaje |
| Cuenta de GPT Proto |
Acceder a modelos de lenguaje compatibles |
| Clave de API de GPT Proto |
Autenticar la solicitud de proxy |
| Saldo disponible |
Pagar por los tokens procesados por el modelo seleccionado |
| Cadena exacta del modelo |
Indicarle a GPT Proto qué modelo debe llamar Janitor AI |
Puedes revisar el uso de modelos y API de Janitor AI antes de elegir un modelo.
Crea o copia tu clave de API desde el panel de control de GPT Proto. Mantén la clave completa en privado. No la publiques en capturas de pantalla, definiciones de personajes, prompts compartidos, repositorios públicos ni publicaciones de soporte.
Cómo usar Janitor AI con las API de GPT Proto
Janitor AI te permite conectar un modelo de lenguaje externo a través de su proveedor Proxy. Para GPT Proto, necesitas un endpoint de Chat Completions completo, una clave de API de GPT Proto y una cadena exacta del modelo.
La configuración completa requiere cinco pasos.
Paso 1: Crea o copia tu clave de API de GPT Proto
Inicia sesión en GPT Proto y abre la sección de claves de API de tu panel de control. Crea una clave nueva o copia una clave activa existente.
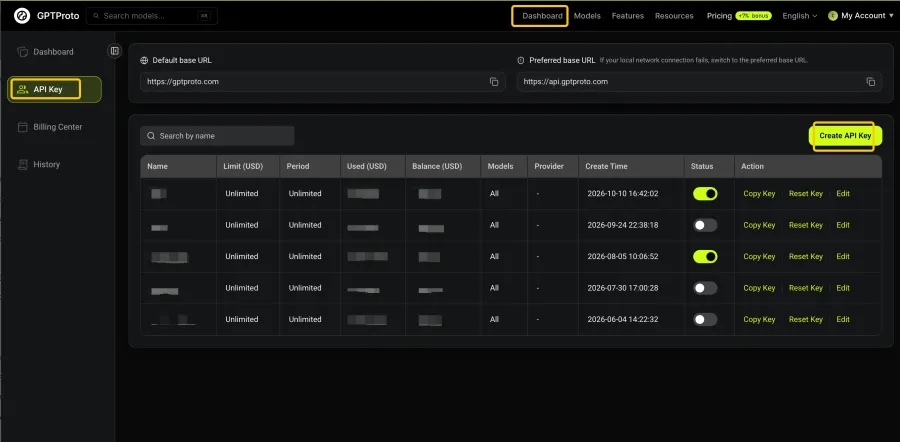
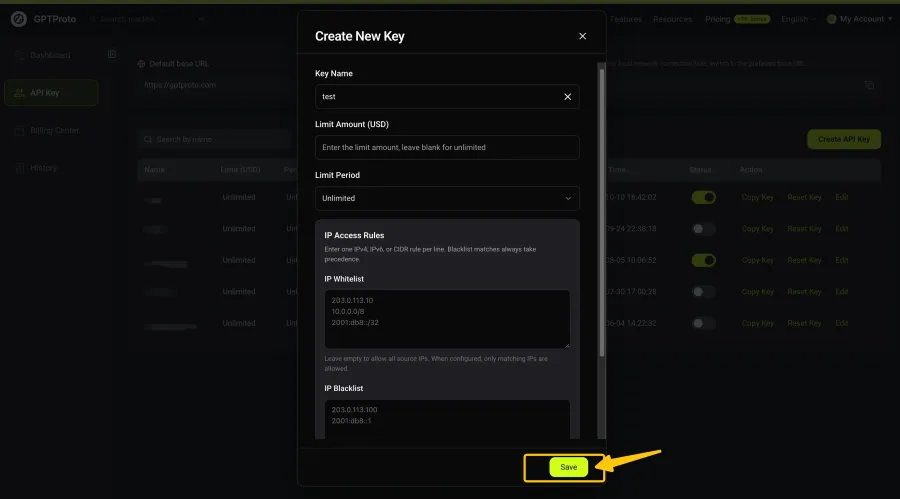
Copia la clave tal cual. No añadas comillas, Bearer ni espacios antes o después al pegarla en Janitor AI.
Si la clave aparece en alguna captura de pantalla, cubre el valor completo antes de publicar la imagen. Ocultar solo la sección central podría revelar partes identificables de la credencial.
Paso 2: Abre la configuración de API de Janitor AI
Abre un chat con un personaje en Janitor AI. Haz clic en el menú junto a la información del proveedor en la esquina superior derecha del chat y luego selecciona Settings.
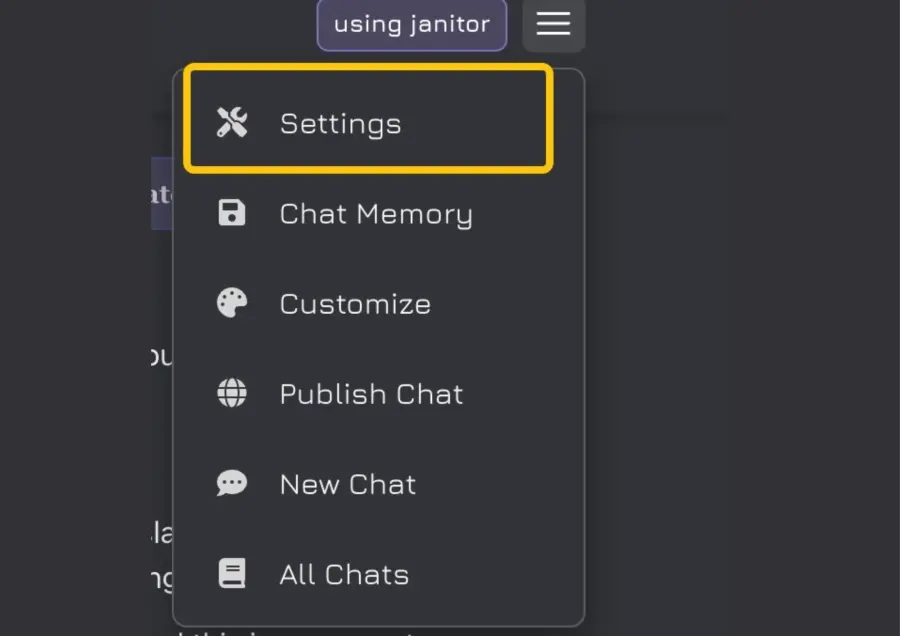
La configuración de la API se gestiona dentro de la interfaz del chat. Abrir solo el perfil público de un personaje no mostrará los campos de configuración que se indican en los siguientes pasos.
Paso 3: Selecciona Proxy y crea una configuración
En el panel de configuración, cambia Provider a Proxy. En las configuraciones de Proxy, haz clic en + New.
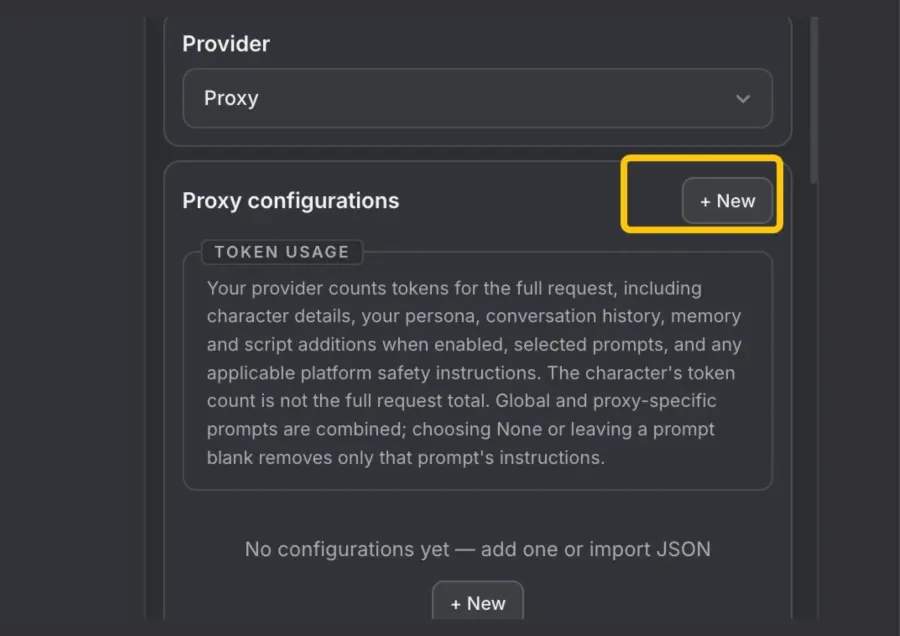
Vale la pena leer el aviso que se muestra en este panel. Una solicitud de Janitor AI puede contener más que solo tu último mensaje. La información del personaje, tu Persona, el historial del chat, la Memoria y un prompt adicional pueden formar parte del contexto enviado al modelo.
Esto significa que dos mensajes de longitud similar no necesariamente cuestan lo mismo. Una respuesta generada al principio de un chat suele llevar menos contexto que una generada después de una larga conversación.
Paso 4: Ingresa la URL del proxy, la clave API y el modelo de GPT Proto
Ingresa los siguientes valores:
| Campo de Janitor AI |
Valor |
| Nombre |
GPT Proto |
| URL del proxy |
https://gptproto.com/v1/chat/completions |
| Clave API |
Tu clave API de GPT Proto |
| Modelo |
deepseek-flash |
| Prompt personalizado |
Opcional; déjalo en blanco durante la primera prueba |
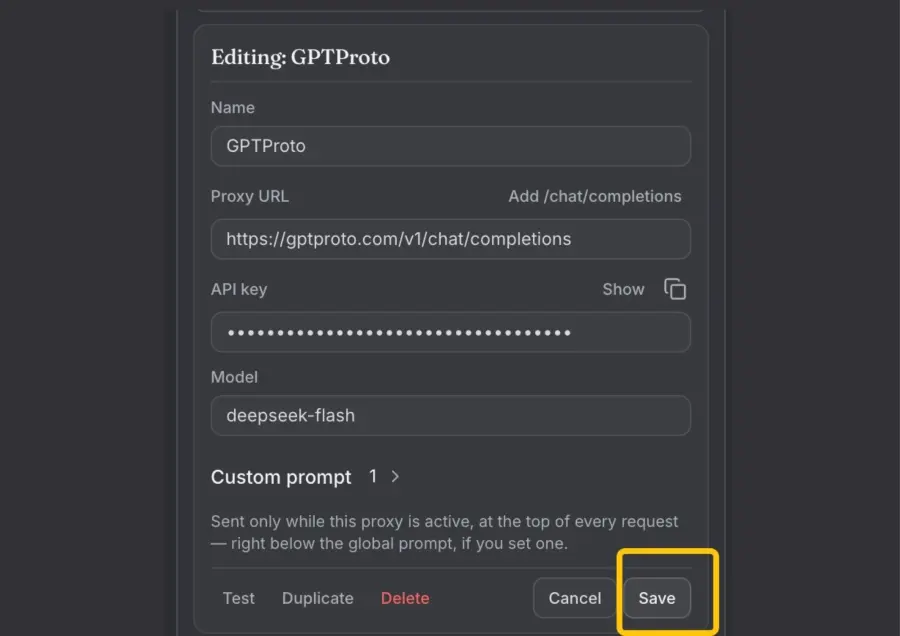
El detalle más importante es la URL del proxy.
Algunos clientes compatibles con OpenAI solicitan una URL base como:
https://gptproto.com/v1
El campo de URL del proxy de Janitor AI necesita la dirección completa de la solicitud de Chat Completions:
https://gptproto.com/v1/chat/completions
GPT Proto utiliza ese endpoint completo en su guía de inicio rápido de la API. Ingresar solo /v1 puede enviar la solicitud a la ruta incorrecta y producir un error de "No encontrado" o de conexión.
El campo del modelo es igual de estricto. Esta prueba utiliza deepseek-flash, que es la cadena de modelo actual de GPT Proto para DeepSeek Flash. Es un ejemplo, no el único modelo que Janitor AI puede usar.
No adivines una cadena de modelo basándote en el nombre público del modelo. Copia el identificador que se muestra en la página del modelo de GPT Proto correspondiente o en el panel de control actual.
Paso 5: Guardar, actualizar y enviar un mensaje real
Haz clic en Guardar después de completar los campos.
Si Janitor AI informa inmediatamente un error de red o de obtención (fetch error), no elimines la configuración todavía. Sigue este orden:
Guarda la configuración.
Actualiza toda la página del navegador de Janitor AI.
Vuelve a abrir el chat si es necesario.
Confirma que Proxy siga siendo el proveedor activo.
Envía un mensaje corto como Hola.
Comprueba si el personaje responde.
Qué sucedió en mi prueba: Janitor AI mostró inicialmente un error de red o de obtención a pesar de que la URL, la clave API y la cadena del modelo eran correctas. Guardé la configuración, actualicé la página completa del navegador y envié un mensaje de chat real. La misma configuración funcionó después de la actualización.
Esta no es una solución garantizada para todos los errores de red. Es una verificación inicial de bajo costo antes de empezar a cambiar credenciales que, por lo demás, son válidas.
Una discusión en la comunidad de Janitor AI describe la misma solución de guardar y recargar, pero debe tratarse como una solución de problemas reportada por los usuarios en lugar de una regla oficial. reddit.com
¿Por qué Janitor AI muestra “Failed to Fetch” o “Network Error”?
Un error de fetch (obtención) no demuestra que tu clave de API de GPT Proto sea inválida.
El mensaje describe el resultado visible —el navegador no recibió la respuesta que esperaba—, pero no identifica una causa definitiva. El fallo puede ocurrir en la configuración guardada de Janitor AI, la solicitud del navegador, la URL del proxy, el paso de autenticación, el modelo seleccionado o la solicitud de API ascendente.
Comienza con la posibilidad más sencilla: es posible que Janitor AI no haya aplicado completamente la configuración recién guardada a la página de chat actual. Guarda, actualiza y prueba con un mensaje real.
Si eso no funciona, verifica lo siguiente:
La URL del proxy incluye /v1/chat/completions.
La clave de API se copió completamente.
La clave no contiene comillas ni espacios adicionales.
La cadena del modelo coincide exactamente con GPT Proto.
Tu cuenta de GPT Proto tiene saldo disponible.
El modelo seleccionado está disponible actualmente.
Una extensión del navegador o configuración de privacidad no está bloqueando la solicitud.
La conversación no está enviando un contexto inusualmente grande.
No crees repetidamente nuevas claves de API hasta que hayas verificado la URL y la cadena del modelo. Reemplazar una clave válida no solucionará una solicitud enviada al endpoint incorrecto.
¿Por qué mi proxy de Janitor AI no funciona?
Es posible que tu proxy de Janitor AI no funcione porque no se han cargado los ajustes guardados, la URL del proxy o el ID del modelo son incorrectos, la clave de API es inválida o tu cuenta tiene saldo insuficiente. Las restricciones del navegador, las interrupciones temporales del servicio y un contexto de conversación demasiado grande también pueden causar fallos.
Primero, guarda tus ajustes, actualiza toda la página, confirma que el Proxy esté seleccionado y envía un mensaje corto en un chat nuevo. Actualizar puede ayudar a aplicar los ajustes guardados, pero no resolverá todos los errores.
Si el problema continúa, compara el mensaje de error con la tabla a continuación para decidir qué verificar después.
| Lo que ves |
Qué verificar primero |
Primera acción |
| Failed to Fetch o Network Error |
Estado de la página guardada, endpoint y bloqueo del navegador |
Guarda, actualiza la página completa y envía un mensaje real |
| 401 Unauthorized |
Clave de API |
Vuelve a copiar la clave sin espacios, comillas o Bearer |
| 404 o Not Found |
URL del proxy |
Usa la dirección completa /v1/chat/completions |
| Model not found |
Cadena del modelo |
Copia el identificador actual exacto de GPT Proto |
| La conexión tiene éxito pero no aparece respuesta |
Saldo, estado del modelo y tamaño de la solicitud |
Prueba un mensaje corto en un chat nuevo |
| Las respuestas fallan más adelante en una conversación larga |
Contexto creciente o límites de salida |
Inicia un chat nuevo o reduce el contexto retenido |
| Un navegador funciona pero otro falla |
Extensiones, estado de caché o controles de privacidad |
Prueba en una ventana privada u otro navegador |
Failed to Fetch o Network Error
Guarda la configuración y recarga toda la página primero. Luego envía un mensaje real en lugar de confiar solo en la prueba de configuración inicial.
Si el mensaje sigue apareciendo, copia el endpoint de nuevo y prueba sin bloqueadores de contenido. Los problemas temporales de disponibilidad en cualquiera de los servicios pueden producir un síntoma similar, así que evita asumir que una plataforma es definitivamente la culpable basándote solo en este mensaje.
401 No autorizado
Una respuesta 401 normalmente indica un problema de autenticación.
Asegúrate de que el campo de la clave API contenga únicamente la clave de GPT Proto. Elimina Bearer, comillas, saltos de línea y espacios accidentales. Si la misma clave también falla en una solicitud API directa, crea una clave de reemplazo desde tu panel de control de GPT Proto.
404 o No encontrado
Una respuesta 404 generalmente significa que la solicitud llegó a un servidor, pero utilizó una ruta no disponible.
Para esta configuración, utiliza:
https://gptproto.com/v1/chat/completions
No te detengas en:
https://gptproto.com/v1
El segundo valor es una URL base utilizada por algunos clientes, no el endpoint completo requerido en este campo de Janitor AI.
Modelo no encontrado
El nombre visible del modelo y su identificador de API no siempre son idénticos.
Para el modelo utilizado en esta prueba, el valor correcto es:
deepseek-flash
Las mayúsculas, espacios, números de versión y puntuación son importantes. Si cambias de modelo, copia el nuevo identificador desde GPT Proto en lugar de editar la cadena antigua manualmente.
La conexión funciona pero el personaje no responde
Primero, intenta iniciar una nueva conversación con un mensaje corto.
Si la prueba corta funciona, es posible que el chat anterior haya acumulado un contexto más grande a través de la definición del personaje, la Persona, la Memoria y el historial de la conversación. Si la prueba corta también falla, verifica el estado actual del modelo y tu saldo en GPT Proto.
Opcional: Prueba GPT Proto antes de culpar a Janitor AI
Una solicitud API directa ayuda a separar un problema de configuración de Janitor AI de un problema de credenciales o de modelo de GPT Proto.
Reemplaza YOUR_GPTPROTO_API_KEY con tu clave privada y ejecuta:
curl --request POST "https://gptproto.com/v1/chat/completions" \
  --header "Authorization: Bearer YOUR_GPTPROTO_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "deepseek-flash",
    "messages": [
      {
        "role": "user",
        "content": "Reply with: API connection works."
      }
    ]
  }'
Esta solicitud sigue el formato actual de Chat Completions que se muestra en la página de la API de DeepSeek Flash.
Interpreta el resultado de esta manera:
Si la solicitud cURL funciona pero Janitor AI falla, concéntrate en los campos de Janitor AI, el estado guardado de la página o el navegador.
Si ambos devuelven un error de autenticación, verifica la clave API.
Si ambos devuelven un error de modelo, verifica la cadena del modelo.
Si la API informa saldo insuficiente, añade saldo antes de volver a probar Janitor AI.
Si la API tiene éxito pero una conversación larga en Janitor AI falla, prueba un chat nuevo con menos contexto.
No publiques el comando cURL completo en un hilo de soporte público después de insertar tu clave real.
¿Puedes usar otros modelos de GPT Proto con Janitor AI?
Sí. deepseek-flash es el modelo utilizado en este tutorial, no un requisito de Janitor AI.
Para cambiar de modelo, reemplaza el valor de Modelo con otro identificador de modelo de texto compatible actualmente con GPT Proto. En la mayoría de los casos, los siguientes valores pueden permanecer sin cambios:
Solo es necesario cambiar el campo Modelo.
Vuelve a probar la configuración después de realizar el cambio, ya que los modelos pueden diferir en estilo de respuesta, manejo de contexto, tiempo de respuesta, disponibilidad y costo. Un modelo que funciona bien para programación o análisis de documentos no es automáticamente la mejor opción para el diálogo de personajes.
Si la prioridad es el comportamiento de juego de rol, compara las ventajas y desventajas en Las mejores API de LLM sin censura para juegos de rol. Aquí, “sin censura” se refiere al control de la API y al comportamiento del modelo dentro del uso legal, no al permiso para ignorar los términos de un proveedor o las reglas aplicables.
¿Cuánto cuesta una conversación en Janitor AI?
No existe un precio fijo único por mensaje en Janitor AI cuando utilizas una API externa.
GPT Proto cobra por el modelo seleccionado según los tokens procesados. La solicitud puede incluir:
Por lo tanto, una conversación más larga puede costar más por respuesta que un chat nuevo, incluso cuando tu último mensaje contenga la misma cantidad de palabras.
Consulta la tarifa actual del modelo en Precios de GPT Proto o en su página de modelo individual. Comienza con una conversación corta, observa el uso real y luego decide si el modelo se ajusta a la duración de chat y al presupuesto que esperas.
Usar Janitor AI frente a crear tu propia aplicación de juegos de rol
Conectar un proxy es adecuado cuando deseas seguir usando la interfaz de chat y personajes existente de Janitor AI. No te otorga control sobre el frontend, el sistema de cuentas o la disponibilidad de la plataforma de Janitor AI.
| Tu objetivo |
Mejor siguiente paso |
| Chatear con personajes existentes de Janitor AI |
Conectar GPT Proto a través del proveedor de Proxy |
| Comparar modelos adecuados para el diálogo de personajes |
Leer la comparación de modelos de juego de rol |
| Controlar tu propia interfaz, memoria y moderación |
Crear una aplicación de juego de rol independiente |
| Crear lógica de personajes reutilizable para tu producto |
Diseñar tu propio sistema de personajes con una API |
Si necesitas control a nivel de producto, mira cómo crear una aplicación de juego de rol con una API de IA. Para definiciones de personajes, diseño de memoria y lógica de aplicación, continúa con Cómo crear tu propio personaje de IA con una API.
Estos son casos de uso diferentes. Conectar GPT Proto a Janitor AI te permite proporcionar el modelo detrás de una interfaz existente. Crear tu propia aplicación te da más control, pero también debes gestionar la interfaz, el almacenamiento, las reglas de seguridad, las cuentas de usuario y los costos operativos por tu cuenta.
Lista de verificación de configuración final
Antes de contactar al soporte técnico o reemplazar tu clave de API, verifica estos cuatro valores:
Proveedor: Proxy
URL del proxy: https://gptproto.com/v1/chat/completions
Clave de API: Tu clave privada de GPT Proto, sin Bearer
Modelo: Una cadena de modelo de GPT Proto actual y exacta, como deepseek-flash
Luego sigue este orden:
Guarda la configuración.
Actualiza toda la página.
Confirma que el Proxy siga seleccionado.
Envía un mensaje corto.
Si falla, verifica la URL, la clave de API, la cadena del modelo, el saldo y el navegador, en ese orden.
Una vez que la conexión funcione, Janitor AI puede seguir siendo tu interfaz de chat mientras GPT Proto proporciona el modelo seleccionado. Si necesitas control sobre la memoria de los personajes, el enrutamiento de modelos o la interfaz del producto en sí, el siguiente paso es crear tu propia aplicación de juego de rol con una API de IA.