Resumen de LLM asequibles para programación
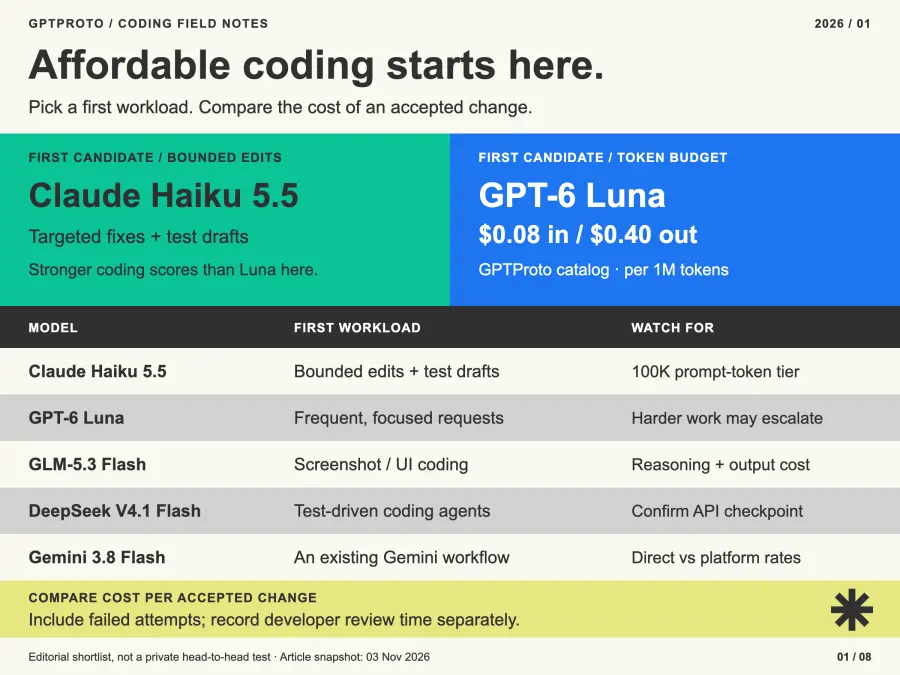
| Modelo |
Primera carga de trabajo a evaluar |
Principal compromiso |
| Claude Haiku 5.5 |
Ediciones de código delimitadas, borradores de pruebas y subtareas de programación |
Su nivel de precio bajo termina por encima de los 100 mil tokens de prompt |
| GPT-6 Luna |
Solicitudes de programación frecuentes y de alcance limitado |
El trabajo de repositorio más complejo puede requerir escalamiento |
| GLM-5.3 Flash |
Tareas de programación que involucran capturas de pantalla o referencias de IU |
El esfuerzo de razonamiento y la longitud de salida afectan la factura |
| DeepSeek V4.1 Flash |
Agentes de programación con pruebas y límites de reintento |
Confirma el punto de control servido por el alias de la API |
| Gemini 3.8 Flash |
Programación dentro de un flujo de trabajo de Gemini existente |
Las tarifas promocionales del proveedor directo difieren de las cotizaciones de la plataforma |
Si también estás eligiendo el proveedor además del modelo, nuestra comparativa de plataformas de API de IA para desarrolladores cubre las preguntas más amplias sobre acceso, facturación, integración y controles de producción.
Cómo comparamos el costo y la capacidad de programación
Un modelo de programación LLM asequible necesita suficiente capacidad para la tarea antes de que su precio por token sea útil. Priorizamos la evidencia específica de programación, luego verificamos el costo de la carga de trabajo, los niveles de contexto, la compatibilidad de herramientas y una página de modelo de GPT Proto disponible.
Los siguientes resultados provienen de Artificial Analysis. Terminal-Bench 4.0 evalúa la programación con agentes y el uso de terminal; FrontierCode 2.0 evalúa la ingeniería de software en repositorios de código abierto. Las diferentes configuraciones pueden cambiar los resultados, por lo que el entorno evaluado se mantiene junto a cada modelo.
| Modelo evaluado |
Terminal-Bench 4.0 |
FrontierCode 2.0 |
| Claude Haiku 5.5 Max |
33% |
35% |
| GPT-6 Luna Max |
13% |
25% |
| GLM-5.3 Flash según se indica |
33% |
18% |
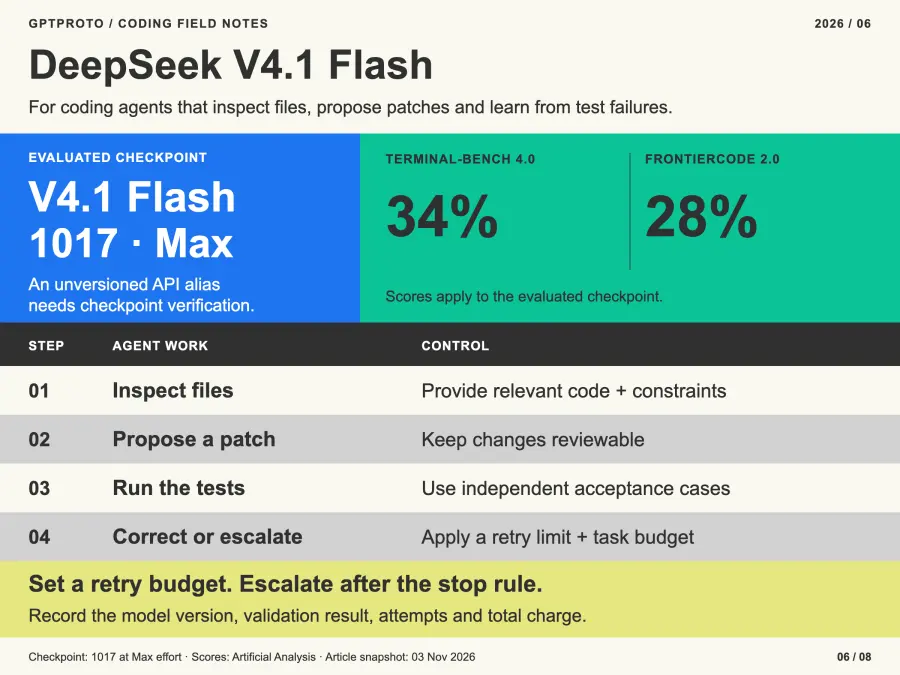
| DeepSeek V4.1 Flash 1017 Max |
34% |
28% |
| Gemini 3.8 Flash High |
20% |
19% |
Las comparaciones subyacentes son Haiku frente a Luna, DeepSeek frente a GLM Flash y Haiku frente a Gemini. Estos porcentajes describen esas evaluaciones, no la tasa de éxito esperada de tu repositorio. Tampoco establecen la latencia o el tiempo de actividad de GPT Proto.
Las estimaciones de precios a continuación mantienen constante el uso de tokens para exponer la aritmética de facturación. Los modelos reales pueden usar diferentes conteos de tokens para el mismo prompt, especialmente cuando el razonamiento está habilitado.
Los 5 mejores LLM asequibles para programación
1. Claude Haiku 5.5 para tareas de programación acotadas
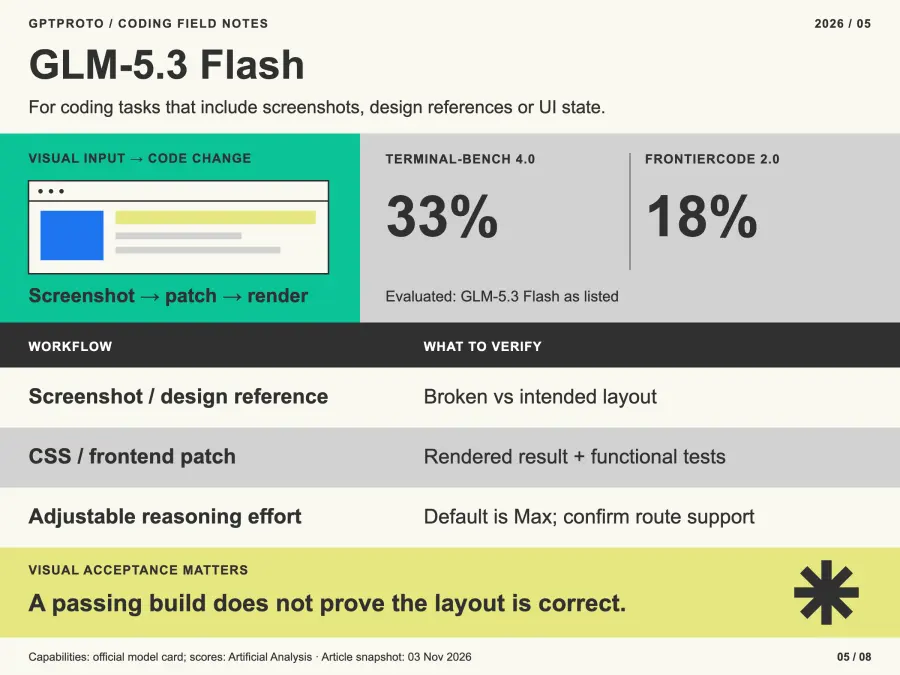
Claude Haiku 5.5 es nuestro primer candidato para una edición dirigida con una prueba de aceptación clara y un prompt de menos de 100K tokens. Sus resultados de programación hacen que valga la pena evaluarlo antes de pagar por un modelo Claude más grande.
El anuncio de lanzamiento de Anthropic posiciona a Haiku como un modelo para trabajo repetitivo y subtareas de programación junto a Sonnet y Opus. Eso sugiere un alcance inicial práctico: corregir una función, redactar una prueba o investigar un error contenido.
El límite de costo importante es la longitud del prompt. Las tarifas de entrada/salida aumentan de $0.10/$0.50 a $0.50/$2.50 por millón de tokens por encima de los 100K tokens de prompt. Una ventana de contexto grande no hace que el nivel más económico esté disponible en toda esa ventana.
2. GPT-6 Luna para solicitudes frecuentes y enfocadas
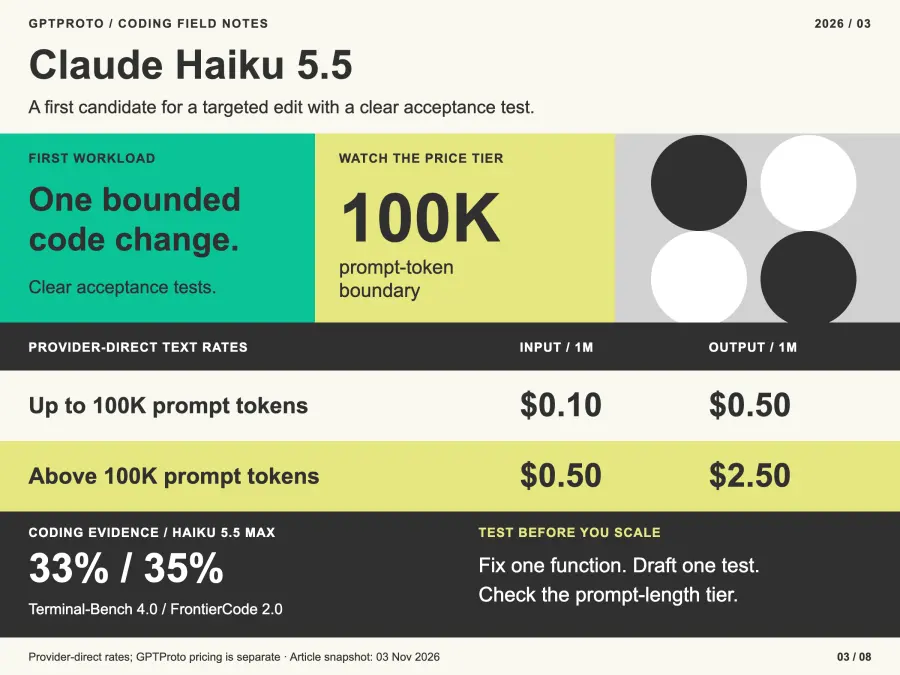
GPT-6 Luna es el candidato que prioriza el presupuesto para solicitudes repetidas y limitadas: explicar una función, redactar código repetitivo (boilerplate) o sugerir una pequeña corrección que las pruebas existentes puedan evaluar.
Su tarifa de catálogo de GPT Proto publicada es de $0.08 de entrada y $0.40 de salida por millón de tokens. Las puntuaciones públicas de programación son más bajas que las de Haiku, por lo que haríamos que Luna se ganara un rol más amplio mediante una evaluación específica de la tarea.
Verifica la superficie de integración al construir un agente. La documentación del modelo de OpenAI especifica el uso de herramientas habilitado para razonamiento a través de Respuestas; Chat Completions permite la llamada a funciones con el esfuerzo de razonamiento establecido en ninguno. Confirma qué expone la ruta de GPT Proto antes de tratar el cambio de modelo como un cambio solo de configuración.
3. GLM-5.3 Flash para programación visual económica
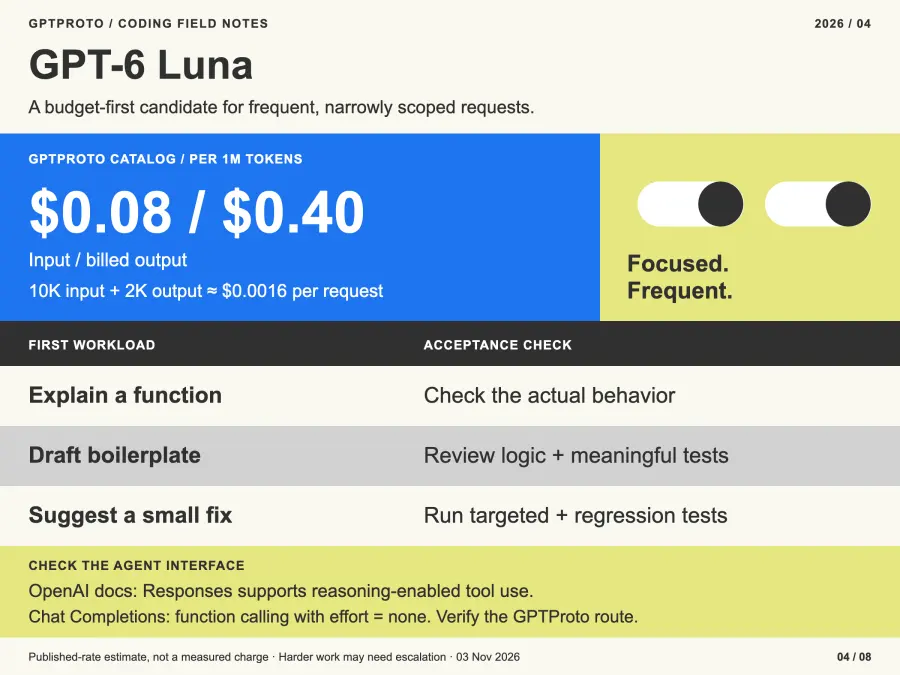
GLM-5.3 Flash pertenece a la lista de candidatos cuando una tarea de programación incluye una captura de pantalla, una referencia de diseño o una interfaz renderizada. Por ejemplo, un asistente de frontend puede necesitar comparar un diseño roto con el estado deseado antes de proponer cambios en CSS.
La tarjeta oficial del modelo GLM-5.3 Flash documenta la entrada multimodal, los pesos abiertos y el esfuerzo de razonamiento ajustable. Su esfuerzo predeterminado publicado es el máximo. Usa otra configuración solo después de verificar cómo la ruta alojada la admite.
Sus dos puntuaciones de programación difieren sustancialmente. Esa es una razón para probar tu combinación de tareas en lugar de tratar un benchmark terminal como una clasificación universal de edición de código. Las correcciones visuales también necesitan una comparación renderizada; la compilación por sí sola no puede establecer que el diseño sea correcto.
4. DeepSeek V4.1 Flash para agentes de programación basados en pruebas
DeepSeek Flash vale la pena evaluarlo para agentes que inspeccionan archivos, proponen cambios, reciben fallos en las pruebas y lo intentan de nuevo dentro de un presupuesto definido.
El anuncio de lanzamiento del 17 de octubre describe mejoras en el rendimiento de programación, la velocidad de finalización de tareas y la longitud de salida. Los resultados independientes en nuestra tabla se refieren específicamente a V4.1 Flash 1017 con esfuerzo máximo. Un alias sin versión no prueba, por sí solo, que tu plataforma utilice ese punto de control; registra la versión resuelta cuando esté disponible.
Para una visión más amplia de DeepSeek, GLM, Qwen y Kimi, consulta nuestra comparativa de LLM chinos para programación. Mantén disponibles a los candidatos más fuertes cuando un cambio difícil en el repositorio agote la ruta económica.
5. Gemini 3.8 Flash para flujos de trabajo existentes de Gemini
Gemini 3.8 Flash es un candidato cuando tu aplicación ya utiliza Gemini o combina código con material visual. Evalúalo en ese flujo de trabajo existente antes de añadir otra integración específica de un proveedor.
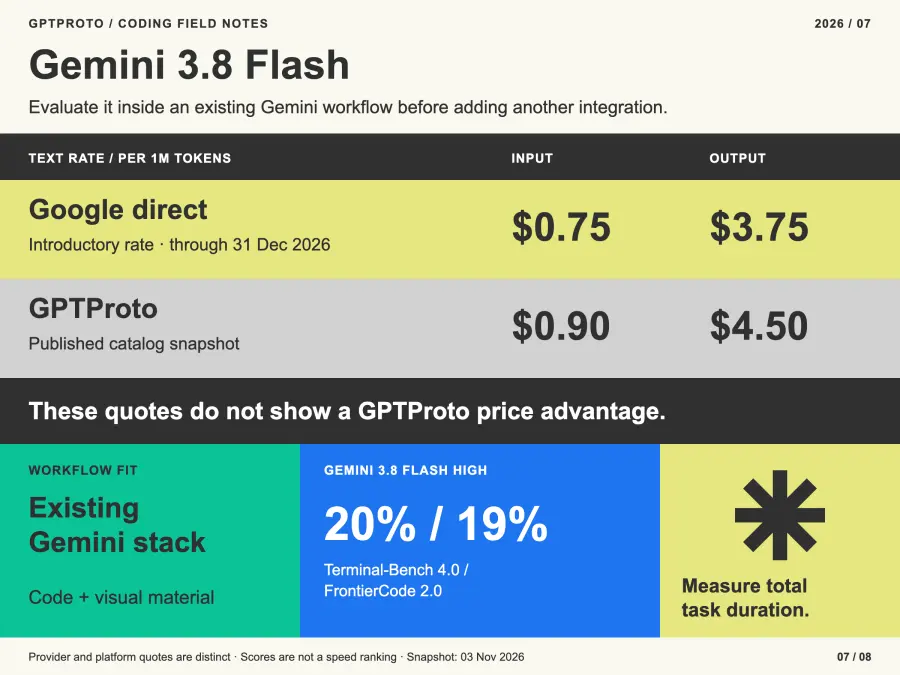
La actualización del modelo de Google documenta el pensamiento ajustable y una tarifa introductoria de proveedor directo de $0.75 por entrada/$3.75 por salida por millón de tokens hasta el 31 de diciembre de 2026. La instantánea del catálogo de GPT Proto publicada es de $0.90/$4.50. Esas cifras no respaldan la afirmación de que GPT Proto sea más barato que la promoción actual de Google.
Incluiríamos a Gemini por su ajuste al flujo de trabajo, no por otorgarle un título de velocidad por la palabra Flash. Mide el tiempo hasta obtener una respuesta útil y la duración total de la tarea en tus prompts.
Comparativa de precios de API de LLM para programación
Esta tabla utiliza tarifas de texto públicas directas del proveedor bajo las condiciones establecidas, no las tarifas de facturación de GPT Proto. Mantener la fuente y la carga de trabajo explícitas hace que la comparación sea reproducible.
La solicitud pequeña contiene 10K tokens de entrada y 2K tokens de salida facturados. La línea base del repositorio contiene 200K tokens de entrada y 20K tokens de salida facturados. Ambos asumen que no hay aciertos de caché; la salida facturada debe incluir tokens de razonamiento cuando corresponda.
| Modelo y condición de precio |
Entrada / salida por 1M de tokens |
Solicitud pequeña |
Línea base del repositorio |
| Haiku 5.5 hasta 100K tokens de prompt |
$0.10 / $0.50 |
$0.0020 |
Usar el siguiente nivel |
| Haiku 5.5 por encima de 100K tokens de prompt |
$0.50 / $2.50 |
No aplica |
$0.1500 |
| GPT-6 Luna dentro de su nivel de contexto base |
$0.10 / $0.50 |
$0.0020 |
$0.0300 |
| GLM-5.3 Flash a la tarifa estándar publicada |
$0.15 / $0.50 |
$0.0025 |
$0.0400 |
| DeepSeek Flash a la tarifa máxima original |
$0.30 / $1.20 |
$0.0054 |
$0.0840 |
| Gemini 3.8 Flash a la tarifa directa de introducción |
$0.75 / $3.75 |
$0.0150 |
$0.2250 |
La evidencia de las tarifas proviene de la documentación del modelo enlazada y de las comparaciones independientes anteriores. Las notas de lanzamiento de DeepSeek confirman que las tarifas de tokens fuera de las horas pico son la mitad de las tarifas pico. Luna aplica tarifas más altas a la solicitud completa por encima de 272K tokens de entrada. Las tarifas de introducción de Gemini terminan en 2026. Verifica la ruta y la fecha aplicables antes de presupuestar.
Para acceder a GPT Proto, utiliza el panel de precios en vivo en las páginas de los modelos enlazados. Dos ejemplos claros del catálogo son Luna a $0.08/$0.40 y Haiku a $0.09/$0.45 en el nivel de precio bajo. La misma solicitud pequeña se estima en $0.0016 y $0.0018 respectivamente. Estos son cálculos basados en tarifas publicadas, no cargos medidos.
Para una aplicación pequeña que realiza 10,000 solicitudes pequeñas al mes, el ejemplo de Luna o Haiku de nivel bajo suma un total de $20 antes de reintentos y otros cargos. Esa estimación deja de ser útil si la aplicación envía una cantidad diferente de contexto o genera salidas mucho más largas.
El almacenamiento en caché necesita su propio cálculo: suma la entrada sin caché, las lecturas de caché, cualquier escritura o almacenamiento en caché y la salida facturada. Un prefijo de repositorio estable puede ayudar, pero cambiar el prompt o perder el caché cambia los ahorros.
La prueba de Haiku 5.5 del desarrollador Simon Willison proporciona un ejemplo concreto de cómo diferentes configuraciones de esfuerzo cambian el tiempo y el costo. También analiza los cambios en el tokenizador. La lección para presupuestar es medir el uso real en lugar de asumir que cada modelo factura la misma cantidad de tokens para un texto idéntico.
Qué modelo se adapta a tu tarea de programación
| Tarea |
Candidatos iniciales |
Verificación de aceptación |
| Una edición de código o corrección de errores contenida |
Haiku 5.5 y Luna |
Pruebas dirigidas más pruebas de regresión existentes |
| Redacción de pruebas unitarias o código repetitivo (boilerplate) |
Luna y Haiku 5.5 |
Revisar aserciones y verificar casos de falla significativos |
| Una corrección visual de frontend |
GLM-5.3 Flash y Gemini 3.8 Flash |
Comparación renderizada más pruebas funcionales |
| Un agente de programación de varios pasos |
DeepSeek Flash y Haiku 5.5 |
Tarea completada, llamadas a herramientas válidas, conteo de reintentos y costo total |
Estos son puntos de partida para la evaluación. Una prueba generada que simplemente repite la suposición errónea del modelo puede aprobarse mientras la función sigue siendo incorrecta. Conserva casos de aceptación independientes e inspecciona los cambios en las pruebas mismas.
Para agentes que también buscan documentos, clasifican solicitudes o realizan tareas de soporte, nuestra guía de API de LLM asequibles para agentes de IA cubre la combinación de cargas de trabajo más amplia.
Cuándo vale la pena un modelo de programación premium
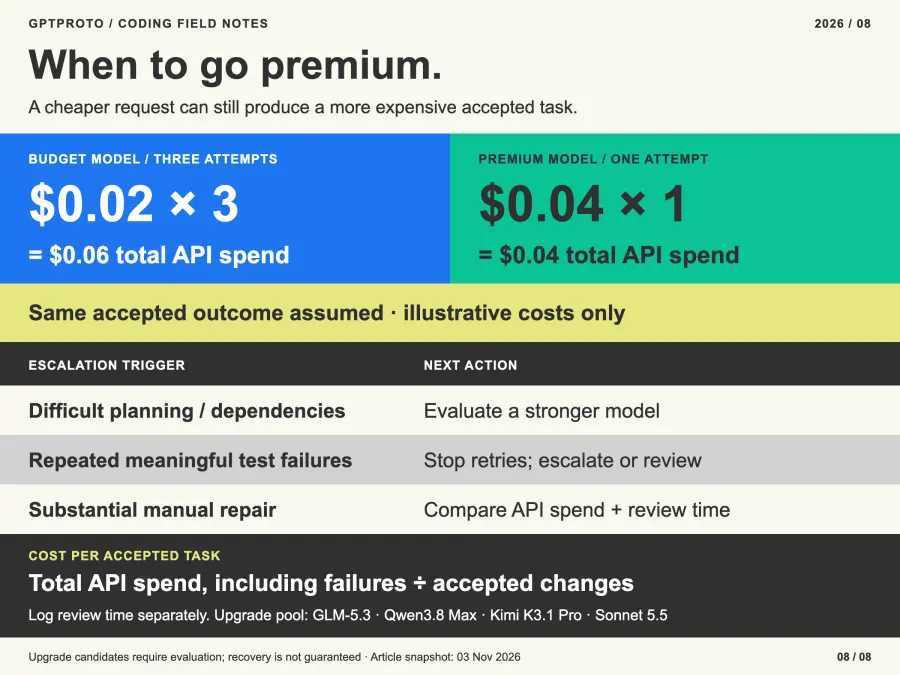
Escala cuando la tarea requiera una planificación difícil, falle repetidamente en pruebas significativas o requiera una reparación manual sustancial. GLM-5.3, Qwen3.8 Max, Kimi K3.1 Pro y Claude Sonnet 5.5 pueden formar un grupo de evaluación separado para ese trabajo. Su inclusión aquí es una ruta de actualización a investigar, no una afirmación de que siempre recuperan las tareas fallidas de los modelos económicos.
Usa el costo por tarea aceptada: gasto total de API en la evaluación dividido por el número de cambios aceptados. Incluye el gasto en intentos fallidos. Registra el tiempo de revisión por separado para que una factura de API baja no oculte una limpieza costosa por parte del desarrollador.
Para una comparación ilustrativa, tres intentos de $0.02 cuestan $0.06. Un intento de $0.04 que termina la misma tarea de inmediato cuesta menos en general. Tus tasas de éxito medidas deciden si esa compensación es válida.
Cómo usar modelos económicos sin reintentos interminables
Establece la verificación de aceptación y la regla de detención antes de la primera solicitud. Una política inicial práctica es un intento inicial, una corrección usando la falla de la prueba, luego la escalada o la revisión humana. Ajusta esa política usando los resultados observados y un presupuesto de tareas.
La aplicación debe registrar el modelo y el punto de control, la configuración de razonamiento, el uso de tokens, el tiempo transcurrido, el resultado de la validación y el cargo total. El modelo propone un parche; tu ejecutor realiza las pruebas; tu lógica de enrutamiento decide qué sucede después.
Una API de múltiples modelos simplifica el acceso y la facturación. Las pruebas de aprobación, el enrutamiento consciente del presupuesto y la escalada automática aún requieren funciones de plataforma verificadas o lógica de aplicación. Nuestra guía de puertas de enlace de IA para desarrolladores compara las diferentes capas de acceso y control.
Prueba un modelo de programación asequible a través de GPT Proto
Abre la página de un modelo preseleccionado, elige Probar este modelo y revisa la Guía de inicio rápido y los precios actuales. Prepara una clave API y saldo. Si el panel ofrece Copiar Markdown para IA, pásale esa guía a tu asistente de programación junto con la tarea y los criterios de aceptación. Mantén la clave real en tu entorno local o en el almacén de secretos de tu servidor.
Para un primer ejercicio reproducible, corrige esta función de paginación: las páginas comienzan en uno, page y per_page son números enteros, los valores menores a uno deben generar un ValueError, y la lista de entrada debe permanecer sin cambios.
Guarda lo siguiente como request_patch.py en una nueva carpeta de trabajo. Utiliza la biblioteca estándar de Python, solicita una función candidata, verifica su sintaxis y la guarda para su revisión. No ejecuta el código devuelto.
import ast
import json
import os
import time
from pathlib import Path
from urllib.error import HTTPError, URLError
from urllib.request import Request, urlopen

key = os.environ.get("GPTPROTO_API_KEY")
if not key:
    raise SystemExit("Configura GPTPROTO_API_KEY en tu entorno.")

source = """def paginate(items, page, per_page):
    start = page * per_page
    return items[start:start + per_page]
"""
task = (
    "Corrige paginate. Las páginas comienzan en uno. page y per_page son "
    "enteros; genera un ValueError si alguno es menor a 1. Devuelve una "
    "lista vacía después de la última página. No modifiques items. Mantén "
    "la firma. Devuelve solo la función, sin Markdown "
    "ni explicaciones.\n\n" + source
)
payload = {
    "model": os.environ.get("GPTPROTO_MODEL", "gpt-6-luna"),
    "messages": [{"role": "user", "content": task}],
}
request = Request(
    "https://gptproto.com/v1/chat/completions",
    data=json.dumps(payload).encode("utf-8"),
    headers={
        "Authorization": f"Bearer {key}",
        "Content-Type": "application/json",
    },
    method="POST",
)
started = time.perf_counter()
try:
    with urlopen(request, timeout=60) as response:
        result = json.load(response)
except HTTPError as exc:
    raise SystemExit(f"La API devolvió HTTP {exc.code}.") from exc
except (URLError, TimeoutError) as exc:
    raise SystemExit("La solicitud falló o excedió el tiempo de espera.") from exc

try:
    code = result["choices"][0]["message"]["content"]
except (KeyError, IndexError, TypeError) as exc:
    raise SystemExit("No hay texto candidato en la respuesta de la API.") from exc
if not isinstance(code, str) or not code.strip():
    raise SystemExit("La respuesta no contenía código Python.")
code = code.strip()
try:
    ast.parse(code)
except SyntaxError as exc:
    raise SystemExit("Revisa la respuesta; no es Python simple.") from exc

Path("candidate.py").write_text(code + "\n", encoding="utf-8")
print("candidate.py guardado. Revísalo antes de ejecutar las pruebas.")
print("Segundos:", round(time.perf_counter() - started, 2))
print("Uso:", json.dumps(result.get("usage", {})))
Guarda estas comprobaciones de aceptación como test_candidate.py:
import unittest
from candidate import paginate


class PaginationTests(unittest.TestCase):
    def test_pages(self):
        items = [0, 1, 2, 3, 4]
        self.assertEqual(paginate(items, 1, 2), [0, 1])
        self.assertEqual(paginate(items, 2, 2), [2, 3])
        self.assertEqual(paginate(items, 3, 2), [4])
        self.assertEqual(paginate(items, 4, 2), [])
        self.assertEqual(items, [0, 1, 2, 3, 4])

    def test_empty_input(self):
        self.assertEqual(paginate([], 1, 2), [])

    def test_invalid_values(self):
        for page, per_page in [(0, 2), (-1, 2), (1, 0), (1, -1)]:
            with self.subTest(page=page, per_page=per_page):
                with self.assertRaises(ValueError):
                    paginate([0, 1], page, per_page)


if __name__ == "__main__":
    unittest.main()
Con la clave de entorno configurada, ejecuta python request_patch.py. Revisa candidate.py y luego ejecuta python -m unittest -v test_candidate.py. Una verificación de sintaxis solo establece que Python puede analizar el resultado; las pruebas evalúan el comportamiento declarado. Este pequeño ejercicio no es un benchmark a escala de repositorio.
Repite con otro ID de modelo documentado a través de GPTPROTO_MODEL. Registra tanto los fallos como los aciertos, y utiliza el uso devuelto junto con la tarifa de facturación aplicable para comparar los costos. Un tiempo de espera agotado o un intento fallido también deben formar parte del registro de evaluación.
Elige una tarea específica, mantén sus comprobaciones de aceptación fijas y compara dos candidatos. Abre la página de la API de Claude Haiku 5.5 o la página de la API de GPT-6 Luna para revisar los precios actuales y comenzar tu primera solicitud de programación.