GPT-6 Astra vs Claude Fable 5.1 : Verdict rapide
| Décision |
Meilleur choix |
Pourquoi |
| Agents de codage qui modifient, testent et déboguent |
GPT-6 Astra |
Résultats plus solides en terminal et automatisation ; coût indépendant par tâche plus faible |
| Raisonnement scientifique approfondi ou travail de connaissance |
Claude Fable 5.1 |
Mène SciCode, HLE, AA-Briefcase et GDPval-AA v2 dans la comparaison indépendante actuelle |
| Agents navigateur et d'utilisation d'ordinateur |
GPT-6 Astra |
Conçu autour de l'utilisation d'ordinateur, des outils asynchrones et du pilotage en cours de tour |
| Première ébauche frontend sensible au design |
Claude Fable 5.1, de justesse |
Les tests communautaires préfèrent souvent ses détails d'interaction et la lisibilité de son code ; il n'existe pas de benchmark frontend définitif |
| Implémentation frontend plus QA navigateur |
GPT-6 Astra |
Meilleur choix lorsque l'agent doit implémenter, rendre, inspecter, tester et réparer |
| Agent de longue durée à fort cache |
Claude Fable 5.1 |
Les lectures de cache officielles coûtent 0,25 $ par million de tokens contre 1,00 $ pour Astra |
| Prix standard GPT Proto le plus bas par token |
GPT-6 Astra |
Les tarifs actuels sont de 8 $ en entrée et 40 $ en sortie par million de tokens |
| Coût mesuré le plus bas par tâche de benchmark indépendante |
GPT-6 Astra |
3,26 $ contre 7,63 $ dans la comparaison actuelle Artificial Analysis à effort maximal |
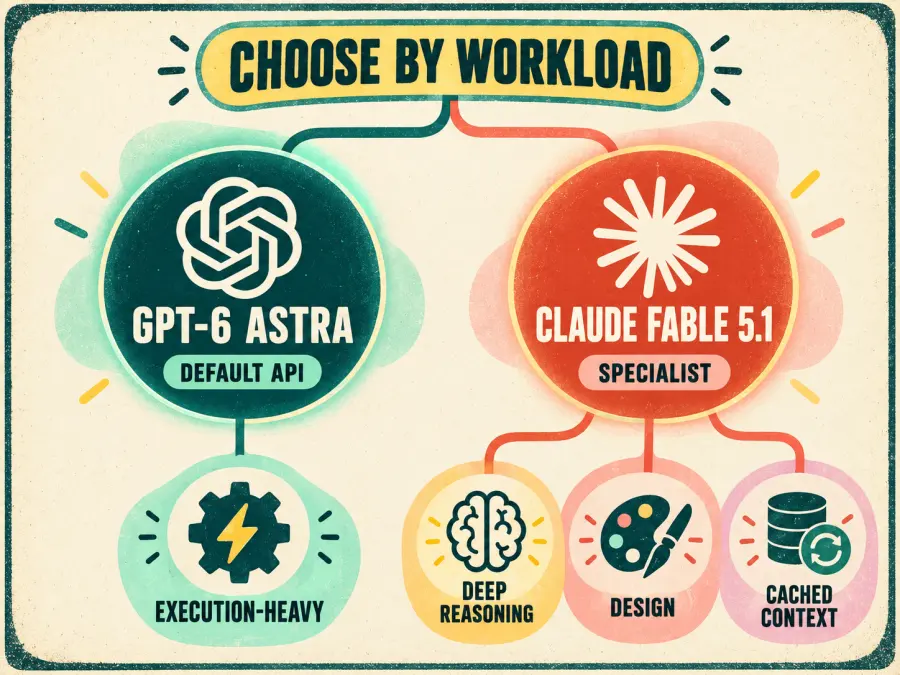
Si vous devez choisir une API par défaut, commencez par Astra pour le travail orienté action et gardez Fable 5.1 comme voie d'escalade pour le raisonnement difficile, le code scientifique ou le jugement de design. Si la charge de travail comporte un long préfixe de prompt stable, testez Fable avant de décider : l'économie du cache peut inverser l'avantage de prix apparent.
Spécifications et différences pour les développeurs
| Spécification |
GPT-6 Astra |
Claude Fable 5.1 |
| Fournisseur |
OpenAI |
Anthropic |
| ID du modèle API |
gpt-6-astra |
claude-fable-5-1 |
| Date de sortie |
3 septembre 2026 |
1er septembre 2026 |
| Fenêtre de contexte |
1 050 000 tokens |
1 000 000 tokens |
| Sortie maximale |
128 000 tokens |
128 000 tokens |
| Entrée / sortie |
Entrée texte et image ; sortie texte |
Entrée texte et image ; sortie texte |
| Date limite de connaissances |
30 avril 2026 |
Juin 2026 |
| Contrôle du raisonnement |
low, medium, high, xhigh, max |
La pensée adaptative est toujours active ; l'effort peut être ajusté de low à max |
| Contrôles principaux de l'agent |
Appels d'outils asynchrones, pilotage en cours de tour, utilisation d'ordinateur, outils hébergés |
Pensée préservée, effort par message, messages système limités au tour, mises à jour de progression |
| Fine-tuning |
Non pris en charge |
Non répertorié comme fonctionnalité standard de Fable 5.1 |
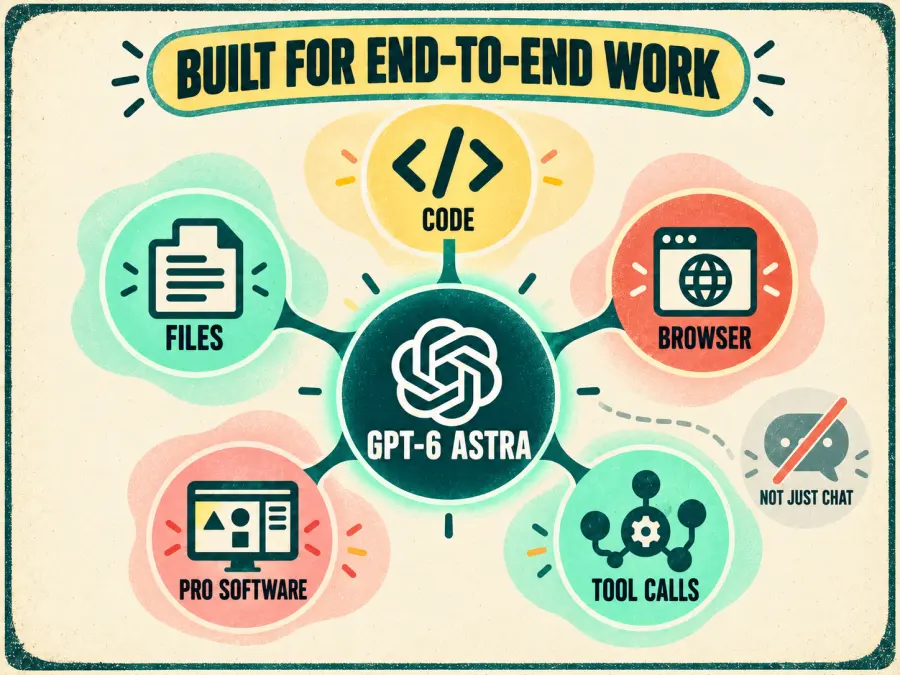
OpenAI positionne Astra comme un modèle pour le travail complexe de bout en bout sur le code, les navigateurs, les fichiers et les logiciels professionnels. Ses contrôles API importent lorsqu'un agent est déjà en mouvement : un utilisateur peut piloter la tâche pendant l'exécution, et les appels d'outils asynchrones réduisent le temps d'inactivité pendant que le travail externe se termine. Voir la documentation du modèle GPT-6 Astra et le rapport de lancement.
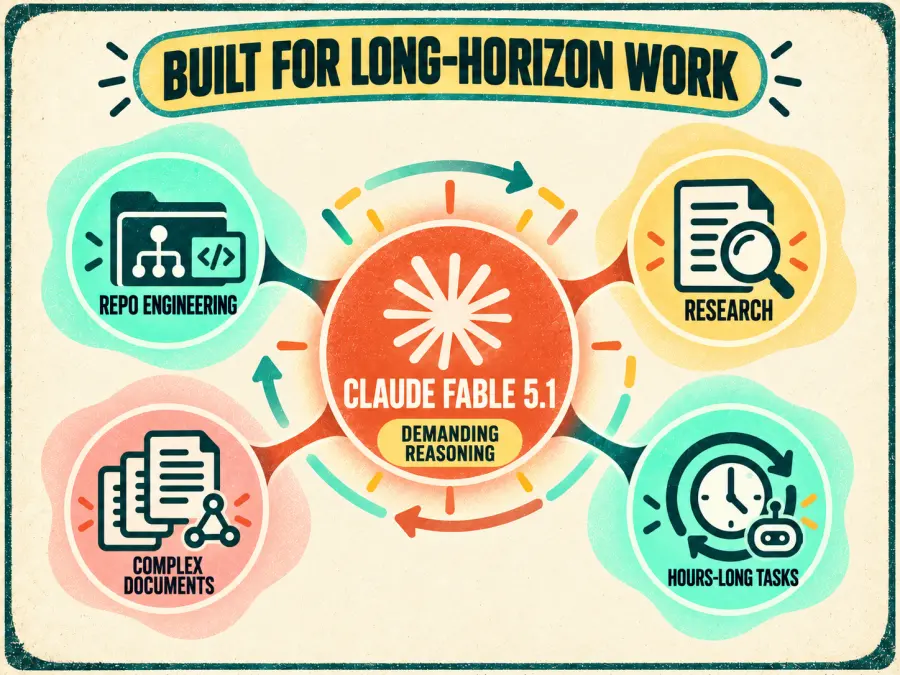
Anthropic positionne Fable 5.1 pour le raisonnement exigeant et le travail agentique de long terme. Sa pensée adaptative toujours active le rend moins adapté lorsque vous voulez un chemin rapide réellement sans raisonnement, mais l'effort par message et la pensée préservée aident les longues sessions à conserver leur continuité. La documentation de Claude Fable 5.1 note aussi des détails de migration propres à l'API : les valeurs forcées tool_choice any et tool ne sont pas prises en charge, et certains contrôles en cours de conversation restent des fonctionnalités bêta.
Benchmarks : le gagnant dépend du tableau de scores
Les résultats rapportés par OpenAI favorisent GPT-6 Astra
La comparaison de lancement d'OpenAI montre Astra en tête sur la plupart des lignes publiées en codage, terminal, automatisation, mathématiques et science. Ce sont des résultats rapportés par le fournisseur, ils doivent donc être traités comme des éléments à examiner plutôt que comme un substitut à votre propre évaluation.
| Benchmark |
GPT-6 Astra |
Claude Fable 5.1 |
Leader |
| Terminal-Bench 4.0 |
57.9% |
55.8% |
Astra |
| DeepSWE v1.1 |
74.1% |
67.4% |
Astra |
| FrontierCode Main |
53.3% |
50.9% |
Astra |
| FrontierCode Extended |
64.5% |
63.6% |
Astra |
| AutomationBench |
41.4% |
31.4% |
Astra |
| Terminal-Bench Science 0.1 |
64.6% |
52.6% |
Astra |
| FrontierMath Tier 4 v2 |
97.6% |
87.8% |
Astra |
| GPQA Diamond |
96.0% |
93.7% |
Astra |
| Humanity's Last Exam avec outils |
57.2% |
65.0% |
Fable 5.1 |
Source : rapport de lancement de GPT-6 Astra d'OpenAI. L'accès aux outils, les prompts, l'effort de raisonnement, les budgets de tokens et les règles de nouvelle tentative influencent ces scores.
L'exception importante est Humanity's Last Exam avec outils, où Fable 5.1 mène. C'est un avertissement précoce contre la réduction de « meilleur modèle » à un seul tableau de fournisseur.
La dernière comparaison indépendante est une égalité 53–53
Certains résultats de recherche publiés immédiatement après le lancement d'Astra citent encore un ancien résultat Artificial Analysis de 61 pour Astra et 66 pour Fable 5.1. La comparaison en direct utilise désormais Intelligence Index v4.3 et attribue 53 aux deux. Cette mise à jour est la plus grande différence entre cet article et de nombreuses comparaisons de première vague.
| Évaluation Artificial Analysis v4.3 |
GPT-6 Astra max |
Claude Fable 5.1 max |
Leader |
| Indice d'intelligence |
53 |
53 |
Égalité |
| AA-Briefcase |
1,562 |
1,662 |
Fable 5.1 |
| GDPval-AA v2 |
1,580 |
1,763 |
Fable 5.1 |
| AutomationBench-AA |
68% |
59% |
Astra |
| Terminal-Bench v4.0 |
59% |
52% |
Astra |
| SciCode |
56% |
63% |
Fable 5.1 |
| Humanity's Last Exam |
55% |
59% |
Fable 5.1 |
| GDP.pdf |
31% |
26% |
Astra |
| CritPt |
32% |
30% |
Astra |
| AA-Omniscience |
43 |
43 |
Égalité |
| AA-LCR v1.1 |
81% |
85% |
Fable 5.1 |
Source : comparaison en direct GPT-6 Astra vs Claude Fable 5.1 d'Artificial Analysis, consultée le 8 septembre 2026.
La distribution est plus utile que le titre à égalité. Astra mène l'automatisation, le travail en terminal, les tâches PDF et le raisonnement sur les points critiques. Fable mène le travail de connaissance professionnel, le codage scientifique, HLE et le raisonnement à long contexte. Choisissez le benchmark le plus proche du travail que vous livrez réellement.
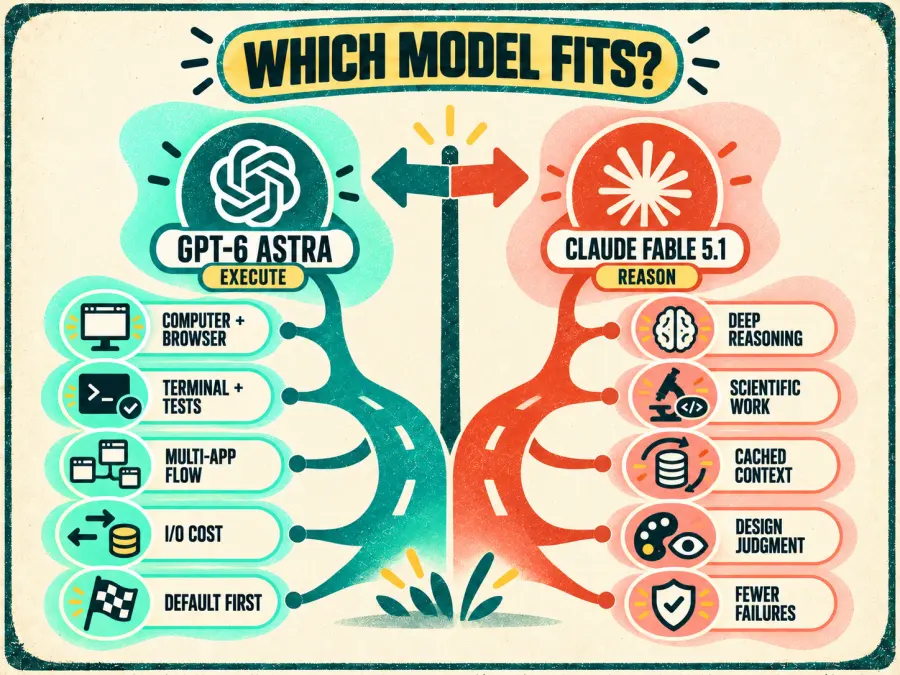
GPT-6 Astra vs Claude Fable 5.1 pour le code
Choisissez Astra pour l'exécution et la récupération
Astra est le meilleur point de départ lorsqu'un agent de codage doit faire plus que produire un patch. Il est particulièrement adapté aux workflows qui exigent du modèle de :
inspecter un grand dépôt et tracer les dépendances ;
modifier plusieurs fichiers et préserver les conventions du projet ;
exécuter des commandes shell et des suites de tests ;
diagnostiquer un environnement cassé ;
rendre l'application dans un navigateur ;
inspecter les échecs et continuer à itérer jusqu'à ce que les critères d'acceptation soient satisfaits.
Ses avances sur Terminal-Bench, DeepSWE et AutomationBench soutiennent ce cas d'usage. Plus important encore, ces capacités s'alignent avec les contrôles d'exécution du modèle. Un score de codage élevé a moins de valeur si le système environnant ne peut pas garder le modèle orienté pendant une longue boucle planifier–agir–observer–réparer.
Choisissez Fable 5.1 pour la clarté du code et le raisonnement spécialisé
Fable 5.1 mérite un test A/B lorsque la partie difficile consiste à comprendre le problème, produire du code lisible ou raisonner sur des détails scientifiques et analytiques. Ses avances indépendantes sur SciCode, AA-Briefcase, GDPval-AA v2 et HLE vont dans ce sens.
Cela ne signifie pas que Fable est un faible codeur agentique. Anthropic rapporte que des partenaires précoces l'ont utilisé pour des modifications multi-dépôts, l'investigation d'incidents, des agents navigateur et du codage de bout en bout. Ces rapports de partenaires apparaissent dans l'annonce de Fable 5.1 d'Anthropic lui-même, ce sont donc des exemples utiles mais pas des tests neutres en face-à-face.
La séparation pratique pour les développeurs est la suivante :
Utilisez Astra lorsque le succès signifie que la tâche a tourné, réussi et été vérifiée.
Utilisez Fable 5.1 lorsque le succès signifie que le design ou le raisonnement est cohérent, révisable et facile à maintenir.
Pour une vue plus large des familles de modèles, voir Claude vs ChatGPT pour le codage.
GPT-6 Astra vs Claude Fable 5.1 pour le codage frontend
Il n'existe pas de benchmark largement accepté qui mesure proprement le goût frontend. Les benchmarks SWE testent le travail sur dépôt ; ils ne notent pas de manière fiable la hiérarchie visuelle, le soin des interactions, le comportement responsive, l'accessibilité ou la fidélité à une image de référence.
Les rapports pratiques disponibles suggèrent une division utile :
Fable 5.1 pour la première implémentation sensible au design. Il produit souvent du code lisible et des petites interactions soignées.
Astra pour l'exécution full-stack et la QA navigateur. Il est mieux positionné pour exécuter l'application, inspecter le résultat rendu, reproduire un mouvement ou une géométrie et réparer les échecs.
Dans une comparaison publique à six tâches, Abel Baruwa a donné cinq victoires à Astra, notamment pour une recréation de mouvement plus fluide et un travail 3D plus solide, tout en créditant Fable 5.1 pour ses boutons soignés, ses animations et ses détails d'interaction. C'est un test unique à un seul essai d'un créateur, pas un benchmark contrôlé.
Un workflow de production solide peut utiliser les deux : demandez à Fable l'architecture des composants et la première passe visuelle, puis utilisez Astra avec des outils navigateur pour tester les breakpoints, les erreurs de console, la navigation clavier, les états de chargement et les critères d'acceptation au pixel près. Si vous devez n'en choisir qu'un, choisissez Astra lorsque la vérification compte plus que le goût initial ; choisissez Fable lorsqu'un développeur révisera chaque changement et que la nuance visuelle domine.
GPT-6 Astra vs Claude Fable 5.1 pour les agents
La qualité du modèle n'est qu'une couche d'un agent. Le harnais d'outils, les permissions, la gestion d'état, la politique de nouvelle tentative et l'évaluateur décident souvent si une exécution réussit.
| Exigence de l'agent |
Meilleur point de départ |
Raison |
| Opération navigateur ou bureau |
GPT-6 Astra |
Positionnement natif autour de l'utilisation d'ordinateur et de la vérification visuelle |
| Workflow terminal long |
GPT-6 Astra |
Évaluations actuelles plus solides en terminal et automatisation |
| Outils externes asynchrones |
GPT-6 Astra |
Prend en charge l'appel d'outils asynchrone et le pilotage en cours de tour |
| Très grand contexte répété |
Claude Fable 5.1 |
Lectures de cache bien moins chères |
| Agent de recherche approfondie ou scientifique |
Claude Fable 5.1 |
Évaluations indépendantes pertinentes plus solides |
| Orchestration stricte d'outils forcés |
GPT-6 Astra, ou adaptez le harnais Fable |
Fable 5.1 rejette tool_choice: any et tool ; utilisez plutôt auto, none ou des schémas stricts |
| Exigences de rétention sensibles |
Vérifiez avant de choisir Fable |
Fable 5.1 exige une rétention de 30 jours, sauf si Anthropic autorise expressément une exception |
Pour l'un ou l'autre modèle, placez les actions destructrices derrière des validations d'approbation, validez les arguments des outils, fixez des limites d'itération et de dépenses, et définissez une route de repli. Un agent capable d'opérer un navigateur ou un terminal a aussi besoin d'une frontière d'autorisation claire ; la force sur les benchmarks ne remplace pas la sécurité au niveau applicatif.
Tarification : prix catalogue, prix du cache et coût par tâche
Tarification officielle de l'API
Les deux modèles ont les mêmes prix officiels standard en entrée et en sortie. Les lectures de cache créent la principale différence de grille tarifaire.
| Prix officiel par million de tokens |
GPT-6 Astra |
Claude Fable 5.1 |
| Entrée |
10,00 $ |
10,00 $ |
| Sortie |
50,00 $ |
50,00 $ |
| Écriture de cache de 5 minutes |
12,50 $ |
12,50 $ |
| Lecture du cache |
1,00 $ |
0,25 $ |
| Entrée/sortie par lots |
50 % de réduction |
50 % de réduction |
Sources : documentation des modèles d'API OpenAI et documentation de Claude Fable 5.1.
Anthropic estime que le taux de lecture de cache plus bas de Fable 5.1 réduit le coût typique des charges de travail d'environ 25 % par rapport à Fable 5 et peut réduire le coût des charges de travail fortement agentiques jusqu'à environ 45 %. Ces chiffres sont des estimations d'Anthropic basées sur son mélange de charges de travail mesuré, et non une garantie pour chaque application.
Astra a une considération supplémentaire pour le contexte long. Pour les requêtes OpenAI directes au-dessus de 272 000 tokens d'entrée, la requête complète est facturée à des tarifs plus élevés : 2× le prix d'entrée et d'entrée mise en cache, et 1,5× le prix de sortie. Tarifiez les tests à contexte long séparément au lieu d'extrapoler à partir d'une requête courte.
Tarification GPT Proto
Au 8 septembre 2026, les calculateurs GPT Proto en direct listent ces tarifs standard :
| Prix GPT Proto par million de tokens |
GPT-6 Astra |
Claude Fable 5.1 |
| Entrée |
8,00 $ |
9,00 $ |
| Sortie |
40,00 $ |
45,00 $ |
| Écriture de cache |
10,00 $ |
11,25 $ |
| Lecture du cache |
0,80 $ |
0,225 $ |
Pour une requête avec 1 500 nouveaux tokens d'entrée et 800 tokens de sortie, hors activité de cache, Astra coûte environ 0,044 $ et Fable 5.1 coûte environ 0,0495 $. Astra est moins cher dans cette forme de requête simple.
Ajoutez maintenant 3 000 tokens d'écriture de cache et 25 000 tokens de lecture de cache. Les totaux estimés deviennent environ 0,094 $ pour Astra et 0,0889 $ pour Fable 5.1. Fable devient moins cher parce que ses lectures de cache coûtent bien moins.
C'est pourquoi « quel modèle est le plus rentable ? » a deux réponses valables :
Vérifiez le calculateur de prix d'Astra et le calculateur de prix de Fable 5.1 actuel avant le déploiement en production.
Le coût par tâche raconte une autre histoire
La comparaison actuelle Artificial Analysis à effort maximal rapporte :
| Indicateur d'efficacité indépendant |
GPT-6 Astra |
Claude Fable 5.1 |
| Prix mélangé par million de tokens |
7,70 $ |
7,175 $ |
| Coût par tâche |
3,26 $ |
7,63 $ |
| Tokens de sortie par tâche |
27 K |
78 K |
| Tokens de raisonnement par tâche |
17 K |
47 K |
| Vitesse de sortie |
59 tokens/s |
70 tokens/s |
| Temps jusqu'au premier token |
322,48 s |
277,47 s |
| Temps total par tâche |
467,25 s |
724,10 s |
Fable a le taux de token mélangé le plus bas et une génération de tokens plus rapide dans cette configuration, mais le coût par tâche d'Astra est environ 57 % inférieur parce qu'il utilise bien moins de tokens de sortie et de raisonnement. Astra termine aussi la tâche mesurée plus tôt dans l'ensemble.
Ce n'est pas une preuve qu'Astra sera moins cher dans votre dépôt. C'est la preuve que le prix par token seul est une métrique d'achat incomplète. Suivez la dépense totale divisée par les tâches acceptées, en incluant les nouvelles tentatives, les appels de repli, le contexte généré par les outils et le temps de revue humaine.
Ce que rapportent les développeurs
Les premiers rapports communautaires ajoutent de la texture, mais ce sont des anecdotes. Les prompts, les outils, l'effort du modèle, les limites d'abonnement et les environnements de tâches sont rarement contrôlés.
La première impression d'Astra par Dan Shipper a mis en avant une utilisation d'ordinateur et un travail 3D ou de visualisation inhabituellement solides, tout en avertissant que le modèle peut trop compliquer les tâches, surtout à effort élevé. Voir le post X original.
Dans un workflow détaillé de machine learning en face-à-face, un utilisateur Reddit a trouvé Astra plus agentique et plus fort en débogage et reproductibilité, mais a préféré le code lisible, l'écriture, le suivi de consignes et le rapport analytique de Fable 5.1. Le post documente aussi des erreurs concrètes des deux modèles. Voir la comparaison ML complète.
Les comparaisons publiques frontend et 3D favorisent souvent l'exécution ou le réalisme d'Astra tout en créditant Fable pour le soin des interactions. Ces tests soutiennent une hypothèse pour votre ensemble d'évaluation ; ils n'établissent pas de gagnant universel.
Le schéma récurrent est plus informatif que n'importe quelle démo virale unique : Astra a tendance à faire avancer le travail de manière agressive ; Fable produit souvent un artefact plus propre ou plus délibéré. Les deux peuvent faire des erreurs confiantes et vérifiables.
Un protocole d'évaluation équitable pour votre charge de travail API
Ne comparez pas un modèle dans un harnais de codage mature avec l'autre dans une simple boîte de chat. Gardez le système autour du modèle aussi similaire que possible.
Sélectionnez 20 à 50 tâches représentatives issues de travail de production réel.
Donnez aux deux modèles le même état de dépôt, le même prompt, les mêmes permissions d'outils et les mêmes critères d'acceptation.
Faites correspondre l'effort de raisonnement aussi étroitement que les API le permettent.
Fixez des budgets identiques de temps, de tokens, d'itérations et de nouvelles tentatives.
Exécutez chaque tâche plus d'une fois pour réduire la chance liée à une seule exécution.
Notez avec des tests exécutables ou une grille aveugle lorsque c'est possible.
Enregistrez le succès au premier passage, le succès final, le temps réel, les tokens, les lectures de cache, les nouvelles tentatives et les minutes de revue humaine.
Calculez le coût par résultat accepté, pas seulement le coût par token.
Utilisez une grille d'évaluation comme celle-ci :
| Métrique |
Poids |
Astra |
Fable 5.1 |
| Succès de la tâche |
40% |
|
|
| Exactitude / taux de réussite des tests |
20% |
|
|
| Temps de revue humaine |
15% |
|
|
| Latence de bout en bout |
10% |
|
|
| Coût total par résultat accepté |
10% |
|
|
| Maintenabilité du code ou de l'artefact |
5% |
|
|
Modifiez les poids avant d'inspecter les résultats. Sinon, il est facile de déplacer les poteaux vers le modèle que vous préférez déjà.
Testez les deux modèles via l'API GPT Proto
GPT Proto expose les deux routes de modèles via le même endpoint Chat Completions compatible OpenAI. Utilisez le même prompt et changez uniquement l'ID du modèle pour un premier test A/B.
Requête GPT-6 Astra
curl --request POST "https://gptproto.com/v1/chat/completions" \
  --header "Authorization: Bearer $GPTPROTO_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "gpt-6-astra",
    "messages": [
      {
        "role": "user",
        "content": "Review this implementation plan. Identify failure modes, then return a prioritized test plan."
      }
    ]
  }'
Requête Claude Fable 5.1
curl --request POST "https://gptproto.com/v1/chat/completions" \
  --header "Authorization: Bearer $GPTPROTO_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "claude-fable-5-1",
    "messages": [
      {
        "role": "user",
        "content": "Review this implementation plan. Identify failure modes, then return a prioritized test plan."
      }
    ]
  }'
Pour une comparaison significative de codage ou d'agent, placez ces appels dans le même évaluateur et donnez à chaque route des outils équivalents. Enregistrez l'usage et la latence de chaque tentative, puis notez l'artefact produit plutôt que la fluidité de la réponse.
Quel modèle choisir ?
Choisissez GPT-6 Astra si la plupart de ces affirmations sont vraies :
Votre agent travaille dans un terminal, un navigateur, un dépôt ou une application professionnelle.
L'achèvement et la vérification comptent plus que le style rédactionnel.
Vous voulez les tarifs standard GPT Proto plus bas en entrée/sortie.
Vos charges de travail ressemblent à des tests d'automatisation, de terminal, de PDF ou d'exécution en plusieurs étapes.
Vous voulez des appels d'outils asynchrones ou un pilotage utilisateur en cours d'exécution.
Choisissez Claude Fable 5.1 si la plupart de ces affirmations sont vraies :
Vos tâches les plus difficiles impliquent du codage scientifique, de la recherche, de la planification ou du travail de connaissance.
Le code lisible et les détails d'interaction soignés comptent beaucoup.
Les longues sessions lisent répétitivement le même grand contexte.
Votre charge de travail bénéficie de la pensée préservée et d'un effort ajustable par message.
Votre propre évaluation montre moins de nouvelles tentatives ou moins de revue humaine malgré des tarifs standard GPT Proto plus élevés.
Utilisez les deux si les modes d'échec diffèrent. Un routeur pratique peut envoyer les tâches à forte exécution à Astra, les tâches analytiques ou sensibles au design à Fable 5.1, et réessayer une tâche échouée sur l'autre modèle. Le routage est souvent plus rentable que de forcer un seul modèle de frontière à traiter chaque requête.
Verdict final
Pour la plupart des équipes API qui choisissent entre OpenAI GPT-6 Astra et Anthropic Claude Fable 5.1, Astra est la meilleure première route pour l'exécution de code, l'utilisation de navigateur ou d'ordinateur et les workflows d'agents. Il combine des benchmarks orientés exécution plus solides avec des tarifs standard GPT Proto actuels plus bas et un coût mesuré plus faible par tâche de benchmark indépendante.
Fable 5.1 reste le meilleur spécialiste lorsque le raisonnement scientifique ou de travail de connaissance, le code maintenable, le soin de l'interface ou un contexte mis en cache répété détermine le succès. Son prix de lecture de cache plus bas peut aussi en faire le modèle moins cher même lorsque ses tarifs standard par token sont plus élevés sur GPT Proto.
La décision la plus sûre est un test A/B au niveau des tâches. Commencez par GPT-6 Astra, comparez la même charge de travail sur Claude Fable 5.1, et promouvez le modèle avec le coût le plus bas par résultat accepté.