Se você está decidindo entre o GPT 6.1 Terra e o Sonnet 5.5 hoje, aqui está a regra de decisão rápida que uso antes de executar um benchmark:
Escolha o GPT-6.1 Terra se o seu pipeline executa inspeção de capturas de tela em alto volume, automação de formulários e faturas, depuração de layout de interface, ou tarefas de codificação limitadas onde uma taxa de US$ 0,80/US$ 4,00 por token e uma execução de tarefa 3x mais rápida importam mais do que a profundidade de refatoração autônoma máxima — e suas entradas de solicitação única permanecem em ou abaixo de 272 mil tokens.
Fique com o Claude Sonnet 5.5 se o seu agente executa migrações de repositórios com vários arquivos, depuração profunda de terminal onde uma edição perdida é mais cara do que a conta de tokens, ou prompts de passagem única entre 300 mil e 900 mil tokens, onde a sobretaxa de contexto longo da OpenAI elimina a vantagem de preço de entrada do Terra.
Você pode verificar as taxas do catálogo em tempo real ou calcular seu volume mensal de tokens através do hub de comparação de modelos GPT Proto antes de se comprometer com qualquer uma das opções. Tudo abaixo é uma comparação baseada em documentação e benchmarks verificada em 5 de novembro de 2026; os benchmarks relatados pelos fornecedores são rotulados separadamente das medições independentes da Artificial Analysis e do feedback inicial dos desenvolvedores.
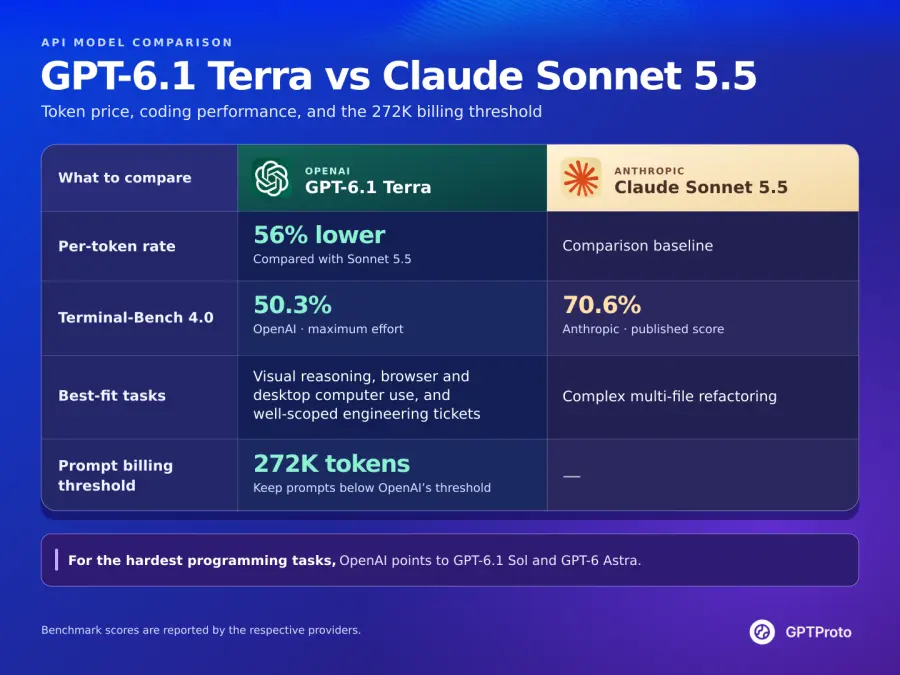
Comparativo rápido: GPT-6.1 Terra vs Claude Sonnet 5.5
Desenvolvedores que buscam por ChatGPT 6.1 Terra vs Sonnet 5.5 ou Anthropic Claude Sonnet 5.5 vs GPT 6.1 Terra frequentemente encontram especificações conflitantes, pois os dois fornecedores estruturam seus controles de raciocínio, endpoints de ferramentas e sobretaxas de contexto longo de maneiras diferentes. A tabela abaixo alinha ambos os modelos com a documentação oficial do OpenAI gpt-6.1-terra, a visão geral do Claude Sonnet 5.5 da Anthropic e as taxas de catálogo em tempo real do GPT Proto.
| Especificação |
GPT-6.1 Terra (gpt-6.1-terra) |
Claude Sonnet 5.5 (claude-sonnet-5-5) |
| Provedor |
OpenAI |
Anthropic |
| Data de lançamento |
26 de outubro de 2026 |
28 de setembro de 2026 |
| Entrada / saída padrão oficial (por 1M de tokens) |
$1,00 / $5,00 |
$2,00 / $10,00 |
| Entrada / saída GPT Proto (por 1M de tokens) |
$0,80 / $4,00 (−20% vs oficial) |
$1,80 / $9,00 (−10% vs oficial) |
| Leitura de entrada em cache oficial (por 1M de tokens) |
$0,05 (5% da entrada base) |
$0,10 (reduzido de $0,20 em 7 de outubro de 2026) |
| Escrita em cache oficial (por 1M de tokens) |
$1,25 (TTL de 30m) / $2,50 (TTL de 12h) |
$2,50 (TTL de 5m) |
| Leitura / escrita em cache GPT Proto (por 1M de tokens) |
$0,04 / $1,00 |
$0,09 / $2,25 (verifique a página do modelo ao vivo) |
| Janela de contexto |
1.050.000 tokens |
1.000.000 tokens |
| Regra de precificação para contexto longo |
>272K de entrada cobra a solicitação completa em 2x entrada/cache e 1,5x saída |
Taxa fixa em toda a janela de contexto de 1M |
| Tokens máximos de saída |
128.000 tokens |
128.000 tokens |
| Modalidades de entrada / saída |
Texto, Imagem, Documento em → Texto fora |
Texto, Imagem, Documento em → Texto fora |
| Data de corte de conhecimento |
1 de junho de 2026 |
Início a meados de 2026 (mantém o tokenizador do Sonnet 5) |
| Controles de raciocínio / esforço |
nenhum, baixo, médio (padrão), alto, xalto, máximo |
Pensamento adaptativo ativado por padrão; médio, alto (padrão da API), máximo, entre_ferramentas |
| Endpoint necessário para chamada de ferramenta |
/v1/responses exigido pela documentação da OpenAI |
/v1/messages (nativo) ou compatível com OpenAI /v1/chat/completions |
| Disponibilidade de cliente e IDE |
ChatGPT Work & Codex (não o Chat comum), GitHub Copilot, Claude Code (via API) |
Claude.ai, Claude Code, GitHub Copilot, Cursor |
| Índice de Inteligência AA (v4.3.2) |
41 (médio) / 48 (máximo) |
56 (máximo, Fallback Padrão) |
| Custo médio de tarefa de avaliação AA |
$0,10 (`médio`) / $0,40 (máximo) |
$5,46 (máximo, Fallback Padrão) |
| Terminal-Bench 4.0 (relatado pelo fornecedor) |
50,3% (esforço máximo) |
70,6% |
Três linhas nessa tabela fazem quase todo o trabalho quando você está orçando um aplicativo. Primeiro, em solicitações padrão com menos de 272 mil tokens, o GPT-6.1 Terra é 56% mais barato por token no GPT Proto tanto para entrada quanto para saída, portanto, conclusões longas não alteram o ranking de custos. Segundo, o Sonnet 5.5 mantém uma vantagem de 20,3 pontos percentuais no Terminal-Bench 4.0, que acompanha de perto como os dois modelos se comportam em edições de repositório não guiadas. Terceiro, ao contrário do GPT-6.1 Sol, o GPT-6.1 Terra restaura o suporte para reasoning.effort: "none", dando aos desenvolvedores da OpenAI um verdadeiro caminho rápido sem raciocínio novamente.
Análise de Preços e Custos: Qual é mais caro e qual é mais econômico?
Quando desenvolvedores pesquisam "GPT 6.1 Terra vs Sonnet 5.5 qual é mais caro" ou "qual é mais econômico", eles geralmente estão tentando conciliar dois números diferentes: a tarifa por milhão de tokens na página de preços e o custo real em dólares de uma tarefa concluída pelo agente. Essas duas proporções não são as mesmas.
No nível por token, o Claude Sonnet 5.5 é o modelo de preço mais alto por uma margem significativa. O preço oficial da Anthropic é de US$ 2,00 por milhão de tokens de entrada e US$ 10,00 por milhão de tokens de saída — o dobro do preço de lista de US$ 1,00/US$ 5,00 da OpenAI para o Terra. Como o GPT Proto aplica um desconto de 20% no GPT-6.1 Terra (US$ 0,80 de entrada / US$ 4,00 de saída) e um desconto de 10% no Claude Sonnet 5.5 (US$ 1,80 de entrada / US$ 9,00 de saída), o Sonnet 5.5 custa 2,25 vezes mais por token na plataforma. Ambos os fornecedores agora precificam leituras de entrada em cache a 5% da entrada base (US$ 0,05 oficial para o Terra vs US$ 0,10 oficial para o Sonnet 5.5 após a Anthropic reduzir pela metade o preço de leitura de cache do Sonnet em outubro de 2026), e ambos cobram 1,25x a entrada base para gravações de cache padrão (US$ 1,25 vs US$ 2,50 oficial). Observe que um prompt longo de uso único gravado no cache, na verdade, adiciona uma sobretaxa de 25% em qualquer um dos modelos se você nunca ler esse prefixo uma segunda vez.
No nível por tarefa, a diferença torna-se muito mais acentuada. No Intelligence Index v4.3.2 da Artificial Analysis (publicado em 26–27 de outubro de 2026), a configuração testada do Claude Sonnet 5.5 (max esforço com Fallback Padrão) registrou um custo médio ponderado de US$ 5,46 por tarefa de avaliação. Na mesma suíte de avaliação, [GPT-6.1 Terra com esforço `max`](https://artificialanalysis.ai/models/gpt-6-1-terra) teve uma média de US$ 0,40 por tarefa, e o GPT-6.1 Terra com esforço medium teve uma média de apenas US$ 0,10 por tarefa. Isso representa uma diferença de 13,6x no esforço max e uma diferença de 54,6x ao comparar a configuração máxima do Sonnet com a configuração padrão medium do Terra.
Por que uma diferença de 2x por token se transforma em uma diferença de fatura de 13x a 54x? Modelos de raciocínio cobram tokens de pensamento como tokens de saída. Quando o Sonnet 5.5 é executado com esforço alto ou máximo em um benchmark aberto, ele gera longas cadeias de raciocínio a US$ 10,00 por milhão de tokens (US$ 9,00 no GPT Proto). O anúncio do Terra também observa que, com esforço máximo no Agents' Last Exam, o Terra usou menos de um terço dos tokens do Claude Opus 5.5. Ainda mais importante é a descoberta da fronteira de Pareto da Artificial Analysis: para o GPT-6.1 Terra, as configurações de esforço low e medium são ótimas de Pareto para inteligência versus custo. Aumentar o Terra para max eleva sua pontuação de 41 para 48, o que empata com o GPT-6.1 Sol com esforço medium — exceto que o Sol medium custa US$ 0,21 por tarefa, enquanto o Terra `max` custa US$ 0,40. Em suma, se você deseja a configuração mais econômica no Terra, mantenha-o em low ou medium; se uma tarefa for difícil o suficiente para exigir esforço max, você já deveria estar testando o Sol ou o Sonnet 5.5.
Cálculo de Custos na Prática: Dois Cenários Reais de Produção
Para entender onde a taxa de tokens mais barata realmente compensa — e onde ela sai pela culatra — vamos fazer o cálculo exato com as taxas de catálogo em tempo real do GPT Proto ($0,80/$4,00 para Terra; $1,80/$9,00 para Sonnet 5.5), assumindo solicitações não armazenadas em cache abaixo de 272 mil tokens.
O Cenário A é um loop de agente de QA visual e extração de formulários de 20 etapas. Cada etapa envia uma captura de tela e um trecho de DOM totalizando 15.000 tokens de entrada e gera 1.500 tokens de saída (incluindo médios tokens de raciocínio). Ao longo de 20 etapas, um único fluxo de trabalho consome 300.000 tokens de entrada (0,3M) e 30.000 tokens de saída (0,03M):
GPT-6.1 Terra no GPT Proto: (0,3 * $0,80) + (0,03 * $4,00) = $0,24 + $0,12 = $0,36 por fluxo de trabalho.
Claude Sonnet 5.5 no GPT Proto: (0,3 * $1,80) + (0,03 * $9,00) = $0,54 + $0,27 = $0,81 por fluxo de trabalho.
Com 10.000 fluxos de trabalho por mês, o Terra custa $3.600 contra $8.100 do Sonnet — uma economia mensal de $4.500. Mesmo que o Terra falhe na validação em 20% das execuções e precise repetir esses 2.000 fluxos de trabalho do zero (adicionando $720), sua conta total é de $4.320, o que ainda economiza $3.780 por mês em comparação com uma execução do Sonnet sem repetições.
O Cenário B é uma refatoração de backend de vários arquivos em um pull request ativo. Suponha que cada tentativa leia 80.000 tokens de entrada e emita 10.000 tokens de saída. Uma execução limpa no Sonnet 5.5 custa (0,08 * $1,80) + (0,01 * $9,00) = $0,234. Uma execução no Terra custa (0,08 * $0,80) + (0,01 * $4,00) = $0,104. Você economiza 13 centavos na chamada de API. O problema é que, se o Terra perder uma dependência de tipo entre módulos — o que se alinha com sua diferença de 50,3% vs 70,6% no Terminal-Bench — e forçar três repetições mais 12 minutos do tempo de um engenheiro sênior a $90/hora ($18,00 de mão de obra), essa economia de 13 centavos em tokens acabou de custar $18,18 à sua equipe. Em uma frase: o Terra vence de forma esmagadora em loops repetíveis e verificáveis por máquina, enquanto o Sonnet 5.5 compensa sua tarifa mais alta sempre que uma edição com falha consome o tempo de revisão humana.
Contexto da Janela (1,05M vs 1M): Por que ultrapassar 272K muda a conta
No papel, a comparação entre o contexto da janela do GPT 6.1 Terra vs Sonnet 5.5 parece um empate técnico com uma leve vantagem para a OpenAI: o Terra aceita 1.050.000 tokens de entrada e emite até 128.000 tokens de saída, enquanto o Claude Sonnet 5.5 aceita 1.000.000 de tokens de entrada e emite até 128.000 tokens de saída. A maioria das tabelas comparativas para por aí.
Se você ler a documentação do modelo gpt-6.1-terra da OpenAI, no entanto, existe um limite de cobrança em 272.000 tokens de entrada que muda completamente a economia de contextos longos. Sempre que um prompt excede 272K tokens de entrada no GPT-6.1 Terra, a OpenAI cobra a solicitação inteira — não apenas os tokens acima de 272K — com o dobro das taxas de entrada e cache e 1,5x a taxa de saída.
Aqui está o que acontece com a tarifa oficial por milhão de tokens no momento em que seu prompt passa de 272.000 tokens para 272.001 tokens:
| Faixa de Contexto |
GPT-6.1 Terra (Taxa Oficial) |
Claude Sonnet 5.5 (Taxa Oficial) |
Relação de Preço de Entrada |
| Prompt padrão (≤272K tokens de entrada) |
US$ 1,00 entrada / US$ 5,00 saída / US$ 0,05 leitura de cache |
US$ 2,00 entrada / US$ 10,00 saída / US$ 0,10 leitura de cache |
O Terra é 50% mais barato na entrada e saída |
| Prompt de contexto longo (>272K a 1M+ tokens de entrada) |
US$ 2,00 entrada / US$ 7,50 saída / US$ 0,10 leitura de cache |
US$ 2,00 entrada / US$ 10,00 saída / US$ 0,10 leitura de cache |
As taxas de entrada e leitura de cache são idênticas (US$ 2,00 / US$ 0,10) |
Ao contrário do modelo menor Haiku 5.5 da Anthropic (que aplica uma sobretaxa de 5x acima de 100K tokens), o Claude Sonnet 5.5 mantém um preço fixo em toda a sua janela de contexto de 1.000.000 de tokens.
Faça as contas em uma auditoria de repositório única de 400.000 tokens que produz 10.000 tokens de saída nas taxas oficiais da lista:
GPT-6.1 Terra (aciona a regra de >272K 2x/1,5x): (0,4 * US$ 2,00) + (0,01 * US$ 7,50) = US$ 0,80 + US$ 0,075 = US$ 0,875.
Claude Sonnet 5.5 (taxa fixa): (0,4 * US$ 2,00) + (0,01 * US$ 10,00) = US$ 0,80 + US$ 0,10 = US$ 0,900.
Assim que seu prompt ultrapassa 272K tokens, o desconto de 50% na entrada do Terra desaparece completamente, deixando uma diferença total de US$ 0,025 em uma chamada de 400K tokens. Minha recomendação é direta: nunca envie prompts monolíticos de >272K tokens para o GPT-6.1 Terra esperando uma economia pela metade do preço. Ou fragmente/recupere seu contexto abaixo de 272K tokens para que o Terra permaneça em sua faixa de US$ 1,00 (US$ 0,80 GPT Proto), ou direcione dumps de repositório de 300K–900K diretamente para o Claude Sonnet 5.5, onde você paga a mesma taxa oficial de entrada e obtém uma compreensão de código de longo alcance mais forte. (Antes de executar prompts >272K em produção através do GPT Proto, confirme com o suporte da plataforma como o ajuste de nível de 272K upstream é refletido no saldo da sua conta.)
Benchmarks e feedback da comunidade: Programação, Frontend e trabalho com agentes
As pontuações compostas das manchetes escondem onde cada modelo realmente tem sucesso. No Artificial Analysis Intelligence Index v4.3.2, o Claude Sonnet 5.5 (max, Default Fallback) pontua 56, o GPT-6.1 Sol (max) pontua 52, e o GPT-6.1 Terra pontua 48 com esforço max e 41 com esforço medium. (No snapshot do índice de 3 de novembro de 2026 exibido no cartão de comparação do GPT Proto, o Sonnet 5.5 registra 54,2 e o Terra max registra 51 — uma diferença menor de 3,2 pontos que ainda favorece o Sonnet.) Para tomar uma decisão prática de roteamento para código, interface de usuário (UI) frontend ou loops de agentes, precisamos decompor esses agregados por tipo de tarefa e compará-los com o que os desenvolvedores estão relatando na prática.
1. Programação de Backend e Terminal (GPT 6.1 Terra vs Sonnet 5.5 para código)
Para engenharia de software pura a partir da linha de comando, a Anthropic ainda mantém uma vantagem clara. No Terminal-Bench 4.0, a Anthropic relata 70,6% para o Claude Sonnet 5.5 (acima dos 10,3% no Sonnet 5), enquanto a OpenAI relata 50,3% para o GPT-6.1 Terra em esforço máximo (acima dos 21,5% no GPT-5.6 Terra). No recém-lançado Coding Agent Index v2.0 da Artificial Analysis, o Terra pontua 48 — 17 pontos à frente do GPT-6 Luna leve (31), mas 6 pontos atrás do GPT-6.1 Sol (54). A Artificial Analysis também observa que, especificamente para agentes de codificação, as configurações de esforço baixo e xalto do Terra situam-se na fronteira de custo-benefício, enquanto outras configurações de esforço ficam para trás.
Os primeiros testes no mundo real apontam para a fronteira exata entre os dois modelos:
O changelog de 26 de outubro de 2026 do GitHub Copilot relatou que, em testes internos iniciais, o GPT-6.1 Terra resolveu visivelmente mais tarefas de terminal e codificação em C# do que o GPT-5.6 Terra, acrescentando uma observação comportamental crucial: "Ele trabalha em etapas focadas e consolidadas em tarefas bem delimitadas." O GitHub não publicou as porcentagens brutas de taxa de sucesso nessa nota, portanto, trate-a como uma descoberta qualitativa da plataforma e não como um benchmark controlado.
Do lado do Claude, um teste comparativo inicial de desenvolvedores no r/ClaudeAI (executando dez tarefas pessoais de codificação três vezes por configuração em esforço alto no Claude Code e pi-agent) descobriu que o Sonnet 5.5 completou consistentemente as implementações em menos turnos de conversa e menos tokens de saída, em grande parte porque o Sonnet 5.5 processa chamadas de ferramentas paralelas de forma mais agressiva. Da mesma forma, na avaliação externa CursorBench 4.0 do Cursor, o Sonnet 5.5 em esforço alto pontuou 47,8% a US$ 1,67 por tarefa.
A conclusão para desenvolvedores de backend: se o ticket estiver bem delimitado — escrever um método de serviço em C#, adicionar um teste unitário ou corrigir um script de CLI isolado —, o Terra em esforço baixo ou médio terminará rapidamente por menos da metade do preço em tokens. Se o ticket exigir o rastreamento de estado em dez arquivos, onde um loop de repetição extra arruína o fluxo de trabalho, a competência de terminal de 70,6% do Sonnet 5.5 justifica a taxa mais alta. Onde a computação científica está envolvida, a OpenAI também relata que no Terminal-Bench-Science 0.1 (como escrever código para rastrear divisões celulares em vídeos de lapso de tempo), o Terra em esforço máximo supera o GPT-6.1 Sol e chega a cinco pontos do Claude Opus 5.5 por menos de um quinto do custo estimado.
2. GPT-6.1 Terra vs Sonnet 5.5 para Programação Frontend
Pesquisar GPT 6.1 Terra vs Sonnet 5.5 para Programação Frontend merece sua própria resposta, pois a engenharia de frontend consiste em dois trabalhos diferentes unidos: trabalho de layout visual/DOM e lógica de estado/arquitetura.
Quando a OpenAI apresentou a pontuação de 50,3% do GPT-6.1 Terra no Terminal-Bench 4.0, o único exemplo concreto de codificação destacado no anúncio foi um bug de frontend: "corrigir uma página da web cujo layout muda conforme ela carrega" (Cumulative Layout Shift, ou CLS). Ao mesmo tempo, a OpenAI relatou que no MMMU-Pro — um benchmark para raciocínio visual sobre diagramas, capturas de tela e layouts densos — o GPT-6.1 Terra supera o GPT-5.6 Terra em todos os níveis de esforço e quase iguala o GPT-6 Astra e o GPT-6.1 Sol de fronteira por uma fração do preço. No tópico do dia do lançamento no fórum da Comunidade de Desenvolvedores da OpenAI, uma das primeiras reações dos desenvolvedores resumiu o Terra como "um ótimo custo-benefício, especialmente no que diz respeito à compreensão visual. Decente na codificação também."
Essa divisão oferece às equipes de frontend uma clara divisão de trabalho:
Use o GPT-6.1 Terra para trabalho de frontend visual e de camada de UI: transformar capturas de tela do Figma ou wireframes em marcação inicial Tailwind/HTML, comparar capturas de tela renderizadas do Playwright com especificações de design para detectar nós DOM sobrepostos ou regressões de breakpoint móvel, e diagnosticar mudanças de layout CSS. Como o Terra processa imagens nativamente, executa mais de 3x mais rápido que o GPT-6.1 Sol e o Astra em benchmarks de ação visual, e custa US$ 0,80/US$ 4,00 no GPT Proto, seu pipeline de CI pode se dar ao luxo de executar verificações de regressão visual em cada commit.
Use o Claude Sonnet 5.5 para arquitetura de frontend pesada em lógica: refatorar árvores de estado complexas de server-action do React/Next.js, resolver restrições genéricas complexas do TypeScript ou migrar um store Redux legado sem quebrar a hidratação. Quando não há captura de tela para inspecionar e a dificuldade reside puramente na coerência de estado entre vários arquivos, o Sonnet 5.5 continua sendo a opção mais segura.
3. Trabalho Agêntico, Uso de Computador e Factualidade (para trabalho agêntico)
Se a sua definição de GPT 6.1 Terra vs Sonnet 5.5 para trabalho agêntico se concentra em automação de GUI, análise de documentos e uso de computador em back-office, o GPT-6.1 Terra é, indiscutivelmente, o lançamento de maior valor da OpenAI em 2026.
Nas avaliações reportadas pelo fornecedor da OpenAI no Agents' Last Exam v1 (que testa fluxos de trabalho profissionais de várias etapas, como converter desenhos arquitetônicos em um modelo 3D ou registrar códigos de tempo cena a cena em um filme de animação), o GPT-6.1 Terra com esforço médio pontuou 15 pontos percentuais acima do GPT-5.6 Terra por aproximadamente um terço do custo, igualando o carro-chefe GPT-6 Astra por um décimo do preço do token. Com esforço máximo, a OpenAI relata que o Terra é mais de 3x mais eficiente em tokens do que o Claude Opus 5.5 e custa 1/4 do seu preço por token, resultando em um custo por tarefa aproximadamente 9x menor, enquanto conclui fluxos de trabalho mais de 3x mais rápido do que o GPT-6 Astra e o GPT-6.1 Sol.
No OSWorld 2.1 (controle de aplicativos de desktop), a OpenAI relata que o Terra com esforço médio supera a melhor pontuação do GPT-5.6 Terra por uma fração do custo por tarefa. Para manter o equilíbrio, a pontuação publicada pela Anthropic no OSWorld 2.1 (offline) para o Claude Sonnet 5.5 é de impressionantes 83,9% (divulgada na tabela de benchmark Haiku 5.5 da Anthropic de outubro de 2026). Ambos os modelos são mecanismos de uso de computador de primeira linha; a diferença é que os agentes de captura de tela enviam uma nova captura a cada clique, o que consome tokens de entrada rapidamente e torna a taxa de entrada de $0,80/M GPT Proto do Terra muito mais fácil de sustentar em escala.
Tão importante quanto para agentes autônomos é saber quando o modelo não sabe algo. No benchmark independente AA-Omniscience da Artificial Analysis, a taxa de alucinação do GPT-6.1 Terra (com que frequência o modelo chuta quando lhe falta conhecimento) caiu 50 pontos percentuais — de 88% no GPT-5.6 Terra para 38% — enquanto simultaneamente ganhou 2 pontos em precisão geral. Essa medição independente corrobora a avaliação interna de factualidade da OpenAI (detalhada mais adiante no Cartão de Sistema do GPT-6.1 Terra), onde as taxas de erro factual com baixo esforço em prompts difíceis caíram de 53,6% para 16,7% (e para 4,3% com esforço máximo). Taxas de alucinação mais baixas significam menos chamadas de ferramentas corrompidas a jusante.
Experiência do desenvolvedor e armadilhas da API (GPT 6.1 Terra vs Sonnet 5.5 para desenvolvedores)
Alternar entre gpt-6.1-terra e claude-sonnet-5-5 em produção raramente é uma substituição de string de uma linha. Se você está avaliando a ergonomia do GPT 6.1 Terra vs Sonnet 5.5 para desenvolvedores, quatro restrições ao nível da API ditarão seu trabalho de integração.
Primeiro, o GPT-6.1 Terra suporta reasoning.effort: "none", enquanto o GPT-6.1 Sol não. Quando a OpenAI lançou o GPT-6.1 Sol em 29 de setembro de 2026, ela removeu os níveis de raciocínio none e minimal, forçando todas as solicitações para o nível low ou superior e invalidando temperature e top_p em todos os casos. De acordo com o guia oficial de migração e prompting do gpt-6.1-terra da OpenAI, o Terra suporta todo o espectro: none, low, medium (padrão), high, xhigh e max. Se você definir reasoning_effort: "none", o Terra é executado sem gerar tokens de raciocínio ocultos e permite parâmetros de amostragem padrão. No entanto, no momento em que você usa low, medium, high, xhigh ou max, você deve remover temperature, top_p, top_logprobs e logprobs do payload da sua solicitação, ou a API rejeitará a chamada com um erro HTTP 400.
Segundo, a OpenAI exige a API de Respostas (/v1/responses) para chamadas de ferramentas no GPT-6.1 Terra. Embora prompts de texto simples e imagens funcionem em /v1/chat/completions, a documentação do modelo da OpenAI declara explicitamente que a chamada de ferramentas requer a /v1/responses. Uma vez na API de Respostas, o Terra suporta todas as nove ferramentas nativas integradas da OpenAI — Pesquisa na Web, Pesquisa de arquivos, Geração de imagens, Interpretador de código, Shell hospedado, apply_patch, Habilidades, Uso de computador, MCP e Pesquisa de ferramentas — além de async: true em ferramentas de função personalizadas, para que o modelo possa continuar raciocinando enquanto uma ferramenta lenta em segundo plano é executada. Além disso, o Terra suporta o envio de um item de entrada configuration_update no meio da conversa para aumentar ou diminuir o reasoning.effort em uma etapa difícil, sem reescrever o prefixo do prompt ou invalidar seu cache de prompt de 30 minutos (prompt_cache_options.ttl: "30m").
Terceiro, o Claude Sonnet 5.5 tem suas próprias armadilhas de erro 400. De acordo com o guia de migração do Sonnet 5.5 da Anthropic, o Sonnet 5.5 usa raciocínio adaptativo por padrão (definindo como high o esforço na API e medium no Claude Code, conforme observado na documentação de configuração do Claude Code da Anthropic). Se sua integração legada do Claude envia thinking: {"type": "disabled"}, você deve atualizá-la para between_tools para a configuração de raciocínio mais baixa. Mais importante ainda, o Sonnet 5.5 rejeita escolhas forçadas de ferramentas (tool_choice: {"type": "any"} ou uma ferramenta nomeada forçada) com um erro 400 quando o raciocínio adaptativo está ativo; você deve usar auto e orientar a seleção da ferramenta no prompt. Você também precisa analisar os blocos de conteúdo da resposta por type em vez de assumir que content[0] é texto, porque o primeiro bloco é frequentemente um bloco de thinking.
Quarto, a integração com IDE e CLI já está configurada para ambos. Observe que, nas assinaturas de consumidor, as notas de lançamento da OpenAI confirmam que o GPT-6.1 Terra foi disponibilizado para o ChatGPT Work e Codex (para os planos Plus, Pro, Business, Enterprise e Edu), não para a interface de chat padrão do ChatGPT, e ele não oferece suporte à residência de inferência nos EAU (embora o modo Fast ofereça suporte à residência de dados na UE). Para desenvolvedores que trabalham em terminais locais, ambos os modelos podem ser conectados ao Claude Code e ao OpenAI Codex por meio do GPT Proto. Na página do modelo GPT-6.1 Terra, clicar em Experimentar este modelo abre um painel de Início Rápido onde você pode selecionar Claude Code ou ChatGPT (Codex) em Deixar a IA concluir a integração, ou clicar em Copiar Markdown para IA para permitir que seu assistente de codificação configure as variáveis de ambiente automaticamente.
Criando aplicativos: como rotear ambos os modelos com uma única chave de API
Quando as equipes perguntam sobre GPT 6.1 Terra vs Sonnet 5.5 para criar aplicativos, a melhor arquitetura quase nunca é escolher um único modelo para 100% do tráfego. Como ambos os modelos residem sob um saldo pré-pago único no GPT Proto, você pode rotear por etapa em vez de por fornecedor: envie inspeção visual de alta frequência, classificação de capturas de tela e correções de interface delimitadas para gpt-6.1-terra a US$ 0,80/US$ 4,00, e escale a síntese de código de vários arquivos para claude-sonnet-5-5 a US$ 1,80/US$ 9,00.
1. Verificação inicial de cURL (Chat Completions compatíveis com OpenAI)
Ambos os modelos podem ser chamados para análise de texto e visual por meio do endpoint unificado /v1/chat/completions compatível com OpenAI do GPT Proto, usando um token Bearer padrão. Alternar entre eles requer alterar apenas a string "model":
# Chamada 1: GPT-6.1 Terra (US$ 0,80 entrada / US$ 4,00 saída por 1 milhão de tokens no GPT Proto)
curl --fail-with-body https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-terra",
    "messages": [
      {
        "role": "user",
        "content": "Inspecione esta regra CSS e explique em duas frases por que ela causa um deslocamento de layout no celular: .hero-banner { width: 100%; height: auto; }"
      }
    ]
  }'

# Chamada 2: Claude Sonnet 5.5 (US$ 1,80 entrada / US$ 9,00 saída por 1 milhão de tokens no GPT Proto)
curl --fail-with-body https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "claude-sonnet-5-5",
    "messages": [
      {
        "role": "user",
        "content": "Escreva um auxiliar em TypeScript que valide assinaturas de webhook usando a Web Crypto API com comparação de tempo constante."
      }
    ]
  }'
2. Exemplo de roteador de etapas em Python para pipelines de frontend e aplicativos
Aqui está um padrão prático em Python usando o SDK openai padrão apontado para https://gptproto.com/v1. Neste fluxo de trabalho, a Etapa 1 usa gpt-6.1-terra para fazer a triagem de um relatório de erro de interface (onde o volume de tokens é alto e o diagnóstico visual/DOM é barato), e a Etapa 2 roteia dinamicamente o patch de código real para gpt-6.1-terra (para correções CSS de componente único isolado) ou claude-sonnet-5-5 (quando a triagem sinaliza uma alteração de estado entre arquivos ou quando o prompt se aproxima do limite de 272 mil tokens):
import os
import json
from openai import OpenAI

# Uma chave de API e saldo compartilhado entre os modelos OpenAI e Anthropic
client = OpenAI(
    api_key=os.environ["GPTPROTO_API_KEY"],
    base_url="https://gptproto.com/v1",
)

def triage_and_patch_ui_issue(dom_snapshot: str, screenshot_url: str, approx_tokens: int) -> dict:
    # Passo 1: Sempre execute a triagem visual/DOM no GPT-6.1 Terra ($0.80 / $4.00 por 1M)
    triage_response = client.chat.completions.create(
        model="gpt-6.1-terra",
        messages=[
            {
                "role": "system",
                "content": (
                    "Você é um agente de triagem de QA de frontend. Inspecione a captura de tela e o DOM. "
                    "Retorne um JSON com as chaves: 'root_cause', 'scope' ('isolated_css' ou 'multi_file_state'), "
                    "e 'target_files' (array de strings)."
                ),
            },
            {
                "role": "user",
                "content": [
                    {"type": "text", "text": f"Snapshot do DOM: {dom_snapshot}"},
                    {"type": "image_url", "image_url": {"url": screenshot_url}},
                ],
            },
        ],
        response_format={"type": "json_object"},
    )

    triage_data = json.loads(triage_response.choices[0].message.content)

    # Passo 2: Roteie pelo escopo da tarefa E pelo limite de faturamento de contexto longo de 272K
    # Se a correção afetar o estado de múltiplos arquivos OU exceder 272K tokens de entrada, escale para o Sonnet 5.5
    if triage_data.get("scope") == "multi_file_state" or approx_tokens > 272_000:
        selected_model = "claude-sonnet-5-5"
    else:
        selected_model = "gpt-6.1-terra"

    patch_response = client.chat.completions.create(
        model=selected_model,
        messages=[
            {
                "role": "user",
                "content": (
                    f"Diagnóstico da triagem: {json.dumps(triage_data)} | "
                    f"Gere um patch mínimo e pronto para produção para o DOM/componente: {dom_snapshot}"
                ),
            }
        ],
    )

    return {
        "triage": triage_data,
        "routed_to": selected_model,
        "patch": patch_response.choices[0].message.content,
    }

if __name__ == "__main__":
    sample_dom = "<div class='card-grid'><img src='/hero.webp' /><h2>Checkout</h2></div>"
    result = triage_and_patch_ui_issue(
        dom_snapshot=sample_dom,
        screenshot_url="https://example.com/cls-regression-frame.png",
        approx_tokens=12_000,
    )
    print(f"Patch roteado para: {result['routed_to']}")
    print(result["patch"])
Nota pré-implantação (teste de fumaça necessário): Verifique as strings exatas do modelo (gpt-6.1-terra e claude-sonnet-5-5) nos painéis de uso da API ao vivo nas páginas de modelos do GPT Proto antes de implantar loops faturáveis. Se o seu agente depender das ferramentas da API de Respostas nativas da OpenAI (apply_patch, shell hospedado ou chamadas de função async: true) ou dos parâmetros de pensamento adaptativo nativos da Anthropic /v1/messages (output_config.effort), execute um teste de fumaça rápido nos respectivos endpoints nativos do GPT Proto (/v1/responses e /v1/messages) para confirmar a passagem de parâmetros em sua rota.
Veredito: Qual você deve usar?
Se você deseja uma única tabela para colar em um documento de revisão de arquitetura, combine sua carga de trabalho principal com o modo de falha e o limite de faturamento que mais lhe interessam:
| Carga de trabalho / Cenário |
Modelo recomendado |
Configuração recomendada |
Por que vence |
| QA de captura de tela de alto volume, leitura de faturas/formulários e uso de computador via navegador |
GPT-6.1 Terra |
low ou medium effort |
Taxa de tokens GPT Proto 56% menor ($0,80/$4,00), conclusão de tarefa >3x mais rápida que o Sol/Astra e visão MMMU-Pro de nível Astra. |
| Depuração de UI de frontend (mudanças de layout CLS, Figma para CSS, regressões visuais) |
GPT-6.1 Terra |
medium effort |
Criado para inspeção visual + DOM; explicitamente testado em correções de mudança de layout de páginas da web. |
Classificação de baixa latência, roteamento ou extração de JSON onde temperature é necessária |
GPT-6.1 Terra |
reasoning.effort: "none" |
Restaura o nível none sem raciocínio que o GPT-6.1 Sol removeu, mantendo a latência e a contagem de tokens de saída mínimas. |
| Refatoração de backend de vários arquivos e alterações complexas de estado em TypeScript/React |
Claude Sonnet 5.5 |
medium ou high effort |
70,6% vs 50,3% no Terminal-Bench 4.0; agrupa chamadas de ferramentas em menos turnos, economizando tempo valioso de revisão do desenvolvedor. |
| Análise de repositório de contexto longo em solicitação única (300 mil a 900 mil tokens de entrada) |
Claude Sonnet 5.5 |
medium ou high effort |
O Terra aciona uma sobretaxa de 2x na entrada / 1,5x na saída acima de 272 mil tokens (saltando para $2,00 na entrada oficial), eliminando sua vantagem de preço. |
Codificação de terminal nativa da OpenAI mais profunda quando o max do Terra não é suficiente |
GPT-6.1 Sol |
medium effort |
Pontua 54 contra 48 do Terra no AA Coding Agent Index v2.0, e o Sol medium ($0,21/tarefa) é, na verdade, mais barato por tarefa do que o Terra `max` ($0,40/tarefa). |
Para resumir o veredito sem rodeios: inicie cada etapa repetível de visual, uso de computador e codificação delimitada no GPT-6.1 Terra em low ou medium effort para aproveitar a taxa de $0,80/$4,00, e mantenha o Claude Sonnet 5.5 nas etapas de codificação de vários arquivos e prompts com >272 mil tokens, onde sua maior precisão na primeira tentativa e o preço fixo de 1 milhão de tokens de contexto compensam. Para inserir suas próprias proporções mensais de entrada e saída, abra a calculadora de comparação GPT Proto e teste ambos os modelos lado a lado em um único saldo.