Alternativas à API da OpenAI em um relance
| Alternativa |
Melhor uso |
Abordagem de acesso |
Principal consideração de migração |
| GPT Proto |
Múltiplas famílias de modelos e acesso com desconto |
Plataforma de modelo unificada |
Confirme as capacidades do modelo e endpoint escolhidos |
| Anthropic Claude |
Fluxos de trabalho de codificação e agentes |
API de modelo direto |
Recursos nativos do Claude e compatibilidade de SDK diferem |
| Google Gemini |
Aplicações multimodais |
API de modelo direto |
Recursos avançados podem exigir integração nativa do Gemini |
| DeepSeek |
Cargas de trabalho de raciocínio com foco em orçamento |
API de modelo direto |
Inclua cache e precificação de pico versus fora de pico |
| Groq |
Aplicações sensíveis à velocidade |
Inferência hospedada |
Avalie a combinação de modelo e recurso suportada |
| Mistral |
Aplicações centradas em documentos |
Modelos mais APIs de documentos |
OCR, estado da conversa e inferência são preocupações separadas |
| OpenRouter |
Exploração de modelos e roteamento de provedores |
Gateway de múltiplos provedores |
Defina requisitos de roteamento e considere taxas da plataforma |
Como comparamos estas alternativas à API da OpenAI
Publicado pela GPT Proto, esta comparação utiliza documentação oficial, preços públicos e recursos de aplicação documentados verificados em 29 de outubro de 2026. As recomendações são julgamentos editoriais sobre a adequação ao fluxo de trabalho; nenhum benchmark de desempenho privado entre provedores foi realizado. Distinguimos APIs de modelos diretos de gateways e serviços de inferência porque eles substituem partes diferentes de uma configuração da OpenAI.
As 7 melhores alternativas à API da OpenAI
1. GPT Proto para acesso a múltiplos modelos e preços com desconto
O GPT Proto atende a uma equipe de SaaS cujo produto precisa de vários modelos: um para suporte de rotina, outro para codificação difícil e talvez geração separada de imagem ou vídeo. Seu catálogo de modelos reúne opções de texto, imagem, vídeo e áudio sob uma única conta, chave de API e saldo compartilhado.
Isso suporta uma migração gradual. Mantenha as solicitações de GPT que já funcionam, mova uma tarefa definida para o Claude ou DeepSeek e compare os resultados antes de alterar o restante da aplicação. Uma conta compartilhada reduz a configuração de faturamento e credenciais envolvida nessa avaliação.
Existe também uma opção direta para equipes que desejam manter o GPT. A página da API GPT-6.1 Sol lista US$ 1,60 de entrada e US$ 8 de saída por milhão de tokens, em comparação com as taxas padrão de US$ 2 e US$ 10 da OpenAI. Isso representa uma redução de 20% nessas taxas de token. O Claude Sonnet 5.5 está listado por US$ 1,80 e US$ 9, 10% abaixo das taxas padrão correspondentes da Anthropic.
Escolha o GPT Proto quando a escolha do modelo e o acesso consolidado forem as prioridades. Verifique a seção de Uso da API do modelo selecionado para interfaces e campos suportados; uma chave compartilhada não torna todos os modelos ou endpoints de mídia intercambiáveis. Manter o GPT através de outro provedor também preserva a dependência da família de modelos GPT.
2. Anthropic Claude para codificação e fluxos de trabalho de agentes
O Claude deve estar na sua lista de opções quando o aplicativo passa a maior parte do tempo editando código, analisando documentos ou decidindo qual ferramenta usar em seguida. Comece com o Sonnet para codificação diária e trabalho de agentes, avalie o Opus para tarefas mais exigentes e considere o Haiku para classificação, extração ou roteamento repetitivos.
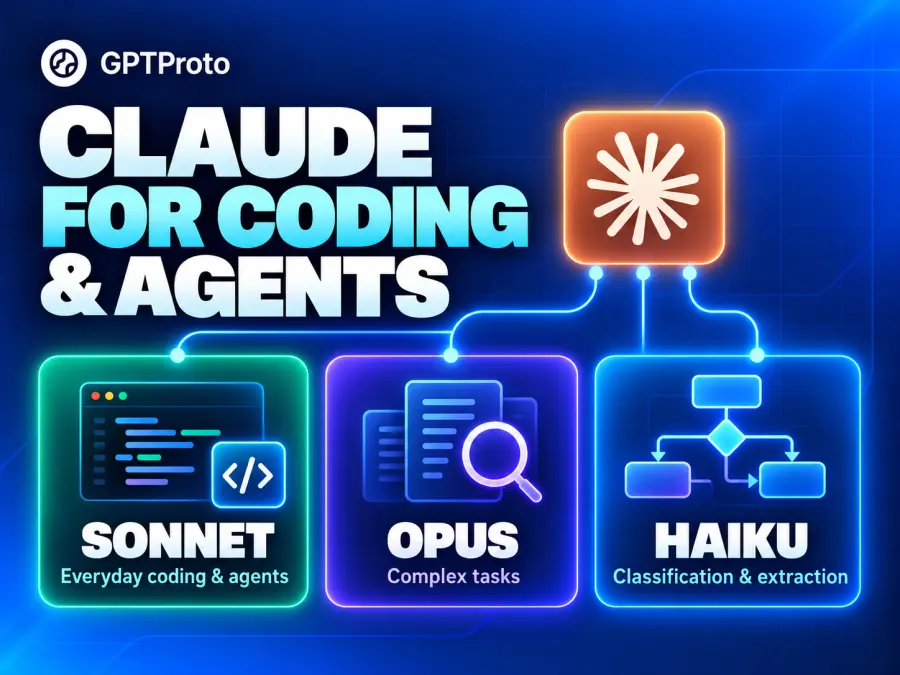
Por exemplo, um agente de suporte pode usar um modelo leve para categorizar solicitações e reservar um modelo mais robusto para investigar um problema técnico complexo. A precificação de modelos da Anthropic torna esses níveis visíveis: o Sonnet 3.5 custa US$ 2 de entrada e US$ 10 de saída por milhão de tokens, enquanto o Haiku 3.5 começa em US$ 0,10 e US$ 0,50 para prompts de até 100 mil tokens de entrada.
A migração exige atenção à interface. A documentação de compatibilidade do SDK da OpenAI da Anthropic afirma que a camada de compatibilidade ignora o campo strict do esquema de ferramentas. Aplicativos que dependem de validação estrita devem avaliar o suporte a saída estruturada da API nativa do Claude.
Use a coleção de modelos Claude no GPT Proto para comparar as rotas disponíveis. O Claude é uma alternativa baseada em capacidades; escolher o Sonnet em sua taxa padrão oficial não reduz automaticamente a fatura em relação ao GPT-4o.
3. Google Gemini para aplicativos multimodais
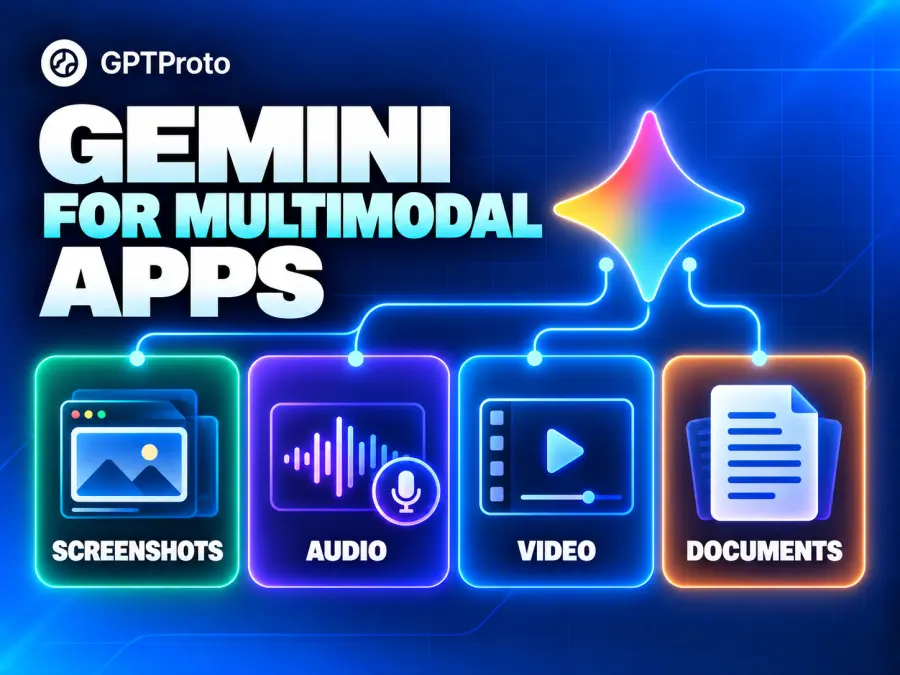
O Gemini é um candidato útil para produtos que combinam texto com capturas de tela, áudio gravado, vídeo ou documentos. Um aplicativo de aprendizado que analisa a gravação de um aluno e uma ferramenta de suporte que interpreta capturas de tela precisam de mais do que apenas geração de texto.
O Google documenta a compatibilidade com o SDK da OpenAI, incluindo a alteração da URL base, chave e modelo para solicitações suportadas. Isso pode simplificar uma avaliação inicial. Sua orientação de integração também explica que recursos avançados do Gemini e ferramentas do lado do servidor podem precisar de tratamento adicional ou integração nativa.
Selecione o modelo de acordo com os requisitos reais de entrada e saída. Um modelo Flash-Lite pode ser uma opção econômica para processamento mais simples, enquanto uma API Live separada lida com a interação em tempo real. O acesso a um endpoint de texto do Gemini não estabelece suporte para todos os produtos Gemini.
Navegue pelos modelos do Google no GPT Proto ou inspecione o Gemini 1.5 Flash para ver suas entradas multimodais listadas. O Google também oferece níveis gratuitos para modelos selecionados, com limites e termos de uso de dados diferentes do acesso pago, conforme mostrado em sua documentação de precificação.
4. DeepSeek para cargas de trabalho de raciocínio com foco em orçamento
Vale a pena avaliar o DeepSeek para análise repetida de documentos, assistência em codificação e tarefas de raciocínio onde os custos de tokens se acumulam rapidamente. É particularmente relevante quando as solicitações reutilizam uma entrada substancial ou podem ser executadas fora dos horários de pico.
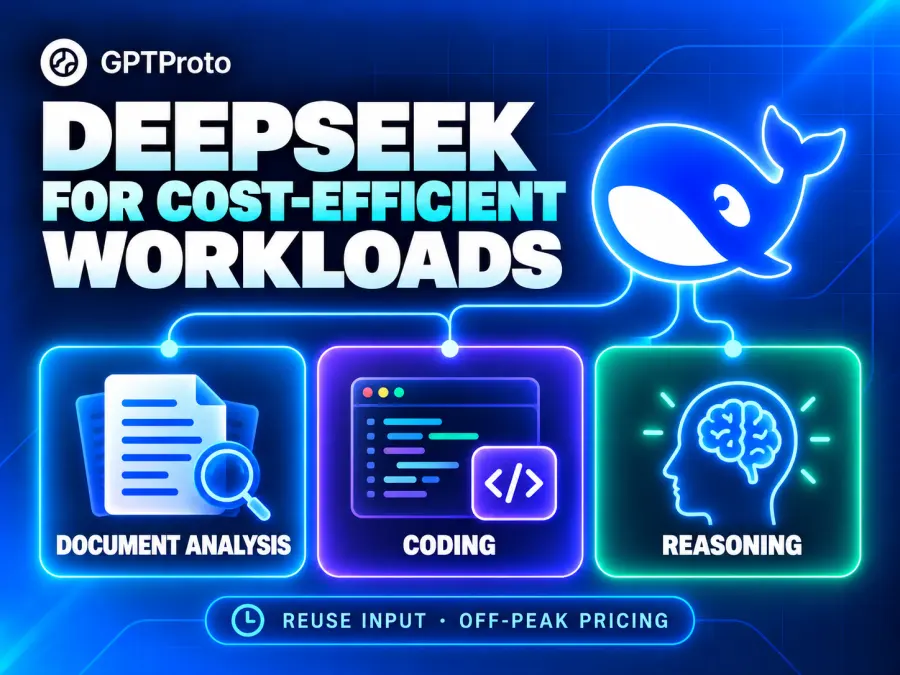
A tabela de preços oficial do DeepSeek lista o Flash a US$ 0,30 por milhão de tokens de entrada não armazenados em cache e US$ 1,20 por milhão de tokens de saída durante os períodos de pico. As taxas fora do horário de pico são de US$ 0,15 e US$ 0,60. A entrada em cache possui uma taxa separada e menor, portanto, um fluxo de trabalho de documento recorrente pode ter uma economia diferente de prompts curtos e não relacionados.
O guia da API do DeepSeek documenta o acesso compatível com OpenAI e Anthropic. Use o identificador de modelo exato para o serviço escolhido; a compatibilidade com um formato de solicitação ainda deixa o comportamento do modelo e o tratamento de ferramentas para validação.
A página da API do DeepSeek Flash fornece uma rota de acesso GPT Proto. Para uma lista mais ampla, compare os principais provedores de LLM chineses ou explore LLMs chineses para codificação.
Suas taxas baixas justificam uma avaliação, mas não o tornam mais barato do que todos os modelos pequenos da OpenAI.
5. Groq para aplicativos sensíveis à velocidade
O Groq é uma opção para aplicativos onde os usuários aguardam diretamente pela saída gerada: assistentes interativos, recursos de resposta curta e fluxos de trabalho com várias chamadas de modelo sequenciais. Seu valor depende de encontrar um modelo suportado que atenda aos requisitos de qualidade da tarefa.
Use a documentação de modelos suportados do Groq para verificar disponibilidade, limites e especificações de serviço publicadas. Meça o tempo até a primeira resposta útil e o tempo total do fluxo de trabalho em seu aplicativo; o número de velocidade de geração de um fornecedor não inclui todos os atrasos de rede ou de ferramentas.
O Groq fornece acesso compatível com OpenAI, com campos não suportados documentados. Ele também possui uma API de Respostas, mas a documentação diz que os aplicativos devem manter e reenviar o histórico da conversa por conta própria.
Escolha o Groq quando a velocidade de resposta for um requisito significativo do produto e o modelo disponível for adequado. Se o aplicativo existente depender fortemente de conversas armazenadas, inclua o gerenciamento de estado na estimativa de migração. Substituir o serviço de hospedagem e substituir o desenvolvedor do modelo são decisões separadas.
6. Mistral para aplicativos centrados em documentos
O Mistral vale a pena ser considerado para aplicativos criados em torno de recebimento, extração e resposta a perguntas sobre documentos. Uma ferramenta de processamento de faturas, por exemplo, precisa de uma extração de texto confiável antes de poder classificar um documento ou explicar uma discrepância.
Seu catálogo de API e preços distinguem modelos gerais de serviços de OCR. Isso ajuda as equipes a estimar a extração e a geração separadamente, em vez de tratar todo o pipeline de documentos como uma única solicitação de chat.
O guia de migração do Mistral cobre Chat Completions no estilo OpenAI. Sua API de Respostas oferece suporte a geração de texto, entradas de arquivos e imagens, chamadas de função e streaming. No momento da análise, ela está em visualização pública e é stateless: seu aplicativo fornece o histórico da conversa.
O Mistral é um candidato sensato quando o processamento de documentos é central para o produto. Avalie a saída da extração, a qualidade das respostas subsequentes e o custo de ambas as etapas. Uma migração de chat funcional por si só não valida um fluxo de trabalho completo de processamento de documentos.
7. OpenRouter para roteamento de provedores e exploração de modelos
O OpenRouter atende equipes que desejam comparar modelos e controlar quais provedores subjacentes atendem às suas solicitações. Ele também pode ajudar quando um aplicativo precisa de uma estratégia explícita de provedor de backup.
O roteamento introduz suas próprias escolhas. Decida se as solicitações podem transitar entre provedores, se todos os parâmetros solicitados devem ser suportados e quais requisitos de tratamento de dados se aplicam. O OpenRouter expõe preferências de provedor, configurações de fallback e controles de suporte a parâmetros; essas configurações merecem atenção quando um aplicativo depende de um recurso específico.
Para uma avaliação inicial, mantenha o provedor e o modelo fixos para que as mudanças nos resultados sejam mais fáceis de investigar. Em seguida, teste a configuração de fallback pretendida, incluindo falhas e diferenças nos relatórios de uso. Taxas de compra de crédito e quaisquer cobranças BYOK aplicáveis também devem fazer parte da estimativa de custos.
Escolha o OpenRouter quando controles de roteamento forem um requisito principal. Nossa comparação de provedores de API de LLM explica como gateways, plataformas gerenciadas e especialistas em inferência diferem.
Quais alternativas à API da OpenAI são realmente mais baratas
Existem duas decisões de custo distintas. Você pode manter o mesmo modelo através de um provedor de acesso diferente ou alterar o modelo que realiza o trabalho. A primeira opção oferece uma comparação direta de preço por token. A segunda exige uma avaliação de qualidade juntamente com a fatura.
O exemplo abaixo assume 10 milhões de tokens de entrada não armazenados em cache e 2 milhões de tokens de saída faturados por mês. É um cenário de uso calculado, não um benchmark de qualidade de tarefa equivalente. A saída faturada inclui tokens de raciocínio quando o provedor os cobra como saída. Taxas de ferramentas, impostos, gravações em cache e descontos por lote estão excluídos.
| Modelo e rota de acesso |
Entrada por 1M |
Saída por 1M |
Custo do exemplo |
| GPT-6.1 Sol via OpenAI Standard |
$2.00 |
$10.00 |
$40.00 |
| GPT-6.1 Sol via GPT Proto |
$1.60 |
$8.00 |
$32.00 |
| GPT-6 Luna via OpenAI Standard |
$0.10 |
$0.50 |
$2.00 |
| Haiku 5.5 direto, prompts até 100K |
$0.10 |
$0.50 |
$2.00 |
| DeepSeek Flash direto, pico |
$0.30 |
$1.20 |
$5.40 |
| DeepSeek Flash direto, fora de pico |
$0.15 |
$0.60 |
$2.70 |
| Gemini 3.1 Flash-Lite direto, texto padrão |
$0.25 |
$1.50 |
$5.50 |
As taxas provêm da página de preços da OpenAI, da página do Sol da GPT Proto e das páginas de preços da Anthropic, DeepSeek e Google vinculadas acima.
O exemplo do Sol economiza $8, ou 20%, no volume de tokens declarado. As linhas de modelos leves mostram por que uma alternativa deve ser comparada com o modelo da OpenAI que você realmente precisa. Um modelo pequeno da OpenAI pode custar menos do que uma alternativa mais capaz.
O limite de 100K do Haiku aplica-se à entrada de cada solicitação, não ao volume mensal. As duas linhas da DeepSeek assumem que todo o uso ocorre dentro do período de preços declarado; tráfego misto produz uma fatura combinada. Tokenizadores, esforço de raciocínio e novas tentativas também podem alterar quantos tokens uma tarefa consome. Para cargas de trabalho de agentes, compare APIs de LLM acessíveis por adequação à tarefa e, em seguida, acompanhe o custo por resultado aceito.
Quanto da sua integração com a OpenAI você pode manter
Comece identificando as interfaces e comportamentos que o aplicativo utiliza. Uma solicitação de saudação bem-sucedida revela muito pouco sobre um agente que utiliza ferramentas.
| Dependência existente |
Verificar antes da migração |
Possível alteração no aplicativo |
| Chat e streaming |
Campos de solicitação, formato de evento, encerramento |
Configuração do cliente ou analisador de resposta |
| Chamada de ferramenta |
Argumentos, resultados de ferramentas, turno de acompanhamento |
Adaptador de ferramenta e validação |
| Saída estruturada |
Regras de esquema aplicadas e casos de falha |
Alterações de esquema e verificações no lado do aplicativo |
| Conversas armazenadas |
Armazenamento e recuperação de histórico |
Persistência e reprodução de histórico |
| Arquivos ou ferramentas integradas |
Recurso equivalente e faturamento |
Recuperação separada ou serviço de ferramenta |
O relato de um desenvolvedor sobre a portabilidade de saída estruturada descreve restrições sendo tratadas de forma diferente entre os provedores. Considere isso como a experiência de um profissional e, em seguida, verifique seu esquema exato em relação à documentação e às respostas atuais.
Execute solicitações representativas através da integração candidata: tráfego normal, entradas longas, uma ferramenta com falha e uma saída que viole o formato esperado. Registre os resultados aceitos, o uso faturado, o tempo de resposta e as tentativas de repetição. Para aplicativos de codificação, execute também a alteração gerada através das verificações do próprio projeto.
Mantenha uma maneira de retornar o tráfego para a configuração anterior enquanto avalia a substituição. Se você ainda está escolhendo uma plataforma geral para um novo produto, o guia de API de IA para desenvolvedores mais abrangente cobre essa decisão.
Alternativas às APIs de Realtime Assistants e Moderation da OpenAI
Alternativas à API Realtime da OpenAI
Gemini Live API é uma candidata para interação de voz e visão em tempo real. Avalie o tratamento de interrupções, formatos de áudio, comportamento da sessão e tempo de resposta de voz. Um pipeline que combina reconhecimento de fala, um LLM e síntese de fala é outra arquitetura, mas seus estágios separados adicionam trabalho de integração e latência. Texto transmitido comum não é um substituto equivalente para uma sessão de áudio ao vivo.
Alternativas à API Assistants da OpenAI para Agentes de Produção
A API Assistants foi descontinuada em 26 de agosto de 2026, de acordo com o guia de migração da OpenAI. As equipes que permanecerem com a OpenAI devem seguir seu caminho de migração de Respostas.
Para um design independente de provedor, combine uma API de modelo escolhida com um runtime de orquestração como o LangGraph. Seus componentes de estado e checkpoint podem suportar fluxos de trabalho persistentes, mas sua equipe ainda precisa implementar a execução de ferramentas, recuperação, armazenamento e recuperação. Alternar o endpoint do modelo não migra essas responsabilidades nem recria threads antigas automaticamente.
Alternativas à API de Moderação da OpenAI para Aplicativos de Chat
O Azure AI Content Safety oferece análise de texto e imagem para conteúdo potencialmente prejudicial. Compare categorias suportadas, idiomas, limites, tempos de resposta e falsos positivos nos exemplos do seu aplicativo.
A moderação é uma seleção separada do modelo de conversação. Para chats criativos ou roleplay, nossa comparação de APIs de LLM sem censura aborda o comportamento do modelo; um aplicativo ainda precisa tomar suas próprias decisões sobre qual conteúdo permitir e como aplicá-las.
Como testar alternativas à API da OpenAI no GPT Proto
Comece com uma carga de trabalho que você possa avaliar de forma consistente, como responder a perguntas de suporte ou extrair campos de um documento.
Escolha um modelo. Abra o catálogo do GPT Proto e compare as opções relevantes de Claude, Gemini ou DeepSeek.
Abra as instruções de configuração do modelo. Use a opção "Experimentar este modelo" (Try This Model) onde disponível, ou a seção de Uso da API. Copie as instruções específicas do modelo para o seu assistente de codificação ou siga o exemplo exibido.
Configure a integração. Crie uma chave de API do GPT Proto e use o ID do modelo, o endpoint e o formato de solicitação mostrados nessa página. Mantenha as credenciais na configuração secreta do aplicativo.
Avalie um pequeno conjunto de solicitações. Compare resultados úteis, uso faturado e tempo de resposta antes de expandir o tráfego. Teste ferramentas necessárias e saídas estruturadas separadamente.