Os melhores modelos LLM chineses em um relance
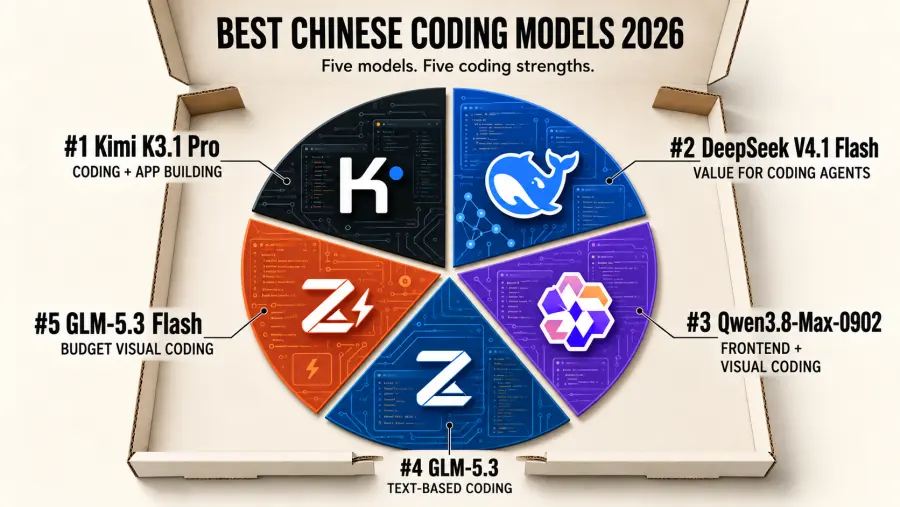
| Classificação |
Modelo |
Uso recomendado |
Principal compensação |
| 1 |
Kimi K3.1 Pro |
Codificação difícil, criação de aplicativos e tarefas estendidas de agentes |
Taxas de token mais altas do que as opções econômicas |
| 2 |
DeepSeek V4.1 Flash |
Agentes de codificação com foco em custo e trabalho de implementação repetitivo |
Confirme o checkpoint servido antes de aplicar os resultados do benchmark 1017 |
| 3 |
Qwen3.8-Max-0902 |
Implementação de frontend e depuração visual |
Taxas de token mais altas do que DeepSeek e GLM Flash |
| 4 |
GLM-5.3 |
Investigação de repositório baseada em texto e tarefas de terminal |
Evidência visual nativa requer outra rota |
| 5 |
GLM-5.3 Flash |
Codificação visual econômica e subtarefas frequentes de agentes |
Teste tarefas difíceis antes de torná-lo o único modelo de produção |
A comparação de preços aparece abaixo. Manter o preço separado da capacidade torna mais fácil ver por que um modelo mais caro ainda pode valer a pena ser testado para uma tarefa específica.
As medições de velocidade vêm da API de cada criador de modelo, conforme medido pela Artificial Analysis. Elas são instantâneos úteis, não garantias de latência para o GPT Proto. A carga do provedor, o tamanho do prompt, o esforço de raciocínio, o comportamento do cache e o tamanho da saída podem alterar o desempenho em produção.
A coluna de modalidade descreve as rotas expostas pelo GPT Proto. Um checkpoint para download e uma API hospedada com um nome semelhante podem não expor recursos idênticos.
Como classificamos os modelos chineses de programação
Uma contagem grande de parâmetros ou uma janela de contexto de um milhão de tokens não diz se um modelo consegue concluir uma tarefa de repositório. Todos os cinco modelos neste ranking estão aproximadamente na mesma categoria de contexto longo. Suas diferenças práticas aparecem em outros aspectos.
Consideramos seis perguntas:
Como o modelo se comporta em avaliações independentes, em vez de apenas nos gráficos de benchmark do desenvolvedor?
Ele consegue sustentar a codificação de vários arquivos, trabalho no terminal, chamadas de ferramentas e ciclos de planejar-executar-verificar?
Ele consegue inspecionar capturas de tela, diagramas, documentos ou fluxos de produto gravados quando a evidência não é apenas em texto?
Qual é o custo real de uma tarefa de API após incluir tokens de saída, raciocínio e prováveis novas tentativas?
Os pesos do modelo são realmente baixáveis e qual licença rege a implementação comercial?
Existe uma rota GPT Proto ativa que os leitores possam testar através da mesma conta e formato de API?
O atual ranking da Artificial Analysis lista pontuações do Índice de Inteligência de 46 para o Kimi K3.1 Pro, 34 para o Qwen3.8 Max 0902 e 32 para cada um dos modelos DeepSeek V4.1 Flash 1017 em raciocínio máximo e GLM-5.3 em raciocínio máximo. O índice é uma medida ampla de capacidade. Ele não mede diretamente o custo de corrigir um bug no seu aplicativo.
Essas pontuações pertencem ao Índice de Inteligência v5.0. Não as combine com versões anteriores do índice nem interprete uma mudança entre versões de avaliação como um declínio no próprio modelo. Também evitamos atribuir ao GLM-5.3 Flash uma pontuação de índice antiga quando o ranking atual não exibe um valor comparável.
Os resultados de codificação podem apontar para direções diferentes. Na comparação entre DeepSeek e GLM da Artificial Analysis, o GLM lidera o Terminal-Bench 4.0, enquanto o DeepSeek lidera o FrontierCode 2.0. Essa divisão é o motivo pelo qual esta lista inclui recomendações específicas para cada tarefa e atribui um papel ao custo na ordem.
1. Kimi K3.1 Pro: O melhor candidato geral para programação
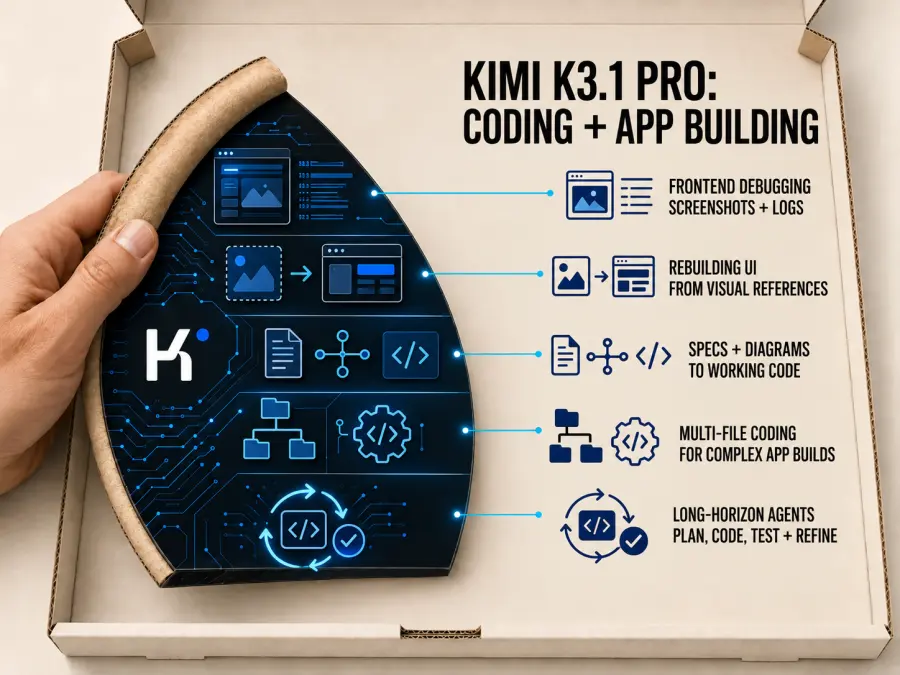
O Kimi K3.1 Pro assume o primeiro lugar porque o novo lançamento traz evidências mais sólidas para trabalhos de software extensos e complexos. O blog técnico da Moonshot relata 65,7% no Terminal-Bench 4.0 e 61,2% no seu Kimi Code Bench 3.0 Long-horizon interno, em comparação com os 55,95% do K3 neste último. Estes são resultados reportados pelo fornecedor.
Existe também um sinal independente: a Artificial Analysis registra aproximadamente 67% no Terminal-Bench 4.0. Esse resultado pertence à sua configuração de avaliação; ele deve permanecer separado do número da Moonshot.
Eu testaria o K3.1 Pro primeiro quando um agente precisar entender um aplicativo desconhecido, alterar vários arquivos conectados e continuar trabalhando após um teste falho. Para desenvolvedores de aplicativos, a pergunta útil é se ele consegue entregar um recurso que atenda ao briefing após a implementação e correção.
Sua rota GPT Proto aceita entrada de texto e visual. Isso o torna um candidato para trabalhos que combinam código-fonte, uma referência de design e uma interface renderizada. Ainda vale a pena começar com uma tarefa delimitada: defina o comportamento esperado e dê ao agente uma maneira de verificá-lo.
A conta de tokens mais alta é o contraponto. Reserve-o para trabalhos onde a melhoria na qualidade da conclusão possa justificar a despesa. Mantenha também o status de implantação preciso: a partir desta atualização, a Moonshot programa o lançamento dos pesos completos do K3.1 Pro para 4 de novembro. Os pesos existentes do K3 não estabelecem que o K3.1 Pro já esteja disponível para download.
Veredito: Comece com o Kimi K3.1 Pro para um recurso difícil ou construção de aplicativo, depois compare as alterações aceitas e o gasto total com um candidato mais barato.
2. DeepSeek V4.1 Flash: O melhor custo-benefício para agentes de programação
O DeepSeek merece uma posição mais alta quando o objetivo é manter uma capacidade de programação útil dentro de um orçamento de produção repetível. É um candidato para agentes que leem código, propõem patches, inspecionam a saída de testes e fazem uma nova tentativa.
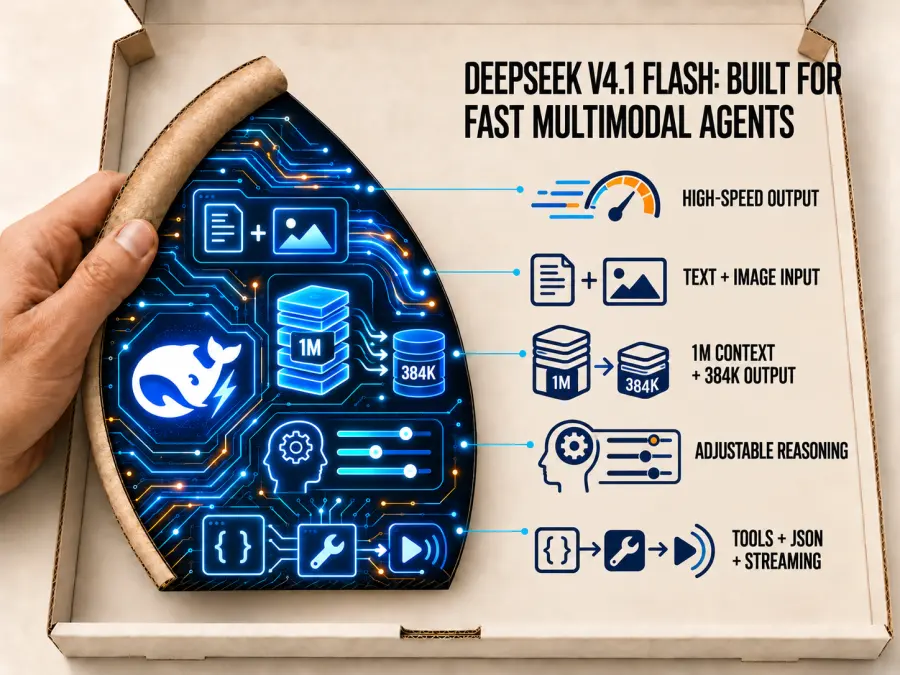
O card do modelo DeepSeek V4.1 Flash 1017 relata melhorias em relação ao lançamento anterior do V4.1 Flash: o Terminal-Bench 4.0 sobe de 31,2 para 42,3, o DeepSWE v1.1 de 74,2 para 77,0 e o ProgramBench de 20,3 para 29,1. Estas são avaliações reportadas pela DeepSeek, e não uma reprodução do GPT Proto.
Essa atualização fortalece o argumento para incluir o DeepSeek em um teste de programação. Isso não torna todos os outros modelos redundantes. Avaliações de programação independentes ainda mostram vencedores diferentes dependendo da tarefa, e um agente de produção deve ser julgado pelas ferramentas e limites que realmente usará.
Mantenha a distinção de rota explícita. O GPT Proto expõe o DeepSeek Flash usando deepseek-flash; sua página pública descreve o V4.1 Flash sem identificar o checkpoint 1017. Confirme a revisão implantada antes de tratar os resultados mais recentes como evidência sobre esse endpoint exato.
Veredito: Teste o DeepSeek como o modelo de implementação focado em custo-benefício. Registre a revisão do modelo juntamente com a taxa de sucesso, novas tentativas, latência e gastos, para que uma atualização de alias posterior não torne a comparação ambígua.
3. Qwen3.8-Max-0902: A melhor opção para frontend e depuração visual
O Qwen continua sendo uma escolha útil quando uma tarefa de codificação começa com algo visível: uma página de referência, um layout quebrado, um gráfico ou uma sequência de estados de interface. A rota Qwen3.8-Max-0902 suporta entrada multimodal, permitindo que um aplicativo combine material visual com código e instruções.
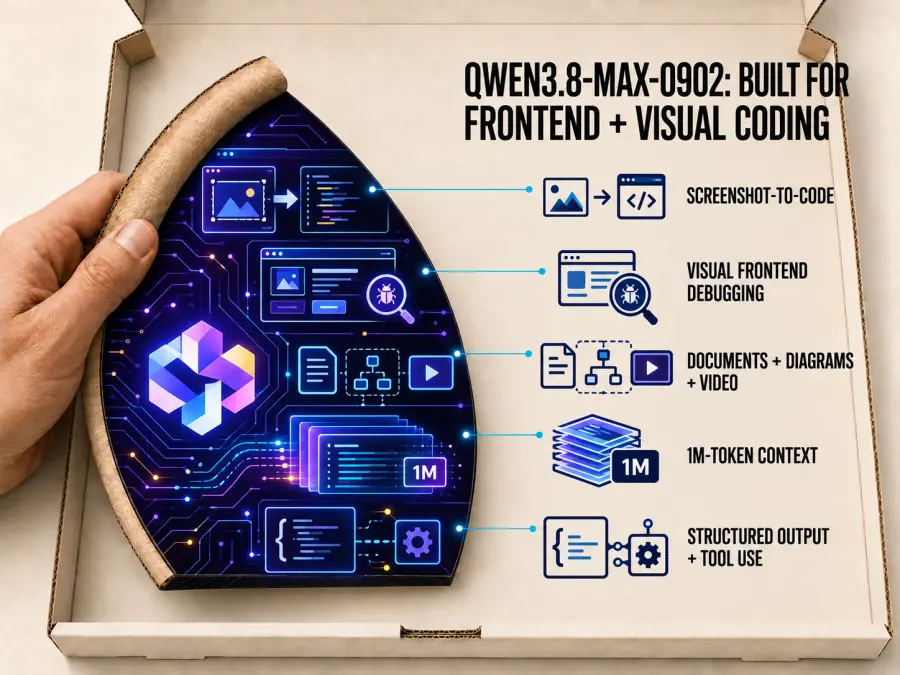
Para uma avaliação de frontend, forneça a ele a mesma referência de design e acesso ao repositório que os outros candidatos. Peça ao agente para implementar a página, renderizá-la, verificar os estados importantes e corrigir o resultado. Avalie o espaçamento, a hierarquia, a responsividade e as interações funcionais, além da correção do código.
É por isso que o Qwen mantém um lugar dedicado aqui, mesmo após a atualização do Kimi. Uma seleção de frontend precisa de critérios de aceitação visual, e uma pontuação de inteligência geral descreve apenas parcialmente esse trabalho. Esta é a nossa recomendação de fluxo de trabalho; não é uma afirmação de que o Qwen venceu um novo teste de frontend com cinco modelos.
O equilíbrio de custos é direto: suas taxas de tokens exibidas são mais altas que as do DeepSeek e do GLM Flash. Para um pequeno patch apenas de texto, inclua uma dessas rotas mais baratas no teste. Além disso, mantenha o snapshot hospedado 0902 exato separado de qualquer checkpoint para download relacionado ao documentar recursos.
Veredito: Coloque o Qwen na lista de finalistas quando a correspondência com um briefing visual for fundamental para o sucesso da implementação.
4. GLM-5.3: A melhor opção para trabalho em repositórios baseado em texto
O GLM-5.3 continua relevante para investigação de código, tarefas de terminal e alterações cujas evidências estão disponíveis como texto. O ranking atualizado dá ao Kimi a recomendação geral, mantendo o GLM como um candidato focado em codificação.
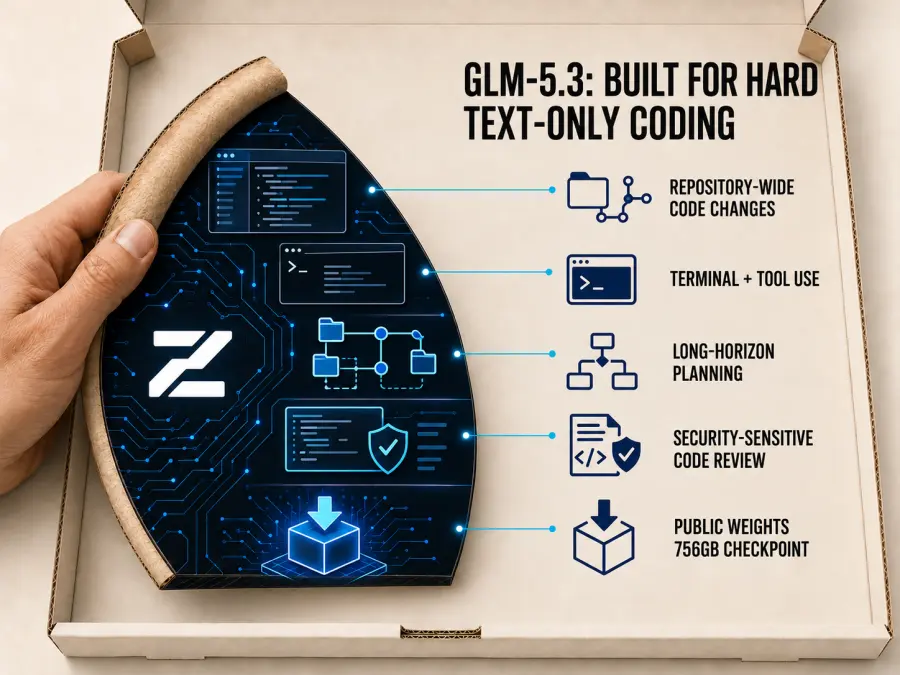
A comparação independente entre DeepSeek e GLM ilustra sua posição: o GLM pontua 42% no Terminal-Bench 4.0 contra 34% do DeepSeek 1017, enquanto o FrontierCode 2.0 favorece o DeepSeek, 28% a 22%. Esses resultados descrevem a configuração daquele avaliador, portanto, não devem ser substituídos pelas execuções configuradas de forma diferente dos fornecedores.
Eu manteria o GLM em um teste envolvendo uma integração de backend com falha, uma dependência desconhecida ou uma alteração de repositório que exija vários ciclos de comando e teste. Os critérios de aceitação devem incluir um teste de reprodução bem-sucedido e uma explicação do que foi alterado.
A página do GPT Proto GLM-5.3 documenta entrada e saída de texto. Se o agente precisar inspecionar uma captura de tela diretamente, use uma rota visual para essa etapa. Suas taxas de tokens mais altas do que as dos modelos econômicos também tornam as novas tentativas repetidas dignas de medição.
Veredito: Mantenha o GLM-5.3 para fluxos de trabalho de repositório e terminal onde ele passa em seus testes consistentemente. Compare-o com o Kimi para tarefas difíceis e com o DeepSeek para questões de custo.
5. GLM-5.3 Flash: O melhor candidato de baixo custo para codificação visual
O GLM-5.3 Flash mantém seu lugar porque chamadas frequentes de agentes podem fazer com que as taxas de tokens sejam mais importantes do que uma pequena diferença na capacidade principal. Ele possui as taxas de entrada e saída mais baixas exibidas entre estas cinco entradas do GPT Proto no resumo de preços abaixo.
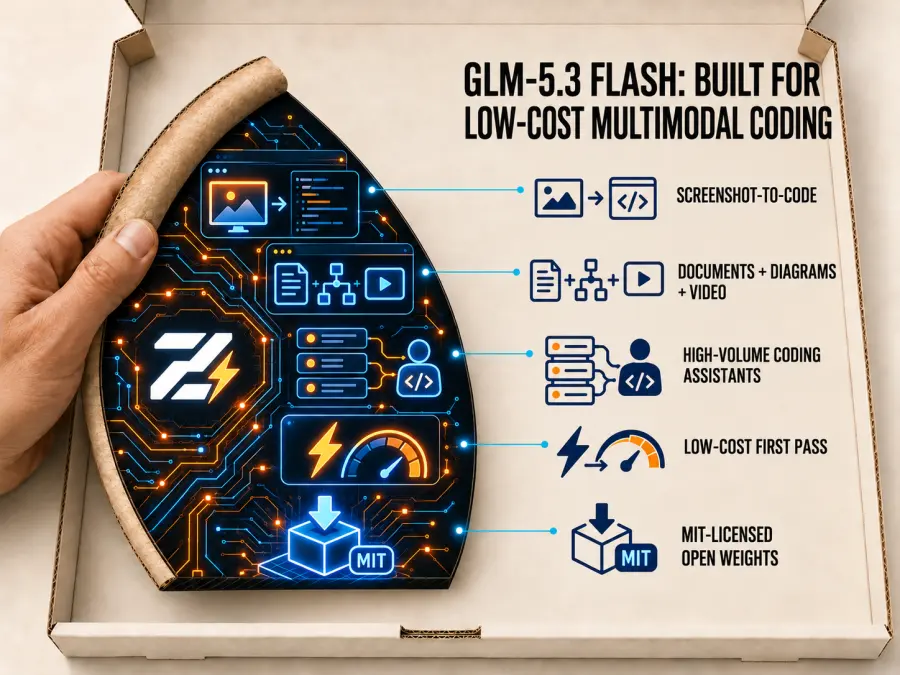
A página do modelo documenta entradas de texto, imagem, vídeo e arquivo, juntamente com pesos licenciados pelo MIT. Ela também explica que o Flash usa uma base multimodal diferente do GLM-5.3 padrão. Trate os dois como candidatos separados ao criar uma política de roteamento.
Uma avaliação prática atribuiria ao Flash um problema delimitado, uma verificação de layout visual ou uma implementação inicial. Mantenha os mesmos testes de aceitação usados para os modelos maiores. Se o resultado falhar, conte a tentativa falha e a escalada no custo total.
Taxas baixas deixam espaço para iteração, mas tentativas repetidas e improdutivas podem apagar essa vantagem. Meça a frequência com que a tarefa é bem-sucedida antes de escolhê-lo como padrão. O raciocínio está sempre ativado no modelo documentado, portanto, inclua o uso de tokens de raciocínio e o tempo de resposta nessa verificação.
Veredito: Teste o GLM-5.3 Flash como o padrão de baixo custo para codificação visual e subtarefas recorrentes, com um caminho de escalonamento claro para falhas.
Menções honrosas
MiniMax M3.1 Flash
O candidato atual da MiniMax merece atenção além da entrada M3 mais antiga. O anúncio de lançamento de 19 de outubro relata 73,7% no DeepSWE v1.1 e enfatiza a execução de agentes com menor custo. Isso torna o M3.1 Flash relevante para a mesma discussão de orçamento que o DeepSeek e o GLM Flash.
Mantenha-o na lista de pesquisa até que a rota exata do GPT Proto, o ID do modelo, o preço e os recursos suportados sejam confirmados. Um endpoint existente do MiniMax M3 não deve ser rotulado como M3.1 Flash sem verificação.
Xiaomi MiMo-V2.6 e outros modelos emergentes
Vale a pena monitorar o MiMo-V2.6; a Artificial Analysis inclui o MiMo-V2.6-Pro em suas avaliações. Dê a um novo modelo uma posição na lista principal após verificar tanto as evidências da tarefa quanto o caminho de acesso real que está sendo recomendado.
Implantações mais antigas do Kimi K3 e do DeepSeek V4 Pro ainda podem valer a pena quando um aplicativo depende de comportamento validado. Teste uma substituição nessas mesmas tarefas antes de mover o tráfego existente.
Modelos para observar
O Step 5 Preview e a família MiMo-V2.6 da Xiaomi são novos modelos chineses relevantes, mas não estão incluídos no ranking principal porque o GPT Proto não tinha rotas ativas confirmadas para eles no momento desta atualização. Adicione-os à lista classificada somente após a página exata do modelo, a string da API, o preço e os campos de solicitação suportados estarem ativos e testados.
Uma Tarefa de Programação Real, Cinco Escolhas Diferentes
Considere adicionar cobrança de assinatura a um aplicativo SaaS TypeScript existente. O agente deve entender o modelo de usuário atual, implementar um fluxo de checkout, lidar com eventos de webhook com segurança, atualizar as permissões da conta e verificar o resultado.
| Requisito |
Candidato para avaliação |
O que verificar |
| Implementar o recurso conectado em vários arquivos |
Kimi K3.1 Pro |
Comportamento correto, alterações coerentes e recuperação após testes com falha |
| Executar tentativas repetidas de implementação e correção |
DeepSeek V4.1 Flash |
Correções aceitas por dólar; registrar a revisão fornecida |
| Corresponder a interface de cobrança a uma referência de design |
Qwen3.8-Max-0902 |
Precisão visual, comportamento responsivo e estados de funcionamento |
| Diagnosticar falhas de backend e de terminal |
GLM-5.3 |
Qualidade de reprodução, uso de comandos e resultados de testes |
| Lidar com implementação limitada ou verificações visuais de baixo custo |
GLM-5.3 Flash |
Taxa de falha, novas tentativas e custo, incluindo escalonamentos |
Para este exemplo, um botão de checkout com boa aparência é apenas uma parte do resultado. O webhook deve ser verificado, eventos duplicados não devem conceder benefícios duplicados e as alterações de assinatura devem atualizar a conta correta. Escreva esses testes de aceitação antes de comparar os modelos.
Quanto Custaria a Mesma Tarefa de Programação?
Para uma comparação simples de custo por token, assuma 100.000 tokens de entrada não armazenados em cache e 20.000 tokens de saída faturáveis por tentativa. O seguinte utiliza os painéis de preços exibidos pelo GPT Proto verificados em 29 de outubro de 2026. As taxas são em USD por milhão de tokens; não são assumidas economias com cache ou fora do horário de pico.
| Modelo |
Entrada / 1M |
Saída / 1M |
Custo ilustrativo de tokens |
| Kimi K3.1 Pro |
$2,00 |
$10,00 |
$0,4000 |
| DeepSeek Flash |
$0,24 |
$0,96 |
$0,0432 |
| Qwen3.8-Max-0902 |
$1,40 |
$4,20 |
$0,2240 |
| GLM-5.3 |
$1,19 |
$3,74 |
$0,1938 |
| GLM-5.3 Flash |
$0,1275 |
$0,425 |
$0,02125 |
O cálculo é 0,1 × taxa de entrada + 0,02 × taxa de saída. A linha do DeepSeek precifica a rota exibida pelo GPT Proto; ela não estabelece o checkpoint servido por esse alias.
Estas são cobranças ilustrativas de tokens. A saída real deve incluir o raciocínio faturável quando aplicável, e uma tarefa completa pode envolver mais turnos, resultados de ferramentas, novas tentativas ou outro modelo. Verifique o painel de preços ao vivo ao planejar os gastos.
Meça o gasto total da API dividido pelas alterações que passam nos seus testes de aceitação. Isso oferece uma comparação mais útil do que assumir que cada modelo completa a tarefa com o mesmo número de tokens.
Por que o vencedor do benchmark pode não ser o melhor agente de programação
Seu agente de programação controla quais arquivos o modelo vê, como as ferramentas são chamadas, quando os testes são executados e o que acontece após uma falha. Alterar essa configuração pode mudar o resultado, mesmo quando o modelo permanece o mesmo.
Antes de comparar candidatos, mantenha constantes o repositório, as instruções da tarefa, as ferramentas, os testes de aceitação e o limite de tempo. Permita que cada modelo use o formato de solicitação que ele exige e registre suas configurações de raciocínio. Em seguida, meça as tarefas concluídas, regressões, novas tentativas, tempo decorrido e gastos com API.
Para esta lista, use o Kimi para testar o limite de capacidade, o DeepSeek e o GLM Flash para testar a economia de produção, o Qwen para aceitação visual e o GLM para execução de repositório baseada em texto. Deixe que os resultados determinem quais etapas compartilham um modelo e quais precisam de uma abordagem diferente.
Qual modelo chinês de programação você deve usar?
Escolha o Kimi K3.1 Pro primeiro quando concluir um recurso ou aplicativo difícil for a prioridade e você puder justificar um orçamento maior por token.
Escolha o DeepSeek V4.1 Flash quando chamadas repetidas do agente tornarem o custo importante. Confirme a revisão implantada antes de basear um lançamento em evidências específicas da versão 1017.
Escolha o Qwen3.8-Max-0902 quando a implementação precisar corresponder a capturas de tela, layouts ou outras referências visuais.
Escolha o GLM-5.3 quando sua avaliação se concentrar em código-fonte, saída de terminal e comportamento de backend.
Escolha o GLM-5.3 Flash quando você quiser um candidato de programação visual de baixa taxa e puder detectar falhas antes de escalá-las.
Para uma comparação inicial, use uma tarefa delimitada que já possua um teste de aceitação confiável. Uma pequena alteração verificada oferece evidências de implantação mais úteis do que um grande aplicativo gerado que ninguém verificou.
Como chamar esses modelos LLM chineses através de uma única API
Abra a página do modelo que você deseja testar e use Experimentar este modelo → Início Rápido. Crie ou selecione uma chave de API do GPT Proto e use Copiar Markdown para IA para fornecer as instruções de integração atuais ao seu assistente de codificação.
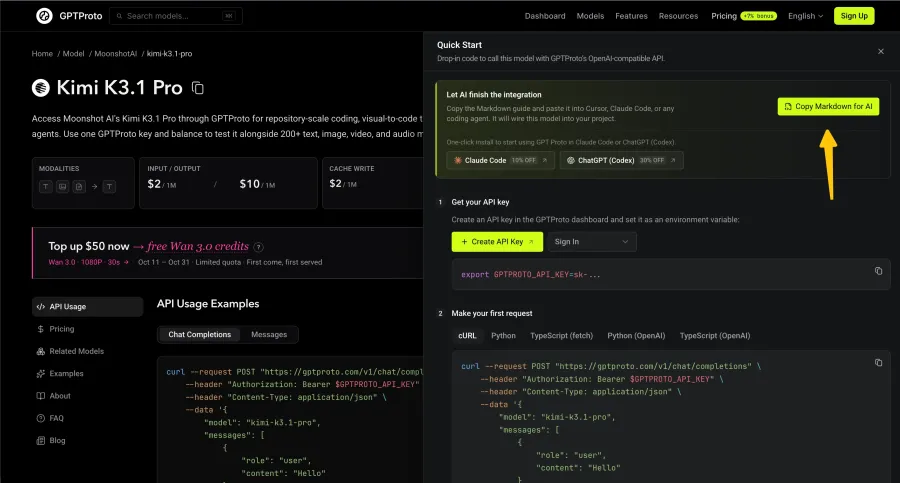
Peça para ele inspecionar seu projeto, seguir o endpoint e os campos de solicitação copiados, manter a chave na configuração do lado do servidor e adicionar uma pequena verificação de conexão. Configure a chave real localmente em vez de colá-la em um prompt público ou repositório.
Os IDs de modelo abaixo identificam as rotas públicas do GPT Proto revisadas para esta atualização:
| Modelo |
ID do modelo GPT Proto |
| Kimi K3.1 Pro |
kimi-k3.1-pro |
| DeepSeek Flash |
deepseek-flash |
| Qwen3.8-Max-0902 |
qwen3.8-max-0902 |
| GLM-5.3 |
glm-5.3 |
| GLM-5.3 Flash |
glm-5.3-flash |
Use o guia da página do modelo ao vivo para cada rota. Os modelos podem diferir nos campos de raciocínio, tratamento de chamadas de ferramentas e formato de solicitação multimodal, portanto, alterar a string do modelo é apenas parte de uma migração. Uma solicitação única bem-sucedida deve ser seguida por um teste de uso de ferramenta de várias etapas antes do uso em produção.
Conectar uma API de modelo ao seu aplicativo também é uma tarefa separada de alterar o modelo que alimenta seu assistente de codificação. Verifique o formato de conexão suportado pelo cliente para este último.
Compare todos os modelos GPT Proto antes de atribuir tráfego de produção. Uma chave de API e um saldo compartilhado podem ser usados para avaliar diferentes modelos suportados sem manter uma integração separada e uma conta pré-paga para cada provedor.
Abra Kimi K3.1 Pro para começar com uma tarefa de codificação difícil, ou compare DeepSeek Flash e GLM-5.3 Flash quando o custo de chamadas repetidas for a prioridade. Use o guia de integração da página do modelo e verifique uma pequena alteração antes de expandir a carga de trabalho.