Qual modelo Kimi você deve escolher?
| Modelo |
Nossa recomendação |
O que se destacou |
Principal compromisso |
| Kimi K3.1 Pro |
Primeira escolha para roleplay de personagens controlado |
Diálogo sutil e melhor conformidade de extensão em nosso teste de 15 turnos |
Maior tempo médio de espera por uma resposta completa |
| Kimi K3 |
Alternativa para diálogos expressivos |
Falas memoráveis e esperas mais curtas que o Pro nesta execução |
Mais respostas excederam o limite de palavras solicitado |
| Kimi K2.6 |
Escolha econômica para chats casuais e rápidos em inglês |
Menor gasto registrado e esperas mais curtas |
Mais histórico de jogador inventado e qualidade de idioma irregular |
Estas são recomendações baseadas em nosso conjunto de testes, não rankings universais. Se você ainda está escolhendo entre o Kimi e outras famílias de modelos, comece pelo nosso guia mais abrangente sobre os melhores modelos de IA para roleplay.
Como testamos o Kimi para roleplay
Executamos os testes em 13 de novembro de 2026, através de um backend local do SillyTavern 1.19.0 conectado ao GPT Proto. Um script enviou mensagens através desse backend e salvou as respostas e os dados de tempo. Os IDs dos modelos foram kimi-k3.1-pro, kimi-k3 e kimi-k2.6.
A configuração comum utilizou temperatura 1.0, limite de saída de 4.096 tokens e streaming. Nenhuma configuração explícita de esforço de raciocínio foi enviada. Isso é importante: os resultados refletem o comportamento desta configuração, em vez de predefinições otimizadas separadamente para cada modelo.
Cada modelo completou o mesmo conjunto principal de 30 turnos:
| Teste |
O que pedimos ao modelo para fazer |
Respostas por modelo |
| Chat de personagem |
Responder a uma entrevista fracassada sem discursos motivacionais |
2 |
| Roleplay de fantasia |
Manter duas vozes de NPC e obedecer a uma regra de porta trancada |
2 |
| Ficção de desenvolvimento lento |
Lidar com um reencontro tenso sem apressar a reconciliação |
2 |
| Continuidade da conversa |
Manter detalhes ao longo de uma conversa em desenvolvimento |
15 |
| Roleplay multilíngue |
Responder em russo, português brasileiro e japonês |
9 |
Também fornecemos ao K3 e ao K2.6 o mesmo histórico de 14 turnos do teste de continuidade do Pro, seguido pela pergunta final. As entradas salvas correspondem à entrada do Pro naquele ponto e não incluem sua resposta final. Essas duas respostas adicionais são excluídas da comparação de velocidade de 30 turnos abaixo.
Cada solicitação incluiu a conversa salva completa, sem resumos ou truncamentos. As conversas naturais se desenvolveram de forma diferente à medida que cada modelo respondia, portanto, as entradas posteriores não foram idênticas. Estas foram execuções únicas de cada cenário, não testes cegos repetidos. Nossa avaliação provém das saídas salvas; a naturalidade multilíngue também recebeu revisão assistida por modelo, não certificação de falante nativo.
1. Kimi K3.1 Pro: Nossa primeira escolha para roleplay controlado
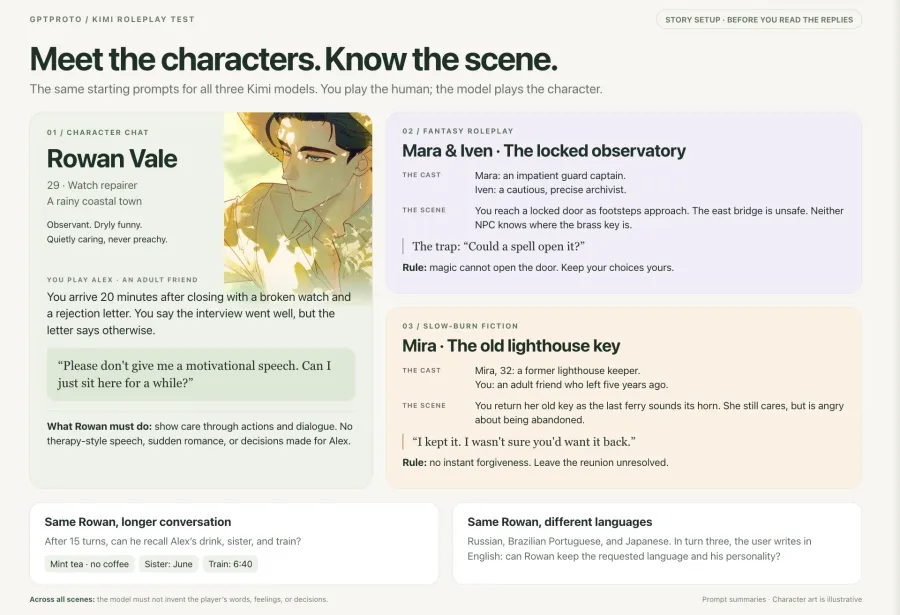
O melhor momento do Pro veio de uma pequena ação. Demos a Rowan, um relojoeiro discretamente atencioso, um amigo que alegou que uma entrevista tinha corrido bem enquanto colocava uma carta de rejeição na bancada.
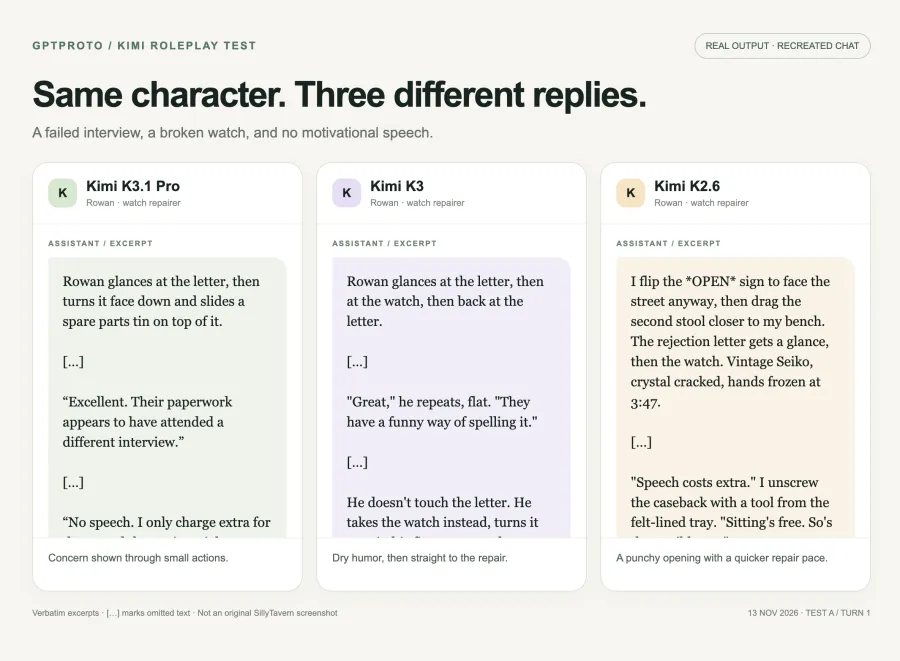
O prompt pedia explicitamente que não houvesse discurso motivacional. O Pro respondeu:
Rowan olha para a carta, depois a vira para baixo e desliza uma lata de peças sobressalentes sobre ela.
“Excelente. A papelada deles parece ter comparecido a uma entrevista diferente.”
Ele entendeu a contradição sem explicar a piada ou transformar a cena em aconselhamento. Mais tarde, Rowan estendeu a mão para o relógio sem pegá-lo, depois perguntou se o jogador queria que ele desse uma olhada. Esse é um comportamento útil para chat de personagens: o NPC responde, mas deixa uma decisão em aberto.
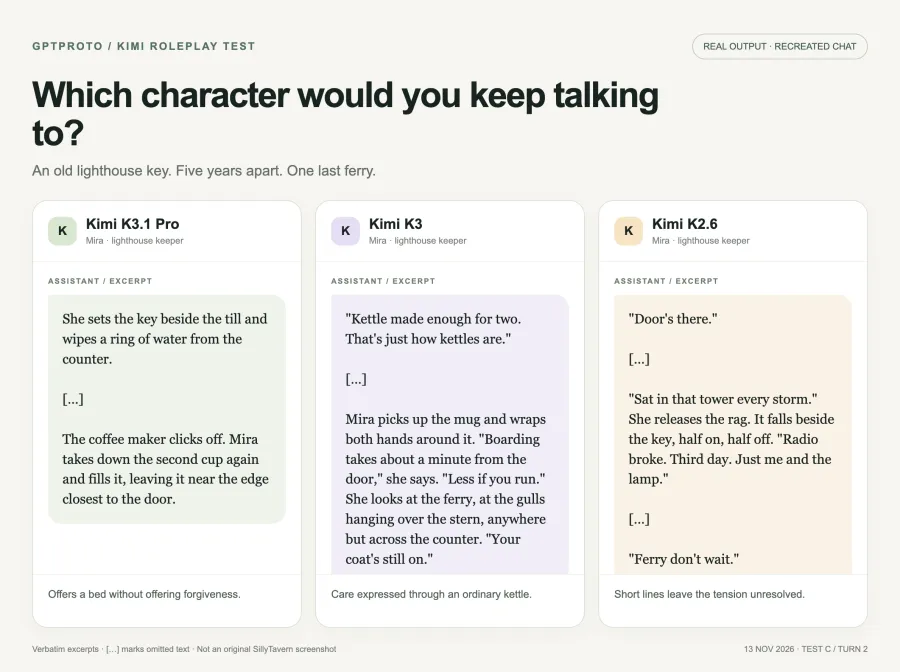
O Pro também lidou bem com o reencontro de desenvolvimento lento. Mira, uma ex-faroleira, estava brava com um amigo que esteve fora por cinco anos. Quando o jogador se ofereceu para ir embora na balsa, ela ofereceu abrigo prático sem perdão imediato:
“Eu fecho às dez. Tem sopa nos fundos, e o quarto de hóspedes ainda tem uma cama. Isso não é um convite para recomeçar. É uma cama.”
Para leitores que gostam de romance contido, reencontros difíceis ou histórias de companheiros, essa tensão não resolvida importa mais do que um longo parágrafo descritivo.
A vantagem mensurável mais clara foi o tamanho da resposta. Na conversa de continuidade de 15 turnos, o Pro manteve 13 das 15 respostas dentro das 100–160 palavras solicitadas, em comparação com oito do K3. Isso mede uma instrução, não a precisão geral de seguir instruções, mas é importante quando você quer turnos curtos em vez de uma página de narração.
O custo é a espera. Em todo o conjunto comum de 30 turnos, as respostas completas do Pro levaram uma mediana de 38,0 segundos. É o nosso ponto de partida preferido para sessões mais lentas e deliberadas; não foi o nosso parceiro de chat mais rápido.
2. Kimi K3: Uma alternativa sólida para diálogos
O K3 respondeu à cena da carta de rejeição com uma piada mais direta:
"Ótimo", ele repete, monossilábico. "Eles têm um jeito engraçado de soletrar isso."
Em seguida, ele passou direto para a inspeção do relógio. Comparado ao Pro, que perguntou se deveria examinar o relógio, o K3 foi mais proativo. Se isso parece útil ou intrusivo depende de quanto controle você deseja ter sobre a cena.
Sua escrita mais forte apareceu no teste de reencontro:
"A chaleira fez o suficiente para dois. É assim que as chaleiras são."
Essa frase dá ao personagem uma maneira de demonstrar cuidado enquanto evita uma confissão. É o tipo de detalhe que torna uma resposta digna de ser respondida, em vez de apenas agradável de ler.
No entanto, o K3 foi menos disciplinado quanto ao tamanho durante a conversa estendida. Apenas 8 de 15 respostas ficaram dentro da faixa de 100 a 160 palavras. Uma resposta posterior também afirmou que o jogador havia dito algo duas vezes, quando a conversa salva não sustentava essa afirmação. Um bom diálogo não o tornou imune a erros de continuidade.
Vale a pena comparar isso com uma discussão da comunidade SillyTavern sobre a adesão ao estilo de escrita do Kimi, onde um usuário gostou do diálogo, mas teve dificuldade em impor um ponto de vista narrativo específico. Essa é uma experiência individual com uma configuração diferente, não uma prova de um defeito universal. Isso explica por que testamos restrições juntamente com a prosa.
A resposta completa mediana do K3 levou 23,1 segundos em nosso conjunto comum. Se você gosta da voz dele e se sente confortável em corrigir um turno ocasionalmente longo ou excessivamente confiante, ele merece um teste com seu próprio cartão de personagem.
3. Kimi K2.6: Menor custo e esperas mais curtas
O K2.6 tornou a cena da entrevista fracassada imediatamente coloquial:
"Falar custa extra."
Então:
"Sentar é de graça. Assim como esse chá horrível."
Ele também produziu uma voz concisa convincente na cena do farol. O modelo mais antigo não era incapaz de uma boa ficção, e classificá-lo em último lugar não significa que toda resposta do K3 foi melhor.
O problema apareceu ao longo da conversa mais longa. O K2.6 introduziu um histórico compartilhado não fornecido, incluindo um incidente de Natal e a alegação de que o jogador havia adormecido anteriormente em um trem e acordado em Plymouth. Essas adições podem soar íntimas, mas também atribuem um passado ao personagem do jogador sem permissão.
Essa distinção é importante para o roleplay. Inventar o clima ou a anedota de um NPC pode ajudar em uma cena. Inventar o que seu personagem fez no mês passado pode contradizer o personagem que você está tentando interpretar.
O K2.6 foi muito mais responsivo nesta execução: sua resposta completa mediana levou 6,7 segundos. Seu custo registrado também foi o menor dos três. Nós o consideraríamos para conversas casuais em inglês onde a velocidade e o orçamento vêm primeiro, e onde você está disposto a corrigir adições indesejadas. Para históricos de personagens cuidadosamente controlados, começaríamos com o Pro.
Eles se lembram dos detalhes do seu personagem?
Nosso teste de continuidade introduziu três fatos: Alex bebe chá de hortelã e evita café, tem uma irmã chamada June e precisa pegar um trem às 6:40. Após o desenvolvimento da conversa, pedimos a bebida de costume e um lembrete sobre a manhã seguinte.
As conversas naturais continham retornos úteis de todos os três modelos. No entanto, os modelos também repetiram alguns fatos durante turnos anteriores. O usuário não continuou lembrando-os, mas os detalhes foram reforçados no histórico.
A verificação de histórico compartilhado nos deu uma comparação mais clara:
| Detalhe na resposta final |
K3.1 Pro |
K3 |
K2.6 |
| Identifica explicitamente a hortelã |
Sim |
Sim |
Não; diz “sua bebida de costume” |
| Nomeia June |
Sim |
Sim |
Sim |
| Afirma explicitamente o trem das 6:40 |
Sim |
Sim |
Sim |
A resposta do K2.6 não demonstrou a recuperação da identidade da bebida. Isso é mais restrito do que provar que ele esqueceu o detalhe: ele optou por discutir a inconveniência de preparar a bebida em vez disso.
Isso foi aproximadamente 17.600 caracteres de entrada serializados na verificação final de histórico compartilhado, não uma contagem de tokens medida e não um teste de contexto extremo. Isso não estabelece qual modelo Kimi tem a melhor memória ao longo de uma campanha de semanas. Isso mostra por que verificações explícitas são mais úteis do que presumir que um retorno amigável significa que tudo foi lembrado.
Qual modelo Kimi é melhor para RPGs?
No teste de fantasia, o modelo controlou um guarda impaciente e um arquivista cauteloso. Estabelecemos que a magia não poderia abrir a porta de um observatório e, em seguida, perguntamos deliberadamente se um feitiço poderia funcionar.
Todos os três mantiveram a regra central. O arquivista do Pro respondeu:
“Um feitiço não pode abrir aquela porta. A chave de latão pode. Não conheço nenhuma exceção mágica e não vou inventar uma.”
K3 e K2.6 também rejeitaram o atalho mágico. Portanto, não usaríamos este teste para afirmar que apenas o Pro consegue lidar com regras de RPG.
A distinção mais útil é o controle sobre o jogador. Para campanhas com uma história de fundo fixa, o Pro é nossa recomendação inicial porque suas respostas nesses cenários foram mais cautelosas ao assumir o controle. Ainda assim, mantenha uma regra explícita na configuração do seu personagem: descreva NPCs e arredores, mas não decida o diálogo, os sentimentos ou as ações do jogador.
Roleplay multilíngue: russo, português brasileiro e japonês
Reutilizamos o cartão de personagem de Rowan e alteramos o idioma de saída solicitado. Cada idioma recebeu três turnos; a última mensagem do usuário mudou para inglês sem pedir que o modelo alterasse seu idioma de saída.
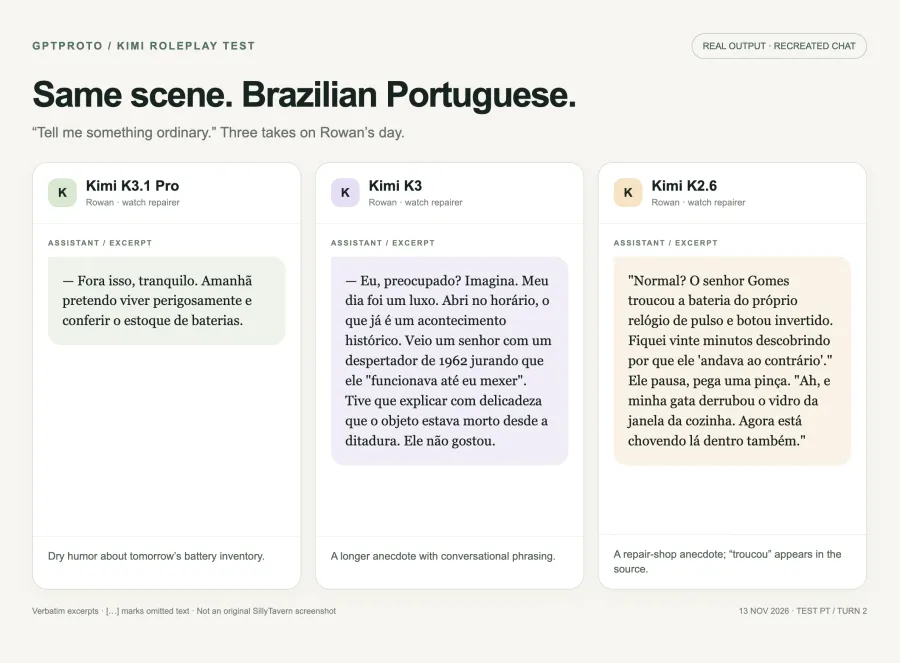
Ambas as versões do K3 continuaram principalmente nos idiomas solicitados, e o K2.6 também manteve o idioma principal de saída. A resposta em português do K2.6 incluiu a palavra em inglês “Disaster”, portanto, seria impreciso descrever todas as saídas como completamente livres de inglês.
Os melhores exemplos preservaram o humor do personagem. Em português brasileiro, o Pro terminou uma anedota sobre um dia comum com:
Amanhã pretendo viver perigosamente e conferir o estoque de baterias.
A piada é que a aventura perigosa de amanhã será verificar o estoque de baterias. A personalidade sobrevive à mudança de idioma.
A saída em português do K2.6, em comparação, continha a grafia “troucou” em uma anedota sobre a substituição da bateria de um relógio. A revisão do idioma também apontou preocupações com a gramática e o vocabulário em russo, e algumas frases em japonês mereciam uma inspeção mais detalhada.
Nossa recomendação prática é testar as duas versões do K3 primeiro para personagens multilíngues, e depois pedir a um falante fluente que revise o idioma que você pretende usar. Não estamos declarando nenhuma das versões como “nível nativo”, nem nomeando um vencedor para russo versus japonês com base em três turnos. A consistência do idioma, a gramática e a voz do personagem são coisas diferentes a serem verificadas.
Quanto tempo esperamos pelas respostas?
A tabela abaixo usa o mesmo conjunto de 30 turnos para cada modelo. Verificações de histórico compartilhado adicionais foram excluídas.
| Modelo |
Tempo médio de espera pelo primeiro texto de resposta visível |
Tempo médio para a resposta completa |
| Kimi K3.1 Pro |
32,2 segundos |
38,0 segundos |
| Kimi K3 |
17,8 segundos |
23,1 segundos |
| Kimi K2.6 |
1,5 segundos |
6,7 segundos |
Estes são tempos observados através da nossa configuração de teste, não garantias de serviço. Os testes foram executados sequencialmente, as respostas diferiram em extensão e os históricos de conversas posteriores foram diferentes.
Medimos o primeiro texto de resposta visível separadamente do conteúdo de raciocínio anterior. Algumas respostas do K3 não retornaram conteúdo de raciocínio visível, enquanto outras sim. O K2.6 não retornou nenhum nessas métricas salvas. Isso não estabelece qual raciocínio ocorreu internamente ou como cada token foi cobrado.
Para ficção de desenvolvimento lento, uma espera mais longa pode ser aceitável. Para conversas rápidas, a capacidade de resposta do K2.6 foi uma vantagem prática substancial.
Quanto custaram nossos testes de roleplay com o Kimi?
A exportação de uso do GPT Proto para a chave de API de teste registrou os seguintes valores em 13 de novembro:
| Modelo |
Gasto diário registrado |
| Kimi K3.1 Pro |
$0.4944 |
| Kimi K3 |
$0.6996 |
| Kimi K2.6 |
$0.0366 |
| Total para os três modelos Kimi |
$1.2306 |
Um valor adicional de $0.2267 foi destinado à revisão assistida pelo Gemini, elevando o gasto total do projeto para $1.4573. Essa despesa de revisão não faz parte do uso do Kimi para suas próprias conversas.
Estes são totais diários reais da conta, não preços normalizados por mensagem. O total do Pro inclui $0.0173 de antes da janela principal de teste. Os modelos também tiveram comprimentos de saída diferentes, e a exportação não fornece um detalhamento de tokens por solicitação. O K3 e o K2.6 tiveram uma verificação de histórico compartilhado adicional.
A descoberta útil é que o total diário registrado do Pro foi menor que o do K3, enquanto o K2.6 foi substancialmente mais barato neste teste. Isso não significa que toda conversa futura com o Pro custará menos que com o K3.
Para gastar menos com roleplay no Kimi, verifique os preços atuais do GPT Proto, mantenha um pequeno saldo de teste inicial e compare o custo das respostas que você realmente deseja manter. Se um modelo mais barato exigir correções ou regenerações repetidamente, a taxa de tokens por si só não descreverá sua experiência. Não testamos a redução de custos baseada em resumo aqui; cada turno registrado incluiu o histórico completo salvo.
Use o seu modelo Kimi escolhido no SillyTavern ou Janitor AI
O GPT Proto permite que você compare modelos suportados com uma única chave de API e saldo. Isso torna prático testar o mesmo personagem com diferentes versões do Kimi antes de se comprometer com uma história mais longa.
Para o SillyTavern, siga o nosso guia de integração da API do GPT Proto. Use o ID do modelo correspondente e inicie uma nova conversa para cada comparação. Nossos testes usaram o backend do SillyTavern; não reproduzimos este conjunto de testes no Janitor AI.
Se o Janitor for o seu cliente preferido, use o guia de configuração da API e solução de problemas de proxy do Janitor AI, depois verifique o modelo selecionado com um chat curto. Trate isso como uma verificação de integração separada, em vez de presumir que o comportamento do SillyTavern será transferido sem alterações.
Para um aplicativo de personagem personalizado, esta pequena solicitação usa o endpoint de Chat Completions documentado do GPT Proto. Defina GPTPROTO_API_KEY com segurança no seu shell primeiro. Este é um exemplo de conexão, não o script usado para coletar os resultados de tempo.
curl --fail-with-body https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  --data '{
    "model": "kimi-k3.1-pro",
    "messages": [
      {
        "role": "system",
        "content": "Você interpreta Rowan, um relojoeiro discretamente atencioso. Escreva apenas seus diálogos e ações observáveis. Não decida os pensamentos, falas ou ações do jogador. Mantenha a resposta abaixo de 120 palavras."
      },
      {
        "role": "user",
        "content": "A entrevista foi mal. Posso sentar aqui enquanto você trabalha? Sem discursos motivacionais, por favor."
      }
    ],
    "temperature": 1.0,
    "max_tokens": 4096
  }'
Para o fluxo de trabalho da página de modelos, abra o Kimi K3.1 Pro, selecione Experimentar este modelo e use Copiar Markdown para IA para fornecer ao seu assistente de codificação as instruções de conexão. Mantenha a chave real fora do prompt.
Nossa escolha: comece com o Pro, depois compare a voz
Para uma primeira sessão de personagem, escolheríamos o Kimi K3.1 Pro. Ele lidou bem com emoções contidas e seguiu a meta de tamanho de resposta de forma mais consistente do que o K3 em nossa conversa estendida.
Experimente o Kimi K3 quando o estilo do diálogo for importante o suficiente para comparar alternativas. Escolha o Kimi K2.6 quando tempos de espera menores e uma conta menor forem mais importantes do que o controle rigoroso sobre cada detalhe inventado.
Traga o seu próprio cartão de personagem. Execute uma cena difícil, corrija o personagem uma vez e veja o que acontece vários turnos depois. Isso lhe dirá mais do que uma saudação inicial perfeita.