Visão geral do Qwen 4 Max: Do teste cego "Qoduck" à prévia de 14 dias
Se você deseja uma visão geral prática do Qwen 4 Max, comece pelos quatro dias anteriores à divulgação do seu nome. Entre 7 e 10 de novembro de 2026, um modelo anônimo codinome Qoduck apareceu dentro do Qoder, uma IDE de codificação agentica. Desenvolvedores testando o Qoduck notaram um padrão incomum: em vez de retornar um snippet de código rápido de passagem única e aguardar o feedback humano, o modelo passava de dez a quinze minutos executando verificações de shell, escrevendo ativos SVG personalizados do zero e executando testes unitários contra seus próprios diffs antes de retornar uma resposta final.
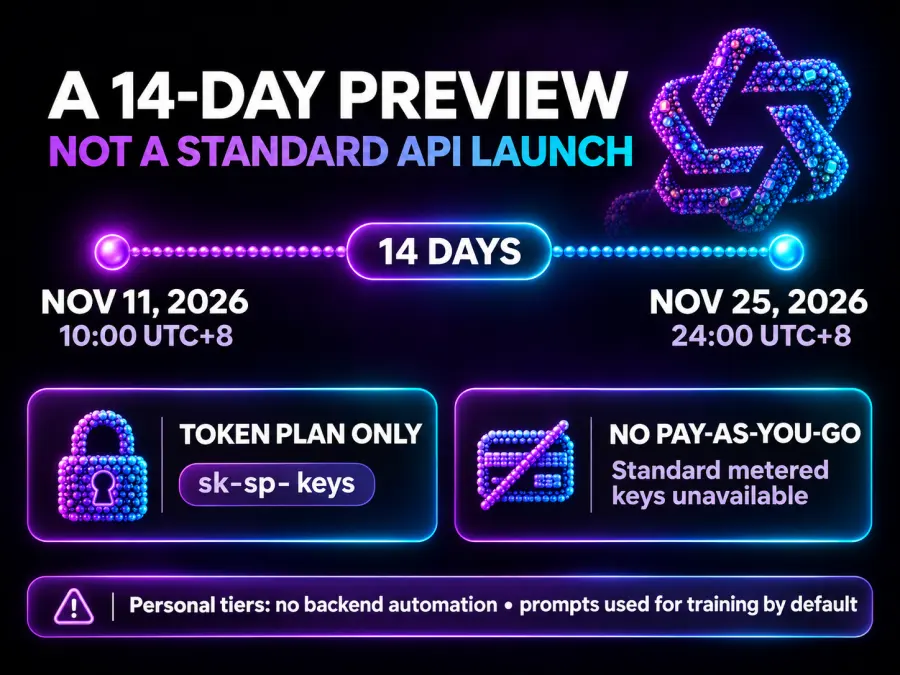
Em 11 de novembro de 2026, às 10:00 UTC+8, o Alibaba confirmou que o Qoduck era o mais novo modelo Qwen, o Qwen 4 Max, e o disponibilizou no Alibaba Cloud Model Studio sob a string de modelo qwen4-max-preview (referenciado como qwen4.0-max-preview em configurações de clientes selecionados). Em vez de realizar um lançamento comercial completo com preços de lista por token, o Alibaba estruturou o lançamento — frequentemente descrito na documentação para desenvolvedores como a introdução do Qwen 4 Max por meio de uma prévia de 14 dias — projetado para testar fluxos de trabalho agenticos dentro de ferramentas de desenvolvedor como Claude Code, Cursor, Cline e Qoder.
| Especificação |
Status Confirmado (qwen4-max-preview) |
Fonte / Nota de Engenharia |
| ID Oficial do Modelo |
qwen4-max-preview |
Documentação do Alibaba Cloud Model Studio / Bailian |
| Janela de Prévia |
11 de nov. de 2026 (10:00) – 25 de nov. de 2026 (24:00 UTC+8) |
Prévia limitada de 14 dias rigorosos |
| Janela de Contexto |
1.000.000 de tokens (entrada máx: 967.000 tokens) |
Verificado em documentos CN e internacionais |
| Tokens de Saída Máximos |
393.216 total (131.072 saída final + 262.144 raciocínio) |
max_tokens limita o pensamento + saída combinados |
| Modalidades de Entrada / Saída |
Entrada: Texto, Imagem, Vídeo · Saída: Texto |
Sem entrada de áudio nativa na rota de prévia |
| Controle de Raciocínio |
reasoning_effort: low, medium, xhigh |
Pensamento ATIVADO por padrão; o padrão é xhigh |
| Protocolos de API Suportados |
OpenAI Chat Completions, Responses API, Anthropic Messages |
Requer endpoint de Plano de Token sk-sp- dedicado |
| Tamanho e Pesos dos Parâmetros |
Não divulgado (Prévia comercial fechada) |
Números de 2.4T / 95B online pertencem ao Qwen3.8-Max |
| Tabela de Benchmark Oficial |
Não publicada no lançamento da prévia |
A pontuação GameFeel de 49.9 em circulação é do Qwen-4-Flash-Early |
Entender o qwen 4 max explicado como um passo geracional resume-se a como ele gasta computação no momento da inferência. Onde lançamentos anteriores tratavam a chamada de ferramentas como um auxiliar opcional, a atualização central do qwen 4 max upgrade incorpora um loop de autoverificação no rastreamento de raciocínio padrão. Quando solicitado a criar um aplicativo web ou corrigir um utilitário de linha de comando, o modelo rotineiramente encadeia dezenas de invocações de ferramentas — inspecionando árvores de diretórios, executando pytest ou navegadores headless locais, detectando suas próprias regressões de sintaxe ou layout e reescrevendo as linhas quebradas antes mesmo que o usuário veja a saída.
Arquitetura, tamanho do modelo e a verificação da realidade dos benchmarks
Duas informações incorretas dominam atualmente os resultados de pesquisa para qwen 4 max size e qwen 4 max benchmark. Esclarecê-las é a maneira mais rápida de entender o que a Alibaba realmente lançou e o que permanece não revelado.
Primeiro, a Alibaba não divulgou a contagem total ou ativa de parâmetros para o alibaba qwen 4 max. Vários blogs de terceiros o listam como um modelo de Mistura de Especialistas (MoE) de 2,4 trilhões de parâmetros com 95 bilhões de parâmetros ativos por token. Esses números exatos pertencem ao carro-chefe anterior, Qwen3.8-Max, lançado em setembro de 2026. Embora o Qwen 4 Max quase certamente use uma estrutura MoE esparsa para atender a uma janela de contexto de 1 milhão de tokens de forma econômica, qualquer número específico de trilhões de parâmetros que você leia em novembro de 2026 é uma informação não verificada herdada da geração 3.8.
O que temos sobre o lado arquitetural vem do lançamento técnico da Alibaba em agosto de 2026 do Qwen3.8-Flash-Next, que a equipe do Qwen designou explicitamente como um ambiente de teste para validar atualizações arquiteturais principais para a série Qwen 4. Esse relatório precursor documentou quatro mudanças estruturais que explicam como o qwen4-max-preview lida com cargas de trabalho de um milhão de tokens:
Atenção Híbrida GDN + QSA: Combinar camadas de atenção linear Gated DeltaNet (GDN) com Qwen Sparse Attention (QSA) reduziu a latência de preenchimento do tempo para o primeiro token (TTFT) em um contexto de 1.000.000 de tokens em até 7,6x em comparação com a atenção total padrão.
Conexões Residuais com Portão de 4 Fluxos: Expandir a largura do fluxo residual com portões aprendidos melhora o fluxo de gradiente e o roteamento de recursos entre camadas durante o raciocínio profundo de várias etapas.
Camadas de Embedding de N-gramas: Injetar contexto local de vários tokens diretamente no estágio de embedding descarrega a correspondência de padrões lexicais dos blocos de atenção iniciais.
Treinamento com Otimizador Muon: Mudar a otimização do pré-treinamento em larga escala para Muon melhorou a eficiência da amostra em corpora de código e lógica formal.
Segundo, se você pesquisar por resultados de qwen 4 max benchmark, provavelmente encontrará alegações de que o Qwen 4 Max marcou 49,9 no GameFeel Bench v1.4, superando o Claude Opus 5.5 com 47,2. Verifiquei o placar e os logs de commit subjacentes: essa pontuação de 49,9 foi registrada por um checkpoint de teste inicial e leve chamado Qwen-4-Flash-Early (codinome interno hawk), não pelo qwen4-max-preview. Até 13 de novembro de 2026, a Alibaba não publicou uma tabela oficial de placar MMLU-Pro, SWE-bench Verified ou AIME para o Qwen 4 Max.
O que você pode verificar agora mesmo é a mecânica da qwen 4 max context window e seu orçamento de saída — e é aqui que os desenvolvedores que estão migrando encontram um obstáculo. Embora a janela de contexto comporte 1.000.000 de tokens (com um limite de prompt documentado de 967.000 tokens), a saída máxima é listada como 393.216 tokens no portal internacional e detalhada no portal doméstico como 262.144 tokens de raciocínio mais 131.072 tokens de resposta final.
Aqui está o detalhe: o parâmetro de API max_tokens no qwen4-max-preview rege a soma de reasoning_content e content. Como o modelo usa por padrão reasoning_effort: "xhigh" (a mais alta das três configurações disponíveis: low, medium e xhigh), um prompt de codificação complexo pode facilmente consumir de 15.000 a 40.000 tokens dentro do bloco de raciocínio oculto. Se o seu código de cliente existente passar max_tokens: 4096 ou 8192, o modelo esgotará toda a sua permissão no meio do raciocínio e retornará uma string content vazia. Para evitar o truncamento silencioso, aumente o max_tokens para acima de 65.536 ou reduza explicitamente o reasoning_effort para medium em tarefas rotineiras.
Análise prática do Qwen 4 Max: O que os testes da comunidade e da mídia realmente mostram
Como a Alibaba não divulgou um comunicado de imprensa tradicional com benchmarks, os dados mais confiáveis da análise do qwen 4 max vêm de equipes de engenharia que conectaram o qwen4-max-preview a ambientes de agentes em tempo real durante as primeiras 48 horas da versão de prévia. Seus registros mostram um padrão claro: cada salto na qualidade de saída vem acompanhado de uma latência e custo de tokens perceptíveis.
Em 11 de novembro, a consultoria de IA japonesa WEEL publicou uma avaliação em três partes testando o modelo de prévia em síntese de frontend, pesquisa de múltiplas fontes e depuração em nível de repositório dentro do Claude Code:
Página de destino SVG personalizada de 908 linhas (vs Qwen 3.8 Max): Com um prompt idêntico para criar uma página de destino responsiva para uma clínica de fisioterapia com tema florestal, o Qwen3.8-Max terminou em cerca de 9,5 minutos, mas puxou fotos de banco de imagens externas aleatórias que quebraram a grade ou falharam ao carregar. O qwen4-max-preview levou cerca de 17 minutos — quase o dobro do tempo. Em vez de vincular URLs externas frágeis, ele invocou seu Interpretador de Código dezenas de vezes em segundo plano para desenhar programaticamente ilustrações SVG personalizadas de copas de florestas, arquitetura da clínica e ícones da equipe, entregando um arquivo HTML de 908 linhas sem nenhum ativo quebrado.
Depuração autônoma de CLI no Claude Code (36/36 testes aprovados): A WEEL apontou o Claude Code (alimentado pelo qwen4-max-preview via endpoint compatível com Anthropic) para uma CLI de contabilidade doméstica em Python (kakeibo) e pediu para adicionar as flags de filtragem --export-csv e --month com testes unitários. A execução levou 11 minutos e 48 segundos. Após escrever a implementação inicial, o modelo executou o pytest, detectou 2 testes com falha — incluindo um caso extremo onde uma string de moeda negativa como -100日元 foi mal interpretada pelo argparse do Python como uma flag de linha de comando — e corrigiu o analisador por conta própria. Sem ser solicitado, ele também adicionou um cabeçalho BOM utf-8-sig para que os caracteres japoneses não ficassem corrompidos no Microsoft Excel e escapou os caracteres iniciais =, +, - e @ para bloquear injeção de fórmula CSV. Todos os 36 testes foram aprovados, consumindo apenas 0,4% da cota mensal do plano Lite.
Pesquisa de políticas autoverificada: Com a tarefa de compilar uma tabela de comparação de subsídios para PMEs japonesas de 2026, o modelo passou 2 minutos realizando mais de uma dúzia de consultas na web em portais ministeriais e outros 5 minutos executando grep e scripts de validação em Python para verificar se nenhuma coluna da tabela Markdown foi deslocada antes de apresentar o resultado de 8 minutos.
Dois dias depois, em 13 de novembro, a publicação de tecnologia chinesa Silicon Star (GuiXingRen) realizou uma maratona de engenharia visual e 3D contra o qwen4-max-preview. Quando solicitado a gerar a clássica animação SVG de um "pelicano andando de bicicleta", o modelo articulou a pedalada e as sombras de paralaxe das árvores, enquanto adicionava espontaneamente um controle deslizante de velocidade de 0,5x–1,75x e um alternador de tema dia/crepúsculo/noite. Em um teste mais difícil com Three.js — construir um jogo 3D jogável de avião de papel chamado Paper Skies onde o avião voa através da janela de um quarto para um jardim — os revisores notaram que sua física e tratamento de obstáculos igualaram o Claude Fable 5.1 da Anthropic, focado em criatividade, embora ainda estivesse atrás do novo Claude Fable 5.2 no polimento de shaders. Ao ser solicitado a redesenhar a própria página inicial responsiva da Silicon Star, o modelo iniciou um navegador local, detectou que as miniaturas de artigos externos estavam retornando erros 403 de hotlink, substituiu-as automaticamente por espaços reservados de gradiente SVG estilizados e concluiu uma segunda rodada de revisões de layout editorial em 5 minutos.
O feedback de desenvolvedores no X (antigo Twitter) e em fóruns de desenvolvedores japoneses adiciona nuances importantes a cada destaque do recurso do qwen 4 max. O desenvolvedor @round_boys demonstrou o modelo renderizando uma cena 3D completa usando Java e Three.js em uma única execução, mas observou que o processo consumiu cerca de 69.000 tokens. Outros usuários pioneiros que mediram o throughput bruto relataram velocidades de streaming em torno de 33 tokens por segundo na configuração padrão xhigh, comentando que suas trajetórias de uso de ferramentas por aprendizado por reforço (RL) ocasionalmente pensam demais em leituras simples de arquivos — um lembrete de que o sufixo -preview é literal.
Preços do Qwen 4 Max, Regras do Plano de Tokens e Bloqueios de Produção
Se você pesquisar por preços do qwen 4 max esperando uma tabela padrão de "$X por milhão de tokens de entrada", você não encontrará. O Alibaba não oferece faturamento medido ou pré-pago para o qwen4-max-preview. A única maneira de enviar solicitações é por meio de uma assinatura ativa do Alibaba Cloud Model Studio Token Plan (anteriormente chamado de Coding Plan), que cobra em "Créditos" mensais abstratos em vez de dólares brutos por token.
No portal internacional do QwenCloud, o Plano de Tokens é dividido em níveis pessoal e de equipe:
Plano Lite (3 pelo primeiro mês para novos usuários): Inclui 20.000 Créditos por mês, regidos por um limite rotativo rigoroso de 1.200 Créditos por janela de 5 horas e 9.000 Créditos por semana.
Plano Pro (15 pelo primeiro mês): Inclui 100.000 Créditos por mês, limitados a 6.000 Créditos por janela de 5 horas e 45.000 Créditos por semana. (No portal doméstico do Alibaba na China, o Lite e o Pro custam 39 RMB e 199 RMB por mês, com promoções de metade do preço no primeiro mês a 19,5 RMB e 99,5 RMB.)
Desconto de Prévia de 14 Dias (11 de nov. a 25 de nov. de 2026): Durante a janela de prévia de duas semanas, as chamadas diurnas (08:00–22:00 UTC+8) consomem apenas 20% do peso padrão de Crédito, enquanto as chamadas noturnas fora de pico (22:00–08:00 UTC+8) recebem um desconto adicional de 80% sobre isso — reduzindo o consumo efetivo de Créditos para apenas 4% das taxas normais.
Para um desenvolvedor individual que trabalha em uma IDE à noite por $3, essa matemática promocional é difícil de superar. Para uma equipe de engenharia que constrói um produto ou executa agentes de CI/CD automatizados, no entanto, o Plano de Tokens introduz três bloqueios de produção severos:
Proibição de Automação de Backend e Integração de API: Os termos do Plano de Tokens do Alibaba restringem explicitamente as chaves pessoais Lite e Pro (sk-sp-) ao uso de codificação interativa acionada por humanos dentro de plugins de IDE suportados. Usar uma chave de assinatura para alimentar um script de backend automatizado, um recurso de SaaS voltado ao cliente ou um pipeline de dados em lote viola os termos de serviço e aciona a suspensão da conta.
Treinamento de Dados Obrigatório em Níveis Pessoais: Sob as regras do Plano de Tokens, as assinaturas pessoais Lite e Pro inscrevem todos os prompts, contexto de repositório e conclusões de modelo no programa de melhoria de treinamento de modelo do Alibaba por padrão — e não há opção para desativar isso. Apenas o Plano de Equipe empresarial ($40 por assento/mês) oferece uma garantia de retenção zero de dados / sem treinamento.
Limites de Taxa Rotativos de 5 Horas e o Encerramento em 25 de Novembro: Mesmo que seu fluxo de trabalho seja puramente interno, um teto rotativo de 1.200 Créditos a cada 5 horas não consegue absorver picos de vários desenvolvedores, e o endpoint qwen4-max-preview está programado para ser encerrado em 25 de novembro de 2026, às 24:00 UTC+8.
Comparações diretas: Qwen 4 Max vs Qwen 3.8 Max, Kimi K3.1 Pro, GLM-5.3 e Claude Opus 5.5
Como você não pode integrar o qwen4-max-preview em um backend de produção hoje, a questão prática por trás de cada consulta de comparação é qual modelo principal com pagamento conforme o uso cobre a mesma carga de trabalho agentic de 1M de contexto sem bloqueio por assinatura ou exposição de dados para treinamento.
| Modelo |
Faturamento e Disponibilidade |
Janela de Contexto |
Saída Máxima |
Modalidades de Entrada Suportadas |
Taxa Medida GPT Proto (Entrada / Saída por 1M) |
Qwen4-Max-Preview (qwen4-max-preview) |
Apenas visualização de 14 dias (termina em 25 de nov.); Assinatura de plano de tokens ($6–$30/mês) |
1.000.000 |
393.216 (incl. 262K CoT) |
Texto, Imagem, Vídeo |
Não hospedado (Sem API upstream medida) |
Qwen3.8 Max 0902 (qwen3.8-max-0902) |
Pagamento conforme o uso em produção |
1.000.000 |
65.536+ |
Texto, Imagem, Vídeo, Áudio, Documento |
4,20 (30% abaixo da lista oficial) |
Kimi K3.1 Pro (kimi-k3.1-pro) |
Pagamento conforme o uso em produção |
1.048.576 (1,05M) |
131.072 |
Texto, Imagem, Documento |
10,00 ($0,20 entrada em cache) |
GLM-5.3 (glm-5.3) |
Pagamento conforme o uso em produção |
1.050.000 (1,05M) |
128.000 |
Texto, Imagem, Documento |
3,74 (15% abaixo da lista oficial) |
Claude Opus 5.5 (claude-opus-5-5) |
Pagamento conforme o uso em produção |
1.000.000 |
128.000 |
Texto, Imagem, Documento |
18,00 (10% abaixo da lista oficial) |
Qwen 4 Max vs Qwen 3.8 Max
Ao avaliar qwen 4 max vs qwen 3.8 max, o compromisso é entre o tempo de verificação autônoma versus a estabilidade de produção e um suporte mais amplo a modalidades. Como demonstrou o teste de landing page de 17 minutos vs 9,5 minutos do WEEL, o Qwen 4 Max está disposto a gastar o dobro do tempo de relógio executando verificações em Python em segundo plano e sintetizando SVGs personalizados. No entanto, o qwen4-max-preview descarta a análise nativa de áudio e documentos em sua rota de visualização e não pode ser chamado por token.
Se o seu pipeline já depende da formatação de prompts, tokenização multilíngue ou visão multimodal da Alibaba, o qwen3.8-max-0902 é o modelo principal pronto para produção para fixar hoje. Ele oferece a mesma janela de contexto de 1.000.000 de tokens enquanto aceita entradas de Texto, Imagem, Vídeo, Áudio e Documento. No GPT Proto, o qwen3.8-max-0902 é executado a 4,20 por 1M de tokens de saída—30% abaixo do preço de lista oficial da Alibaba—e você pode compará-lo ao lado de modelos menores de pesos abertos no hub de modelos Qwen.
Qwen 4 Max vs Kimi K3.1 Pro
O confronto qwen 4 max vs kimi k3.1 pro foi testado frente a frente nos benchmarks Blender MCP e WebGL de 13 de novembro da Silicon Star, e a diferença entre os dois modelos é notavelmente clara: o Qwen 4 Max pensa como um engenheiro mecânico estrutural, enquanto o Kimi K3.1 Pro pensa como um designer industrial.
No prompt do Blender ("Doca de Manutenção de Megaveículo Orbital de Júpiter") e no teste de portão de mar profundo do WebGL ("Portão das Dez Mil Marés"), o qwen4-max-preview construiu nervuras de suporte de carga internas mais densas, braços de acoplamento complexos e um controle deslizante de interface de nível de maré funcional que recalculava dinamicamente as leituras de altura e pressão da água. No entanto, os avaliadores pontuaram consistentemente o kimi-k3.1-pro mais alto em composição visual, iluminação de shader de água e harmonia de cores. Se você está criando frontends voltados para o usuário, experiências web 3D interativas ou agentes de documentos de contexto longo que precisam de uma janela de contexto de 1.048.576 tokens (1,05M) e 131.072 tokens de saída máxima hoje, o Kimi K3.1 Pro está disponível no GPT Proto por 10,00 por 1M de saída (com entrada em cache caindo para $0,20 por 1M).
Qwen 4 Max vs GLM-5.3
Desenvolvedores que pesquisam qwen 4 max vs glm5.3 geralmente buscam eficiência de codificação e uso de ferramentas em alto volume a um preço agressivo. Embora a promoção Lite de $3 do primeiro mês do Qwen 4 Max pareça barata no papel, o limite de crédito rotativo de 5 horas e a proibição de scripts automatizados o tornam inutilizável para frotas de agentes em segundo plano.
O glm-5.3 da Z.ai resolve exatamente esse problema em uma API medida. Ele supera ligeiramente o Qwen 4 Max na capacidade total de contexto — oferecendo uma janela de contexto de 1,05M combinada com um limite de saída de 128K — e aceita entradas de Texto, Imagem e Documento. Por 3,74 por 1M de tokens de saída no GPT Proto (15% abaixo da taxa oficial da Z.ai), o GLM-5.3 é o cavalo de batalha de pagamento conforme o uso mais econômico para bots de revisão de PR automatizados, roteamento de ferramentas de alta concorrência e geração de código de múltiplos arquivos.
Qwen 4 Max vs Claude Opus 5.5
A Alibaba incorporou compatibilidade nativa com a API Anthropic Messages no qwen4-max-preview especificamente para atrair desenvolvedores que analisam qwen 4 max vs claude opus 5.5 dentro do Claude Code. Como o teste de CLI Python da WEEL provou, o Qwen 4 Max já consegue executar um loop de reparo pytest de 12 minutos e detectar bugs sutis de argparse e injeção de CSV.
Onde o claude-opus-5-5 mantém uma vantagem decisiva é na eficiência de trajetória, responsividade de streaming e confiabilidade de SLA de produção. Testadores da comunidade notaram que o ajuste de RL em estágio inicial do Qwen 4 Max pode fazer com que ele entre em loop através de verificações de shell redundantes a ~33 tokens/s sob raciocínio xhigh. Quando você está refatorando repositórios de produção de missão crítica onde turnos de ferramentas desperdiçados ou treinamento de dados de nível pessoal são inaceitáveis, o Claude Opus 5.5 oferece uma janela de contexto de 1M e 128K de saída máxima com adesão madura às instruções. Através do GPT Proto, você pode chamar o claude-opus-5-5 por 18,00 por 1M de saída — 10% abaixo do preço oficial da Anthropic.
Como chamar alternativas de produção via API unificada
Se você deseja executar os quatro modelos principais de produção acima sem gerenciar SDKs de fornecedores separados, janelas de crédito de assinatura ou endpoints regionais sk-sp-, o GPT Proto expõe todos eles por trás de uma única rota compatível com OpenAI (https://gptproto.com/v1/chat/completions).
Um detalhe de autenticação que vale a pena notar antes de copiar o snippet: conforme documentado em nosso guia de autenticação e na página de início rápido, sempre passe sua chave no cabeçalho Authorization com o prefixo Bearer (Authorization: Bearer $GPTPROTO_API_KEY). Abaixo está um exemplo baseado na documentação mostrando como chamar o qwen3.8-max-0902 e alternar diretamente para glm-5.3, kimi-k3.1-pro ou claude-opus-5-5 alterando uma única string:
curl --request POST "https://gptproto.com/v1/chat/completions" \
  --header "Authorization: Bearer $GPTPROTO_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "qwen3.8-max-0902",
    "messages": [
      {
        "role": "user",
        "content": "Audite este analisador de CLI Python quanto a colisões de flags de números negativos e riscos de injeção de fórmula CSV."
      }
    ]
  }'
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://gptproto.com/v1",
    api_key=os.environ["GPTPROTO_API_KEY"],
)

# Troque o ID do modelo livremente entre os principais modelos de 1M de contexto:

# "qwen3.8-max-0902" ($1.40/$4.20) | "glm-5.3" ($1.19/$3.74)

# "kimi-k3.1-pro" ($2.00/$10.00)   | "claude-opus-5-5" ($3.60/$18.00)
response = client.chat.completions.create(
    model="qwen3.8-max-0902",
    messages=[
        {
            "role": "user",
            "content": "Audite este analisador de CLI Python quanto a colisões de flags de números negativos e riscos de injeção de fórmula CSV.",
        }
    ],
)

print(response.choices[0].message.content)