Como classificamos os modelos para o SillyTavern
A principal evidência é o AI Roleplay Bench de setembro de 2026, que testou 14 modelos oficiais em 10 categorias e pontuou 840 respostas. Suas categorias abrangem chat com companheiros, comportamento de Mestre de Jogo, voz de personagem rigorosa, vilões, robustez, temas maduros e limites de segurança. Kimi K3, GLM-5.3 e DeepSeek V4.1 Flash estão separados por menos de dois pontos, portanto, o próprio benchmark recomenda interpretá-los como um empate técnico em vez de tratar um decimal como uma vitória decisiva.
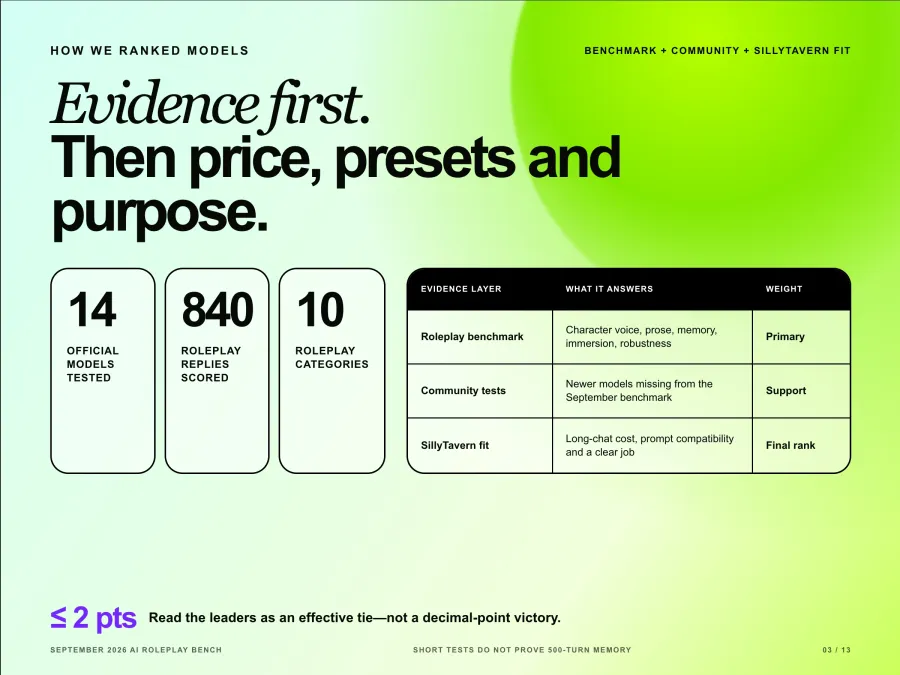
O benchmark também possui limitações. Sua metodologia publicada usa cenários curtos de múltiplos turnos, não mede a deriva ao longo de centenas de mensagens e exclui ajustes finos da comunidade. Lançamentos mais recentes, como o Gemini 4 Argon, também chegaram após esse teste. Para esses modelos, utilizo comparações da comunidade como evidência de suporte e marco a recomendação como menos certa.
A classificação final adiciona três fatores específicos do SillyTavern:
Economia de chat longo. Os tokens de entrada geralmente dominam os turnos posteriores porque o SillyTavern envia novamente o cartão do personagem, instruções, lore relevante e o histórico da conversa.
Compatibilidade de prompt e predefinições. Chat Completion, Text Completion, modelos de instrução, samplers e controles de raciocínio não são intercambiáveis.
Uma função clara para cada modelo. Um modelo mais barato ganha um lugar apenas se tiver uma função útil, não simplesmente porque seu preço é baixo.
Os 8 melhores modelos de IA para roleplay no SillyTavern
1 Kimi K3: O melhor modelo geral para SillyTavern
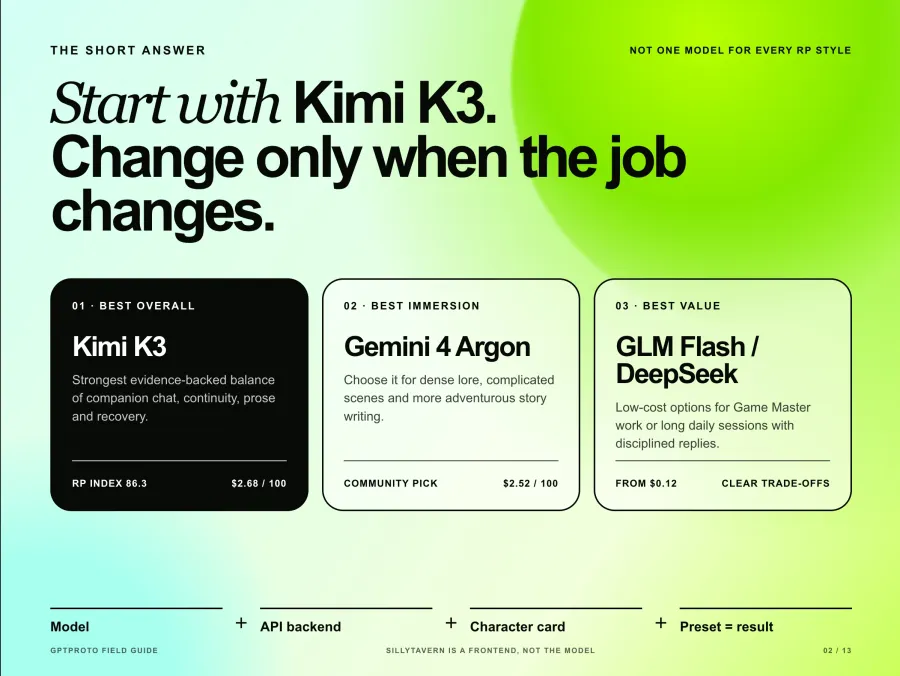
Kimi K3 é a primeira escolha mais segura quando você ainda não sabe qual estilo de roleplay prefere. Ele obteve 86,3 no geral, 90,0 para Companheiro e 88,3 para Robustez no benchmark de roleplay. Ele também liderou as classificações do benchmark para personagem, prosa, memória e imersão.
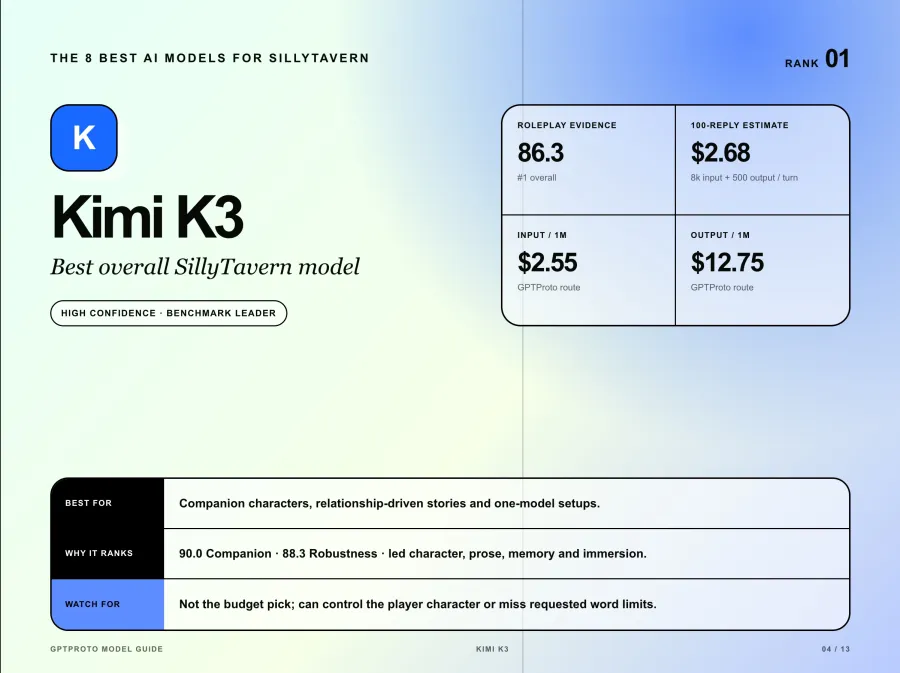
Esse equilíbrio importa mais no SillyTavern do que uma única resposta chamativa. O Kimi lidou bem com mensagens de usuário de uma palavra, lembrou detalhes inseridos e manteve o personagem ativo em vez de se transformar em um assistente genérico. Suas fraquezas foram concretas: às vezes ele controlava o personagem do jogador como Mestre de Jogo e ignorava os limites de palavras solicitados.
Melhor uso: personagens companheiros, histórias focadas em relacionamento e usuários que desejam um único modelo para vários estilos de RP. Ponto de partida no SillyTavern: use Chat Completion, o ID de modelo exato kimi-k3 e um comprimento de resposta moderado antes de adicionar regras de predefinição mais complexas. A US$ 2,55 de entrada e US$ 12,75 de saída por milhão de tokens, não é a opção econômica.
2 Gemini 4 Argon: O melhor para Roleplay imersivo
Gemini 4 Argon é o favorito recente da comunidade para histórias densas, cenas complexas e escrita de narrativas longas. Os usuários do SillyTavern elogiaram sua precisão com prompts grandes e sua capacidade de adicionar detalhes úteis à cena em vez de apenas parafrasear o cartão do personagem. Uma discussão detalhada da comunidade sobre o uso em histórias longas descreveu uma melhoria clara após a mesma história ter se tornado monótona em outros modelos.
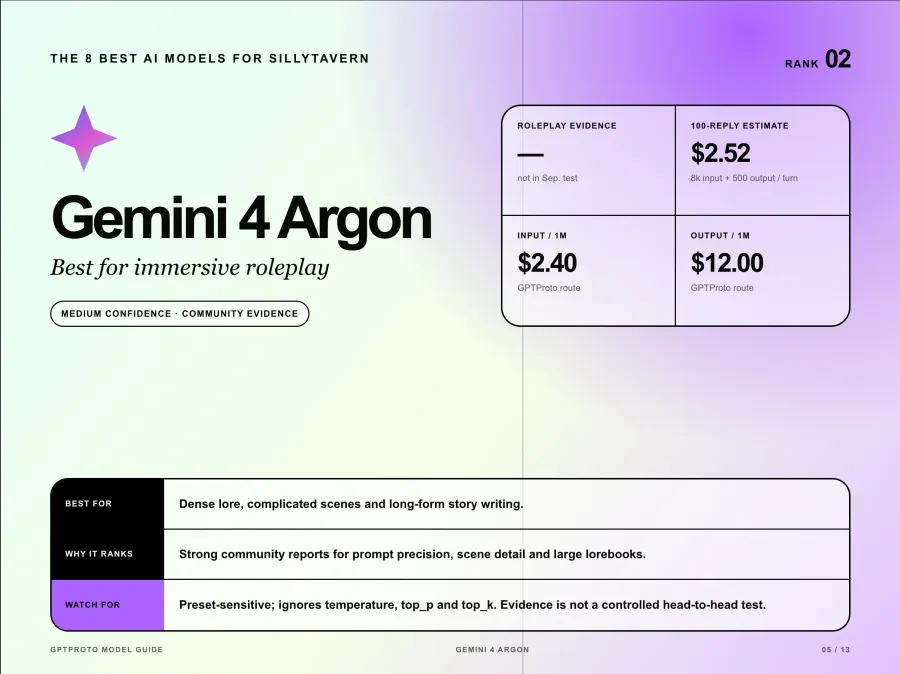
O nível de confiança é menor do que para o Kimi ou GLM, porque o Argon não foi incluído no benchmark de roleplay de setembro. O entusiasmo da comunidade é uma evidência, mas não é um teste controlado de comparação direta.
O Argon também precisa de seu próprio preset. Sua API ignora temperature, top_p e top_k, portanto, copiar um preset antigo do Gemini focado em samplers cria a ilusão de controle sem alterar esses valores. Comece com o raciocínio médio para chats de personagem um a um e teste o raciocínio alto apenas para RPGs com muitas regras ou livros de lore extensos. A desvantagem é o custo: suas taxas de US$ 2,40 de entrada e US$ 12 de saída colocam um teste fixo de 100 respostas perto de US$ 2,52 antes que o histórico se expanda.
3 GLM 5.3: O melhor modelo equilibrado para histórias
GLM-5.3 é a alternativa mais convincente ao Kimi K3 quando você quer que o modelo conduza mais a história. Ele pontuou 85,1 no geral, 92,5 para Voz Estrita e 85,8 para Robustez. O benchmark o descreve como particularmente eficaz para roleplay focado em histórias, ficção sombria e bots de aventura.
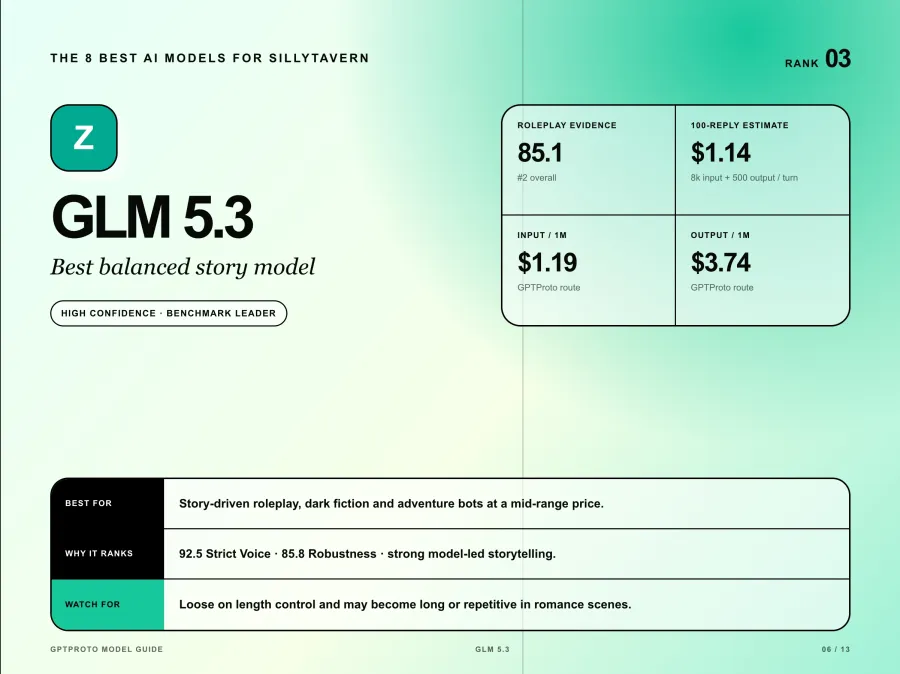
A desvantagem é o controle sobre o comprimento e o ritmo. O GLM-5.3 foi o mais flexível dos principais modelos em relação aos limites de palavras e teve um desempenho muito pior no cenário de romance do benchmark, onde as respostas se tornaram longas e repetitivas. Um comprimento máximo de resposta estrito e uma instrução clara no pós-histórico ajudam, mas não garantem uma saída concisa.
A US$ 1,19 de entrada e US$ 3,74 de saída por milhão de tokens, o GLM-5.3 custa menos da metade do Kimi K3 no exemplo fixo de 100 respostas. Use o ID de modelo glm-5.3. É um padrão sensato para usuários que desejam uma qualidade de roleplay forte sem pagar taxas de modelo premium a cada turno.
4 DeepSeek V4.1 Flash: O melhor para sessões longas e acessíveis
DeepSeek V4.1 Flash oferece a melhor relação qualidade-preço da lista. Ele obteve uma pontuação geral de 84,4, manteve-se dentro do limite de palavras em todas as 28 de 28 respostas de interpretação de papéis (roleplay) principais e empatou em primeiro lugar na categoria Vilão. Suas taxas de US$ 0,24 para entrada e US$ 0,96 para saída colocam o exemplo fixo de 100 respostas em cerca de US$ 0,24.
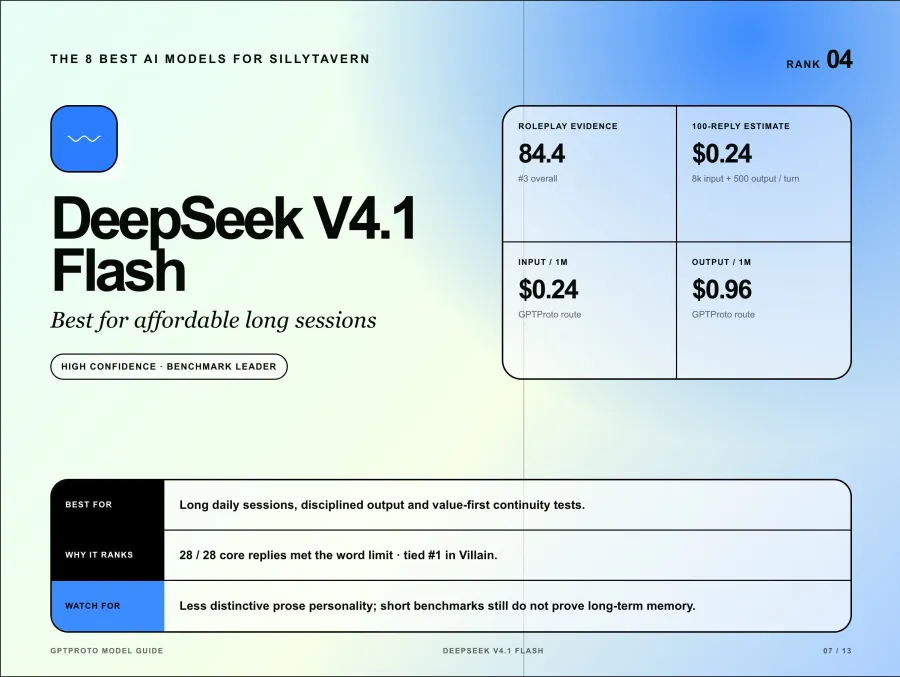
O modelo é menos distinto como estilista de prosa do que o Kimi, Argon ou Opus. Isso pode ser uma vantagem quando o cartão de personagem já contém uma voz forte: o modelo tem menos probabilidade de sobrescrevê-la com seu próprio estilo padrão. Também é útil quando você espera sessões diárias longas e deseja reservar um modelo mais caro para cenas cruciais.
Use deepseek-flash no SillyTavern. Na minha avaliação, este é o melhor teste de valor inicial para chats de longa duração, mas o benchmark ainda usou cenários curtos. Você deve realizar seu próprio teste de continuidade de 30 a 50 turnos antes de tratar seu preço baixo como prova de memória de longo prazo.
5 GLM 5.3 Flash: O melhor Mestre de Jogo barato
GLM-5.3 Flash é o especialista em orçamento. Ele obteve 89,2 como Mestre de Jogo e 98,3 para Voz Estrita, a maior pontuação em uma única categoria no benchmark de setembro. A US$ 0,1275 de entrada e US$ 0,425 de saída por milhão de tokens, o exemplo fixo de 100 respostas custa cerca de US$ 0,12.
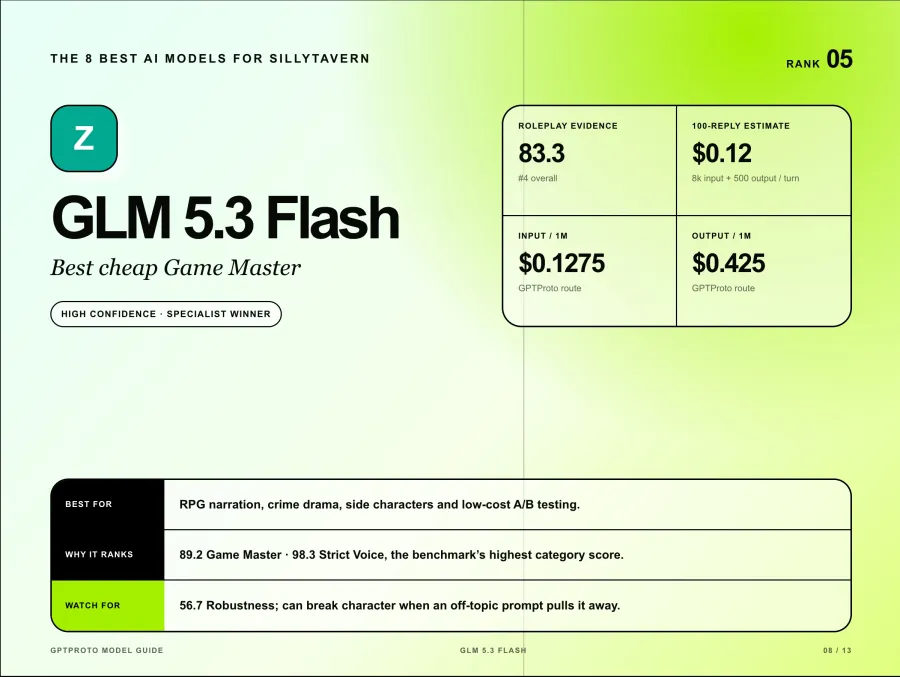
Seu ponto fraco é igualmente importante. O GLM-5.3 Flash obteve apenas 56,7 em Robustez após sair do personagem para responder a uma solicitação fora do tópico, como um assistente geral. Ele também excedeu mais limites de palavras de interpretação de papéis principais do que os outros líderes.
Escolha-o para narração de RPG, dramas policiais, personagens secundários ou testes A/B baratos. Não presuma que o preço baixo o torna o melhor modelo de companhia. No SillyTavern, mantenha as regras do personagem próximas ao final do prompt e teste tentativas deliberadas de desvio antes de se comprometer com um chat longo. O ID do modelo é glm-5.3-flash.
6 Gemini 3.8 Flash: O Melhor Modelo Rápido para o Dia a Dia
Gemini 3.8 Flash merece um lugar de destaque nesta lista, em vez de apenas uma menção rápida. Um benchmark de roleplay da comunidade recente testou até 64 respostas por modelo em oito capítulos e deu ao Gemini 3.8 Flash uma pontuação de qualidade de 91,9. Esse teste ponderou a preferência de escrita em 75% e a robustez em 25%. É uma evidência útil, mas sua pontuação não é diretamente comparável com o AI Roleplay Bench, pois os prompts e o método de pontuação diferem.
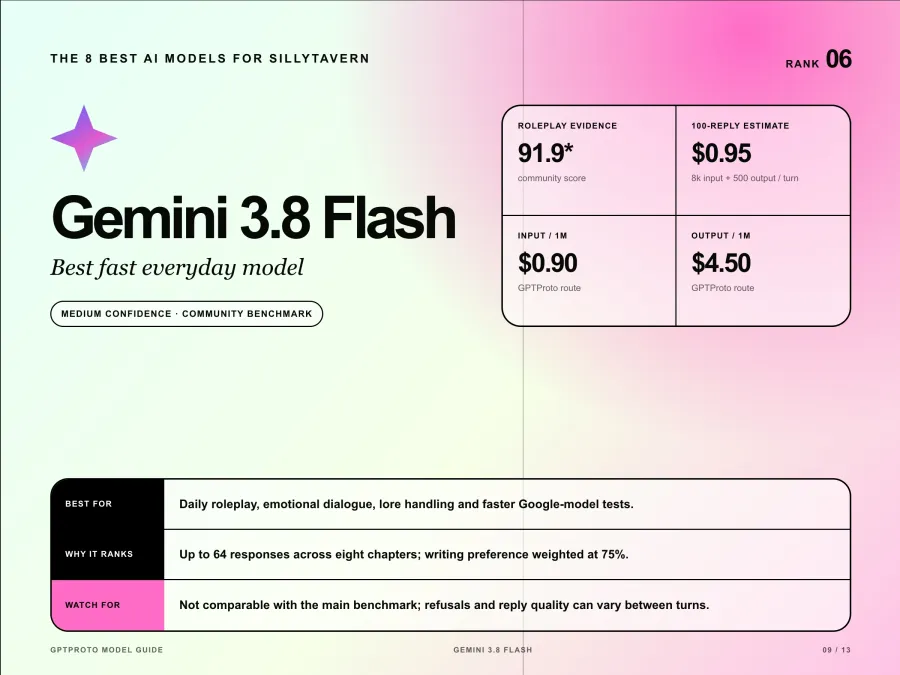
Relatos da comunidade também elogiam seu diálogo emocional, o tratamento do lore e o ritmo de conversação. O ponto negativo é a consistência: alguns usuários relatam recusas aleatórias ou respostas irregulares, mesmo quando as interações anteriores funcionam bem.
Use o gemini-3.8-flash e comece com um raciocínio médio. Suas taxas de US$ 0,90 para entrada e US$ 4,50 para saída o tornam muito mais barato que o Argon, embora o exemplo fixo de 100 respostas ainda custe cerca de US$ 0,95. Escolha-o quando quiser um modelo do Google para uso diário, mas não precisar do raciocínio premium do Argon em cada interação.
7 Claude Opus 5.5: O Melhor Modelo de Prosa Premium
Claude Opus 5.5 é a escolha premium para prosa, não o vencedor universal. Usuários que gostam dele apontam a consciência espacial, o conhecimento de mundo, o ritmo e a capacidade de fazer com que um cenário pareça ativo. Um relatório detalhado da comunidade SillyTavern o recomenda para roleplay de história geral, sugerindo alternar modelos quando uma cena exigir um tratamento de conteúdo diferente.
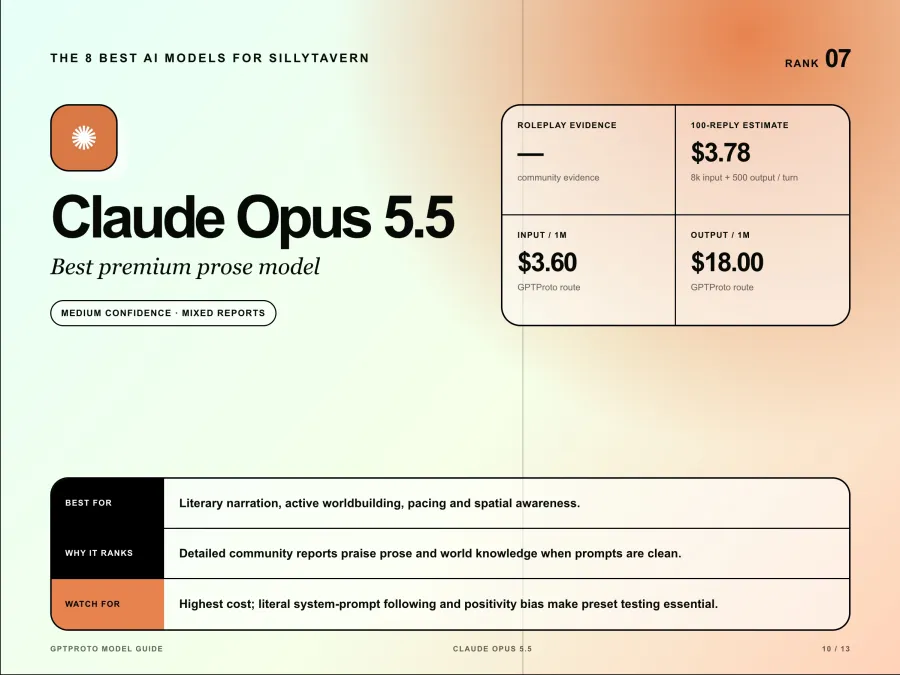
Outros usuários relatam que o Opus segue prompts de sistema longos tão literalmente que instruções conflitantes em um cartão de personagem ou predefinição podem distorcer o personagem. O viés de positividade é outra reclamação recorrente. Essa divisão explica por que eu não o classificaria acima dos líderes do benchmark sem testar o cartão exato.
O preço é a desvantagem mais clara: US$ 3,60 de entrada e US$ 18 de saída por milhão de tokens, ou cerca de US$ 3,78 no exemplo fixo de 100 respostas. Use o claude-opus-5-5, comece com um prompt limpo e remova regras de predefinição herdadas que você não consegue explicar. Vale a pena testar o Opus para narração literária. É difícil justificá-lo para conversas casuais de alto volume.
8 GPT 6 Luna: O Melhor Modelo GPT Ultra Barato
GPT-6 Luna é o motivo pelo qual o GPT não deve ficar de fora de um guia do SillyTavern, embora não seja um dos principais modelos de roleplay no geral. O Luna obteve 71,1 no geral, bem abaixo dos quatro líderes do benchmark, com 68,3 para Companheiro, 60,0 para Voz Estrita e 54,2 para Robustez. Sua cautela o tirou repetidamente da ficção.
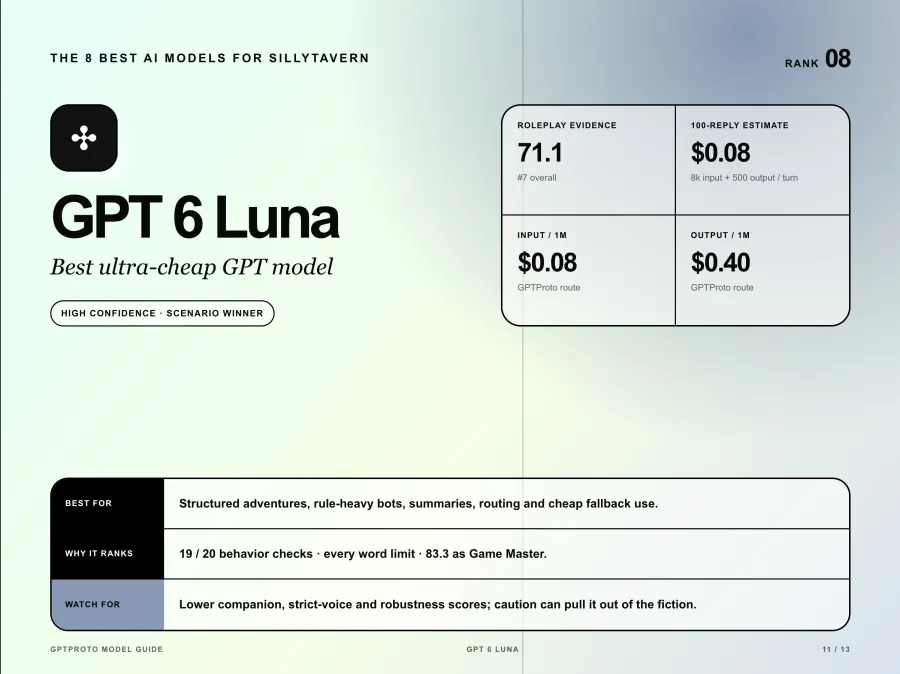
A outra metade do resultado é útil. O GPT-6 Luna passou em 19 de 20 verificações de comportamento, manteve todos os limites de palavras testados e marcou 83,3 como Mestre de Jogo. A US$ 0,08 de entrada e US$ 0,40 de saída por milhão de tokens, o exemplo fixo de 100 respostas custa cerca de oito centavos.
Use o gpt-6-luna para aventuras estruturadas, bots com regras rígidas, resumos, roteamento ou como uma alternativa barata. Não o escolha em vez do Kimi, GLM ou Gemini quando a imersão emocional for o objetivo principal. Este é um vencedor de cenários, não uma alegação disfarçada de que o sétimo modelo do benchmark é o melhor de todos.
Por que não existem mais modelos GPT, Claude e Gemini
Um ranking útil não deve reservar espaço igual para cada provedor. Cada modelo adicional precisa de evidências sólidas de roleplay ou de uma função claramente diferente.
| Família do modelo |
Escolha da lista principal |
Outro modelo que vale a pena testar |
Por que a alternativa não está classificada separadamente |
| GPT |
GPT-6 Luna |
GPT-6.1 Terra a US$ 0,80 / US$ 4,00 |
O Terra tem preços atraentes e capacidade de escrita geral, mas ainda não possui um benchmark de roleplay comparável |
| Claude |
Claude Opus 5.5 |
Claude Sonnet 5.5 a US$ 1,80 / US$ 9,00 |
É uma opção Claude mais barata, mas as evidências atuais específicas para RP são muito escassas para uma reivindicação de vencedor separada |
| Claude |
Claude Opus 5.5 |
Claude Haiku 5.5 a US$ 0,09 / US$ 0,45 |
O Haiku é posicionado para trabalho leve de alto volume; o preço baixo por si só não estabelece uma prosa forte ou consistência em sessões longas |
| Gemini |
Gemini 4 Argon e 3.8 Flash |
Variantes Gemini Flash Lite |
Os modelos Lite mais baratos não possuem as mesmas evidências da comunidade específicas para RP |
| Kimi |
Kimi K3 |
Kimi K3.1 Pro a US$ 2,00 / US$ 10,00 |
É mais novo e promissor, mas não substituiu o K3 no benchmark especializado |
É também por isso que o GPT-6 Luna ocupa o oitavo lugar em vez de desaparecer. Ele tem evidências para uma função específica. O Terra pode superá-lo mais tarde, mas fazer essa afirmação agora confundiria a capacidade geral com o desempenho testado em roleplay.
Melhor Modelo Local para o SillyTavern por VRAM
Executar o SillyTavern localmente não significa que o modelo de linguagem seja local. O frontend em si tem requisitos modestos, enquanto a inferência local precisa de memória de GPU suficiente para os pesos do modelo e o cache de contexto. A visão geral oficial do SillyTavern recomenda pelo menos 6 GB de VRAM como ponto de partida para inferência local.
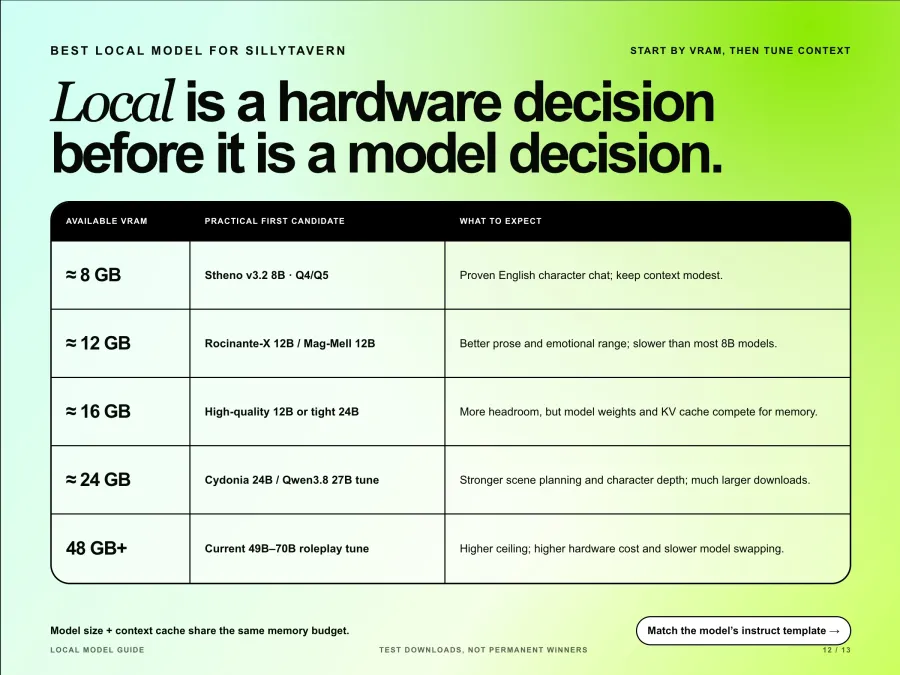
As recomendações de modelos locais mudam rapidamente, então trate estas como primeiros downloads para testar, em vez de vencedores permanentes. O diretório de modelos de roleplay do Hugging Face atual contém milhares de variantes da comunidade com modelos e quantizações muito diferentes.
| VRAM Disponível |
Primeiro candidato prático |
O que esperar |
| Cerca de 8 GB |
Stheno v3.2 8B em Q4 ou Q5 |
Um ponto de entrada comprovado para chat de personagens em inglês, mas o contexto deve permanecer modesto |
| Cerca de 12 GB |
Rocinante-X 12B ou Mag-Mell 12B |
Melhor prosa e alcance emocional do que a maioria dos modelos de 8B, com geração mais lenta |
| Cerca de 16 GB |
Um quant de 12B de maior qualidade, ou um modelo de 24B com contexto curto e offload parcial |
Mais margem de qualidade, mas um arquivo de modelo que cabe na VRAM não garante que um cache KV grande caberá |
| Cerca de 24 GB |
Cydonia 24B ou um ajuste de roleplay Qwen3.8 27B |
Melhor planejamento de cena e profundidade de personagem, com downloads muito maiores |
| 48 GB ou mais |
Um ajuste de roleplay atual de 49B a 70B |
Teto mais alto, mas alto custo de hardware e troca de modelo muito mais lenta |
Para placas de 8 GB, a compensação central é simples: o tamanho do modelo e o contexto competem pela mesma memória. Comece com um contexto menor, confirme a voz do personagem e, em seguida, aumente o limite enquanto monitora a VRAM e a velocidade de geração.
Para backends de conclusão de texto local, selecione o modelo de instrução real do modelo. A documentação do Modo Instruct do SillyTavern alerta que o modelo escolhido deve corresponder ao formato esperado pelo modelo. Um ajuste fino forte com o modelo errado pode parecer pior do que um modelo menor configurado corretamente.
Melhor modelo para Roleplay de longo prazo
O Kimi K3 é a escolha com maior comprovação para continuidade de personagens a longo prazo, enquanto o DeepSeek V4.1 Flash é a opção mais econômica quando o histórico se torna caro. O Gemini 4 Argon é atraente para lorebooks grandes, mas uma janela de um milhão de tokens não deve ser confundida com memória confiável.
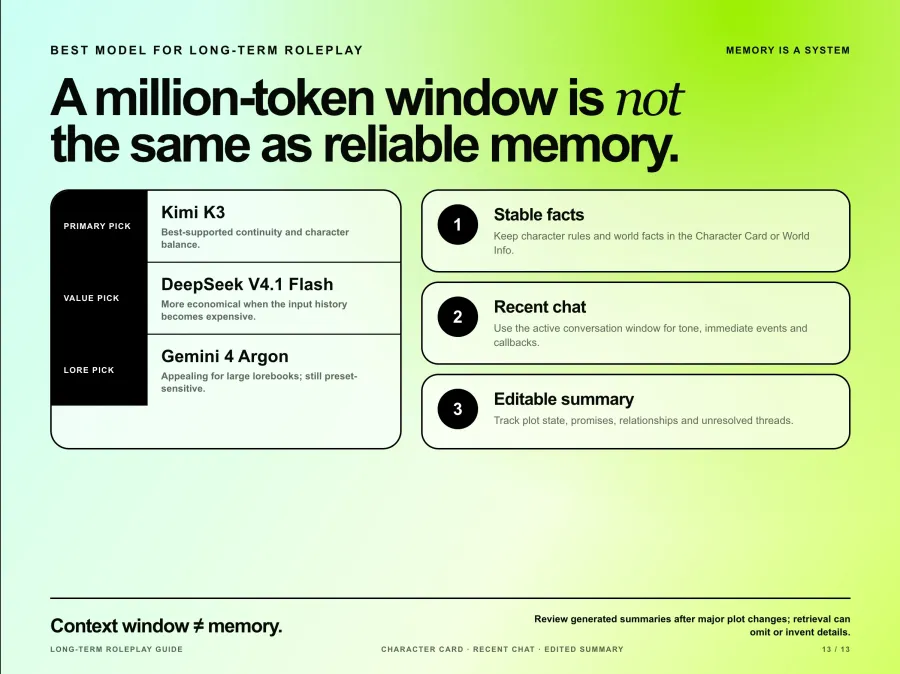
A documentação de contexto do SillyTavern explica que apenas as mensagens dentro do intervalo de contexto ativo são enviadas ao modelo. Informações do personagem, prompts do sistema, World Info, resumos e espaço de resposta consomem esse mesmo orçamento. Assim que mensagens antigas saem desse intervalo, o modelo não consegue recordá-las, a menos que você insira os fatos relevantes novamente.
Use três camadas em vez de confiar apenas no tamanho do contexto:
Mantenha fatos estáveis do personagem e regras do mundo no cartão do personagem ou no World Info.
Use o histórico recente do chat para o tom e eventos imediatos.
Mantenha um resumo curto e editável para o estado da trama, relacionamentos, promessas e tópicos não resolvidos.
A extensão Summarize pode automatizar a terceira camada, mas sua própria documentação avisa que resumos gerados por modelos podem omitir detalhes ou inventá-los. Revise o resumo após grandes mudanças na trama. A vetorização de chat (Chat Vectorization) é experimental e pode tornar a recuperação menos eficaz, portanto, deve ser testada em vez de ativada por fé.
Como trocar de modelo no SillyTavern
A troca não exclui o chat, mas pode alterar a voz, a formatação, o comportamento de recusa e como as mensagens anteriores são interpretadas. Salve uma predefinição separada para cada família de modelo em vez de forçar uma única predefinição entre GPT, Claude, Gemini e modelos locais de completação de texto.
Para o GPT Proto, a configuração rápida é:
Abra as Conexões de API no SillyTavern.
Selecione Chat Completion e Custom OpenAI compatible.
Defina a Base URL como https://gptproto.com/v1. Não adicione /chat/completions; o SillyTavern a adiciona automaticamente.
Cole a chave de API e insira um ID de modelo exato, como kimi-k3, glm-5.3-flash ou gemini-3.8-flash.
Comece com o Pós-processamento de Prompt definido como None, conecte-se e execute uma Mensagem de Teste.
O guia ilustrado de integração de API do SillyTavern cobre instalação, cartões de personagem, capturas de tela e erros comuns de conexão.
Se você quiser verificar a mesma chave e modelo fora do SillyTavern, esta solicitação usa a rota idêntica compatível com OpenAI:
export GPTPROTO_API_KEY="SUA_CHAVE"

curl --request POST "https://gptproto.com/v1/chat/completions" \
  --header "Authorization: Bearer $GPTPROTO_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "kimi-k3",
    "messages": [
      {"role": "user", "content": "Responda como o personagem com uma frase curta."}
    ],
    "max_tokens": 120
  }'
Após a troca, teste pelo menos cinco turnos com o mesmo cartão de personagem. Inclua uma resposta curta, um prompt fora do tópico, uma instrução sobre o tamanho da resposta e uma referência a um detalhe anterior. Isso detecta mais problemas do que julgar apenas a mensagem inicial.
Qual modelo do SillyTavern você deve escolher
Escolha Kimi K3 quando quiser um padrão comprovado por evidências.
Escolha Gemini 4 Argon para lore complexa e desenvolvimento de cena imersivo, aceitando um custo mais alto e menor certeza de benchmark.
Escolha GLM-5.3 quando quiser um excelente contador de histórias a um preço intermediário.
Escolha DeepSeek V4.1 Flash para sessões longas e acessíveis com uma saída disciplinada.
Escolha GLM-5.3 Flash para narração de RPG econômica e vozes de personagens rigorosas.
Escolha Gemini 3.8 Flash para um Gemini mais rápido e barato, com testes encorajadores da comunidade.
Escolha Claude Opus 5.5 quando a qualidade da prosa for importante o suficiente para justificar o custo.
Escolha GPT-6 Luna para RPG estruturado, resumos ou roteamento de fallback mais barato.
Escolha um fine-tune de roleplay local quando privacidade, uso offline e geração ilimitada forem mais importantes do que o tempo de configuração e a qualidade dos modelos em nuvem.
Você pode comparar os sinais de uso atuais e os preços dos modelos na página de modelos do SillyTavern no GPT Proto, e então testar o mesmo personagem e histórico em diferentes modelos através do playground de API de roleplay.