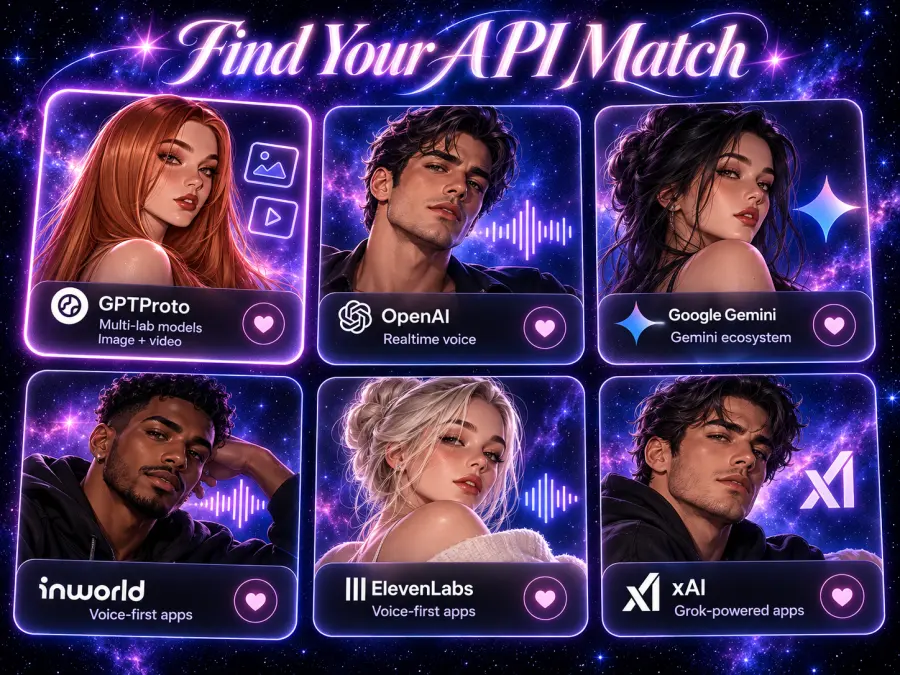
Principais provedores de API para aplicativos de companhia de IA em um relance
| Provedor |
Melhor uso |
Capacidades a avaliar |
Principal compensação |
| GPT Proto |
Combinar modelos de diferentes laboratórios com conteúdo visual |
Suporte a modelos de chat, imagem e vídeo sob uma única chave e saldo |
Seu aplicativo ainda gerencia o estado do personagem e a memória persistente |
| OpenAI |
Integração direta com modelos de voz em tempo real da OpenAI |
Texto, geração de imagem, fala e interação de áudio em tempo real |
O acesso a outras famílias de modelos requer integrações adicionais |
| Google Gemini API |
Produtos que utilizam o ecossistema de IA do Google |
Chat Gemini, interação ao vivo, geração de imagem e modelos de vídeo |
A entrada ao vivo e a mídia gerada usam capacidades de modelo diferentes |
| Inworld |
Experiências de voz em tempo real configuráveis |
STT, LLMs selecionáveis, TTS, além de inferência de imagem e vídeo |
A memória entre sessões requer armazenamento e restauração pelo aplicativo |
| ElevenLabs |
Produtos focados em voz que também precisam de conteúdo visual |
Agentes, vozes configuráveis e APIs de geração de imagem/vídeo |
O acesso à API de mídia tem um requisito de assinatura |
| xAI |
Produtos construídos em torno do Grok |
Chat, geração de imagem/vídeo Imagine e APIs de voz |
Cada recurso tem seus próprios requisitos de solicitação e faturamento |
Como selecionamos estes provedores de API
Este é um guia de seleção baseado em documentação, verificado em 27 de outubro de 2026. As recomendações refletem as capacidades disponíveis, requisitos de integração e estruturas de faturamento publicadas. Elas não representam um ranking medido de qualidade de diálogo ou velocidade de resposta.
Priorizei provedores que um desenvolvedor poderia avaliar para um produto de companhia, depois considerei a escolha do modelo, suporte a mídia, trabalho de aplicação e custo. Uma comparação útil deve explicar se um serviço fornece inferência de modelo, um pipeline de conversação por voz ou infraestrutura de produto adicional.
Projetos reais mostram por que essa distinção é importante. O projeto de companhia de código aberto Utsuwa configura provedores de LLM e conversão de texto em fala separadamente. Seu aplicativo recupera o histórico de conversas, injeta memórias relevantes e ajusta o contexto para se adequar ao modelo selecionado. A seleção do provedor é apenas uma parte desse sistema.
Para mais exemplos, explore os aplicativos de chat com personagens e seu uso de modelos do GPT Proto. Use as listagens para investigar padrões de aplicação e escolhas de modelos. Eles não estabelecem qual fornecedor terá o melhor desempenho para o seu próprio aplicativo.
6 provedores de API para considerar para seu aplicativo de companhia
1. GPT Proto para combinar modelos de chat, imagem e vídeo
O GPT Proto é o ponto de partida mais sólido nesta lista quando você deseja comparar diferentes famílias de modelos e adicionar recursos visuais gerados através da mesma conta. Sua API de IA para roleplay oferece um espaço para avaliar prompts de personagens e comparar modelos suportados antes de se comprometer com um deles.
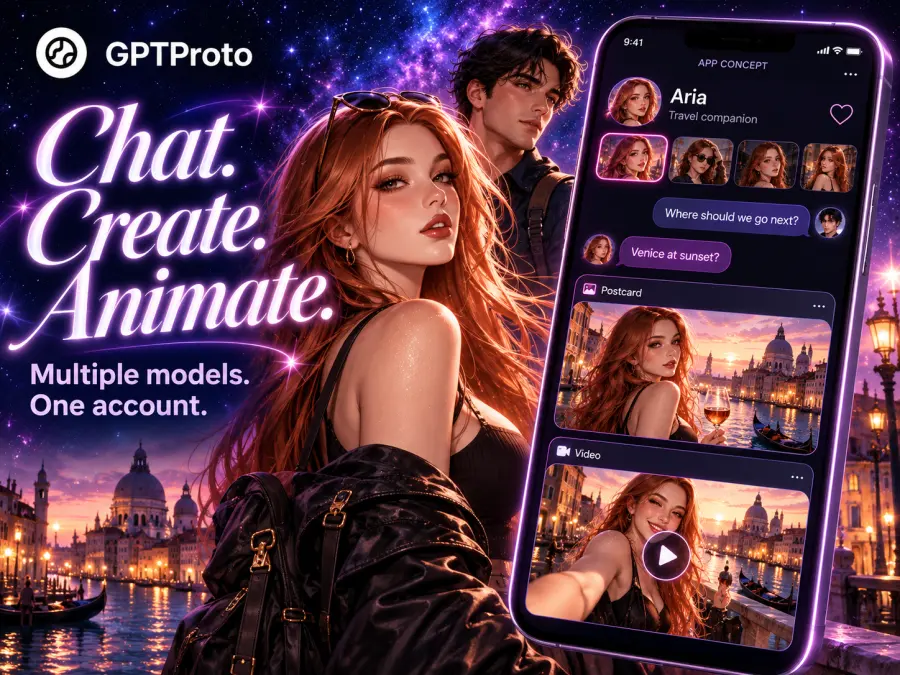
Considere um companheiro de viagem fictício: um modelo de chat escreve a conversa, um modelo de imagem cria um cartão-postal do personagem e um modelo de vídeo anima uma cena. Essas tarefas podem usar modelos diferentes. O GPT Proto possui páginas dedicadas para opções como geração de imagem Nano Banana 2.1 e geração de vídeo Kling 4.0, com exemplos de solicitação específicos para cada modelo.
O acesso compartilhado reduz a quantidade de contas e saldos que sua equipe precisa gerenciar. A integração ainda requer um tratamento separado para cada tarefa. Uma solicitação de conclusão de chat e um trabalho de vídeo assíncrono possuem ciclos de vida diferentes.
Para uma referência de orçamento concreta, o GPT-6 Luna no GPT Proto lista US$ 0,08 por milhão de tokens de entrada e US$ 0,40 por milhão de tokens de saída. Isso o torna um candidato para experimentos de chat de baixo custo; a qualidade do personagem precisa de sua própria avaliação.
Escolha o GPT Proto quando a flexibilidade de modelos e os recursos visuais forem prioridades. Integre memória, permissões de usuário e estado de personagem ao seu aplicativo, e verifique qualquer recurso de voz em tempo real necessário separadamente.
2. OpenAI para acesso direto a modelos de voz em tempo real
A OpenAI é uma escolha prática quando os requisitos do seu produto se concentram em seus modelos e na interação por voz em tempo real. A API Realtime processa áudio diretamente, mantém o estado da conversa e suporta ferramentas. Seu fluxo de navegador documentado usa um segredo de cliente efêmero e WebRTC; conexões de servidor podem usar WebSocket.
Isso é útil para um companheiro falante que precisa lidar com interrupções ou chamar uma ferramenta durante a conversa. Você pode desenvolver usando a API original e seus SDKs, com menos serviços intermediários para investigar quando um recurso específico do modelo se comporta de maneira inesperada.
A limitação é a escolha de modelos entre fornecedores. Se o seu produto precisar posteriormente do estilo de diálogo de outro laboratório ou de um modelo de imagem diferente, você mesmo adicionará essa integração. O estado da conversa armazenado também precisa de um design explícito para o histórico do usuário e recuperação de memória.
Para vídeo, verifique a disponibilidade atual com cuidado. O aviso de descontinuação da OpenAI lista o encerramento da API de Vídeos e da API Sora 2 em 24 de setembro de 2026. Um tutorial antigo acessível não é evidência suficiente de que seu endpoint permanece disponível.
Escolha a OpenAI quando o acesso direto às suas capacidades em tempo real superar a necessidade de alternar entre famílias de modelos.
3. Google Gemini API para aplicativos criados em torno da Google AI
Vale a pena considerar o Google se você já utiliza o ecossistema de desenvolvedores da empresa e deseja avaliar recursos de conversação, entrada visual, imagens geradas e vídeo dentro desse ambiente.
A Gemini Live API oferece suporte a interações via streaming, com conexões WebSocket de frontend ou backend. O Google recomenda tokens efêmeros para conexões de clientes em produção. Isso pode ser adequado para um companheiro que responde a entradas de voz e informações de uma câmera ou tela compartilhada.
Vídeo gerado é uma seleção à parte. O guia de vídeo do Gemini atual orienta os desenvolvedores para o Gemini Omni Flash e o diferencia dos endpoints descontinuados do Veo 3.1 Preview. Para um personagem que envia uma curta mensagem animada, avalie um modelo de geração em vez de presumir que a entrada de vídeo Live forneça essa saída.
O trabalho prático consiste em selecionar e testar os modelos certos para cada recurso. Um produto pode exigir configurações, limites de uso e cálculos de cobrança diferentes para chat, voz e mídia. Mantenha esses custos separados em sua previsão.
Escolha o Google quando o ecossistema deles se adequar ao seu aplicativo e você se sentir confortável em selecionar modelos diferentes para interações diferentes.
4. Inworld para pipelines de voz em tempo real configuráveis
O Inworld merece uma análise detalhada quando a conversação por voz é central para a experiência. Sua Realtime API combina conversão de fala em texto, o LLM de sua escolha e conversão de texto em fala, enquanto gerencia a detecção de turnos e interrupções via WebSocket ou WebRTC.
Ele também possui uma cobertura de mídia mais ampla. O Inworld Inference expõe modelos de texto, imagem e vídeo, portanto, descrever a plataforma apenas como um serviço de voz seria ignorar parte de sua oferta.
O limite importante é a memória persistente. Sua documentação de memória de longo prazo explica que as sessões em tempo real são temporárias. Seu cliente deve salvar a memória externamente e restaurá-la para uma sessão futura. Esta é uma responsabilidade concreta do aplicativo a ser incluída nas estimativas de desenvolvimento.
Para avaliação de custos, rastreie o reconhecimento de fala, o consumo de LLM e a fala gerada separadamente, e então adicione o uso de mídia. Um preço unitário baixo de TTS não define o preço de uma conversa inteira.
Escolha o Inworld quando a interação por voz configurável for um requisito central e você quiser menos trabalho de orquestração. Planeje o fluxo de banco de dados e restauração de memória juntamente com a integração de voz.
5. ElevenLabs para aplicativos orientados por voz com recursos visuais
O ElevenLabs é um candidato quando você deseja que a configuração de voz e os controles de conversação façam parte da plataforma que você adquire. O ElevenAgents oferece suporte à seleção de modelos de linguagem, turnos de fala, interrupções e implantação por meio de integrações web e móveis.
Sua oferta de imagem e vídeo altera a comparação. O guia da API de Imagem e Vídeo documenta endpoints de geração assíncrona separados, com resultados coletados por meio de webhooks ou polling. O acesso requer um plano Pro ou superior e as permissões de API relevantes.
Esse requisito de assinatura é importante para um pequeno protótipo. Compare o uso esperado dos recursos com os serviços disponíveis no plano que você pretende adquirir. As gerações de mídia consomem créditos de acordo com o modelo, as configurações e as entradas selecionadas; uma franquia de voz não deve ser tratada como um orçamento de mídia ilimitado.
Existe outra distinção de custo: a documentação do modelo de agente contabiliza o uso de LLMs de terceiros separadamente. Estime a configuração de conversação que você realmente implantará em vez de usar o preço de voz principal como o total.
Escolha o ElevenLabs quando a configuração de voz e as ferramentas de agente justificarem os requisitos da plataforma. Verifique o acesso à mídia antes de projetar recursos de imagem ou vídeo de personagem em torno dele.
6. xAI para aplicativos criados em torno dos modelos Grok
O xAI é relevante quando você deseja especificamente o Grok como o modelo de conversação e quer avaliar recursos relacionados de mídia e fala.
A documentação do Imagine abrange a geração e edição de imagens, além da geração de vídeo. Isso oferece aos desenvolvedores um caminho para testar uma conversa de personagem e conteúdo visual gerado dentro do ecossistema do mesmo fornecedor.
A voz deve ser avaliada por meio de sua própria documentação da API de Voz. Mantenha a interação por voz, o chat de texto e os clipes gerados como itens de integração e orçamento separados, mesmo quando eles compartilham a mesma conta.
Você ainda está criando o produto de companhia. Uma API de modelo não fornece automaticamente os ativos de personagem, o estado de relacionamento persistente ou a interface encontrados em um aplicativo de companhia para o consumidor. Verifique as entradas, saídas e controles reais da API em relação aos recursos em sua especificação.
Escolha o xAI quando o próprio Grok fizer parte da decisão do produto. Se sua prioridade for comparar muitas famílias de modelos, inclua também um serviço de múltiplos modelos na avaliação.
Quanto custa realmente um aplicativo de companhia de IA
Uma cotação de tokens torna-se útil quando você a conecta a uma carga de trabalho definida. Conversas longas podem reenviar instruções de personagem, memórias recuperadas e histórico recente a cada solicitação. Meça a entrada que seu aplicativo envia.
Aqui está uma carga de trabalho hipotética apenas de texto: 1.000 sessões, 50 respostas por sessão, uma média de 2.000 tokens de entrada por solicitação e 200 tokens de saída faturáveis por resposta. Isso produz 100 milhões de tokens de entrada e 10 milhões de tokens de saída.
| Mesmo modelo e carga de trabalho |
GPT Proto GPT-6 Luna |
OpenAI GPT-6 Luna |
| Preço de entrada por milhão de tokens |
$0,08 |
$0,10 |
| Preço de saída por milhão de tokens |
$0,40 |
$0,50 |
| Custo para 100 milhões de tokens de entrada |
$8 |
$10 |
| Custo para 10 milhões de tokens de saída |
$4 |
$5 |
| Estimativa total de inferência de texto |
$12 |
$15 |
As taxas provêm da página de modelos da GPT Proto e da documentação do modelo OpenAI GPT-6 Luna. Este cálculo utiliza taxas de texto padrão não armazenadas em cache e não assume nenhuma saída de raciocínio além da franquia de tokens declarada. Exclui cobranças de gravação em cache, novas tentativas, mídia, processamento de memória, armazenamento e impostos. É uma ilustração de custo de compra, não uma comparação medida de qualidade de companhia.
Para um produto multimodal, adicione o seguinte uso à previsão:
| Recurso |
O que medir |
| Memória persistente |
Chamadas de extração ou resumo, embeddings onde usados, recuperação e armazenamento |
| Imagens de personagem |
Imagens solicitadas, resolução, entradas de referência e gerações repetidas |
| Vídeos curtos |
Duração gerada, resolução, ativos de entrada, configurações de áudio e novas tentativas faturadas |
| Conversa falada |
Reconhecimento, uso de LLM, saída de voz e quaisquer cobranças de plataforma ou conexão |
A latência também faz parte da avaliação do produto. Em uma conta de desenvolvimento de companhia para desktop, o autor combinou inferência em nuvem com fala local e memória de banco de dados, e então relatou atrasos provenientes da chamada de ferramentas. É uma experiência individual, mas ilustra por que um modelo de texto rápido, por si só, não pode determinar o tempo de espera que os usuários experimentam.
Conecte um modelo de chat e planeje seu fluxo de trabalho de mídia
Comece com uma breve conversa com o personagem. Crie uma chave de API do GPT Proto, adicione créditos e defina a variável de ambiente GPTPROTO_API_KEY no seu servidor. A página do modelo GPT-6 Luna fornece o exemplo de uso da API atual.
curl --fail-with-body --silent --show-error \
  https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  --data '{
    "model": "gpt-6-luna",
    "messages": [
      {
        "role": "system",
        "content": "You are Mira, a fictional travel companion. Be warm and concise."
      },
      {
        "role": "user",
        "content": "I have one free afternoon in Kyoto and prefer quiet places."
      }
    ]
  }'
Leia a resposta de choices[0].message.content. Esta solicitação fornece uma instrução de personagem e uma mensagem. Para continuar o diálogo, seu backend deve reunir a conversa relevante e as memórias para cada chamada. Mantenha a chave de API permanente fora do código do navegador e de pacotes móveis.
Em seguida, selecione um modelo de imagem ou vídeo em sua própria página. Use as instruções de uso da API da página do modelo ao pedir ao seu assistente de codificação para criar a integração. Preserve o endpoint documentado, a autenticação, os parâmetros e o fluxo de tratamento de resultados.
Uma tarefa de mídia assíncrona precisa de um ID de trabalho salvo e um manipulador de conclusão. Sua interface pode mostrar uma imagem ou vídeo pendente enquanto o chat continua. Conectar cada tarefa ao endpoint de chat-completions não reproduzirá esses recursos separados.
Qual provedor de API você deve escolher
| Seu primeiro marco de produto |
Lista de opções |
O que validar antes de se comprometer |
| MVP de companheiro de texto |
GPT Proto ou uma API de modelo direta |
Comportamento do personagem, custo por conversa, gerenciamento de memória |
| Chat com imagens e clipes de personagens |
GPT Proto, Google, Inworld, ElevenLabs ou xAI |
Disponibilidade exata do modelo, acesso à mídia, referências e fluxo de conclusão de tarefas |
| Companheiro falante em tempo real |
OpenAI, Inworld, ElevenLabs ou Gemini Live |
Interrupções, primeira resposta audível, consistência de voz e custo total da sessão |
| Produto criado especificamente em torno do Grok |
xAI |
Recursos de API necessários e o trabalho do aplicativo além do acesso ao modelo |
Para uma equipe que ainda está explorando seu modelo de diálogo e recursos visuais, eu começaria com o GPT Proto e uma pequena avaliação repetível. Use as mesmas instruções de personagem e histórico de conversa, depois compare os modelos suportados antes de construir o restante do produto em torno de um deles.
A seleção do modelo merece uma análise separada. Nosso guia sobre os melhores modelos de IA para roleplay foca nos modelos de diálogo subjacentes. Use-o para restringir os candidatos e, em seguida, teste seus próprios personagens e padrões de sessão.
Comece com a API de IA para roleplay do GPT Proto para comparar uma conversa de personagem e adicione a geração visual assim que a experiência de chat atender aos seus requisitos.