Kimi K3.1 Pro vs Opus 5.5 em resumo
| Item |
Kimi K3.1 Pro |
Claude Opus 5.5 |
| Preço oficial de entrada / saída por 1 milhão de tokens |
$2 / $10 |
$4 / $20 |
| Preço GPT Proto de entrada / saída por 1 milhão de tokens |
$2 / $10 |
$3.60 / $18 |
| Janela de contexto |
Cerca de 1 milhão de tokens |
1 milhão de tokens |
| Entrada / saída do modelo |
Texto e imagens / texto |
Texto e imagens / texto |
| Esforço de raciocínio padrão da API nativa |
Máximo |
Médio |
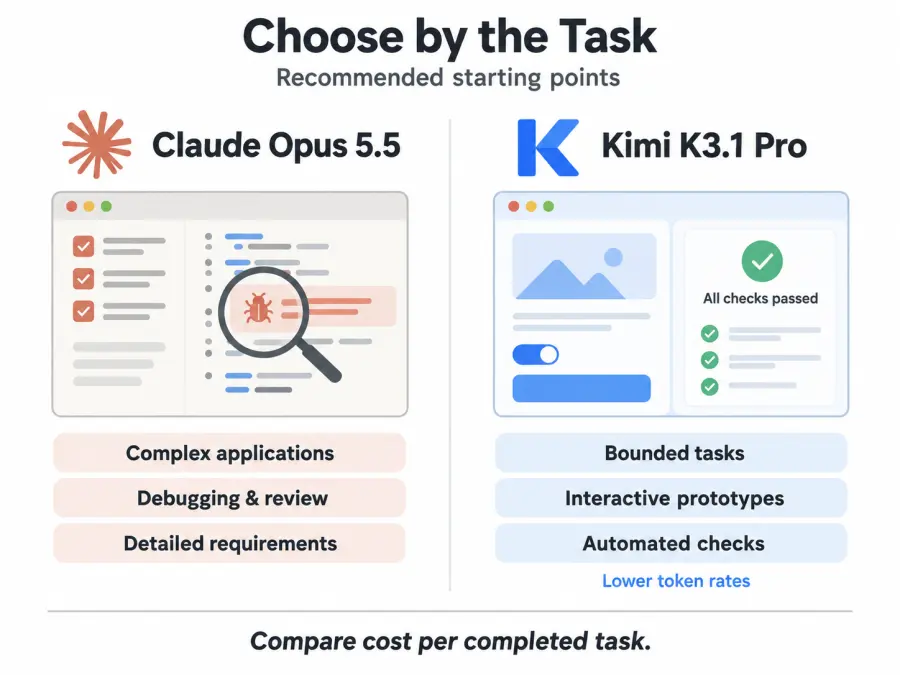
| Minha recomendação para o primeiro teste |
Tarefas delimitadas com verificações claras |
Desenvolvimento complexo e revisão final |
Os preços foram verificados em 29 de outubro de 2026. As especificações oficiais vêm da documentação da API do Kimi e da documentação do modelo Claude. As taxas do GPT Proto estão listadas na página da API do Kimi K3.1 Pro e na página da API do Claude Opus 5.5. Operações de cache e outras cobranças aplicáveis precisam de contabilização separada.
Para uma comparação rápida de catálogo, use a página de comparação entre Kimi K3.1 Pro e Claude Opus 5.5. Para o contexto sobre este lançamento do Kimi, veja o que mudou no Kimi K3.1 Pro.
O que os benchmarks nos dizem sobre programação e o que eles deixam de fora
A comparação de lançamento publicada pela Moonshot relata 65,7% para o Kimi K3.1 Pro e 66,4% para o Opus 5.5 no Terminal-Bench 4.0. Estes são números publicados pelo fornecedor, aguardando verificação independente dessa comparação específica. Eles apoiam levar o Kimi a sério para trabalhos baseados em terminal; eles não estabelecem desempenho igual em todo o desenvolvimento de aplicativos.
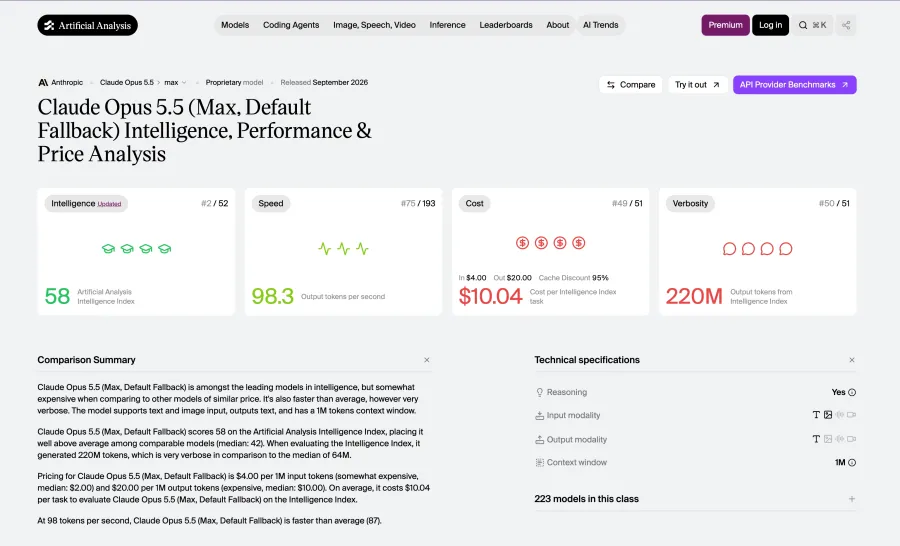
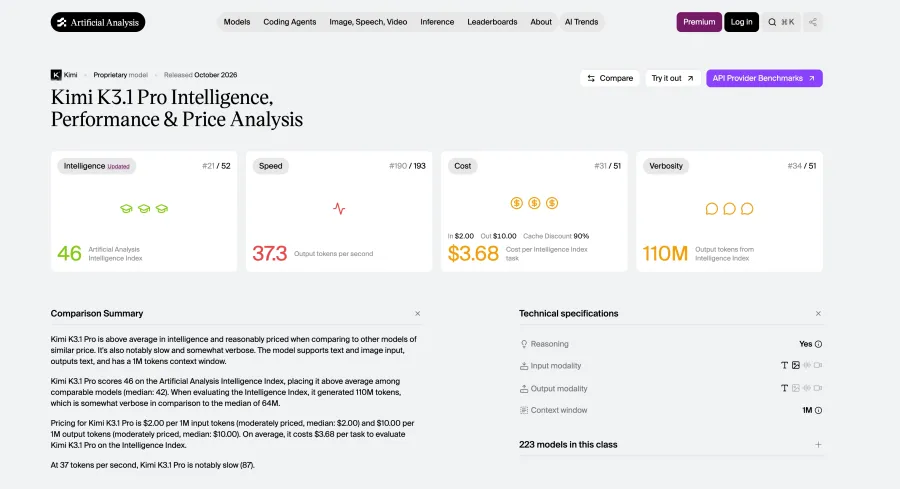
O panorama independente mais amplo é diferente. Em 29 de outubro, as páginas do modelo do Artificial Analysis Intelligence Index v5.0 mostravam o Kimi com 46 e o Opus com 58, sendo este último rotulado como Máximo com Fallback Padrão. Esses pontos do índice não são porcentagens ou uma taxa de sucesso de codificação. Mantenha a versão do índice e a configuração anexadas à comparação.
Eu trataria o Opus como a linha de base de qualidade inicial para trabalhos exigentes e, em seguida, testaria se o Kimi atende aos mesmos critérios de aceitação a um custo menor. Um benchmark de terminal não pode dizer se um formulário de reserva preserva seu estado ou se um painel permanece legível em dispositivos móveis. Seus testes de aplicativo precisam responder a isso.
Codificação de Frontend: De uma captura de tela a uma interface funcional
Para uma tarefa de conversão de captura de tela em interface, separe a aparência do comportamento. Um layout fiel ainda precisa de navegação funcional, estados de formulário, acesso via teclado e uma versão móvel utilizável. Depois, peça uma alteração. Adicionar um filtro sem quebrar o layout existente é um teste diferente de gerar uma página do zero.
Existe um exemplo útil para desenvolvedores aqui. Na comparação publicada por Melvynx, ele preferiu o tratamento visual do Opus para um verificador de fuso horário. Esse é um julgamento estético sobre uma construção específica, e não uma taxa de sucesso de frontend medida.
Para um site de marketing ou um painel voltado ao cliente, minha primeira escolha seria o Opus quando o design precisa de distinção e refinamento repetido. O Kimi é um candidato sensato para uma interface interna com um sistema de design claro, especialmente quando você pode inspecionar o resultado antes do lançamento. A compensação é o tempo gasto corrigindo o que o prompt inicial deixa em aberto.
Considere uma interface de reserva como um resumo de avaliação. Forneça a ambos os modelos a mesma imagem de referência, biblioteca de componentes existente e requisitos para seleção de data, horários indisponíveis, validação e confirmação. Peça a cada um que conecte a interface à mesma API simulada. Em seguida, introduza uma solicitação com falha e verifique se o usuário consegue se recuperar sem perder o formulário.
Essa última etapa torna esta uma comparação de aplicativos. Ela expõe se uma página atraente também lida com a próxima ação do cliente.
Aplicativos Interativos e 3D: Qualidade Visual, Lógica e Desempenho em Tempo de Execução
O caso do Kimi torna-se mais interessante em trabalhos visuais interativos. O exemplo de lâmpada de lava de Melvynx incluía controles de iluminação e cor. Ele classificou o resultado de maior esforço do Opus como o melhor, embora tenha achado os materiais e efeitos de vidro do Kimi convincentes. Seus custos de execução relatados foram de US$ 2,30 para o Kimi High e US$ 4,16 para o Max, contra US$ 4,35 para o Opus Medium e US$ 6,39 para o Extra High.
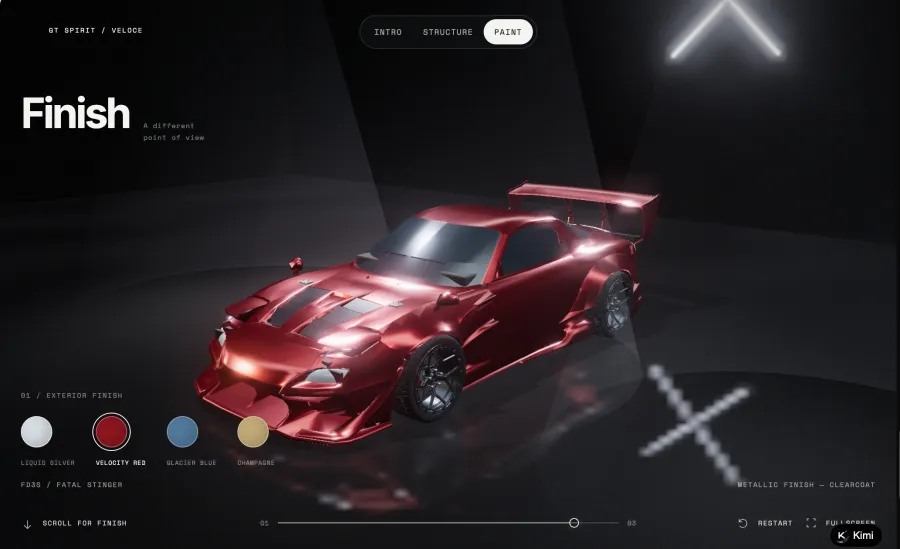
A mesma análise descreve uma simulação de colisão que funcionou melhor no Kimi High do que no Max. O autor divulga um link de afiliado do Kimi e um espaço de trabalho compartilhado e não isolado. Esses exemplos são observações úteis, com esses limites anexados.
Minha interpretação é que vale a pena testar o Kimi para configuradores de produtos, demonstrações educacionais e protótipos visuais. Escolher uma configuração de maior esforço automaticamente faria você perder uma das lições práticas desses exemplos. Comece com um requisito explícito e inspecione o artefato.
Para um configurador de móveis, defina o que deve mudar quando alguém seleciona um material, alterna a visualização da câmera ou redefine o design. Verifique se o preço exibido corresponde à seleção. Recarregue a página. Teste os controles em um celular. Uma cadeira visualmente atraente é apenas parte da entrega.
A precisão técnica precisa de suas próprias verificações. Os resultados do BenchCAD da Moonshot relatam 92,7% para o Kimi e 96,2% para o Opus com ferramentas, usando uma métrica de reconstrução geométrica. Esse resultado publicado pelo fornecedor aborda uma questão diferente de saber se uma cena parece atraente. Uma animação convincente ainda precisa de validação separada antes que você a use para ensinar física ou representar um processo de engenharia.
Para um protótipo, eu testaria o Kimi primeiro. Para um aplicativo sensível à precisão, eu começaria com o Opus e exigiria verificações específicas do domínio, independentemente de qual modelo produza o código.
Desenvolvimento Agêntico: O modelo consegue concluir uma tarefa de várias etapas?
Um agente trabalhando em um repositório precisa entender o comportamento existente, escolher arquivos para alterar, executar ferramentas, interpretar falhas e decidir quando parar. Erros podem se acumular entre essas etapas.
Ambos os fornecedores publicam exemplos de trabalho estendido. A Moonshot descreve o Kimi diagnosticando e corrigindo um simulador antes de treinar novamente um controlador de caminhada. O relatório de lançamento do Opus 5.5 da Anthropic descreve melhorias em um aplicativo web, incluindo uma tarefa de tempo de carregamento concluída com sucesso em 39 de 40 tentativas. Estes são exemplos separados dos fornecedores, em vez de um teste comparativo direto compartilhado.
Para um aplicativo de faturamento existente, uma comparação útil seria adicionar importações de CSV. Exija mapeamento de campos, tratamento de linhas inválidas, detecção de duplicatas, uma visualização e testes que cubram o comportamento existente. Deixe cada modelo trabalhar a partir do mesmo snapshot do repositório e inspecione ambos os patches. Um resumo dizendo “todos os testes passaram” precisa de um log de teste por trás dele.
Para esse tipo de alteração entre arquivos, o Opus seria meu ponto de partida padrão. O Kimi é mais fácil de avaliar em uma parte delimitada do trabalho, como implementar a validação em relação a um esquema acordado. Expanda seu escopo depois que os testes estabelecerem que ele consegue lidar com o aplicativo ao redor.
A configuração também importa. A orientação de uso de ferramentas do Kimi exige a retenção da mensagem completa do assistente entre as turnos. A documentação do Opus da Claude descreve o pensamento específico do modelo e o comportamento da ferramenta. Verifique esses detalhes na rota escolhida; corresponder a um formato de solicitação básico não estabelece um comportamento de agente idêntico.
Preço e Custo: Quanto custa realmente um resultado aceito?
O Kimi K3.1 Pro tem as taxas padrão de entrada e saída mais baixas. A questão mais difícil é quantas chamadas, novas tentativas e ciclos de revisão sua tarefa precisa.
Aqui está um exemplo de planejamento usando as taxas listadas da GPT Proto. Suponha que cada tentativa use 1 milhão de tokens de entrada não armazenados em cache e 200.000 tokens de saída faturados. Estes são volumes hipotéticos, não resultados observados de aplicativos.
| Cenário de planejamento |
Kimi K3.1 Pro |
Claude Opus 5.5 |
| Uma tentativa nos volumes declarados |
$4.00 |
$7.20 |
| Duas tentativas, cada uma com os mesmos volumes |
$8.00 |
$14.40 |
Sob essas suposições, um resultado do Kimi que precise de duas tentativas custa mais em tokens do que um resultado do Opus aceito após uma. As novas tentativas raramente repetem exatamente os mesmos volumes de tokens, portanto, use seus registros de uso para o cálculo real.
O cache altera a comparação novamente. Ambos os fornecedores listam leituras oficiais de cache a US$ 0,20 por 1 milhão de tokens em suas documentações do Kimi e Claude. Uma longa sessão de agente com muitos acertos de cache terá uma proporção de custo diferente de uma solicitação nova. Verifique também as cobranças de gravação em cache, uso de saída e as taxas reais do seu provedor.
Para uma equipe, eu rastrearia o custo por tarefa aceita junto com o tempo decorrido e os minutos do revisor. Um rascunho mais barato pode ser um bom custo-benefício quando a verificação é rápida. Torna-se menos atraente quando um desenvolvedor precisa reconstruir o que o agente alterou antes de confiar nele.
Como comparar ambos os modelos no seu próprio aplicativo através do GPT Proto
Use uma pequena alteração no aplicativo com resultados observáveis. Um formulário de agendamento, importador de CSV ou configurador de produtos oferece evidências mais úteis do que uma solicitação irrestrita para “criar algo impressionante”.
Abra a página do modelo Kimi e a página do modelo Opus. Use o "Try this model" (Experimente este modelo) e o "Quick Start" (Início rápido) para obter o guia de integração e, em seguida, copie as instruções em Markdown para o seu assistente de codificação. Mantenha sua chave de API em uma variável de ambiente local ou na configuração do lado do servidor.
Antes de avaliar a qualidade do desenvolvimento, verifique se ambas as rotas do modelo respondem. Este exemplo de conexão segue o formato Chat Completions publicado nas páginas dos modelos. Defina a GPTPROTO_API_KEY localmente antes de executar; as solicitações consomem tokens pagos.
for model in kimi-k3.1-pro claude-opus-5-5; do
  curl --fail-with-body --silent --show-error --max-time 180 \
    https://gptproto.com/v1/chat/completions \
    -H "Authorization: Bearer $GPTPROTO_API_KEY" \
    -H "Content-Type: application/json" \
    --data "{
      \"model\": \"$model\",
      \"messages\": [{\"role\": \"user\",
        \"content\": \"Return only: API connection OK\"}]
    }"
done
Isso verifica a conectividade, não a qualidade da codificação. As APIs nativas possuem configurações de raciocínio padrão diferentes; configure e registre as configurações de esforço suportadas antes de uma comparação de aplicativos. Uma resposta de API também precisa de um agente ou aplicativo ao seu redor para editar arquivos, executar ferramentas e inspecionar um navegador.
Para o teste de desenvolvimento, inicie cada modelo a partir de uma cópia limpa do mesmo projeto. Forneça a mesma tarefa, permissões, dependências e testes de aceitação. Registre a rota do modelo, o esforço, o uso faturado, o tempo de conclusão e as alterações manuais necessárias. Repita a tarefa antes de tornar uma pequena diferença o seu padrão de produção.
Se o endpoint retornar um erro de autenticação, verifique a chave e o cabeçalho de autorização. Se um parâmetro opcional for rejeitado, compare-o com o guia atual da página do modelo. Verifique se uma resposta bem-sucedida contém a saída do modelo pretendida antes de expandir o trabalho.
Qual modelo você deve escolher?
| Sua carga de trabalho |
Minha escolha inicial |
Condição para mantê-lo |
| Frontend voltado ao cliente com revisões de design frequentes |
Opus 5.5 |
Uma saída melhor aceita justifica seu custo |
| Protótipo interativo ou experimento visual |
Kimi K3.1 Pro |
Os controles funcionam e o artefato é fácil de inspecionar |
| Alterações complexas em um aplicativo existente |
Opus 5.5 |
Testes de repositório e revisão sustentam a escolha |
| Implementação repetida com base em uma especificação fixa |
Kimi K3.1 Pro |
Verificações automatizadas mantêm os custos de correção baixos |
| Código ou simulação sensível à precisão |
Opus como linha de base inicial |
Validação externa é necessária para qualquer um dos modelos |
Eu escolheria o Opus 5.5 como padrão inicial para uma equipe que delega um trabalho substancial de aplicativo a um agente. As evidências de avaliação mais amplas apoiam começar por ele, enquanto o repositório real decide se o valor premium se justifica.
O Kimi K3.1 Pro é um candidato prático para reduzir o custo de trabalhos bem definidos. Comece com tarefas que você possa inspecionar ou testar, meça os resultados aceitos e dê a ele mais responsabilidade à medida que as evidências melhorarem. Esse é um motivo mais forte para mudar do que um quase empate em um benchmark.
Leve uma pequena tarefa para as páginas da API do Kimi K3.1 Pro e da API do Claude Opus 5.5, use os guias de integração e compare o resultado que seu aplicativo pode aceitar.