Visão geral do GPT-6.2 Astra
| Pergunta |
Resposta curta |
| O que é o GPT-6.2 Astra? |
O modelo GPT-6.2 de maior capacidade da OpenAI para codificação complexa e trabalho profissional |
| Data de lançamento |
17 de novembro de 2026 |
| ID do modelo da API |
gpt-6.2-astra |
| Janela de contexto |
1,05 milhão de tokens |
| Entrada / saída máxima |
922.000 / 128.000 tokens |
| Modalidades |
Entrada de texto e imagem; saída de texto |
| Preço padrão da API da OpenAI |
US$ 8 de entrada, US$ 0,40 de entrada em cache e US$ 40 de saída por 1 milhão de tokens |
| Preço do GPT Proto |
US$ 6,40 de entrada, US$ 0,32 de entrada em cache e US$ 32 de saída por 1 milhão de tokens — 20% de desconto |
| Melhor uso inicial |
Depuração complexa, revisão de código, migrações, análise de dados, documentos profissionais, ciência, CAD e fluxos de trabalho 3D |
| Melhor opção para o dia a dia |
GPT-6.2 Sol para codificação de rotina, escrita e trabalhos de menor custo |
A documentação do modelo da OpenAI lista suporte para Respostas e Completar Chat, além de ferramentas que incluem pesquisa na web, pesquisa de arquivos, interpretador de código, shell hospedado, uso de computador, MCP e geração de imagens. O modelo em si retorna texto. Planilhas, slides, sites ou ativos 3D finalizados dependem das ferramentas e do ambiente de execução ao redor dele.
O que os primeiros usuários estão realmente discutindo?
A conversa sobre o lançamento não é principalmente sobre pontuações de benchmark. É sobre a lacuna entre a capacidade bruta e a usabilidade no dia a dia.
1. O Astra pode ser excelente na revisão e reparo de sistemas existentes
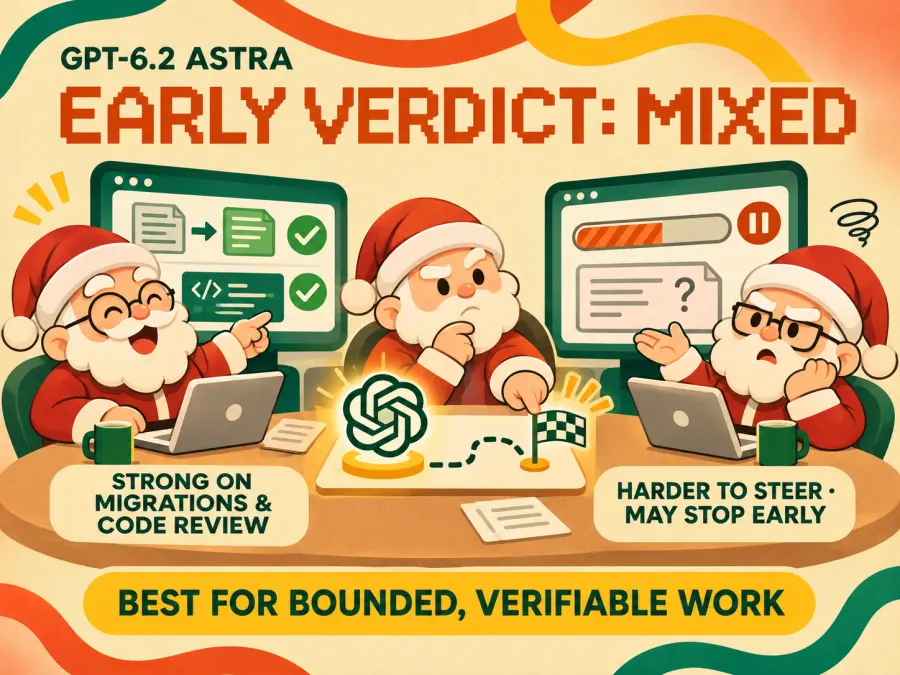
Os testes iniciais do Copilot do GitHub descobriram que o GPT-6.2 Astra detectou significativamente mais problemas reais de revisão de código do que o GPT-6 Astra, usando menos tokens. Isso é mais relevante para uma equipe de produção do que outra demonstração de aplicativo de uso único: o trabalho valioso geralmente consiste em encontrar o defeito, preservar o comportamento existente e comprovar o patch com testes.
O engenheiro Tibor Blaho descreveu o uso do Astra em trabalhos diários de infraestrutura e software, incluindo gerenciamento de servidores, backups, monitoramento, pesquisa, administração, depuração e revisão de código. Seu exemplo de destaque foi a atualização de um aplicativo legado de milhões de linhas e suas dependências antigas para uma versão de linguagem atual. Ele relatou um resultado utilizável localmente após cerca de três horas e um teste de checkout limpo após aproximadamente seis horas, observando que ainda restava trabalho a ser feito.
Isso é um relato, não um benchmark controlado. Ainda assim, é um exemplo útil porque inclui uma base de código real, tempo decorrido e uma etapa de verificação. Também aponta para um fluxo de trabalho prático: Blaho usa o Astra e modelos Claude para pesquisar e revisar o trabalho um do outro, em vez de presumir que um modelo detecta todos os defeitos.
2. Execuções autônomas longas podem ser frustrantes
Os relatos negativos também são concretos. A análise inicial de Dan Shipper afirmou que o Astra frequentemente parava cedo demais em construções de código de ponta a ponta e podia ser tão conciso que sua escrita se tornava difícil de acompanhar. Ethan Mollick o chamou de irregular e mais difícil de direcionar: ele construiu com sucesso uma experiência ambiciosa de elevador espacial no Blender e Unity, mas ele ainda não se viu recorrendo a ele como um modelo diário.
O relato detalhado do desenvolvedor Theo é igualmente dividido. Ele elogiou o Astra como revisor de código, disse que ele encontrou soluções inovadoras e creditou a ele um design de proxy reverso que poderia economizar US$ 25.000 por mês para sua empresa. Ele também relatou execuções longas que travavam em perguntas que ele não conseguia responder, loops que não progrediam e resumos que eram mais difíceis de entender do que as próprias alterações no código.
Esses relatos não provam que toda execução do Astra falhará. Eles identificam o mesmo risco sob ângulos diferentes: o modelo pode ser capaz o suficiente para realizar o trabalho, mas difícil de supervisionar quando o objetivo é aberto.
3. A saída concisa é eficiência ou falta de contexto
O próprio guia de prompts do GPT-6.2 da OpenAI diz que o Astra é mais conciso e direto por padrão. Para uma resposta de suporte, nota de revisão de código ou resumo executivo, isso pode ser útil. Para uma explicação complexa, pode parecer que o modelo pulou o raciocínio de que o leitor precisava.
Isso explica por que as reações iniciais são conflitantes. Pessoas testando uma entrega de escopo restrito podem ver menos preenchimento e menos tokens. Pessoas usando o Astra como colaborador em um projeto longo podem ver respostas abruptas, decisões inexplicadas ou transferências prematuras.
4. A verdadeira questão é o formato da tarefa, não se o Astra é “inteligente”
As evidências até agora sugerem uma linha divisória simples:
| Formato da tarefa |
Adequação inicial para o Astra |
| Objetivo claro, ferramentas, testes e linha de chegada |
Candidato forte |
| Revisão de alto valor onde defeitos não detectados são caros |
Candidato forte |
| Trabalho com dados ou documentos de múltiplas fontes com uma saída verificável |
Candidato forte |
| E-mail de rotina, notas de reunião ou pequena edição de código |
Geralmente use o Sol primeiro |
| Pesquisa aberta que exige julgamento sobre o que é importante |
Compare com o Fable 5.2 e mantenha a revisão humana |
| Construção autônoma de horas de duração com decisões ambíguas |
Teste cuidadosamente antes de confiar nele |
O GPT-6.2 Astra é bom para o trabalho diário?
Sim, mas a maior parte do trabalho diário não precisa dele. Para anotações de reuniões, e-mails de rotina, pesquisas curtas, pequenas edições de código ou um primeiro rascunho, o GPT-6.2 Sol é o ponto de partida mais natural. É o modelo que a OpenAI posiciona para o trabalho diário, e suas taxas de tokens são 75% menores que as do Astra. O GPT Proto aplica o mesmo desconto de 20% a ambos os modelos, portanto, essa diferença de preço permanece inalterada.
O Astra torna-se útil quando uma categoria de trabalho comum se transforma em uma tarefa difícil e de alto valor. “Revise este pull request” pode ser adequado para o Sol; “rastreie esta falha intermitente em três serviços, corrija-a e execute os fluxos de trabalho afetados” é um trabalho para o Astra. “Resuma este CSV” é rotina; “encontre os problemas de qualidade de dados, explique as armadilhas estatísticas e crie uma pasta de trabalho de decisão editável” dá ao Astra mais espaço para justificar seu custo.
Os usos diários práticos relatados até agora incluem depuração, operações de servidor, monitoramento, backups, revisão de código, pesquisa de múltiplas fontes e administração de escritório. O ponto em comum não é a profissão. É que o trabalho tem complexidade suficiente para se beneficiar de um raciocínio mais profundo e estrutura suficiente para verificar o resultado.
Para que o GPT-6.2 Astra é bom?
Revisão de código, análise de causa raiz e modernização de sistemas legados
Este é o caso de uso prático mais claro. Dê ao Astra o fluxo de trabalho com falha, os logs relevantes, o repositório e os comandos de teste. Peça que ele rastreie a falha entre os serviços, implemente a correção segura mais precisa e execute os testes afetados. Isso corresponde ao fluxo de trabalho do Astra recomendado pela própria OpenAI e aos relatórios positivos do GitHub e de engenheiros pioneiros.
Atualizações de sistemas legados podem ser uma opção especialmente boa porque a tarefa é difícil, mas verificável. O modelo pode inspecionar dependências antigas, atualizar o código em etapas e executar repetidamente uma compilação limpa. O humano ainda precisa definir os requisitos de compatibilidade e revisar a migração. “Todos os testes passaram” é uma evidência apenas se a suíte de testes cobrir o comportamento que importa.
Para uma revisão normal de pull-request ou uma pequena revisão, o GPT-6.2 Sol pode ser suficiente. A OpenAI recomenda explicitamente o Sol para codificação diária, e ele custa um quarto das taxas padrão de entrada e saída do Astra.
Análise de dados, dashboards e pastas de trabalho editáveis
O valor do Astra aqui não é apenas escrever uma consulta SQL. Ele pode inspecionar dados, notar problemas de qualidade, declarar suposições, executar análises e transformar os resultados em uma pasta de trabalho, gráfico ou dashboard que outra pessoa possa revisar.
Um teste de análise de dados com Plotly independente fornece um exemplo útil de tarefa real. O Astra passou em 41 das 43 perguntas, detectou todos os problemas de qualidade de dados inseridos, evitou todas as cinco armadilhas estatísticas e completou a execução por US$ 4,11. Sua pergunta mediana levou 12,4 segundos, contra 26,9 segundos para o GPT-6 Astra. A compensação é importante: ele perdeu dois padrões ocultos, e o GPT-6.1 Sol alcançou uma pontuação perfeita nesse teste por US$ 2,61. O Astra foi rápido e capaz, mas não é automaticamente a opção mais barata ou mais precisa.
O exemplo de avaliação Alderfen da OpenAI mostra o lado documental da mesma capacidade. O Astra criou uma pasta de trabalho DCF editável que previu a receita até 2031, reconciliou três demonstrações financeiras, calculou o valor por ação e colocou os principais direcionadores ao lado da tabela de sensibilidade. Trate isso como uma demonstração de fornecedor, não como uma prova independente. Ainda assim, é um modelo útil para um teste que você pode reproduzir com sua própria planilha.
Finanças, contabilidade, trabalho jurídico e documentos profissionais
O GPT-6.2 Astra foi treinado para seguir convenções profissionais em slides, planilhas, memorandos e documentos. A OpenAI relata ganhos em fluxos de trabalho de finanças, contabilidade, consultoria, vendas e jurídico. Os resultados dos clientes na página de lançamento incluem menos rodadas de revisão para aplicativos, painéis e slides, além de tempos de conclusão mais curtos para trabalhos contábeis de longo prazo. Esses são resultados selecionados pelo fornecedor, portanto, devem ser lidos como casos de uso promissores e não como resultados garantidos.
As melhores aplicações são entregáveis verificáveis:
Um modelo financeiro cujas fórmulas conciliam e respondem corretamente quando as premissas mudam.
Um memorando jurídico cujas alegações podem ser rastreadas até autoridades e documentos de origem fornecidos.
Uma apresentação de slides que segue um modelo existente e transforma cada título em uma conclusão fundamentada.
Um rastreador de conformidade que mapeia cada requisito para evidências, um responsável e um status.
Evidências independentes são menos favoráveis em trabalhos abertos. Na avaliação de ambiente de trabalho realista da Epoch AI, nenhum modelo testado atingiu o padrão de funcionário da Epoch em nenhuma tarefa. O GPT-6.2 Astra obteve uma média de 65%, 17 pontos abaixo do Claude Fable 5.2. A Epoch descobriu que o Astra melhorou em relação ao GPT-6 Astra em redação concisa, design gráfico e pesquisa em data centers, mas pode ser cauteloso demais e omitir conclusões que as evidências disponíveis sustentavam.
Essa aparente contradição é o ponto central. O Astra pode ser muito forte quando a rubrica e a saída são explícitas. Quando o trabalho exige decidir o que é importante, fazer suposições calibradas e iterar em um plano de pesquisa incerto, a escolha do modelo e a supervisão humana são mais importantes.
Análise científica e pesquisa técnica
A OpenAI posiciona a ciência como um caso de uso emblemático do Astra e relata resultados de liderança em fluxos de trabalho científicos baseados em terminal. Um sinal inicial separado de usuários vem do pesquisador biomédico Derya Unutmaz, que preferiu o Astra para ciência e codificação de longo prazo, embora ainda prefira o Opus 5.5 por seu senso de design e inteligência emocional. Ele também descreveu sua própria experiência de pesquisa biomédica com o Astra como sólida.
Isso não significa que o Astra possa produzir independentemente pesquisas prontas para publicação. A avaliação da Epoch constatou que os modelos de fronteira ainda reutilizam ideias existentes, dependem excessivamente de primeiras tentativas e lutam para identificar as descobertas mais importantes. Use o Astra para pesquisar, analisar códigos, comparar fontes, testar uma hipótese declarada ou desafiar um rascunho. Não trate uma narrativa de pesquisa confiante como validação.
CAD, simulação, design 3D e protótipos visuais
Aqui, os exemplos de lançamento são mais interessantes do que os jogos. A OpenAI mostrou o Astra modelando componentes de veículos, escrevendo um resolvedor em Python para dinâmica de chassi, animando o resultado no Blender e criando um guia de montagem e catálogo de peças para um buggy de controle remoto. Esses exemplos combinam raciocínio visual, código, uso de computador e documentação em um único fluxo de trabalho.
Essa combinação pode ajudar na exploração inicial de engenharia: transformar imagens de referência e manuais em um modelo editável, testar uma revisão em simulação e produzir uma explicação visual para um revisor. Um design físico ainda precisa de validação de engenharia. Uma animação plausível não é prova de que cargas, tolerâncias, materiais ou requisitos de segurança estão corretos.
O GPT-6.2 Astra consegue criar jogos?
Sim. Meridian Sound Racing é uma demonstração jogável no navegador, e o projeto de elevador espacial de Ethan Mollick combinou Blender, Unity, uma experiência de navegador e física de gravidade zero simulada.
Mas “conseguir criar um jogo” não é o melhor resumo do Astra. Esses projetos são a prova de que o modelo consegue coordenar código, ativos 3D, ferramentas e interações em uma construção complexa. As mesmas capacidades são úteis para simulações, experiências de treinamento, gêmeos digitais, configuradores de produtos e histórias de dados interativas.
A consistência criativa também precisa de testes. Os primeiros usuários relataram instintos visuais padrão fortes, mas padrões de design repetitivos e um controle mais fraco sobre o estilo. Forneça ao Astra uma referência visual, tipografia, público-alvo, regras de interação e objetivos explícitos do que não fazer. Em seguida, avalie a segunda revisão, não apenas a primeira captura de tela.
Como obter melhores resultados com o GPT-6.2 Astra
As reclamações da comunidade sugerem que o Astra precisa de um resumo operacional mais explícito do que um prompt de chat comum. O guia da OpenAI também alerta que o modelo pode propor um próximo passo e aguardar quando a intenção não estiver clara.
Use uma estrutura de prompt como esta:
Objetivo:
Concluir [entregável específico].

Concluído quando:

1. [Verificação de aceitação]

2. [Teste ou evidência]

3. [Formato de saída necessário]

Autonomia:
Faça suposições razoáveis e reversíveis e continue sem esperar.
Pergunte apenas se uma decisão alterar materialmente o resultado ou causar uma ação irreversível.

Restrições:

- Preserve [comportamento ou estilo existente].

- Não altere [área fora do escopo].

- Use [ferramentas, arquivos, fontes ou convenções].

Verificação:
Execute [testes ou verificações]. Relate explicitamente qualquer arquivo ausente, ferramenta com falha, suposição não suportada ou etapa incompleta.

Entrega final:
Resuma o que foi alterado, o que foi verificado, os riscos restantes e o uso/custo total.
Para trabalhos de API de várias etapas, mantenha o prefixo do prompt anterior inalterado e anexe novas instruções. A OpenAI diz que isso preserva o raciocínio e melhora o reuso do cache de prompt. Para trabalhos de front-end ou visuais, forneça uma referência real e nomeie a tipografia e as imagens que você deseja. “Faça algo moderno” não é um sistema de design.
Quanto custa o GPT-6.2 Astra por tarefa?
Estas taxas estão em USD por milhão de tokens para solicitações de até 272.000 tokens de entrada. As linhas do GPT Proto aplicam o desconto atual de 20% sobre as taxas padrão da OpenAI.
| Modelo e rota |
Entrada |
Entrada em cache |
Saída |
| GPT-6.2 Astra — Padrão OpenAI |
$8,00 |
$0,40 |
$40,00 |
| GPT-6.2 Astra no GPT Proto — 20% de desconto |
$6,40 |
$0,32 |
$32,00 |
| GPT-6 Astra — Padrão OpenAI |
$10,00 |
$1,00 |
$50,00 |
| GPT-6.2 Sol — Padrão OpenAI |
$2,00 |
$0,10 |
$10,00 |
| GPT-6.2 Sol no GPT Proto — 20% de desconto |
$1,60 |
$0,08 |
$8,00 |
Para uma solicitação com 20.000 tokens de entrada sem cache e 5.000 tokens de saída faturados, a cobrança padrão de tokens seria de $0,36 no GPT-6.2 Astra, $0,45 no GPT-6 Astra e $0,09 no GPT-6.2 Sol. Com as taxas atuais do GPT Proto, a mesma contagem de tokens custa $0,288 no Astra ou $0,072 no Sol. Uma tarefa real de agente pode realizar chamadas repetidas ao modelo, reutilizar contexto em cache, tentar novamente ferramentas que falharam ou produzir um resultado muito mais longo.
Com mais de 272.000 tokens de entrada em uma única solicitação, as taxas de entrada e cache do Astra dobram e os custos de saída são 1,5 vezes a taxa de contexto curto para toda a solicitação. A janela de contexto de 1,05M é útil, mas preenchê-la casualmente pode gerar uma fatura alta. Meça o custo por tarefa concluída, não apenas o preço por milhão de tokens.
A execução do Plotly fornece um exemplo concreto: 43 perguntas de análise custaram $4,11 no GPT-6.2 Astra, em comparação com $19,97 no GPT-6 Astra. No entanto, o GPT-6.2 Sol custou $1,22 e terminou apenas uma pergunta atrás. A atualização do Astra é real; o modelo mais barato ainda pode ter uma economia melhor para tráfego de produção rotineiro.
Ambas as rotas com desconto já estão ativas. Verifique a página do modelo GPT-6.2 Astra ou a página do modelo GPT-6.2 Sol para obter o ID do modelo atual e o formato de solicitação antes de enviar tráfego de produção. A coleção de modelos da OpenAI lista o restante dos modelos disponíveis da OpenAI.
O GPT-6.2 Astra é melhor que o Claude Fable 5.2?
Não em todos os tipos de trabalho.
A OpenAI relata que o Astra mais do que dobrou a taxa de aprovação rigorosa do Fable 5.2 em um benchmark de agente jurídico, com aproximadamente um sexto do custo. No FrontierCode 2.0 da Cognition, no entanto, o Fable 5.2 obteve pontuação mais alta em alterações em bases de código existentes. A avaliação de ambiente de trabalho de final aberto da Epoch também favoreceu o Fable 5.2 em 17 pontos.
| Escolha o GPT-6.2 Astra quando… |
Escolha o Claude Fable 5.2 quando… |
| Revisão de código, depuração, uso de ferramentas ou uma entrega técnica verificável forem fundamentais |
A tarefa for de final aberto e exigir um julgamento sólido sobre o que é importante |
| Você precisar de fluxos de trabalho de CAD, simulação, 3D ou uso de computador |
O estilo de colaboração e explicações longas e legíveis forem mais importantes |
| O custo de tarefas repetidas e a eficiência de cache forem importantes |
Seus próprios testes representativos mostrarem menos intervenções ou melhor conclusão |
| Você quiser um segundo modelo para revisar o trabalho de outro agente |
Você quiser um segundo modelo para desafiar as suposições e patches do Astra |
A resposta mais prática pode ser usar ambos. O fluxo de trabalho de revisão cruzada inicial descrito por Tibor Blaho é mais confiável do que declarar um vencedor universal: deixe um modelo implementar ou pesquisar e, em seguida, peça ao outro para procurar defeitos ignorados e suposições sem suporte.
Para uma comparação criativa, reutilize o briefing interativo de aquarela do nosso teste do Claude Fable 5.2. Dê a ambos os modelos o mesmo projeto existente e peça um novo controle sem quebrar os atuais. Compare a precisão na primeira tentativa, a contagem de revisões, a qualidade da explicação, o total de tokens e o custo da tarefa concluída. Você pode encontrar o acesso ao Fable na página da API do Claude Fable 5.2.
Onde você pode usar o GPT-6.2 Astra?
ChatGPT Work: O GPT-6.2 Astra está disponível no Work, em vez do chat comum do ChatGPT. O acesso depende do plano, das configurações do espaço de trabalho e do status de lançamento.
Codex: Sim. Escolha o Astra no aplicativo Codex ou use /model na CLI. É a opção recomendada pela OpenAI para rastrear bugs difíceis entre serviços e concluir a correção e os testes.
Claude Code: Não existe uma opção nativa para o GPT-6.2 Astra. A documentação do gateway de LLM da Anthropic afirma que o roteamento do Claude Code para modelos que não sejam do Claude por meio de um gateway não é suportado.
OpenAI API: Use o ID de modelo oficial gpt-6.2-astra. A OpenAI recomenda a API de Respostas para fluxos de trabalho que utilizam ferramentas.
GPT Proto: Tanto o GPT-6.2 Astra quanto o GPT-6.2 Sol estão ativos com 20% de desconto sobre as taxas padrão de token da API da OpenAI. Escolha o Astra para raciocínio complexo e entregas profissionais verificáveis; escolha o Sol para codificação de rotina, escrita e cargas de trabalho de maior volume. O cronograma anterior de lançamento do GPT-6.2 Astra registra as aparições iniciais no Codex.
A solicitação a seguir usa o ID do modelo Astra ativo. Você pode copiar o snippet de integração mais recente diretamente da página do modelo.
curl --fail-with-body --silent --show-error \
  https://gptproto.com/v1/chat/completions \
  --header "Authorization: Bearer ${GPTPROTO_API_KEY}" \
  --header 'Content-Type: application/json' \
  --data '{
    "model": "gpt-6.2-astra",
    "messages": [
      {
        "role": "user",
        "content": "We sold 12 units at $25 each. Each unit cost $10. Return revenue and gross profit in USD as JSON using the keys revenue and gross_profit."
      }
    ]
  }'
A receita deve ser de $300 e o lucro bruto deve ser de $180. Para uma execução de rotina mais barata, mude para o ID de modelo exato mostrado na página do GPT-6.2 Sol. Você também pode navegar pela coleção de modelos da OpenAI para ver outros modelos disponíveis.
Considerações Finais
A vantagem mais convincente do GPT-6.2 Astra não é que ele pode criar um jogo. É a capacidade de combinar raciocínio, código, ferramentas, arquivos e uso do computador em trabalhos que têm uma linha de chegada mensurável: um bug corrigido e testado, uma migração que é compilada corretamente, uma planilha que é reconciliada ou uma análise que expõe suas premissas.
A limitação é igualmente prática. Os primeiros usuários descrevem repetidamente um modelo que pode ser brilhante na tarefa e, ainda assim, difícil de direcionar ou entender em uma execução longa. Use o Sol para trabalhos de rotina. Use o Astra quando o trabalho for difícil o suficiente para justificá-lo, defina o que é "concluído" com precisão, verifique o resultado e compare-o com o Fable 5.2 nas tarefas em que o julgamento de pesquisa e o estilo de colaboração importam.