O que é um provedor de API de LLM?
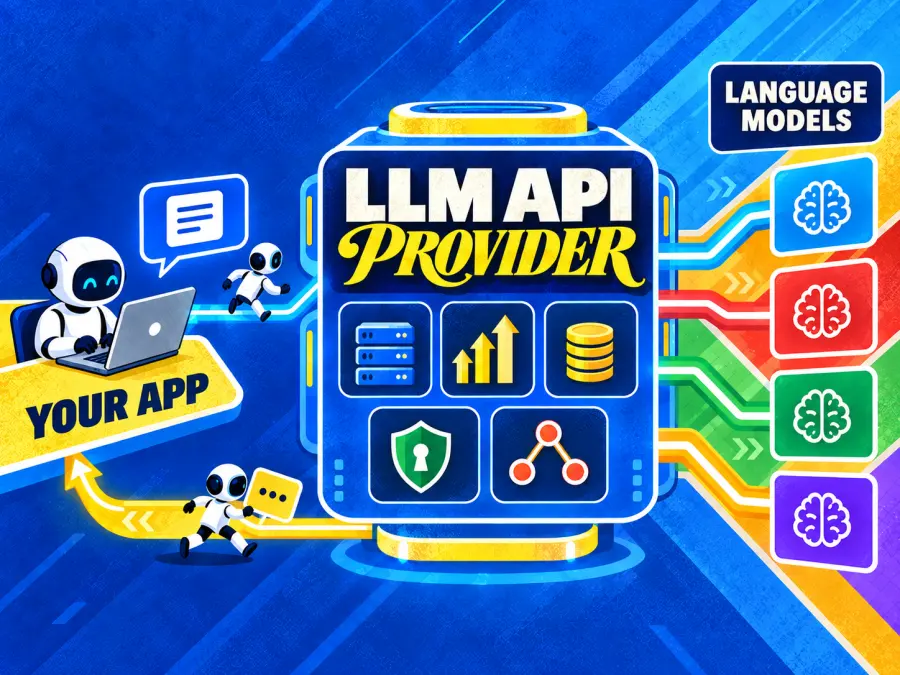
Um provedor de API de LLM oferece aos desenvolvedores acesso hospedado a modelos de linguagem sem exigir que eles provisionem e operem a infraestrutura de inferência subjacente. O provedor lida com implantação, escalonamento, medição, autenticação e — dependendo da plataforma — roteamento, observabilidade, controles de segurança ou ajuste fino.
O termo abrange vários tipos de negócios:
APIs de modelos próprios servem modelos criados pela mesma empresa, como um laboratório de modelos que expõe seus próprios modelos de fronteira.
Provedores de API multi-modelo colocam modelos de vários criadores atrás de uma única conta e, frequentemente, de uma única convenção de API.
Roteadores e gateways enviam uma solicitação para um de vários hosts subjacentes com base em preço, disponibilidade, latência ou regras definidas pelo usuário.
Plataformas de IA em nuvem gerenciadas combinam acesso a modelos com identidade corporativa, rede privada, governança e outros serviços de nuvem.
Especialistas em inferência otimizam modelos selecionados de pesos abertos para velocidade, custo, ajuste fino ou implantação dedicada.
Essas categorias se sobrepõem. O que importa não é simplesmente “Este provedor lista o modelo?”, mas “Ele pode entregar o modelo com o protocolo, a economia, a confiabilidade e os controles que nossa aplicação exige?”
Como classificamos os melhores provedores de API de LLM
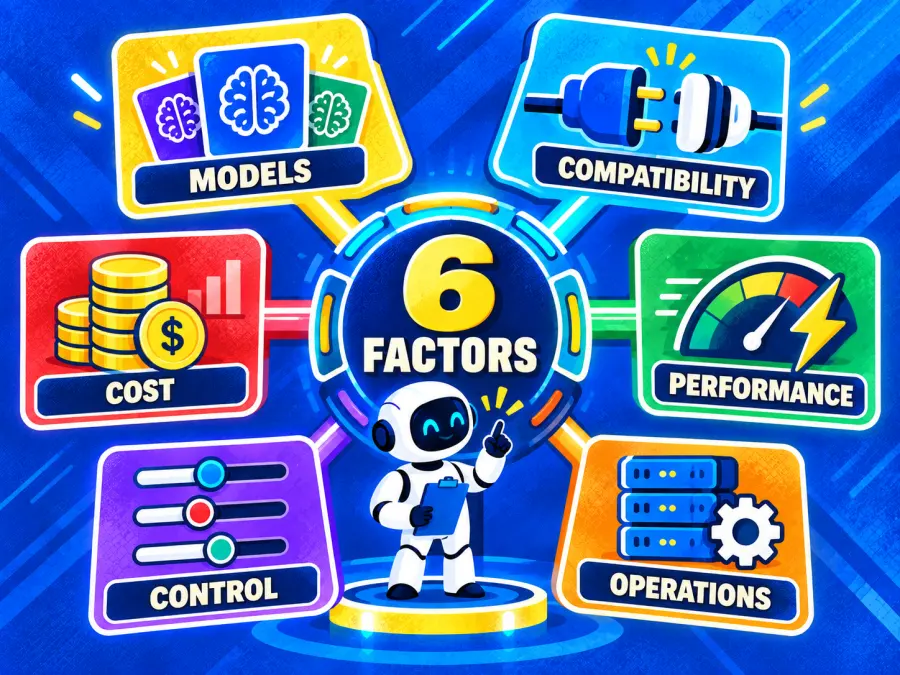
Analisamos cada provedor em seis grupos de fatores:
Escolha de modelo: o número e a variedade de modelos úteis, não apenas o tamanho bruto do catálogo
Compatibilidade: consistência da API, ferramentas, saídas estruturadas e streaming
Custo real: taxas de tokens, tarifas da plataforma, cache, descontos em lote e retentativas
Desempenho: tempo até o primeiro token, taxa de transferência, latência de cauda e comportamento de capacidade
Controle: fixação de provedor, regras de fallback, semântica de erros e ciclo de vida do modelo
Operações: identidade, regiões, rede, governança, documentação e esforço de migração
Nenhum provedor vence em todos os fatores. Nossa ordem favorece a melhor plataforma de uso geral para equipes que valorizam acesso amplo a modelos, e então identifica os casos em que um provedor mais especializado é a melhor decisão.
Comparação de provedores de API de LLM
| Classificação |
Provedor |
Melhor para |
Perfil do catálogo |
Abordagem de API |
Principal trade-off |
| 1 |
GPT Proto |
Uma chave de API para modelos de LLM e multimodais |
232 modelos no total, incluindo 124 modelos de texto no momento da análise |
Endpoint de chat compatível com OpenAI para LLMs suportados; APIs específicas de tarefas para outras modalidades |
Plataforma mais nova com um ecossistema empresarial menor que o dos hyperscalers |
| 2 |
OpenRouter |
Máxima escolha de LLM e roteamento entre provedores |
Mais de 500 modelos de mais de 80 provedores |
API roteada compatível com OpenAI com preferências de provedor e fallbacks |
O roteamento pode complicar o cache, a consistência de desempenho e a atribuição de custos |
| 3 |
Amazon Bedrock |
Governança da AWS e implantação empresarial |
Mais de 100 modelos através do Bedrock Marketplace |
Interfaces gerenciadas consistentes, incluindo a API Converse |
Conceitos da AWS, disponibilidade regional e comportamento específico do modelo adicionam complexidade |
| 4 |
Together AI |
Modelos de pesos abertos, ajuste fino e experimentação |
Catálogo amplo de modelos abertos |
API serverless compatível com OpenAI, além de opções de ajuste fino e dedicadas |
O suporte a recursos varia por modelo |
| 5 |
Fireworks AI |
Inferência de modelos abertos em produção |
Mais de 100 modelos disponíveis |
APIs compatíveis com OpenAI com implantação serverless e dedicada |
Melhor ajuste está concentrado em cargas de trabalho de modelos abertos |
| 6 |
GroqCloud |
Geração muito rápida em um catálogo focado |
Seleção menor e curada de modelos |
API em sua maioria compatível com OpenAI |
Escolha mais restrita e lacunas de compatibilidade documentadas |
Os totais do catálogo são direcionais, não diretamente comparáveis. Uma empresa pode contar versões de modelos, modalidades, provedores ou ajustes finos de maneira diferente de outra. A disponibilidade também muda mais rápido do que uma lista anual pode capturar.
1. GPT Proto — Melhor provedor geral de API de LLM multi-modelo
GPT Proto classifica-se em primeiro lugar para desenvolvedores que desejam uma conta e uma chave de API que possam crescer além da geração de texto. No momento da análise, seu catálogo mostrava 232 modelos, incluindo 124 modelos de texto, além de opções de imagem, vídeo e áudio.
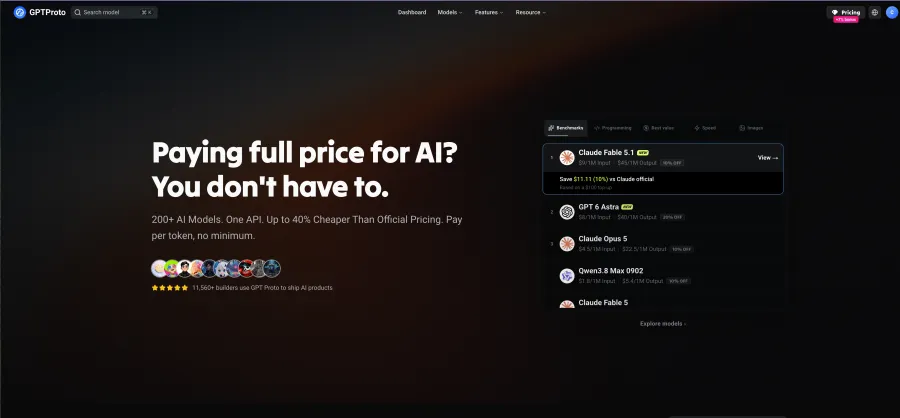
Para LLMs suportados, o GPT Proto expõe um padrão de chat-completions compatível com OpenAI. Os desenvolvedores podem navegar pelo catálogo de modelos de texto, inspecionar taxas específicas de cada modelo e testar um modelo antes da integração.
Cada página de modelo expõe as taxas de entrada e saída. A API GLM-5.3, por exemplo, estava listada a $1,26 por milhão de tokens de entrada e $3,96 por milhão de tokens de saída no momento da análise — 10% abaixo das taxas diretas exibidas da Z.ai. Os preços podem mudar, então verifique a página do modelo.
O GPT Proto não é o vencedor padrão para todas as empresas: o Bedrock tem governança mais profunda da AWS, o OpenRouter um catálogo maior de LLMs roteados, e especialistas podem ter melhor desempenho para um modelo aberto específico. Sua vantagem é a amplitude prática entre famílias de modelos e modalidades.
Melhor para: produtos SaaS, agências de IA, protótipos em direção à produção e aplicações multimodais.
Atenção para: Trate a compatibilidade com OpenAI como específica por modelo e endpoint. Modelos de imagem e vídeo usam corpos de solicitação específicos de tarefas em vez do formato de chat de LLM.
2. OpenRouter — Melhor para amplitude de catálogo de LLM e roteamento
O OpenRouter é a escolha mais forte quando a amplitude do catálogo é o requisito principal. Sua oferta publicada excede 500 modelos em mais de 80 provedores. Um único endpoint pode rotear solicitações entre hosts subjacentes, e os desenvolvedores podem definir preferências de provedor, permitir fallbacks ou usar seleção automática.
O trade-off é que o roteamento se torna parte do comportamento da aplicação. O mesmo nome de modelo pode ser executado em um host, pilha de hardware ou variante de modelo diferente. Isso pode alterar a latência, o contexto suportado, o tratamento de erros e a economia do cache de prompts. O OpenRouter também lista uma taxa de 5,5% na compra de créditos para seu plano padrão pré-pago, que deve ser incluída nos cálculos de custo total.
Em recentes discussões de desenvolvedores, usuários relataram menor consistência de acertos de cache quando o tráfego se movia entre provedores. Uma análise separada da comunidade examinou milhares de turnos. Esses relatos são anedóticos, mas equipes com prompts longos repetidos devem testar configurações de provedor fixado e fallback desabilitado em comparação com o roteamento padrão.
Melhor para: descoberta de modelos, acesso amplo a LLMs, roteamento de fallback e aplicações que podem se beneficiar da escolha de provedor no momento da solicitação.
Atenção para: tarifas da plataforma, diferenças entre provedores, falhas de cache e a tensão entre fallback automático e desempenho determinístico.
3. Amazon Bedrock — Melhor para empresas centradas na AWS
O Amazon Bedrock é a opção mais atraente aqui para organizações que já operam dentro da AWS. O Bedrock Marketplace anuncia acesso a mais de 100 modelos, enquanto serviços como Agents, Knowledge Bases e Guardrails conectam a inferência de modelos a uma pilha gerenciada maior.
Seu valor central é a governança, em vez da contagem bruta de modelos. Clientes da AWS podem alinhar o acesso a modelos com padrões familiares de identidade, registro, regional, rede, compras e segurança. A API Converse oferece aos modelos suportados uma interface mais consistente baseada em mensagens, reduzindo algumas diferenças de integração entre fornecedores. A AWS também afirma que o conteúdo enviado por essa API não é armazenado, uma consideração significativa para revisão empresarial.
Consistência não significa que todo modelo se comporta de forma idêntica. A disponibilidade varia por região, o suporte a recursos difere, e conceitos de conta ou limite de serviço da AWS adicionam trabalho. Esses custos fazem menos sentido para uma equipe pequena que precisa apenas de uma chave e um endpoint de chat.
Melhor para: cargas de trabalho regulamentadas, equipes estabelecidas da AWS e empresas que desejam acesso a modelos dentro de um limite de governança de nuvem existente.
Atenção para: disponibilidade específica por região, recursos específicos de modelos, cotas de serviço e sobrecarga de arquitetura de nuvem.
4. Together AI — Melhor para experimentação e ajuste fino de pesos abertos
O Together AI é um forte provedor de API de modelos LLM para equipes que trabalham principalmente com modelos de pesos abertos. Seu serviço serverless usa preços por token sem provisionar réplicas ou se comprometer com um custo mínimo de implantação. A plataforma também suporta ajuste fino e endpoints dedicados, oferecendo às equipes um caminho da avaliação rápida para uma implantação mais controlada.
A interface compatível com OpenAI reduz o esforço de migração para cargas de trabalho de chat padrão. A Together também publica indicadores de capacidade para recursos como chamada de funções e saídas estruturadas. Esses indicadores importam porque o suporte a recursos não é uniforme em todo o catálogo; um modelo excelente para geração simples pode não satisfazer um fluxo de trabalho de agente que depende de JSON estrito ou chamadas de ferramentas confiáveis.
A Together oferece mais profundidade do que um roteador puro para equipes que desejam ajustar um modelo aberto, testá-lo por meio de um endpoint hospedado e depois escolher serviço dedicado. As equipes ainda precisam selecionar o modelo certo, o modo de serviço e o conjunto de recursos.
Melhor para: pesquisa de modelos abertos, ajuste fino, avaliação e equipes que podem migrar de serverless para inferência dedicada.
Atenção para: suporte por modelo para ferramentas, saída estruturada, contexto e modos de serviço.
5. Fireworks AI — Melhor para implantação de modelos abertos em produção
O Fireworks AI se concentra em servir modelos abertos para uso em produção. Ele lista mais de 100 modelos disponíveis e oferece tanto acesso serverless quanto implantações dedicadas. Sua superfície de API inclui interfaces Chat Completions e estilo Responses compatíveis com OpenAI, o que pode reduzir as alterações de código necessárias para aplicações LLM comuns.
A plataforma é especialmente relevante quando uma equipe deseja começar com inferência serverless por token e depois mover uma carga de trabalho estável para capacidade mais isolada. A inferência em lote tem preço de 50% das tarifas serverless para cargas de trabalho que podem esperar, criando um caminho claro de otimização para enriquecimento offline, classificação, sumarização e tarefas de processamento de dados.
Benchmarks independentes de inferência também mostram por que nenhum provedor deve receber um rótulo permanente de “velocidade”. O desempenho varia por modelo, região, carga e método de medição. Teste o par exato provedor-modelo com prompts realistas em vez de transferir um resultado de um modelo para toda a plataforma.
Melhor para: inferência de modelos abertos em produção, cargas de trabalho que podem precisar de capacidade dedicada e trabalhos em lote tolerantes a atrasos.
Atenção para: variação de desempenho modelo a modelo e se a implantação serverless, em lote ou dedicada corresponde à carga de trabalho.
6. GroqCloud — Melhor para geração de texto de baixa latência
O GroqCloud é o especialista nesta lista. Seu catálogo focado é executado na arquitetura de inferência da Groq, e medições públicas colocaram repetidamente os modelos suportados entre os mais rápidos para geração de tokens. Isso o torna atraente para agentes interativos, pipelines de voz, ferramentas de codificação e outras experiências em que os usuários sentem cada pausa.
A Groq descreve sua API como em sua maioria compatível com OpenAI, e o qualificador importa. Sua documentação identifica campos não suportados, incluindo logprobs, logit_bias, top_logprobs, e messages[].name; n deve ser definido como 1. O processamento Flex permite limites de taxa muito mais altos, mas pode retornar um 498 capacity_exceeded quando a capacidade não está disponível. Modelos de pré-visualização também podem ser descontinuados com pouco aviso.
Escolha o GroqCloud quando um modelo suportado se adequar à tarefa e a latência tiver valor de produto mensurável. Não o escolha apenas porque um framework já possui um adaptador OpenAI.
Melhor para: assistentes em tempo real, loops de agentes, aplicações de voz e geração sensível à latência em modelos suportados.
Atenção para: seleção menor de modelos, campos de solicitação não suportados, comportamento de capacidade e risco de ciclo de vida de modelos de pré-visualização.
Por que o mesmo LLM pode se comportar de forma diferente entre provedores
Um estudo de medição de 2026, “Quando o mesmo modelo não é o mesmo serviço?”, argumenta que um modelo hospedado deve ser tratado como um objeto de serviço específico do provedor. Seu comportamento observado inclui a variante do modelo, protocolo, capacidade de contexto, preço, latência, taxa de transferência, confiabilidade e viabilidade da tarefa — não apenas o nome do modelo.
A distinção oferece aos desenvolvedores uma estrutura de comparação de provedores de API de LLM melhor:
Identidade e versão do modelo
Dois endpoints podem exibir a mesma família de modelos enquanto servem checkpoints, quantizações, níveis de precisão ou cronogramas de atualização diferentes. Pergunte se o identificador do modelo é fixado por versão e o que acontece quando um modelo upstream muda.
Compatibilidade além da URL base
“Compatível com OpenAI” frequentemente significa que o provedor aceita uma solicitação de chat-completions familiar. Isso não garante suporte para todos os parâmetros, esquema de ferramenta, evento de streaming, campo de resposta ou código de erro. Crie um teste de contrato para os recursos que sua aplicação realmente usa.
Roteamento e estabilidade de cache
O roteamento automático pode melhorar a disponibilidade, mas a troca de provedor pode reduzir a reutilização do cache de prompts. Se o contexto repetido domina sua conta de entrada, teste um host fixo contra o tráfego roteado. Compare o custo efetivo por tarefa concluída, não o preço anunciado por milhão de tokens.
Latência, taxa de transferência e erros
Meça toda a distribuição. A latência P50 descreve uma chamada típica; P95 ou P99 expõe caudas lentas. Monitore o tempo até o primeiro token separadamente da velocidade de geração. Registre limites de taxa, timeouts, erros de capacidade e sucesso de retentativas, porque um endpoint barato que precisa de retentativas frequentes pode ser caro tanto em computação quanto em paciência do usuário.
O mesmo estudo dá uma indicação útil do potencial: em seus casos medidos, o roteamento reduziu o custo de uma carga de trabalho Qwen3-32B em 37,8%, enquanto a escolha do provedor aumentou a taxa de transferência de uma carga de trabalho DeepSeek-V3.2 em cerca de 90%. Esses resultados são específicos da carga de trabalho, mas mostram por que a camada do provedor merece sua própria avaliação.
Qual provedor de API de LLM você deve escolher?
Use a classificação como uma lista restrita e depois decida pela carga de trabalho:
Escolha GPT Proto para acesso amplo a texto e mídia com uma única chave.
Escolha OpenRouter para máxima escolha de LLM e roteamento de provedores.
Escolha Amazon Bedrock para governança da AWS e serviços gerenciados.
Escolha Together AI para experimentação e ajuste fino de modelos abertos.
Escolha Fireworks AI para implantação de modelos abertos em produção.
Escolha GroqCloud para geração sensível à latência em modelos suportados.
Mantenha uma API de primeira parte na comparação quando um modelo proprietário é uma dependência estável. Caso contrário, teste pelo menos dois provedores com conversas em cache, chamadas de ferramentas, respostas estruturadas, concorrência de pico e falhas — não apenas prompts de demonstração curtos.
Como acessar vários LLMs com uma única chave de API do GPT Proto
Comece no catálogo de modelos de texto do GPT Proto, abra uma página de modelo e use a opção Experimente Este Modelo do modelo para confirmar a saída antes da integração. Depois de criar uma chave de API, envie uma solicitação padrão de chat-completions:
export GPTPROTO_API_KEY="replace_with_your_key"

curl https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.3",
    "messages": [
      {
        "role": "user",
        "content": "Retorne uma comparação JSON de duas estratégias de cache."
      }
    ]
  }'
Para outro LLM compatível, altere o valor model para o identificador mostrado na página do modelo. Mantenha a seleção de modelo na configuração em vez de codificá-la rigidamente em toda a aplicação, e valide o suporte a recursos antes de trocar. Modelos de imagem, vídeo e áudio usam seus endpoints e corpos de solicitação específicos de tarefas.
Veredito Final
O melhor provedor de API de LLM é aquele que transforma o modelo certo em um serviço confiável para sua carga de trabalho. A qualidade do modelo define o teto, mas compatibilidade, comportamento de cache, latência, tratamento de erros, política de ciclo de vida e custo total determinam o que os usuários realmente experimentam.
Para uso amplo no dia a dia, o GPT Proto oferece o ponto de partida mais equilibrado nesta comparação de seis provedores: uma chave, um grande catálogo de texto, páginas de modelo transparentes e acesso a outras APIs de mídia generativa. O OpenRouter vence em amplitude de LLMs roteados; o Amazon Bedrock em controles empresariais da AWS; o Together AI e o Fireworks AI em diferentes estágios do ciclo de vida de modelos abertos; e o GroqCloud em inferência focada em velocidade.
Selecione a categoria de provedor que corresponde às suas necessidades operacionais e, em seguida, faça benchmark da combinação exata provedor-modelo-tarefa. Em 2026, essa combinação de serviço — não o logotipo ou o nome do modelo sozinho — é a unidade que vale a pena escolher.