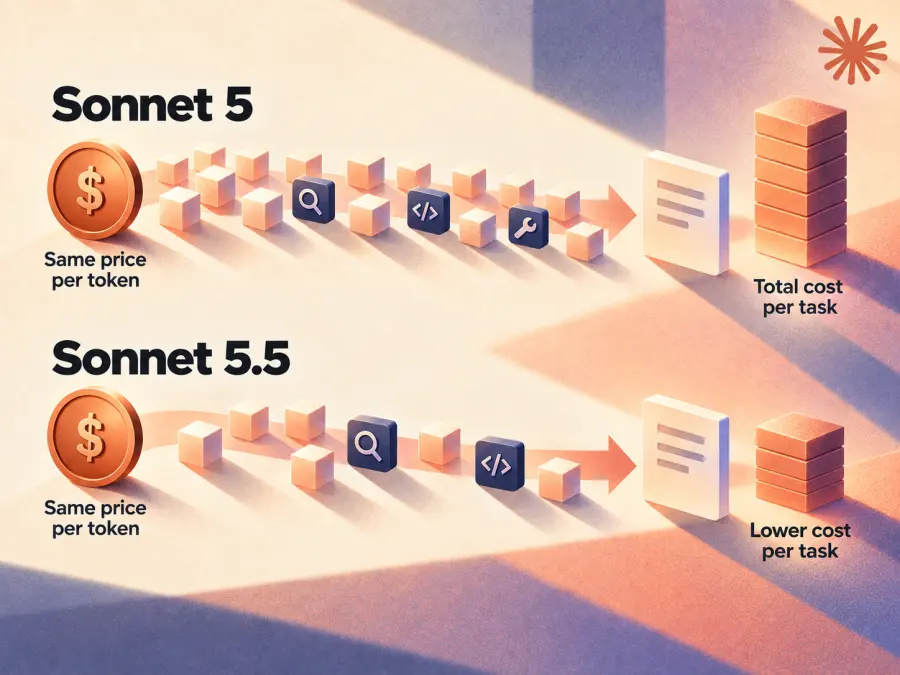
Claude Sonnet 5.5 tem o mesmo preço de API por token que o Sonnet 5. A Anthropic, no entanto, afirma que o novo modelo pode custar menos para concluir uma tarefa. Isso parece contraditório até separarmos o preço de cada token do número de tokens e chamadas de ferramentas que uma tarefa realmente exige.
A resposta curta: Claude Sonnet 5.5 é a atualização de 28 de setembro de 2026 da Anthropic para o seu modelo Sonnet para programação, trabalho com documentos e outras tarefas com um objetivo claro. Aceita texto e imagens, devolve texto e está disponível no Claude Code e por meio da API Claude. A Anthropic relata saída mais rápida e melhores resultados do que o Sonnet 5 em várias avaliações. Esses resultados são motivos para testar uma atualização, não são garantias para cada base de código ou fluxo de trabalho. A página do modelo Claude Sonnet 5.5 no GPTProto é o local para verificar a disponibilidade na plataforma e experimentá-lo quando a listagem estiver ativa. O anúncio da Anthropic apresenta o lançamento e as suas afirmações.
O que é Claude Sonnet 5.5?
Sonnet é a camada intermediária da linha atual do Claude. O Sonnet 5.5 foi feito para lidar rapidamente com trabalho definido e repetível: implementar um recurso especificado, corrigir um bug, revisar um documento em relação ao material de origem ou produzir uma apresentação a partir de um briefing. A Anthropic posiciona o Opus 5.5 para trabalhos mais difíceis e abertos, que exigem julgamento contínuo. A distinção importa mais do que o número da versão. Uma pontuação alta em um teste de programação não torna o Sonnet a melhor escolha para toda decisão de arquitetura.
| Especificação |
Claude Sonnet 5.5 |
| Data de lançamento |
28 de setembro de 2026 |
| ID do modelo da API do Claude |
claude-sonnet-5-5 |
| Janela de contexto |
1 milhão de tokens |
| Saída máxima |
128.000 tokens em requisições padrão |
| Modalidades |
Entrada de texto e imagem; saída de texto |
| Raciocínio |
Adaptativo, ativado por padrão |
Estas são as especificações publicadas da Anthropic. Uma janela de contexto de 1 milhão de tokens é substancial, mas não é uma vantagem nova em relação ao Sonnet 5, que também suporta 1 milhão de tokens. Nem uma janela grande prova que todo detalhe em uma entrada longa será usado corretamente. O Sonnet 5.5 também mantém o tokenizador do Sonnet 5, então um texto idêntico tem a mesma contagem de tokens nesses dois modelos. documentação de migração da Anthropic deixa esse último ponto explícito.
O que mudou em relação ao Sonnet 5?
A mudança útil é a quantidade de trabalho que o Sonnet 5.5 consegue concluir para um determinado tempo e computação. A Anthropic diz que ele gera saída mais de 30% mais rápido que o Sonnet 5. Em sua avaliação de codificação agêntica Terminal-Bench 4.0, o Sonnet 5.5 marcou 70,6%, contra 10,3% do Sonnet 5. Ela também relata que o modelo mais novo agrupa chamadas de ferramentas com mais frequência, reduzindo as etapas necessárias para algumas tarefas de programação. Esses são resultados da Anthropic, medidos em configurações de teste específicas.
Há uma verificação externa, embora ela faça uma pergunta diferente. No CursorBench 4.0, o Sonnet 5.5 em esforço Alto marcou 47,8% a um custo relatado de US$ 1,67 por tarefa avaliada; o Sonnet 5 em Alto marcou 30,8% a US$ 3,48. Isso sustenta uma melhoria no ambiente de programação do Cursor. Não prevê a economia exata para um cliente de API usando um agente, prompt ou repositório diferentes.
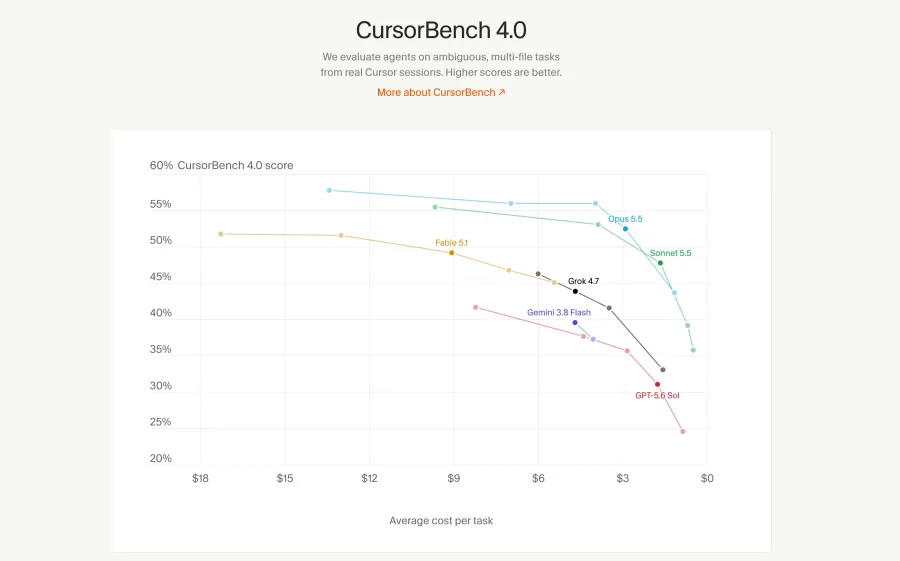
A atualização, portanto, é mais interessante do que um aumento rotineiro de versão para equipes de programação. A contrapartida é que um resultado forte de benchmark ainda precisa sobreviver aos seus próprios testes. Se você quer o ponto de partida do modelo anterior, veja nosso guia do Sonnet 5 e página da API do Sonnet 5.
Preço do Sonnet 5.5: mesma tarifa de tabela, potencialmente menos tokens por tarefa
Nas tarifas publicadas da API da Anthropic, o Sonnet 5.5 custa o mesmo por milhão de tokens que o Sonnet 5. A tarifa do Sonnet 5.5 no GPT Proto é 10% abaixo dessas tarifas de entrada e saída:
| Por 1 milhão de tokens |
Tarifa de tabela da Anthropic |
GPT Proto Sonnet 5.5 |
| Entrada |
$2.00 |
$1.80 |
| Saída |
$10.00 |
$9.00 |
A Anthropic lista leituras de cache a US$ 0,20 por milhão de tokens; gravações de cache e outras cobranças têm suas próprias tarifas. Confira a página do modelo GPT Proto para detalhes de cobrança em tempo real antes de estimar uma carga de trabalho com cache. As tarifas da Anthropic e o fato de corresponderem ao Sonnet 5 vêm do anúncio de lançamento. As tarifas de entrada e saída do GPT Proto acima refletem seu desconto de 10% no modelo.
Aqui está um cálculo deliberadamente simples. Se uma requisição usa 100.000 tokens de entrada comuns e 20.000 tokens de saída, sem cobranças de cache ou ferramentas, o custo de tokens seria US$ 0,40 nas tarifas de tabela da Anthropic e US$ 0,36 nas tarifas declaradas do GPT Proto. Essa é uma comparação para uso idêntico de tokens. Separadamente, a Anthropic diz que o Sonnet 5.5 usou menos tokens para concluir tarefas típicas em seus testes, reduzindo o custo por tarefa concluída em até 30% em relação ao Sonnet 5. Seu resultado depende da tarefa e da configuração de esforço; 30% não é um corte na tarifa de tokens, e não deve ser somado mecanicamente ao desconto de 10% do GPT Proto. Veja preços do GPT Proto para informações de cobrança no nível da conta.
O Sonnet 5.5 é bom para programação e está disponível no Claude Code?
Sim. guia de modelos do Claude Code da Anthropic lista o Sonnet 5.5. Use /model dentro do Claude Code para selecioná-lo, ou inicie uma sessão com claude --model claude-sonnet-5-5. O Claude Code e os aplicativos Claude usam o esforço Médio como padrão para este modelo; a API do Claude usa Alto como padrão. O esforço controla por quanto tempo o modelo trabalha em um problema, afetando qualidade, tempo e saída cobrada. Portanto, os padrões importam quando alguém cita uma pontuação obtida em esforço Máximo como se descrevesse uma sessão comum do Claude Code.
Em um teste comparativo inicial de um desenvolvedor, o autor executou dez tarefas pessoais de programação três vezes por configuração em esforço Alto no Claude Code e no pi-agent. O Sonnet 5.5 usou menos turnos e tokens de saída que o Sonnet 5 nessa configuração. O autor também observou que modelos mais novos já estavam passando quase todas as tarefas, limitando o que o teste poderia dizer sobre trabalho difícil. É uma observação útil sobre fluxo de trabalho, não uma taxa de vitória universal.
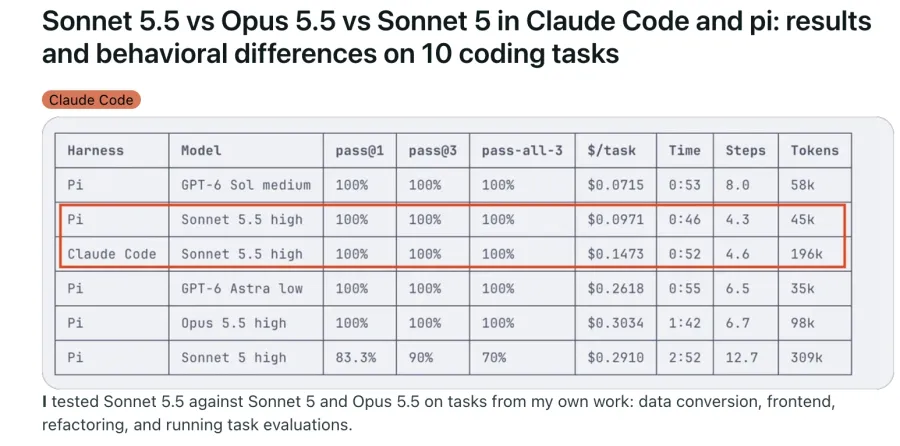
Para implementação bem especificada e correção de bugs, eu testaria o Sonnet 5.5 primeiro. Para uma mudança de arquitetura ambígua ou uma revisão em que um erro sutil é caro, teste também o Claude Opus 5.5. A própria Anthropic diz que o Opus continua mais forte em trabalho complexo e aberto, apesar das altas pontuações do Sonnet 5.5 em benchmarks individuais. Sua discussão de lançamento traça essa fronteira claramente.
Você deve atualizar uma integração existente do Sonnet 5?
Provavelmente, se sua própria avaliação melhorar. Mas alterar a string do modelo é apenas o primeiro passo para uma integração de API existente. O guia de migração do Sonnet 5.5 da Anthropic documenta configurações de requisição que podem retornar um erro 400 após a troca:
| Se sua integração com o Sonnet 5 faz isso |
Verifique antes de trocar |
Envia thinking: {"type":"disabled"} |
O Sonnet 5.5 usa between_tools para sua configuração de raciocínio mais baixa. |
Força uma ferramenta específica com tool_choice |
O Sonnet 5.5 rejeita escolhas forçadas de tool e any; revise a abordagem documentada de auto. |
| Usa uma versão mais antiga da ferramenta de uso do computador |
O conjunto de ferramentas aceito varia por plataforma; siga a tabela de migração para a sua. |
| Assume que o primeiro bloco de resposta é texto |
Leia blocos por tipo e preserve blocos de raciocínio em loops de ferramentas. |
Há também uma mudança mais discreta: os níveis de esforço foram recalibrados. Alto no Sonnet 5.5 não precisa consumir a mesma quantidade de trabalho que Alto no Sonnet 5. A Anthropic recomenda executar novamente suas próprias avaliações de qualidade, latência e custo, em vez de manter uma configuração anterior. Isso é particularmente relevante se seu agente faz chamadas repetidas de ferramentas ou se você analisa a saída do modelo em um formato fixo.
Para uma requisição básica de chat do GPT Proto, use a ação Experimente este modelo da página do modelo e o painel Uso da API para confirmar que o Sonnet 5.5 está ativo e que o ID de modelo exibido é claude-sonnet-5-5. Quando estiver ativo, a requisição padrão de chat-completions do GPT Proto tem este formato:
curl --request POST 'https://gptproto.com/v1/chat/completions' \
  --header "Authorization: Bearer $GPTPROTO_API_KEY" \
  --header 'Content-Type: application/json' \
  --data '{
    "model": "claude-sonnet-5-5",
    "messages": [{"role": "user", "content": "Resuma os riscos neste resumo de projeto em três frases."}]
  }'
Defina GPTPROTO_API_KEY com sua própria chave antes de executá-lo. O GPT Proto mostra este formato de requisição em suas páginas existentes de modelos Claude; a página do modelo Sonnet 5.5 é a fonte final para sua string de modelo ativa e disponibilidade. Opções específicas da API Claude Messages precisam de verificações de compatibilidade separadas quando usadas por um endpoint compatível com OpenAI.
Como o Sonnet 5.5 se compara a outros modelos?
Um explicador não consegue resolver toda busca de “versus” com um único ranking. A comparação muda conforme a tarefa, a configuração do agente, o esforço e o preço medidos. Estes são três pontos de referência úteis, mas limitados:
| Pergunta |
O que um teste comparável diz |
O que ele não consegue estabelecer |
| Sonnet 5.5 vs GPT-6 Astra |
Na avaliação Code Migration da Vals AI, o Sonnet 5.5 marcou 69,83% e o Astra 67,74%. |
Qual modelo é melhor para todas as tarefas de programação, pesquisa ou escrita. |
| Sonnet 5.5 vs GLM-5.3 |
No CursorBench 4.0, o Sonnet 5.5 Alto marcou 47,8% e o GLM-5.3 Alto 38,0%. |
Desempenho ou custo em seu próprio agente e repositório. |
| Sonnet 5.5 vs Claude Fable 5.1 |
No Vals Index, o Sonnet 5.5 marcou 69,22% e o Fable 5.1 68,83%. |
Um vencedor geral confiável a partir de uma pequena diferença de pontuação composta. |
Os resultados do Astra e do Fable vêm da avaliação da Vals AI, que diz ter usado esforço Máximo na maioria dos testes. O resultado do GLM vem do benchmark próprio do Cursor. Não combine as pontuações dessas duas fontes em um único ranking. Se uma alternativa específica for mais barata ou já se encaixar na sua stack, o teste relevante é se o Sonnet 5.5 conclui sua tarefa com mais precisão ou com menos gasto total.
Quem deve experimentar o Sonnet 5.5?
Comece com trabalho que tem uma linha de chegada visível: uma alteração de código definida, um bug com um teste que falha, um documento com um pacote de fontes ou uma análise repetível. Execute o mesmo pequeno lote de tarefas reais no Sonnet 5 e no 5.5 com configurações de esforço explícitas. Acompanhe se a resposta está correta, se o modelo verificou seu trabalho, quanto tempo levou e quantos tokens foram cobrados. Isso oferece uma decisão de atualização muito melhor do que escolher a maior porcentagem do dia de lançamento.
O Sonnet 5.5 é um forte candidato para esses trabalhos delimitados. É menos seguro assumir que um benchmark o torna um substituto para o Opus em trabalho aberto, ou que a economia máxima relatada pela Anthropic aparecerá em todas as faturas. Quando a página da API do Sonnet 5.5 no GPT Proto estiver ativa, você pode testá-lo junto com os outros modelos vinculados acima com a mesma conta e comparar seus próprios resultados.