Melhores gateways de IA para desenvolvedores em resumo
| Gateway de IA |
Melhor para |
Tipo de gateway |
Implantação |
Custo inicial publicado |
Principal desvantagem |
| GPT Proto |
Acesso acessível a modelos multimodais |
Gateway de modelo gerenciado |
Hospedado |
Pague conforme o uso |
Catálogo menor que o OpenRouter |
| OpenRouter |
Amplitude de modelos e provedores |
Gateway de modelo gerenciado |
Hospedado |
Taxa de 5,5% na compra de créditos |
Menos controle de infraestrutura |
| LiteLLM |
Auto-hospedagem |
Proxy de código aberto |
Auto-hospedado |
Software gratuito |
Você gerencia a infraestrutura |
| Cloudflare AI Gateway |
Limites de gastos e controles de borda |
Camada de controle gerenciada |
Hospedado ou BYOK |
Recursos principais gratuitos; taxa de faturamento unificado de 5% |
Vários recursos mais recentes permanecem em beta |
| Vercel AI Gateway |
Apps com AI SDK e Next.js |
Gateway de modelo gerenciado |
Hospedado ou BYOK |
Sem markup de tokens |
Mais atraente dentro do ecossistema Vercel |
| Portkey / Prisma AIRS |
Observabilidade e governança |
Camada de controle de produção |
Hospedado, híbrido ou auto-hospedado |
US$ 49 por mês |
Controles avançados podem exigir Enterprise |
| Kong AI Gateway |
Governança de API e agentes empresariais |
Gateway de infraestrutura |
Hospedado, híbrido ou auto-hospedado |
Baseado em componentes |
Complexo e caro para equipes pequenas |
Não existe um “melhor no geral” honesto até você decidir se precisa de acesso a modelos hospedados, controle auto-hospedado ou governança empresarial.
Como escolhemos esses gateways de IA
Comparei as plataformas nos aspectos que importam depois que um recurso de IA passa de uma demo:
Cobertura de modelos e modalidades
Migração compatível com OpenAI
Roteamento de modelos e provedores
Novas tentativas e failover automático
Cache e controles de custo de tokens
Logs de uso e atribuição de gastos
Implantação hospedada, BYOK e auto-hospedada
Taxas publicadas do gateway
Custos de infraestrutura e manutenção
Adequação para desenvolvedores individuais, startups e equipes de plataforma empresariais
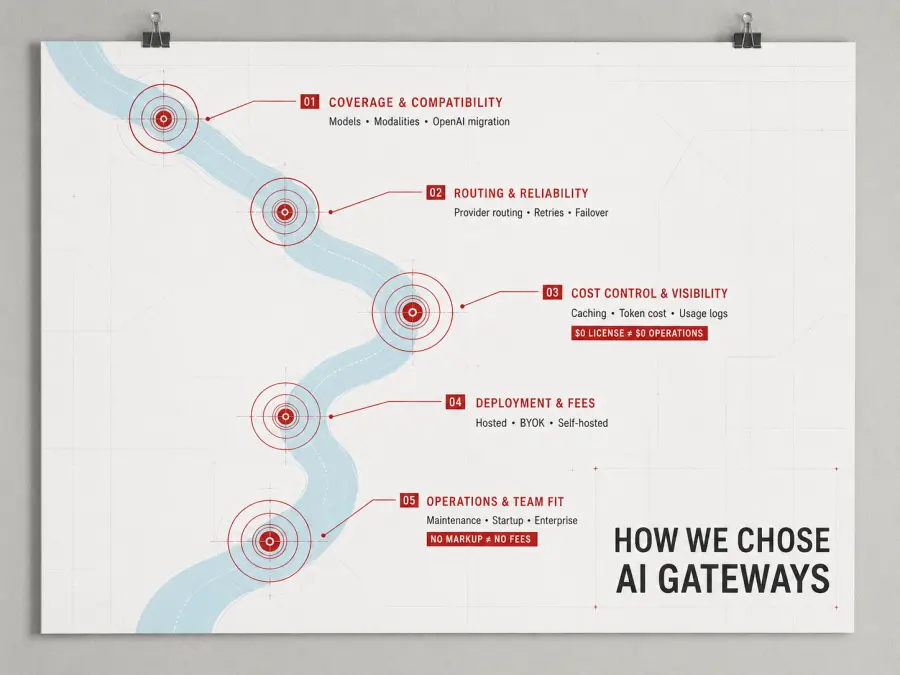
Também considerei o trabalho operacional como um custo. Software de código aberto pode ter preço de licença de US$ 0, mas alguém ainda precisa implantá-lo, protegê-lo, armazenar seus logs, atualizá-lo e responder quando ele falha.
A mesma cautela se aplica a “sem markup”. Um gateway pode repassar preços de tokens sem adicionar uma porcentagem, enquanto cobra separadamente por créditos, logs, planos de controle, recursos empresariais ou proxies de modelos.
Nem todo gateway de IA faz o mesmo trabalho
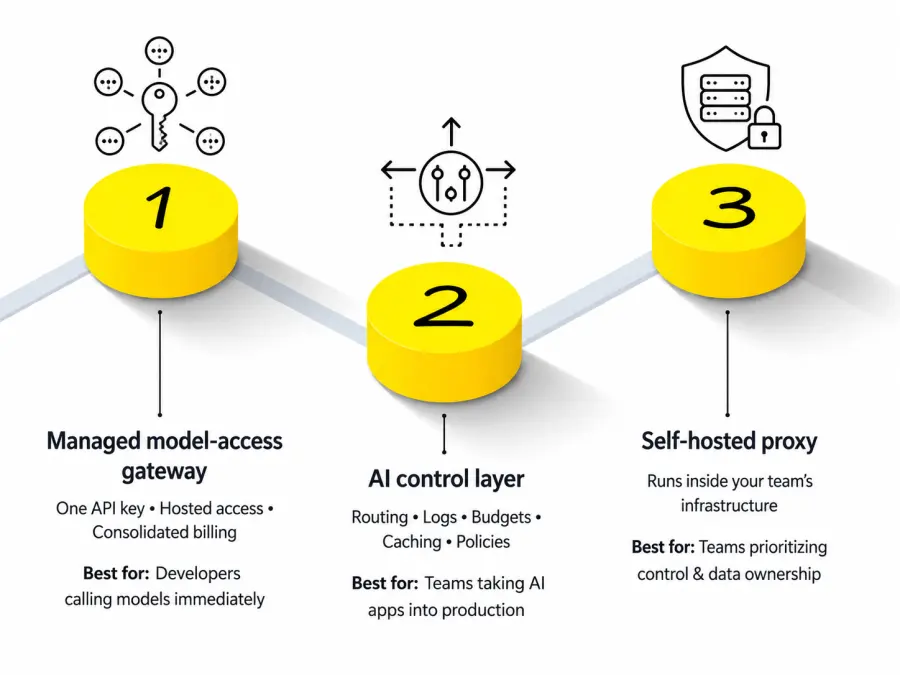
Um gateway de IA fica entre um aplicativo e um ou mais serviços de IA. Além dessa definição básica, a categoria se divide em três grupos.
| Tipo de gateway |
O que ele oferece |
Usuário típico |
| Gateway gerenciado de acesso a modelos |
Uma chave de API, acesso a modelos hospedados e faturamento consolidado |
Desenvolvedores que querem chamar modelos imediatamente |
| Camada de controle de IA |
Roteamento, logs, orçamentos, cache e políticas em torno de conexões com provedores |
Equipes levando aplicações de IA para produção |
| Proxy auto-hospedado |
Software de gateway executado dentro da infraestrutura da equipe |
Equipes que priorizam controle e propriedade dos dados |
GPT Proto e OpenRouter resolvem principalmente o acesso a modelos. O LiteLLM permite criar e operar seu próprio proxy multiprovedor. Portkey e Kong focam mais fortemente no controle do tráfego de IA entre equipes e aplicações.
Cloudflare e Vercel ficam entre essas categorias. Eles podem fornecer acesso gerenciado a modelos, mas suas vantagens mais fortes vêm da infraestrutura ao redor.
Essa distinção importa. Se você quer uma chave de API e um saldo compartilhado, instalar um proxy auto-hospedado cria mais trabalho antes de você enviar sua primeira requisição de modelo. Se sua equipe de compliance precisa de logs de auditoria, SSO, políticas de conteúdo e implantação privada, escolher apenas pela contagem de modelos perde o sentido.
1. GPT Proto — Melhor para acesso acessível a modelos multimodais
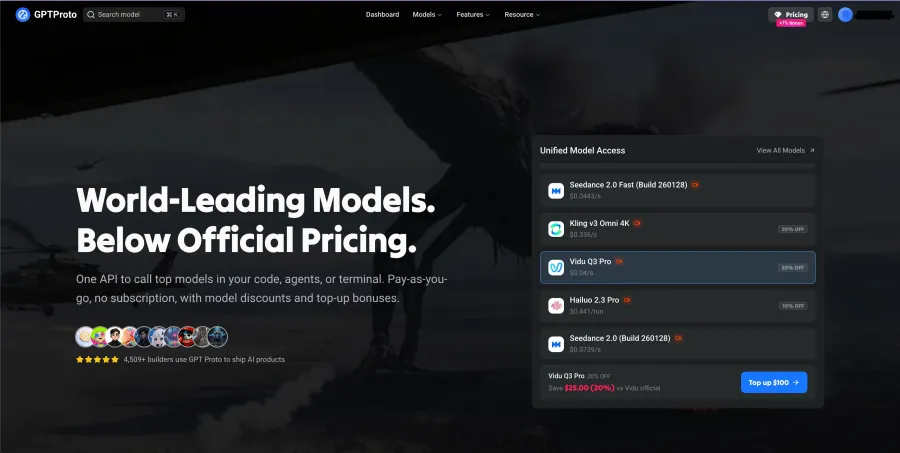
GPT Proto é uma API de IA gerenciada tudo-em-um com mais de 200 modelos de texto, imagem, vídeo e áudio em uma única conta. Desenvolvedores usam uma chave de API e um saldo compartilhado em vez de abrir e financiar contas separadas para cada provedor de modelo.
Sua vantagem mais clara é o acesso sem trabalho de infraestrutura. Você não precisa implantar um proxy, manter um banco de dados de roteamento de modelos ou armazenar várias credenciais upstream antes de chamar um modelo. A API oferece suporte a um formato de requisição compatível com OpenAI, tornando migrações comuns de modelos de texto basicamente uma questão de alterar a URL base, a chave de API e o ID do modelo.
GPT Proto usa cobrança conforme o uso, sem assinatura fixa de gateway. Modelos individuais têm seus próprios preços por token ou por geração, e rotas selecionadas têm preço abaixo de suas taxas de referência upstream. Isso é especialmente relevante para cargas de trabalho de imagem e vídeo, onde uma diferença por execução se acumula rapidamente durante a geração em lote.
A plataforma também documenta várias chaves de API, limites de crédito por chave e rastreamento de gastos por equipe ou projeto. Esses controles ajudam a impedir que uma chave de teste, um workspace de cliente ou um agente interno consuma todo o saldo da conta.
Onde o GPT Proto se encaixa
Escolha o GPT Proto quando quiser:
Acessar modelos hospedados de texto, imagem, vídeo e áudio
Usar um único saldo em vez de várias contas de provedores
Comparar modelos sem reconstruir a integração
Evitar uma assinatura fixa de gateway
Alcançar modelos chineses de imagem e vídeo junto com modelos ocidentais
Manter um formato de requisição estilo OpenAI para fluxos comuns de chat
Onde ele não se encaixa
O GPT Proto publica um catálogo de modelos menor que o OpenRouter. Ele também não deve ser confundido com um sistema completo de gerenciamento de API empresarial, como o Kong.
Se você precisa hospedar o gateway dentro da sua própria rede, projetar plugins de roteamento personalizados ou aplicar um sistema existente de políticas de API empresarial a cada requisição, um gateway auto-hospedado ou focado em infraestrutura é a categoria melhor.
Veredito: Escolha o GPT Proto quando o objetivo for chamar uma ampla variedade de modelos a preços competitivos — não se tornar seu próprio operador de gateway.
Você pode navegar pelo inventário atual no catálogo de modelos GPT Proto.
2. OpenRouter — Melhor para amplitude de modelos e provedores
O OpenRouter tem o maior catálogo publicado nesta comparação: mais de 500 modelos em mais de 80 provedores em seu plano de pagamento conforme o uso.
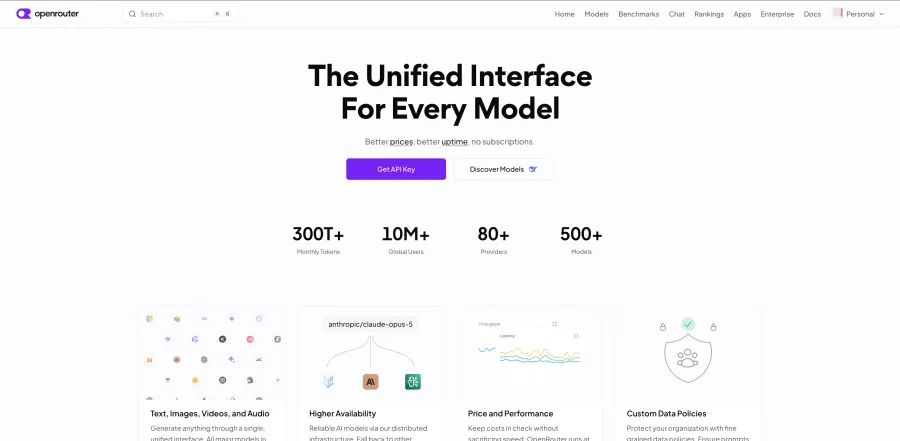
É particularmente útil quando o mesmo modelo é servido por vários provedores de inferência. Por padrão, o OpenRouter pode distribuir requisições entre provedores elegíveis, e desenvolvedores podem modificar a ordenação de provedores com base em preferências como preço, latência ou política de dados.
O OpenRouter não é mais um gateway de LLM apenas para texto. Sua documentação atual cobre geração de imagem, geração de vídeo, texto para fala, fala para texto, PDFs e entrada multimodal. Isso elimina uma distinção antiga que muitas comparações de gateways de IA ainda repetem.
Seu preço exige uma leitura mais atenta. O OpenRouter repassa os preços individuais dos modelos, mas cobra uma taxa de 5,5% quando os usuários compram créditos. O plano publicado de pagamento conforme o uso inclui US$ 25.000 de inferência BYOK a preço de tabela por mês sem taxa BYOK, seguido de uma taxa de 5% acima dessa franquia.
Onde o OpenRouter se encaixa
Escolha o OpenRouter quando precisar de:
Um grande catálogo de modelos e provedores
Roteamento em nível de provedor para o mesmo modelo
BYOK com fallback de capacidade compartilhada
Entradas e saídas multimodais
Relatórios centrais de atividade e gastos
Acesso frequente a modelos recém-listados
Onde ele não se encaixa
O OpenRouter fornece roteamento e controles organizacionais, mas ainda é mais orientado ao acesso a modelos do que uma plataforma de infraestrutura empresarial. Equipes que exigem planos de dados auto-hospedados, políticas de tráfego profundamente personalizadas ou integração com gateway de API existente podem preferir LiteLLM ou Kong.
O failover também tem um limite. Se um provedor falha antes de o streaming começar, um gateway pode tentar novamente em outro lugar. Depois que parte de uma resposta em streaming chegou ao usuário, o gateway não pode descartá-la silenciosamente e recriar a resposta completa sem que a aplicação trate essa interrupção.
Veredito: OpenRouter vence em amplitude de catálogo. Isso não o torna automaticamente a opção menos cara ou mais governável.
Para uma comparação mais específica, veja OpenRouter vs GPT Proto ou o guia de alternativas ao OpenRouter.
3. LiteLLM — Melhor gateway de IA de código aberto
O LiteLLM é a opção mais forte aqui para equipes que querem um gateway de IA de código aberto rodando em sua própria infraestrutura.
Ele oferece tanto um Proxy Server central quanto um SDK Python. O proxy é projetado para equipes de plataforma que fornecem acesso compartilhado a modelos, enquanto o SDK pode ficar diretamente dentro de uma aplicação Python. O LiteLLM atualmente anuncia mais de 140 integrações de provedores.
Sua camada de roteamento inclui balanceamento de carga, timeouts, novas tentativas, cooldowns e fallbacks de provedor. Equipes podem criar chaves virtuais, definir orçamentos, impor limites de RPM e TPM e rastrear gastos por usuário, equipe, modelo ou projeto.
Esse é um conjunto sério de capacidades para um software com nível auto-hospedado gratuito. O custo aparece em outro lugar.
O que “gratuito” não inclui
Executar o LiteLLM em produção ainda pode exigir:
Capacidade de computação em nuvem ou Kubernetes
Redis para roteamento compartilhado e estado de cooldown
Um banco de dados para chaves, usuários e registros de uso
Armazenamento de logs e cache
Métricas, alertas e backups
Correção de segurança
Atualizações de versão
Um engenheiro responsável pelo serviço
Pagamento separado para cada provedor de modelo upstream
Recursos empresariais como SSO, logs de auditoria, suporte personalizado e níveis de serviço contratuais usam preços personalizados.
O LiteLLM, portanto, é econômico quando uma equipe já tem capacidade de engenharia de plataforma ou precisa de controle o suficiente para justificá-lo. É menos atraente quando o objetivo é simplesmente chamar vários modelos hospedados com uma conta.
Veredito: O LiteLLM remove a taxa do software de gateway. Ele não remove a responsabilidade de infraestrutura.
4. Cloudflare AI Gateway — Melhor para limites de gastos e controles de borda
O Cloudflare AI Gateway combina análises de requisições, cache, limitação de taxa, novas tentativas, fallback de modelo e controles de custo dentro da infraestrutura da Cloudflare.
Os recursos principais publicados do gateway estão disponíveis sem uma assinatura separada do AI Gateway. Os limites de logs persistentes dependem do plano subjacente: o nível Workers Free atualmente inclui 100.000 logs em todos os gateways, enquanto o Workers Paid lista 10 milhões de logs por gateway.
Os limites de gastos da Cloudflare são o recurso de controle de custos mais concreto nesta comparação. Uma equipe pode definir orçamentos em dólares por modelo, provedor, usuário, equipe, aplicação, agente ou outros metadados personalizados.
Quando um limite é atingido, a Cloudflare pode rejeitar a requisição com uma resposta 429. Desenvolvedores também podem combinar o limite com uma rota dinâmica que move o tráfego de um modelo principal caro para um fallback mais barato.
Isso é diferente da limitação de taxa comum. Dez requisições curtas e dez requisições de um milhão de tokens não têm o mesmo efeito financeiro. Um limite baseado em dólares tenta controlar o gasto real em vez de contar apenas requisições.
O gateway principal da Cloudflare pode ser gratuito, mas sua opção de Faturamento Unificado aplica uma taxa de 5% quando créditos são comprados. As taxas de inferência dos provedores são repassadas separadamente.
Limites importantes
Atualmente, um gateway suporta até 20 regras de limite de gastos.
O rastreamento de gastos usa estimativas de custo com melhor esforço.
Picos simultâneos podem exceder brevemente um limite antes que os registros de uso sejam atualizados.
Roteamento dinâmico, limites de gastos e vários recursos de segurança carregaram rótulos beta.
O produto é mais conveniente quando a equipe já usa serviços da Cloudflare.
Veredito: A Cloudflare é mais forte quando o tráfego de IA é mais uma carga de trabalho dentro de uma stack Cloudflare existente.
5. Vercel AI Gateway — Melhor para AI SDK e apps Next.js
O Vercel AI Gateway é a escolha natural para desenvolvedores que criam com o Vercel AI SDK.
Ele oferece suporte ao AI SDK da Vercel, juntamente com OpenAI Chat Completions, OpenAI Responses, Anthropic Messages e endpoints compatíveis com OpenResponses. O catálogo atual abrange texto, imagem, vídeo, embeddings e reranking.
A Vercel repassa os preços de tokens upstream sem markup de tokens. O mesmo se aplica quando desenvolvedores trazem suas próprias chaves de provedor. Alguns recursos avançados permanecem vinculados a planos Vercel superiores ou cobranças de uso separadas, então “zero markup” não deve ser traduzido como “todo recurso do gateway é gratuito”.
O failover automático é um de seus recursos de produção mais fortes. O gateway pode tentar outro provedor que serve o mesmo modelo e então passar para um modelo de backup se as opções configuradas de provedor falharem.
O painel relata uso, gastos, volume de requisições, tempo até o primeiro token e contagens de tokens por modelo, provedor ou projeto. Compromissos existentes com provedores também podem fluir via BYOK.
Onde a Vercel se encaixa
É uma escolha forte para:
Aplicações com AI SDK
Projetos Next.js e hospedados na Vercel
Desenvolvedores que querem failover gerenciado de provedores
Equipes com contratos existentes com provedores
Aplicações que usam múltiplas modalidades de modelo
Seu valor é menos óbvio para um backend que não usa o SDK, a plataforma de implantação ou os sistemas de relatórios da Vercel. O gateway ainda funciona, mas parte da conveniência desaparece.
Veredito: O Vercel AI Gateway é uma recomendação fácil para uma aplicação com AI SDK e uma escolha menos automática para um backend independente de infraestrutura.
6. Portkey / Prisma AIRS — Melhor para observabilidade e governança
A Portkey está no meio de uma transição significativa de produto. A Palo Alto Networks anunciou sua intenção de adquirir a Portkey em abril de 2026, e o site atual da Portkey identifica o produto como Prisma AIRS AI Gateway.
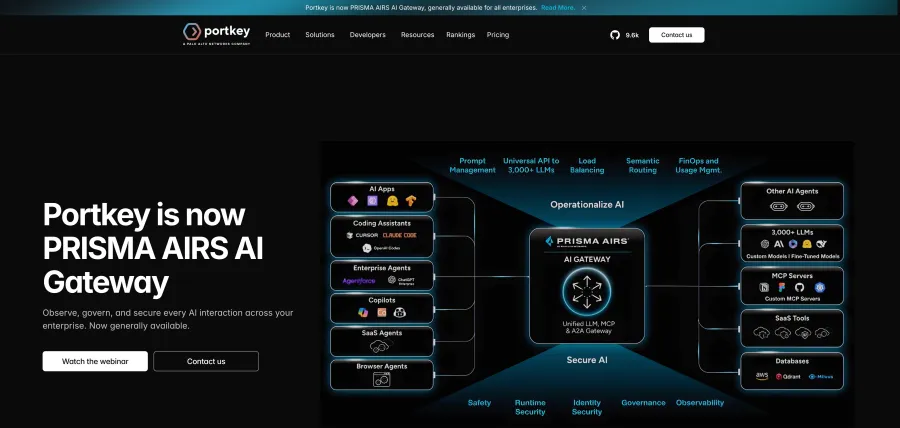
Esse status torna várias comparações mais antigas de gateways de IA desatualizadas antes mesmo de suas tabelas de recursos começarem.
O gateway combina uma API universal com novas tentativas, fallbacks, balanceamento de carga, circuit breakers, roteamento condicional e timeouts de requisição. Ele também oferece cache simples e semântico, testes canário, guardrails, suporte a MCP e observabilidade detalhada.
Seu plano Production publicado custa US$ 49 por mês. Esse plano inclui 100.000 logs registrados por mês, com US$ 9 adicionais para cada 100.000 requisições registradas extras. A retenção de logs é listada como 30 dias, enquanto as métricas são retidas por 90 dias.
O preço empresarial é personalizado e adiciona mais opções de implantação, segurança e conformidade.
Onde o preço fica complicado
Nem todo recurso exibido na documentação do produto Portkey está incluído no plano de US$ 49. Limites de orçamento, por exemplo, estão documentados como disponíveis para clientes Enterprise e alguns clientes Pro selecionados.
As equipes devem, portanto, verificar a combinação específica de:
Imposição de orçamento
Residência de dados
Implantação privada
Controles de auditoria
Guardrails
Retenção
Suporte
A transição atual de marca e propriedade cria outro motivo para confirmar o preço antes de se comprometer.
Veredito: A Portkey é atraente quando o gateway precisa explicar, rastrear e governar cada requisição — não apenas encaminhá-la.
7. Kong AI Gateway — Melhor para infraestrutura de API empresarial existente
O Kong AI Gateway está mais próximo de um sistema completo de infraestrutura do que de um marketplace de modelos.
Ele fornece uma camada de API agnóstica de provedor com autenticação, controles de acesso, streaming, balanceamento de carga, análises de uso, roteamento semântico, cache semântico, guardrails e controles de custo em nível de token.
Seu escopo agora se estende além de chamadas de modelo. O Kong pode governar tráfego MCP e comunicação agente-a-agente junto com APIs convencionais. Isso importa para equipes de plataforma empresariais que tentam aplicar uma camada de política comum em aplicações, ferramentas, modelos e agentes.
Ele também suporta várias configurações de implantação. O Kong pode gerenciar o plano de controle enquanto o cliente hospeda os planos de dados, ou um cliente empresarial pode discutir uma configuração totalmente auto-hospedada.
Essa flexibilidade vem com uma estrutura de preços mais complicada. O Kong oferece um teste de 30 dias, enquanto seu plano Plus publicado usa cobranças baseadas em componentes. A tabela atual lista itens como US$ 25 por mês para um plano de controle serverless, um limite de cinco LLMs únicos e US$ 100 por mês para cada modelo proxy. As cobranças de inferência do provedor permanecem separadas. O preço completo do Enterprise auto-hospedado é personalizado.
Para uma equipe que chama dezenas de modelos, esses custos exigem cálculo cuidadoso. Para uma empresa que já opera o Kong, no entanto, estender uma plataforma existente pode ser mais fácil do que introduzir outro gateway.
Veredito: Se sua empresa já executa o Kong, o AI Gateway é uma extensão. Se não, o Kong se torna outro sistema de infraestrutura para manter.
Como gateways de IA controlam custos e uso de tokens
Um gateway de IA não reduz custos simplesmente por existir. As economias vêm de políticas específicas aplicadas às requisições.
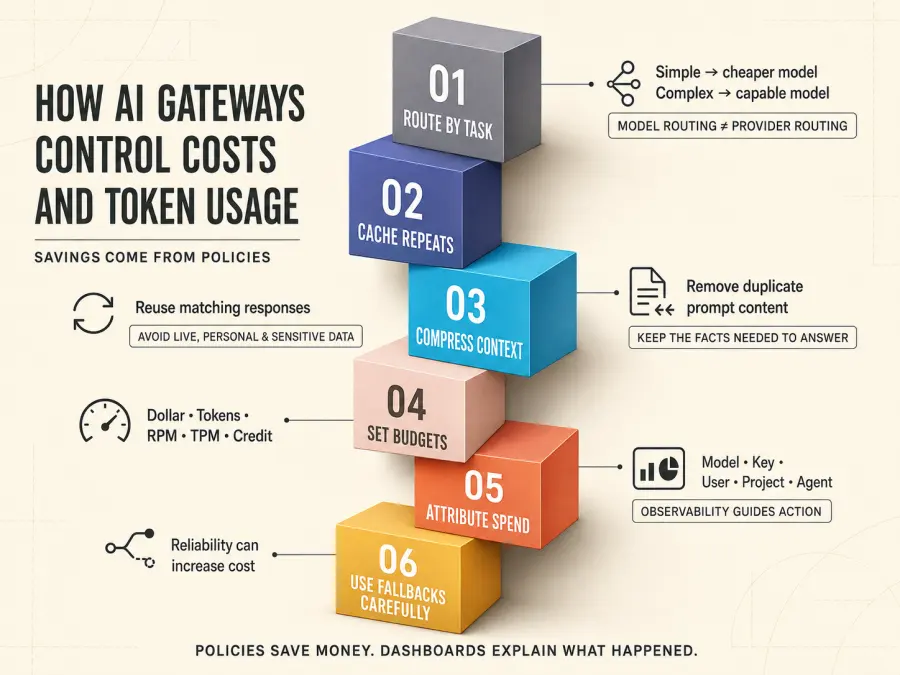
Encaminhe tarefas simples para modelos mais baratos
Um roteador de modelos pode classificar requisições e enviar trabalho rotineiro para um modelo mais barato, reservando um modelo mais caro para tarefas difíceis.
Isso pode reduzir o custo médio, mas introduz um risco de qualidade. Se o roteador confundir uma requisição complexa com uma simples, o modelo mais barato pode produzir uma resposta inutilizável.
O roteamento de provedores é diferente. Ele escolhe entre provedores que servem o mesmo modelo. Isso pode melhorar o preço ou a disponibilidade sem alterar o modelo subjacente, embora as implementações dos provedores e os parâmetros suportados ainda possam variar.
Faça cache de respostas repetidas
Um gateway pode armazenar uma resposta concluída e retorná-la quando uma requisição idêntica ou similar aparecer novamente. A requisição em cache evita outra chamada de modelo, reduzindo tanto a latência quanto os custos de tokens.
O cache funciona bem para:
Perguntas sobre documentação estática
Informações repetidas de produto
Conhecimento interno compartilhado
Requisições determinísticas de desenvolvimento e avaliação
É pouco adequado para:
Dados ao vivo
Respostas personalizadas
Políticas que mudam rapidamente
Requisições contendo contexto sensível do usuário
Tarefas em que a geração recente faz parte do requisito
O cache semântico pode aumentar a taxa de acertos ao tratar prompts similares como equivalentes, mas um limite de similaridade muito frouxo pode retornar a resposta errada.
Compacte contexto desnecessário do prompt
Prompts longos frequentemente contêm instruções repetidas, histórico de conversa duplicado ou documentos recuperados que não ajudam a responder à requisição atual.
A compressão de prompt reduz o número de tokens de entrada enviados ao provedor. O trade-off é a perda de informação. Uma regra de compressão que economiza dinheiro, mas remove o único parágrafo necessário para responder corretamente, falhou.
Defina orçamentos antes de enviar as requisições
Gateways podem impor vários tipos de limites:
| Limite |
O que ele controla |
| Orçamento em dólares |
Gasto estimado ou registrado com modelos |
| Limite de tokens |
Consumo de tokens de entrada e saída |
| RPM |
Requisições por minuto |
| TPM |
Tokens por minuto |
| Limite de crédito |
Saldo total disponível para uma chave ou projeto |
Esses controles resolvem problemas diferentes. O RPM pode desacelerar um loop de requisições, mas não distingue uma requisição barata de uma cara. Um orçamento em dólares está mais diretamente ligado à fatura, enquanto o TPM pode proteger a capacidade do provedor.
Atribua gastos a usuários, equipes e agentes
A observabilidade pode mostrar qual modelo, chave de API, cliente, projeto ou agente gerou o gasto. Essa informação ajuda uma equipe a decidir onde adicionar cache, usar um modelo mais barato ou definir um limite mais rígido.
Mas monitoramento sozinho não economiza dinheiro.
O roteamento decide para onde uma requisição vai. Um orçamento decide se ela pode ser executada. A observabilidade explica o que aconteceu.
Um painel que relata um incidente caro amanhã não o impede hoje.
Use fallbacks com cuidado
Fallbacks melhoram a confiabilidade ao tentar novamente por outro provedor ou modelo. Eles também podem alterar custos.
Mudar para outro provedor do mesmo modelo geralmente cria menos variação na saída. Mudar para um modelo diferente pode alterar:
Qualidade da resposta
Comportamento de chamada de ferramentas
Confiabilidade de saída estruturada
Limites de contexto
Velocidade da resposta
Preço dos tokens
Comportamento de segurança
Um fallback de produção deve, portanto, ser testado como seu próprio caminho de modelo, não tratado como um backup invisível.
Qual gateway de IA você deve escolher?
| Sua necessidade |
Gateway recomendado |
| Chamar modelos de texto, imagem, vídeo e áudio com um saldo |
GPT Proto |
| Acessar o maior catálogo de modelos publicado |
OpenRouter |
| Auto-hospedar o gateway e controlar chaves de provedores |
LiteLLM |
| Adicionar limites de gastos ao tráfego da Cloudflare |
Cloudflare AI Gateway |
| Criar com Vercel AI SDK |
Vercel AI Gateway |
| Centralizar logs, guardrails e governança |
Portkey / Prisma AIRS |
| Governar tráfego de API empresarial, MCP e A2A |
Kong AI Gateway |
Para um protótipo, eu evitaria implantar um grande gateway empresarial antes que a aplicação tenha tráfego real. GPT Proto, OpenRouter ou Vercel podem colocar um recurso multimodelo em execução com menos trabalho de infraestrutura.
À medida que o uso cresce, a decisão muda. Equipes de produção precisam inspecionar orçamentos, limites de taxa, logs, retenção, failover de provedor, políticas de dados e a pessoa responsável pelo gateway quando algo quebra.
Se sua empresa não tem uma equipe de DevOps ou plataforma, a auto-hospedagem não é automaticamente a opção econômica. Se sua aplicação gera principalmente imagens e vídeos, verifique o inventário real de modelos e os endpoints de tarefas em vez de aceitar um rótulo genérico de “suporte multimodal”.
Início rápido: chame um modelo de IA pelo GPT Proto
A seguinte requisição cURL chama o Gemini 3.7 Flash pelo endpoint Chat Completions compatível com OpenAI do GPT Proto:
curl --request POST "https://gptproto.com/v1/chat/completions" \
  --header "Authorization: Bearer $GPTPROTO_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "gemini-3.7-flash",
    "messages": [
      {
        "role": "user",
        "content": "Explique como um gateway de IA controla os custos de tokens."
      }
    ]
  }'
Substitua $GPTPROTO_API_KEY por uma variável de ambiente contendo sua chave. A mesma conta pode então chamar outros modelos disponíveis alterando o ID do modelo e, quando necessário, o endpoint ou campos de requisição específicos da tarefa.
Um gateway de IA não cria um sistema multiagente por si só. Ferramentas como Workbuddy, LangGraph, CrewAI ou sua própria aplicação decidem quantos agentes são executados e quais tarefas eles recebem.
Vários agentes podem usar uma única chave de API GPT Proto, desde que a conta tenha saldo suficiente e as requisições permaneçam dentro dos limites aplicáveis de concorrência e taxa. O gateway fornece acesso a modelos; o framework de agentes fornece a orquestração.
Explore o catálogo atual de modelos GPT Proto antes de escolher IDs de modelo para produção.
Veredito final
A primeira pergunta não é qual gateway de IA tem a lista de recursos mais longa. É se você quer acesso gerenciado a modelos ou controle de infraestrutura.
Escolha o GPT Proto se você quer uma chave de API e um saldo para mais de 200 modelos de texto, imagem, vídeo e áudio, com cobrança conforme o uso e sem assinatura de gateway.
Escolha o OpenRouter para o catálogo publicado mais amplo de modelos e provedores. Escolha o LiteLLM quando a auto-hospedagem e o controle de chaves de provedores justificarem a manutenção. Cloudflare e Vercel se encaixam em equipes que já trabalham dentro de seus respectivos ecossistemas. Portkey e Kong se tornam mais relevantes à medida que observabilidade, imposição de políticas, governança de MCP e requisitos de implantação empresarial crescem.
Se seu objetivo imediato é comparar modelos e começar a enviar requisições, explore mais de 200 modelos de IA pelo GPT Proto.