Qwen 3.8 Max vs GLM 5.3: a resposta curta
| Se sua prioridade for... |
Melhor ponto de partida |
Por quê |
| Codificação em escala de repositório e agentes de terminal |
GLM 5.3 |
Leve vantagem em preferência independente de codificação, resultados de agentes mais fortes relatados pelo fornecedor, menor custo de tokens |
| Codificação frontend e geração de UI |
Qwen 3.8 Max |
Vantagem clara no Arena WebDev e Frontend |
| Screenshot-to-code ou depuração visual |
Qwen 3.8 Max |
Aceita entrada de imagem e vídeo; o GPT Proto GLM-5.3 é somente T2T |
| Menor custo de API |
GLM 5.3 |
$1.26/M de entrada e $3.96/M de saída no GPT Proto |
| Controle de raciocínio |
Qwen 3.8 Max |
Suporta modos de pensamento e não pensamento; o GLM 5.3 sempre raciocina |
| Agentes de texto com contexto longo |
GLM 5.3 |
Contexto de 1M, saída de 128K, menor custo e pós-treinamento orientado a agentes |
| Um modelo para tarefas mistas de texto e visuais |
Qwen 3.8 Max |
Suporte de entrada mais amplo com a mesma classe de contexto de 1M |
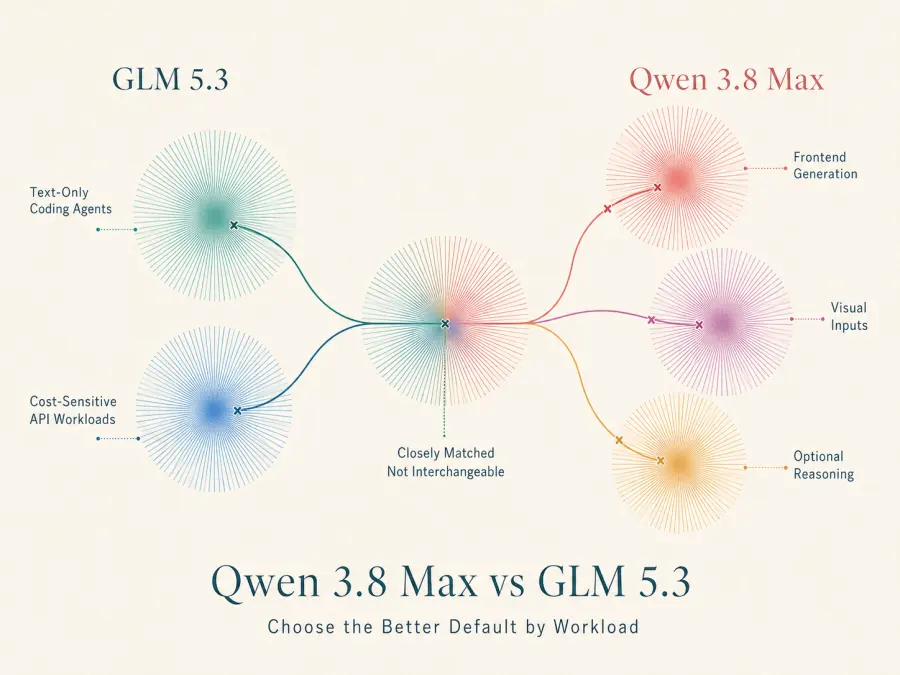
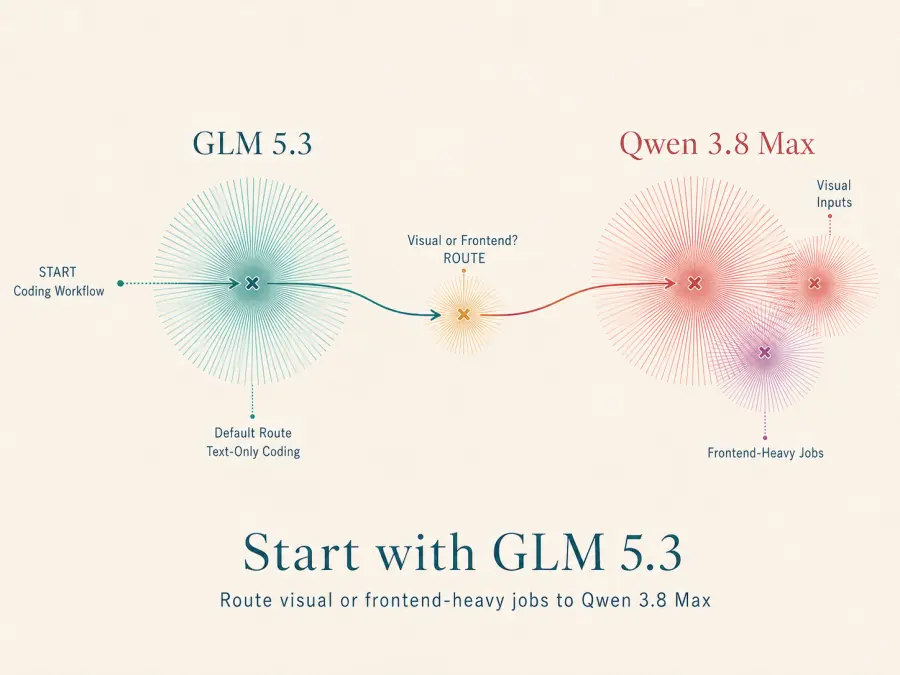
Para um fluxo de trabalho de codificação somente texto, comece com GLM 5.3 e encaminhe tarefas visuais ou com muita carga de frontend para Qwen 3.8 Max.
Qwen 3.8 Max vs GLM 5.3 em resumo
| Recurso |
Qwen 3.8 Max |
GLM 5.3 |
| Fornecedor |
Alibaba Cloud / Qwen |
Z.ai |
| ID do modelo da API no GPT Proto |
qwen3.8-max |
glm-5.3 |
| Entrada no GPT Proto |
Texto, imagem, vídeo |
Somente texto |
| Saída |
Texto |
Texto |
| Janela de contexto |
1M tokens |
1M tokens |
| Saída máxima |
131,072 tokens |
128K tokens |
| Raciocínio |
Pensamento ou não pensamento |
Sempre ativo; o esforço pode ser baixo, alto ou máximo |
| Chamada de funções |
Sim |
Sim |
| Saída estruturada |
Sim |
Sim |
| Cache de prompt |
Sim |
Sim |
| Preço de entrada no GPT Proto |
$1.80 por 1M tokens |
$1.26 por 1M tokens |
| Preço de saída no GPT Proto |
$5.40 por 1M tokens |
$3.96 por 1M tokens |
Documentação do Qwen da Alibaba descreve o Qwen 3.8 Max como um modelo carro-chefe de mistura de especialistas com 2,4 trilhões de parâmetros e uma janela de contexto de um milhão de tokens. Ele suporta entrada visual, chamadas de ferramentas, saída estruturada e cache de prompt. O serviço Max hospedado não deve ser confundido com todo modelo que carrega o nome Qwen 3.8.
Documentação do GLM 5.3 da Z.ai diz que o modelo mantém a arquitetura base do GLM 5.2 e obtém seus principais ganhos com pós-treinamento. Seu foco é codificação, agentes, uso de ferramentas, tarefas de longo horizonte e raciocínio mais eficiente. No GPT Proto, sua rota é somente texto para texto.
Comparação de benchmarks: o vencedor muda conforme a tarefa
Inteligência independente e custo
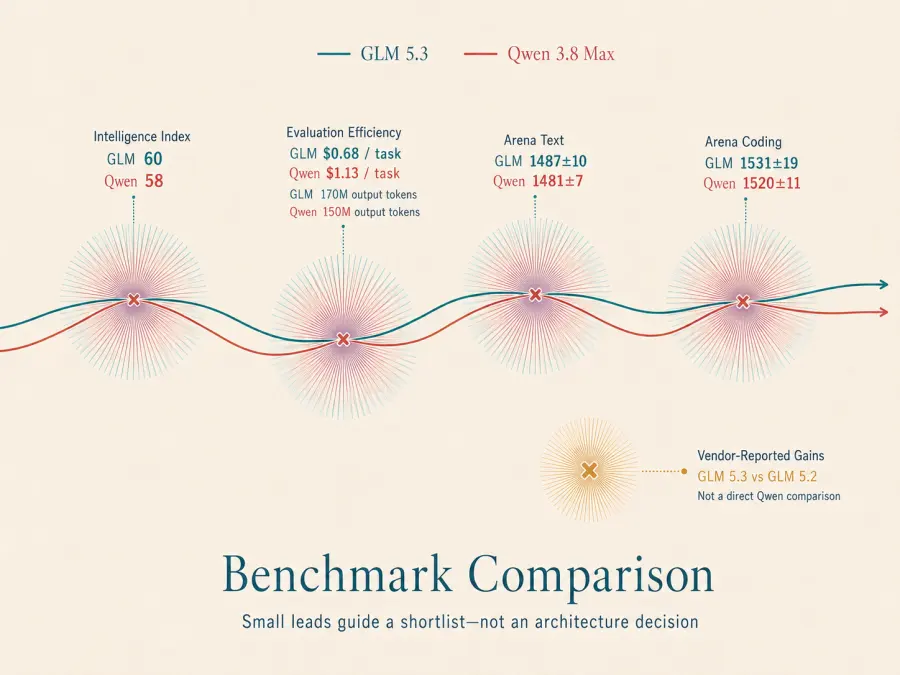
A Artificial Analysis atribui ao Qwen 3.8 Max uma pontuação de 58 no Intelligence Index e GLM 5.3 no esforço máximo de raciocínio uma pontuação de 60. A diferença é pequena, mas o resultado de eficiência é mais interessante: seu custo relatado por tarefa avaliada é $1.13 para o Qwen e $0.68 para o GLM.
O GLM produziu mais tokens de saída na avaliação — cerca de 170 milhões contra 150 milhões — mas ainda custou menos por tarefa. Isso é uma evidência útil para cargas de trabalho de agentes, porque um preço baixo por token pode ser anulado se um modelo precisar de longos rastros, novas tentativas ou chamadas de ferramentas repetidas. Aqui, o GLM manteve a vantagem de custo mesmo gerando mais tokens.
Esses são resultados controlados, não uma previsão da sua conta de produção. Cache, erros de ferramentas e novas tentativas podem mudar o resultado.
Preferência humana para texto e codificação
No ranking Arena Text, o GLM 5.3 marcou 1487±10 e o Qwen 3.8 Max marcou 1481±7 no snapshot usado para esta comparação. No subconjunto de codificação, o GLM marcou 1531±19 contra 1520±11 do Qwen.
Isso dá ao GLM uma liderança direcional, não um nocaute. Os intervalos de confiança se sobrepõem, e o intervalo de codificação do GLM é relativamente amplo. Uma diferença de seis pontos em texto ou de onze pontos em codificação deve orientar uma lista final, não decidir sozinha uma decisão de arquitetura.
Ganhos em codificação e agentes relatados pelo fornecedor
A Z.ai relata melhorias substanciais em relação ao GLM 5.2: o Terminal-Bench 3 sobe de 4.6 para 28.3, o DeepSWE 1.1 de 46.2 para 66.9, e o Agents' Last Exam de 23.8 para 28.5. Seu benchmark privado de código supostamente melhora de 23.4% para 34.5%, enquanto a saída por tarefa cai de cerca de 96K para 75K tokens.
Esses resultados apoiam o posicionamento do modelo para loops mais longos de codificação e agentes. Eles também são comparações executadas pelo fornecedor contra o GLM 5.2 — não testes diretos e independentes de Qwen 3.8 Max versus GLM 5.3. Trate-os como evidência de progresso, não como prova de que o GLM vence todas as tarefas de codificação.
Qual é melhor para codificação?
Para codificação geral, GLM 5.3 é a melhor primeira escolha quando a entrada é texto. Ele combina uma modesta vantagem nos dados de preferência de codificação do Arena com preços de API mais baixos e pós-treinamento voltado para trabalho em repositórios, uso de terminal, chamadas de ferramentas e longas trajetórias de agentes.
Isso torna o GLM uma boa opção para:
Explorar um repositório grande e propor uma alteração em vários arquivos
Executar um ciclo de teste-correção-teste por meio de um agente
Revisar pull requests ou rastrear defeitos de backend
Gerar migrações, scripts e código de serviço
Lidar com especificações de texto longas ou logs dentro de um contexto de 1M tokens
O Qwen 3.8 Max continua competitivo para o desenvolvimento cotidiano. Suas vantagens práticas são raciocínio opcional e entrada visual. Um desenvolvedor pode usar o modo sem pensamento para transformações curtas ou geração de código simples, e então ativar raciocínio mais profundo para arquitetura, depuração ou refatorações complexas. O raciocínio do GLM 5.3 não pode ser desativado, embora seu nível de esforço possa ser reduzido.
Para tarefas curtas e sensíveis à latência — renomear símbolos, escrever um pequeno teste unitário, traduzir um schema ou editar um arquivo de configuração — o caminho sem pensamento do Qwen pode ser mais fácil de controlar. Para tarefas autônomas longas em que o custo de tokens e a persistência de ferramentas importam, o GLM tem o argumento inicial mais forte.
Qwen 3.8 Max vs GLM 5.3 para codificação frontend
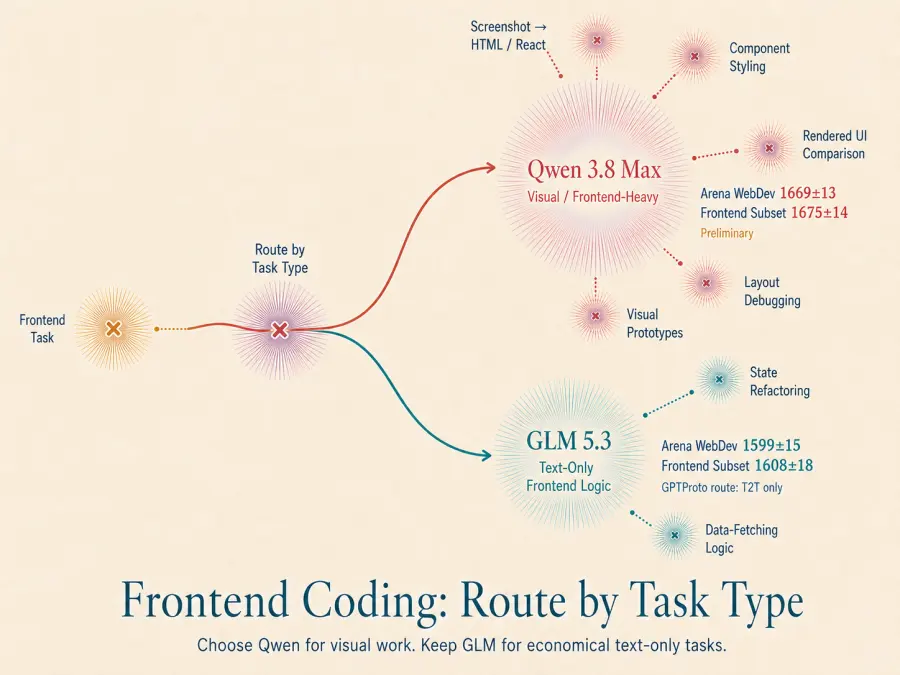
O frontend é a exceção mais clara à vantagem geral de codificação do GLM. No Arena WebDev, o Qwen 3.8 Max marcou 1669±13 em comparação com 1599±15 do GLM 5.3. No subconjunto Frontend, o Qwen marcou 1675±14 contra 1608±18 do GLM.
O resultado do Qwen foi marcado como preliminar no snapshot do ranking, então ele pode mudar conforme mais votos chegam. Mesmo com essa ressalva, a diferença observada é muito maior do que a diferença nos rankings gerais de texto e codificação.
O Qwen também aceita capturas de tela e entrada de vídeo. Isso muda o que um fluxo de trabalho de frontend pode incluir: uma captura de tela pode ser combinada com um briefing de design, uma página renderizada pode ser inspecionada em busca de defeitos visuais, ou uma gravação curta de interação pode fornecer contexto para um bug de UI. Como a rota GLM-5.3 do GPT Proto é somente T2T, ela não pode receber esses artefatos visuais diretamente.
Escolha o Qwen 3.8 Max primeiro para:
Tarefas de screenshot-to-HTML ou screenshot-to-React
Estilização de componentes e composição de página
Comparar uma UI renderizada com uma referência visual
Depurar layout, espaçamento ou comportamento responsivo a partir de imagens
Gerar protótipos em que a preferência visual é o principal critério de aceitação
Se a tarefa de frontend for majoritariamente texto — como refatorar gerenciamento de estado ou escrever lógica de busca de dados — o GLM ainda pode ser a opção mais econômica. Encaminhe por tipo de tarefa, não por rótulo de repositório.
Qual modelo é melhor para agentes?
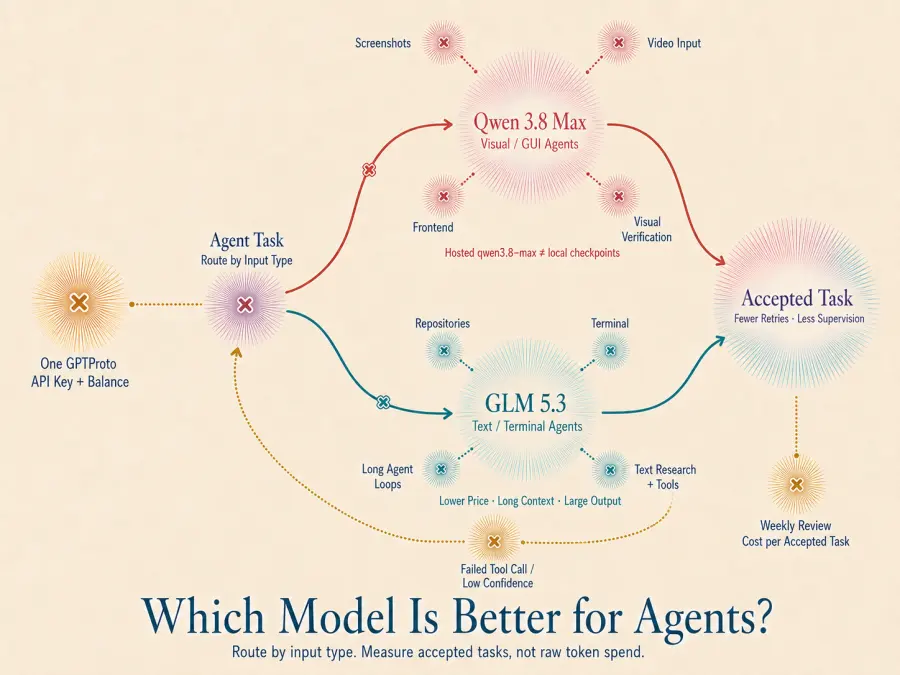
Para agentes de texto e terminal, o GLM 5.3 leva vantagem. Seu preço mais baixo, contexto longo, grande limite de saída, chamada de funções, saída estruturada e treinamento orientado a agentes o tornam um padrão sensato para codificação autônoma, pesquisa em corpora de texto e fluxos de trabalho orientados a ferramentas.
Para agentes visuais ou cientes de GUI, o Qwen 3.8 Max é a escolha prática porque pode receber entrada de imagem e vídeo. Um agente de navegador que precisa inspecionar uma captura de tela, um agente de suporte que recebe uma imagem enviada, ou um agente de codificação que compara uma referência visual com uma página renderizada exige um canal de entrada que o GLM somente texto não oferece no GPT Proto.
Discussões entre desenvolvedores acrescentam uma ressalva importante. Uma discussão no Hacker News sobre o Qwen 3.8 retorna repetidamente ao consumo de tokens, novas tentativas e ao framework de agentes. O melhor modelo é aquele que conclui uma tarefa aceita com menos tentativas falhas e menos supervisão — não simplesmente o de menor preço por milhão de tokens.
A mesma cautela se aplica a posts em redes sociais e discussões sobre modelos locais. Resultados para o Qwen3.8-27B ou outro checkpoint Qwen baixável não são resultados para o modelo hospedado qwen3.8-max. Nomes semelhantes não tornam os modelos equivalentes.
Uma política prática de roteamento é:
Envie tarefas de repositório, terminal e agentes longos somente texto para o GLM 5.3.
Envie tarefas de captura de tela, vídeo, frontend e verificação visual para o Qwen 3.8 Max.
Mantenha uma regra de fallback para chamadas de ferramentas com falha ou saídas de baixa confiança.
Revise o custo por tarefa aceita toda semana, não apenas o gasto bruto de tokens.
Ambos os modelos estão disponíveis sob uma única chave de API e saldo do GPT Proto, então este padrão de roteamento não exige manter duas integrações de fornecedor.
Preços: qual modelo é mais custo-efetivo?
Nos preços verificados em 24 de agosto de 2026, o GPT Proto lista:
| Modelo |
Entrada / 1M tokens |
Saída / 1M tokens |
Leitura de cache / 1M tokens |
| Qwen 3.8 Max |
$1.80 |
$5.40 |
$0.225 |
| GLM 5.3 |
$1.26 |
$3.96 |
$0.234 |
O Qwen também lista gravações de cache a $2.25 por milhão de tokens. As duas rotas do GPT Proto estão 10% abaixo dos preços de tabela diretos dos fornecedores: a Alibaba lista o Qwen a $2 de entrada e $6 de saída, enquanto a Z.ai lista o GLM a $1.40 de entrada e $4.40 de saída por milhão de tokens.
Considere uma carga de trabalho usando 10 milhões de tokens de entrada não cacheados e 2 milhões de tokens de saída:
O GLM economiza $8.28, ou cerca de 28.8%, neste exemplo. Sua vantagem cresce quando a saída representa uma grande parte da conta. O preço de leitura de cache do Qwen é ligeiramente menor, no entanto, então uma carga de trabalho que reutiliza repetidamente um grande prefixo estável pode reduzir a diferença.
Não pare nessa aritmética. Para cada tarefa de produção, registre o ID do modelo, a categoria da tarefa, os tokens de entrada, os tokens de saída, os tokens em cache, as tentativas, o resultado do teste, a aceitação do revisor e a latência total. Divida o gasto total pelas tarefas aceitas. Esse número captura novas tentativas e falhas que o preço por token não considera.
Raciocínio, latência e controle de produção
O Qwen 3.8 Max oferece controle mais explícito sobre quanta deliberação uma solicitação precisa. Seus modos de pensamento e sem pensamento permitem que uma equipe separe transformações rápidas de tarefas que se beneficiam de raciocínio mais profundo. A Alibaba documenta uma entrada máxima de 991,808 tokens no modo padrão e 983,616 tokens no modo de pensamento, com até 131,072 tokens de saída.
O GLM 5.3 sempre usa raciocínio. Desenvolvedores podem definir seu esforço como baixo, alto ou máximo, com máximo como padrão documentado, mas não podem desativar o raciocínio. Isso pode melhorar a persistência em tarefas difíceis de agentes, ao mesmo tempo que torna chamadas triviais menos previsíveis em latência e uso de tokens.
A decisão operacional, portanto, é simples:
Escolha o Qwen quando precisar de um caminho rápido e um caminho de raciocínio atrás de um único ID de modelo.
Escolha o GLM quando a maioria das solicitações já justifica raciocínio deliberado e preços menores de tokens importam.
Faça benchmark de fluxos de trabalho completos quando a latência for um requisito rígido; a velocidade de geração do modelo por si só não inclui execução de ferramentas, novas tentativas ou tempo de fila.
Experimente ambos por um endpoint compatível com OpenAI
A maneira mais rápida de decidir é executar os mesmos prompts representativos pelas duas rotas. Esta solicitação cURL usa o endpoint Chat Completions compatível com OpenAI do GPT Proto:
curl --request POST "https://gptproto.com/v1/chat/completions" \
  --header "Authorization: Bearer $GPTPROTO_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "glm-5.3",
    "messages": [
      {
        "role": "user",
        "content": "Review this Python function for correctness and return JSON with issues, fixes, and tests: ..."
      }
    ]
  }'
Altere apenas o valor de model para qwen3.8-max para executar o mesmo prompt de texto pelo Qwen. Use um conjunto de tarefas real em vez de algumas demos atraentes: inclua edições fáceis, alterações difíceis em repositórios, chamadas de ferramentas, tarefas de contexto longo e tarefas de frontend. Avalie correção, testes aprovados, aceitação humana, latência e total de tokens.
Pesos abertos e auto-hospedagem não são a mesma questão
A Alibaba publica o checkpoint Qwen3.8-2.4T-A95B, mas esse checkpoint baixável não é idêntico ao serviço Qwen 3.8 Max hospedado. A API Max adiciona contexto de um milhão de tokens, entrada visual, operação sem pensamento e capacidades de ferramentas hospedadas. Um benchmark local em uma variante menor do Qwen3.8 não deve ser usado como comparação direta com o Max.
A Z.ai descreveu um lançamento escalonado de pesos abertos para o GLM 5.3, mas os pesos do GLM 5.3 não estavam disponíveis publicamente para download no momento da escrita. Equipes tomando uma decisão de implantação hoje devem avaliar a API que existe hoje, não assumir que pesos prometidos, licenças, quantizações ou requisitos de serviço já estão definidos.
Veredito final
Escolha o GLM 5.3 para agentes de codificação somente texto, trabalho em repositórios, tarefas longas orientadas a ferramentas e a conta de API mais baixa. Escolha o Qwen 3.8 Max para codificação frontend, entradas de captura de tela ou vídeo, agentes visuais e cargas de trabalho que precisam de raciocínio opcional.
Se você precisa de um padrão para uma plataforma de desenvolvedor, o GLM 5.3 oferece o melhor equilíbrio entre custo e capacidade. Se seu produto cruza de código para interfaces visuais, o suporte de entrada e os resultados de preferência frontend do Qwen são mais importantes do que a pequena vantagem do GLM em inteligência geral.
A melhor configuração de produção pode usar ambos: comece com GLM 5.3 para agentes de texto, encaminhe tarefas visuais e de frontend para Qwen 3.8 Max, e mantenha o modelo que entrega o menor custo por tarefa aceita para cada categoria.