GLM-5.3 vs DeepSeek V4 Pro: comparação rápida
| Categoria |
GLM-5.3 |
DeepSeek V4 Pro |
Vencedor prático |
| Entrada e saída |
Texto → texto |
Texto → texto |
Empate |
| Janela de contexto |
1.048.576 tokens |
1M tokens |
Empate |
| Saída máxima |
131.072 tokens |
384K tokens |
DeepSeek V4 Pro |
| Índice de Inteligência Independente |
60 |
53 |
GLM-5.3 |
| Raciocínio |
Sempre ativado |
Com pensamento ou sem pensamento |
DeepSeek V4 Pro para controle |
| Esforço de raciocínio |
low, high, max; padrão max |
low, high, max; pensamento ativado por padrão |
DeepSeek V4 Pro para flexibilidade |
| Suporte a ferramentas e agentes |
Chamadas de ferramentas, saída estruturada, cache, streaming |
Chamadas de ferramentas, saída estruturada, cache, Responses API |
Depende do fluxo de trabalho |
| Pesos abertos |
Ainda não disponível para download nesta atualização |
Pesos abertos com licença MIT |
DeepSeek V4 Pro |
| Preço de entrada do GPT Proto por 1M de tokens |
$1.26 |
$1.32 pico / $0.66 fora de pico |
Depende do horário |
| Preço de saída do GPT Proto por 1M de tokens |
$3.96 |
$3.96 pico / $1.98 fora de pico |
DeepSeek V4 Pro fora de pico |
| Entrada em cache do GPT Proto por 1M de tokens |
$0.234 |
$0.044 pico / $0.022 fora de pico |
DeepSeek V4 Pro |
As especificações e os preços foram verificados em 24 de agosto de 2026. Confira a página ativa da API do GLM-5.3 e a página da API do DeepSeek V4 Pro antes de orçar uma carga de trabalho de produção.
Desempenho: GLM-5.3 tem o teto de capacidade mais alto
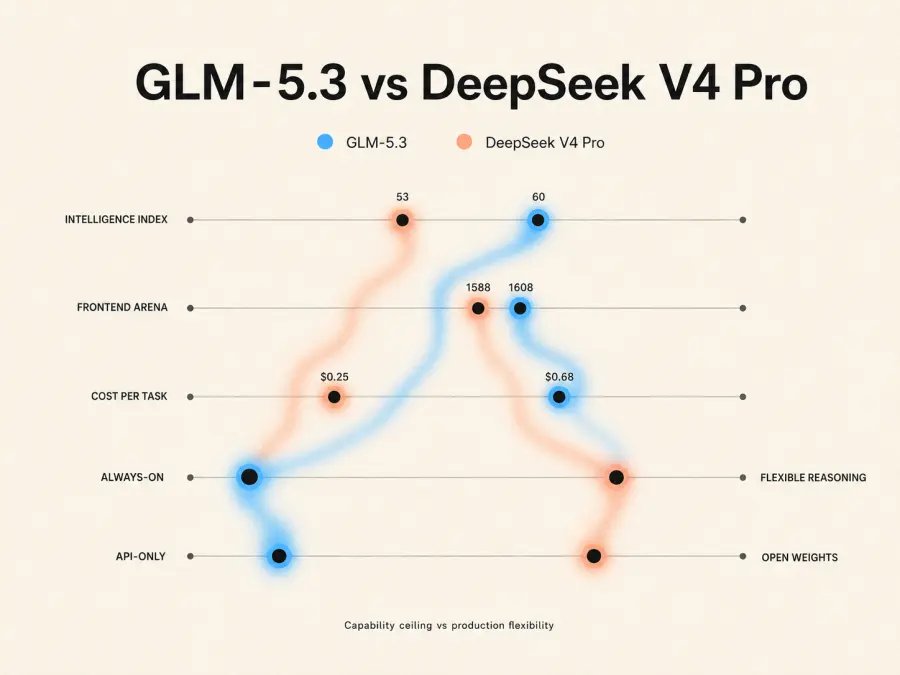
A comparação independente mais limpa disponível atualmente vem da Artificial Analysis, que avalia os dois modelos dentro da mesma metodologia mais ampla. GLM-5.3 pontua 60 em seu Índice de Inteligência, em comparação com 53 do DeepSeek V4 Pro.
Essa liderança de sete pontos torna o GLM-5.3 o primeiro candidato mais atraente para tarefas em que uma resposta falha é cara: alterações difíceis em repositórios, investigações em várias etapas, depuração complexa ou execuções de agentes que precisam se recuperar de etapas falhas.
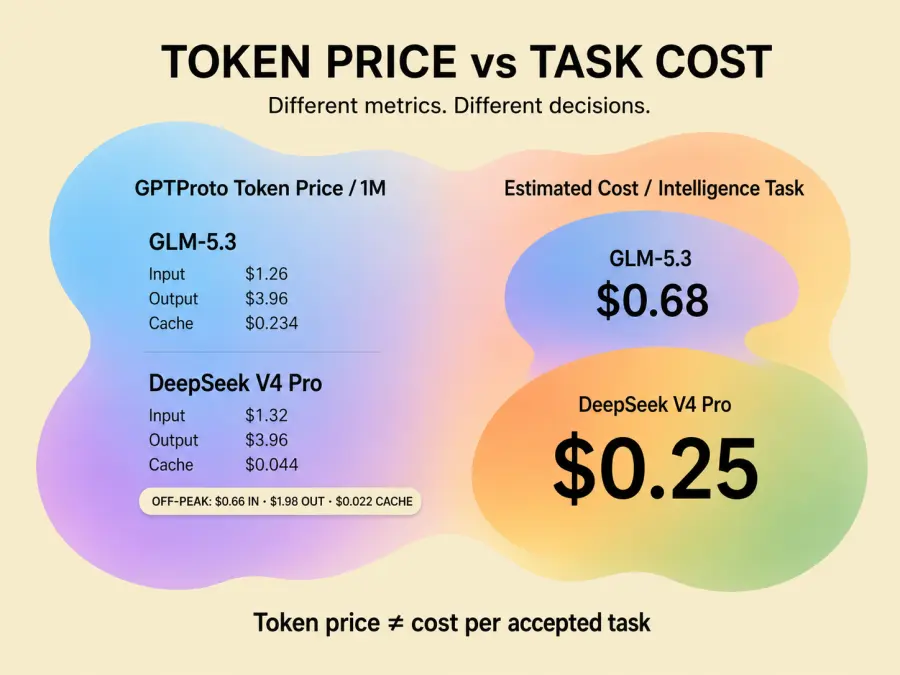
No entanto, a mesma avaliação mostra por que um vencedor de benchmark não é automaticamente o modelo mais econômico. O Artificial Analysis relata um custo estimado de $0.68 por tarefa de Inteligência para o GLM-5.3, contra $0.25 para o DeepSeek V4 Pro. Sua avaliação também gerou cerca de 170 milhões de tokens de saída do GLM contra 130 milhões de tokens de saída do DeepSeek. Esses totais são específicos da avaliação, não uma proporção universal de verbosidade, mas são um aviso útil: um modelo com preço razoável ainda pode se tornar caro se raciocinar ou escrever por mais tempo.
Também ainda não há um vencedor justo de velocidade. O Artificial Analysis relata a velocidade de saída do DeepSeek V4 Pro, mas sua página do GLM-5.3 atualmente não fornece a mesma medição completa de velocidade de saída. Comparar um resultado medido do DeepSeek com um resultado ausente do GLM criaria uma conclusão que os dados não sustentam.
Por que a comparação viral de benchmark é enganosa
A armadilha de benchmark mais importante nesta comparação diz respeito ao Terminal-Bench.
A Z.ai relata 28.3 no Terminal-Bench 3.0 para o GLM-5.3. A DeepSeek relata 87.9 no Terminal-Bench 2.1 para o V4 Pro. Uma postagem em redes sociais pode colocar 28.3 e 87.9 no mesmo gráfico, mas os números são de versões diferentes do benchmark e não podem ser usados como pontuação comparativa direta.
Isso importa porque um post popular do Cline no X enquadrou o GLM como superando o DeepSeek no Terminal-Bench. A direção pode ser interessante, mas os números públicos não justificam essa comparação exata, a menos que ambos os modelos sejam reexecutados na mesma versão, no mesmo harness de agente, ambiente de ferramentas, orçamento de tempo e regras de pontuação.
O DeepSWE fornece um sinal direcional mais útil. A Z.ai relata 66.9 no DeepSWE v1.1, enquanto a DeepSeek relata 62.7 para o V4 Pro. Mesmo aqui, trate a diferença de quatro pontos como relatada pelo fornecedor, e não como uma comparação independente controlada: configurações escolhidas pelo provedor e o scaffolding do agente podem alterar o resultado.
Veredito de desempenho: O GLM-5.3 tem o resultado independente de capacidade mais forte. As evidências sustentam uma liderança de capacidade, mas não todas as alegações dramáticas de benchmark que circulam nas redes sociais.
GLM-5.3 vs DeepSeek V4 Pro para código
Para programação, a escolha correta depende menos da linguagem de programação do que do formato da tarefa.
GLM-5.3 para trabalho difícil em repositórios
GLM-5.3 é o melhor modelo para testar primeiro quando o trabalho exige que o agente assuma a responsabilidade por uma tarefa de engenharia substancial. Exemplos incluem:
Inspecionar vários módulos antes de decidir de onde vem um bug
Planejar e implementar uma refatoração entre arquivos
Executar testes, ler falhas, revisar o patch e tentar novamente
Diagnosticar problemas de CI, dependências, terminal ou infraestrutura
Revisar caminhos de autenticação ou de controle de risco com evidências reproduzíveis
Trabalhar em uma especificação longa sem perder restrições anteriores
Isso está alinhado com o foco declarado de pós-treinamento da Z.ai: tarefas projetadas para se assemelhar a unidades completas de trabalho profissional, em vez de exercícios isolados de programação. O contexto de 1M de tokens torna grandes repositórios mais fáceis de inspecionar, enquanto o teto de saída de 128K deixa espaço para patches longos, planos de teste e relatórios de implementação.
O trade-off é o raciocínio obrigatório. O GLM-5.3 oferece suporte a low, high e max, com max como padrão. De acordo com a documentação oficial do GLM-5.3, enviar thinking.type: "disabled" pode fazer a solicitação falhar. Um desenvolvedor que migra de outra versão do GLM, portanto, precisa alterar mais do que o ID do modelo se a integração existente desativar o pensamento.
DeepSeek V4 Pro para desenvolvimento rotineiro e de alto volume
DeepSeek V4 Pro é o padrão mais prático para equipes que executam muitas solicitações de programação e precisam de controle operacional mais rígido. Ele é uma ótima opção para:
Gerar funções, testes, documentação e notas de migração
Corrigir bugs bem delimitados com etapas claras de reprodução
Revisar pull requests ou explicar código desconhecido
Produzir JSON estruturado para ferramentas de desenvolvedor downstream
Lidar com contexto de repositório repetido que se beneficia de acertos de cache
Atuar como modelo principal dentro de um assistente de IDE ou fluxo de CI
O DeepSeek pode usar pensamento para problemas difíceis e modo sem pensamento para os mais simples. Isso importa em um pipeline de agente, onde nem toda etapa merece raciocínio máximo. Classificar um problema, selecionar um arquivo, resumir a saída de uma ferramenta ou formatar uma resposta final pode ser mais barato e rápido sem um longo processo de raciocínio.
Sua saída máxima de 384K também é três vezes o limite declarado de 128K do GLM-5.3. Poucas respostas normais de programação devem se aproximar de qualquer um dos tetos, mas a capacidade extra pode importar para artefatos gerados excepcionalmente longos ou traces de agente. Isso não deve ser tratado como permissão para produzir saída ilimitada; conclusões longas aumentam a latência, a carga de revisão e o custo.
Veredito de programação para desenvolvedores
Se você quer a maior capacidade disponível para uma tarefa difícil em repositório, escolha o GLM-5.3. Se você precisa de um modelo para desenvolvimento diário, chamadas repetidas e controle de custos previsível, escolha o DeepSeek V4 Pro.
Se sua plataforma oferece suporte a roteamento, use uma política mais forte:
Comece tarefas rotineiras no DeepSeek V4 Pro.
Valide o resultado com testes ou critérios de aceitação explícitos.
Escalone falhas, bugs ambíguos ou trabalho de repositório em várias etapas para o GLM-5.3.
Isso evita pagar pelo nível mais alto de raciocínio em cada chamada, preservando o acesso ao teto de capacidade mais alto do GLM.
GLM-5.3 vs DeepSeek V4 Pro para programação frontend
A programação frontend merece uma comparação separada porque “bom em código” pode significar várias coisas diferentes: produzir componentes atraentes, seguir requisitos responsivos, implementar comportamento de produto ou manter uma aplicação com vários arquivos.
O ranking geral do WebDev Arena dá ao GLM-5.3 Max uma pontuação de 1599 ± 15, em comparação com 1582 ± 12 para o DeepSeek V4 Pro High. Na categoria dedicada de Frontend, o GLM lidera 1608 ± 18 a 1588 ± 14.
Esses resultados favorecem o GLM, mas os intervalos de confiança se sobrepõem. A conclusão defensável é uma pequena liderança do GLM, não uma vitória decisiva.
A categoria Produto de Consumo adiciona outro detalhe útil: o DeepSeek pontua 1574 ± 28, enquanto o GLM pontua 1540 ± 35. Os intervalos são amplos e ainda se sobrepõem, mas a ordem se inverte. Um modelo que vence a categoria agregada de frontend pode não vencer tarefas envolvendo fluxos de produto, comportamento de estado e interações voltadas ao consumidor.
Para uma avaliação justa de frontend, divida seu conjunto de prompts em pelo menos três grupos:
Implementação visual: layout, CSS, tipografia, espaçamento e breakpoints responsivos
Engenharia de componentes: estrutura React ou Vue, acessibilidade, props reutilizáveis e testes
Comportamento de produto: formulários, validação, transições de estado, estados vazios, erros e fluxos de várias etapas
Atualmente, ambos os modelos são texto-entrada, texto-saída. Nenhuma rota direta deve ser considerada capaz de inspecionar nativamente uma captura de tela ou um frame do Figma. Para screenshot-to-code, use um modelo de visão para extrair os requisitos visuais e depois envie a especificação resultante ao GLM-5.3 ou ao DeepSeek V4 Pro. Uma ferramenta de regressão visual deve verificar o resultado renderizado depois.
Veredito de frontend: comece com o GLM-5.3 para implementação complexa e alterações frontend em vários arquivos. Teste os dois modelos para trabalho de UI com forte foco em produto, onde o resultado disponível da categoria não sustenta uma vitória universal do GLM.
GLM-5.3 vs DeepSeek V4 Pro para fluxos de trabalho de agentes
O desempenho do agente depende de mais do que inteligência. O sistema ao redor decide o que o modelo pode ler, quais ferramentas pode chamar, por quanto tempo pode continuar, quando deve pedir permissão e o que conta como sucesso.
Onde o GLM-5.3 se encaixa melhor
O GLM-5.3 foi projetado para fluxos de trabalho de longo horizonte que alternam entre planejamento, uso de ferramentas, observação e correção. Ele é o candidato mais forte quando um agente precisa:
Explorar um grande repositório antes de fazer alterações
Usar um terminal e interpretar os resultados dos comandos
Recuperar-se de testes falhos em vez de parar após o primeiro patch
Coordenar várias fases de implementação dependentes
Produzir um relatório final auditável de ações e etapas de verificação
Seu raciocínio sempre ativado pode ser uma vantagem nessas tarefas, porque o modelo não é roteado acidentalmente para um modo superficial sem pensamento. O mesmo comportamento se torna desperdício quando o agente executa subtarefas simples.
Onde o DeepSeek V4 Pro se encaixa melhor
O DeepSeek V4 Pro oferece mais controles para orquestração de produção. O pensamento pode ser desativado, e o esforço de raciocínio pode ser aumentado apenas para as etapas que precisam. Seu preço baixo para acertos de cache é atraente para agentes que enviam repetidamente o mesmo mapa de repositório, esquema de ferramenta, política de sistema ou histórico de conversa.
O DeepSeek também fornece pesos licenciados sob MIT. Isso não torna a auto-hospedagem um projeto pequeno — o modelo completo é extremamente grande —, mas cria opções de implantação e personalização que o GLM-5.3 ainda não oferece. Nesta atualização, a Z.ai havia anunciado um plano faseado de pesos abertos para o GLM-5.3, mas os pesos e a licença final ainda não estavam disponíveis para download.
O que os relatos da comunidade acrescentam
O feedback da comunidade é útil para descobrir modos de falha, mas não deve ser apresentado como evidência controlada.
Um relato no Reddit sobre uma longa tarefa frontend descreve o GLM-5.3 trabalhando por cerca de 90 minutos em aproximadamente 60 arquivos e várias fases. Isso sustenta a impressão de que o GLM está disposto a persistir em tarefas grandes, mas é o fluxo de trabalho de um usuário, não uma comparação repetível de modelos.
Outra discussão no OpenCode relata um agente GLM ultrapassando as restrições pretendidas, seguindo um caminho improdutivo e consumindo cerca de $10. O relato não estabelece um defeito geral do modelo, mas destaca uma preocupação real de produção: persistência sem guardrails pode se transformar em expansão de escopo e custo.
Independentemente do modelo escolhido, o harness do agente deve impor:
Permissões explícitas de arquivo e comando
Orçamentos máximos de tokens, tempo e dólares
Pontos de verificação antes de ações destrutivas ou amplas
Um limite de tentativas e hipóteses repetidas
Testes ou critérios de aceitação que encerram a execução quando o objetivo é atingido
Logs de chamadas de ferramentas, uso de tokens, latência e status final da tarefa
Veredito do agente: O GLM-5.3 é o melhor modelo de escalonamento para trabalho autônomo difícil. O DeepSeek V4 Pro é o melhor padrão quando controle, cache e custo operacional importam ao longo de muitas etapas de agente.
Preços do GLM-5.3 vs DeepSeek V4 Pro
Nas tarifas de pico, os dois modelos parecem quase empatados nos preços normais de entrada e saída via GPT Proto. A maior diferença está na entrada em cache e no desconto por horário do DeepSeek.
| Custo do GPT Proto por 1M de tokens |
GLM-5.3 |
DeepSeek V4 Pro |
| Entrada padrão ou de pico |
$1.26 |
$1.32 |
| Saída padrão ou de pico |
$3.96 |
$3.96 |
| Entrada em cache |
$0.234 |
$0.044 |
| Entrada fora de pico |
Não listado |
$0.66 |
| Saída fora de pico |
Não listado |
$1.98 |
| Entrada em cache fora de pico |
Não listado |
$0.022 |
O DeepSeek define fora de pico como todas as horas fora de suas janelas de pico em dias úteis, das 01:00–04:00 e 06:00–10:00 UTC. Fins de semana são fora de pico. Confira a documentação oficial de preços da DeepSeek e a página ao vivo do modelo no GPT Proto, porque as regras de cobrança e os preços podem mudar.
Qual modelo é mais econômico?
Para uma solicitação curta sem acerto de cache durante horários de pico, a diferença é insignificante: a entrada do GLM é um pouco mais barata, e a saída custa o mesmo. O DeepSeek se torna claramente mais barato em três situações:
A aplicação reutiliza repetidamente um grande prompt de sistema, resumo de base de código ou histórico do agente.
O trabalho pode ser executado durante os períodos fora de pico do DeepSeek.
Etapas simples podem usar o modo sem pensamento em vez de raciocínio obrigatório.
O GLM-5.3 ainda pode ser a escolha econômica para uma tarefa difícil se obtiver sucesso em menos tentativas. Uma execução de $0.20 aceita na primeira tentativa custa menos do que três execuções de $0.10 que falham na revisão. É por isso que a unidade correta não é apenas custo por token, mas também custo por tarefa aceita.
Para cada modelo, registre:
Tokens de entrada, entrada em cache, raciocínio e saída
Configuração de esforço de raciocínio
Latência total
Número de tentativas e chamadas de ferramentas
Se os testes ou a aceitação do revisor foram aprovados
Custo total do primeiro resultado aceito
O resultado independente de custo por tarefa disponível atualmente favorece o DeepSeek V4 Pro por uma ampla margem, enquanto a pontuação de inteligência favorece o GLM-5.3. Esse é o trade-off central da comparação.
Qual modelo você deve escolher?
| Sua prioridade ou carga de trabalho |
Modelo recomendado |
Por quê |
| Maior capacidade geral |
GLM-5.3 |
Índice de Inteligência independente mais alto |
| Assistente de programação diário |
DeepSeek V4 Pro |
Bom desempenho com melhor controle de raciocínio |
| Depuração difícil em nível de repositório |
GLM-5.3 |
Melhor candidato para trabalho de engenharia em várias etapas |
| Implementação frontend |
GLM-5.3 primeiro |
Pequena liderança no geral do WebDev e em Frontend |
| Comportamento de UI de produto de consumo |
Testar ambos |
DeepSeek lidera o resultado disponível da categoria |
| Tráfego de API de alto volume |
DeepSeek V4 Pro |
Melhor economia de cache e modo sem pensamento opcional |
| Agentes de programação com uso intenso de cache |
DeepSeek V4 Pro |
Entrada em cache muito mais barata |
| Saída gerada extremamente longa |
DeepSeek V4 Pro |
Máximo de 384K contra 128K |
| Implantação com pesos abertos |
DeepSeek V4 Pro |
Pesos com licença MIT estão disponíveis |
| Implantação com um único modelo |
DeepSeek V4 Pro |
Padrão mais equilibrado para custo e controle |
| Roteamento multimodelo |
DeepSeek → GLM |
Padrão para eficiência; escale para capacidade |
Se você está escolhendo para uma demonstração única de benchmark, o GLM-5.3 é o modelo mais impressionante. Se você está escolhendo para um sistema de produção que lida com milhares de solicitações de dificuldade mista, o DeepSeek V4 Pro é o padrão mais seguro. Se você pode usar os dois, rotear por dificuldade da tarefa é mais forte do que forçar cada solicitação pelo mesmo modelo.
Para decisões relacionadas dentro de cada família, veja GLM-5.3 vs GLM-5.2 e DeepSeek V4 Pro vs DeepSeek V4 Flash.
Como comparar os dois modelos pelo GPT Proto
O GPT Proto expõe ambos os modelos pelo mesmo endpoint Chat Completions compatível com OpenAI. Mantenha o prompt, as ferramentas, o limite de tempo e o teste de aceitação inalterados; troque apenas o ID do modelo.
curl "https://gptproto.com/v1/chat/completions" \
  --header "Authorization: Bearer $GPTPROTO_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "glm-5.3",
    "messages": [
      {
        "role": "system",
        "content": "Complete the task, follow the acceptance criteria, and report the checks you performed."
      },
      {
        "role": "user",
        "content": "Review this repository migration plan, identify the three highest-risk dependencies, and propose one executable verification step for each."
      }
    ]
  }'
Execute a mesma solicitação novamente com:
"model": "deepseek-v4-pro"
Não julgue as respostas apenas pelo tom ou pelo comprimento. Verifique se cada risco identificado é real, se as verificações propostas podem ser executadas, quantas correções foram necessárias e quanto custou o resultado aceito.
Uma chave e um saldo do GPT Proto podem ser usados para ambas as rotas, então este teste A/B não exige integrações separadas de provedores. Abra a página da API do GLM-5.3 ou da API do DeepSeek V4 Pro para verificar disponibilidade e preços ao vivo antes de testar.
Veredito final
GLM-5.3 vence no teto de capacidade. Ele tem a pontuação de inteligência independente mais alta e uma pequena liderança nos resultados gerais e de frontend do WebDev Arena. Ele deve ser o primeiro modelo a testar para trabalho difícil em repositórios, investigações longas orientadas por ferramentas e tarefas de programação em que a falha é mais cara do que tokens extras.
DeepSeek V4 Pro vence em flexibilidade de produção e custo-benefício. Ele oferece suporte a operação com e sem pensamento, disponibiliza uma saída máxima muito maior, tem entrada em cache substancialmente mais barata, oferece descontos fora de pico e disponibiliza pesos com licença MIT para equipes que precisam de um caminho de implantação aberto.
Para a maioria dos desenvolvedores, a melhor resposta prática para GLM-5.3 vs DeepSeek V4 Pro é:
Use o DeepSeek V4 Pro como modelo padrão, depois escale as tarefas mais difíceis que falharam ou de alto risco para o GLM-5.3.