LLMs acessíveis para programação em resumo
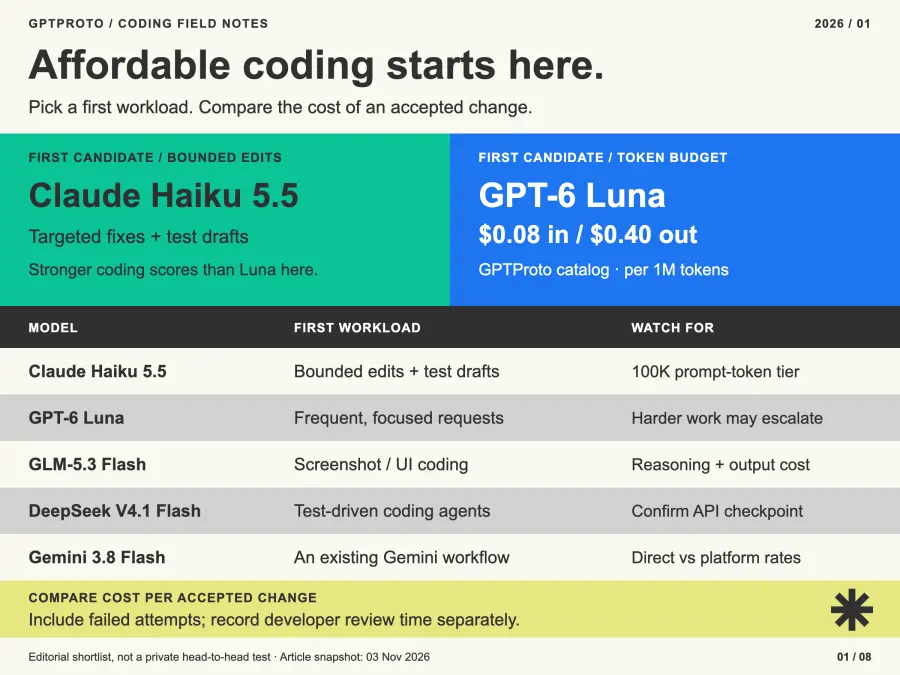
| Modelo |
Primeira carga de trabalho a avaliar |
Principal compromisso (trade-off) |
| Claude Haiku 5.5 |
Edições de código delimitadas, rascunhos de testes e subtarefas de programação |
Sua camada de preço baixo termina acima de 100 mil tokens de prompt |
| GPT-6 Luna |
Solicitações de programação frequentes e de escopo restrito |
Trabalhos mais complexos no repositório podem exigir escalonamento |
| GLM-5.3 Flash |
Tarefas de programação envolvendo capturas de tela ou referências de interface |
O esforço de raciocínio e o tamanho da saída afetam a fatura |
| DeepSeek V4.1 Flash |
Agentes de programação com testes e limites de novas tentativas |
Confirme o checkpoint servido pelo alias da API |
| Gemini 3.8 Flash |
Programação dentro de um fluxo de trabalho existente do Gemini |
As taxas promocionais diretas do provedor diferem das cotações da plataforma |
Se você estiver escolhendo o fornecedor além do modelo, nossa comparação de plataformas de API de IA para desenvolvedores aborda as questões mais amplas de acesso, faturamento, integração e controles de produção.
Como comparamos custo e capacidade de programação
Um modelo de LLM acessível para programação precisa ter capacidade suficiente para a tarefa antes que seu preço por token se torne útil. Priorizamos evidências específicas de programação e, em seguida, verificamos o custo da carga de trabalho, camadas de contexto, compatibilidade de ferramentas e uma página de modelo disponível no GPT Proto.
Os resultados a seguir vêm da Artificial Analysis. O Terminal-Bench 4.0 avalia a programação por agentes e o uso de terminal; o FrontierCode 2.0 avalia a engenharia de software em repositórios de código aberto. Configurações diferentes podem alterar os resultados, portanto, a configuração avaliada permanece ao lado de cada modelo.
| Modelo avaliado |
Terminal-Bench 4.0 |
FrontierCode 2.0 |
| Claude Haiku 5.5 Max |
33% |
35% |
| GPT-6 Luna Max |
13% |
25% |
| GLM-5.3 Flash conforme listado |
33% |
18% |
| DeepSeek V4.1 Flash 1017 Max |
34% |
28% |
| Gemini 3.8 Flash High |
20% |
19% |
As comparações subjacentes são Haiku versus Luna, DeepSeek versus GLM Flash e Haiku versus Gemini. Essas porcentagens descrevem essas avaliações, não a taxa de sucesso esperada do seu repositório. Elas também não estabelecem a latência ou o tempo de atividade do GPT Proto.
As estimativas de preço abaixo mantêm o uso de tokens constante para expor a aritmética de faturamento. Modelos reais podem usar contagens de tokens diferentes para o mesmo prompt, especialmente quando o raciocínio está ativado.
As 5 melhores LLMs acessíveis para programação
1. Claude Haiku 5.5 para tarefas de codificação delimitadas
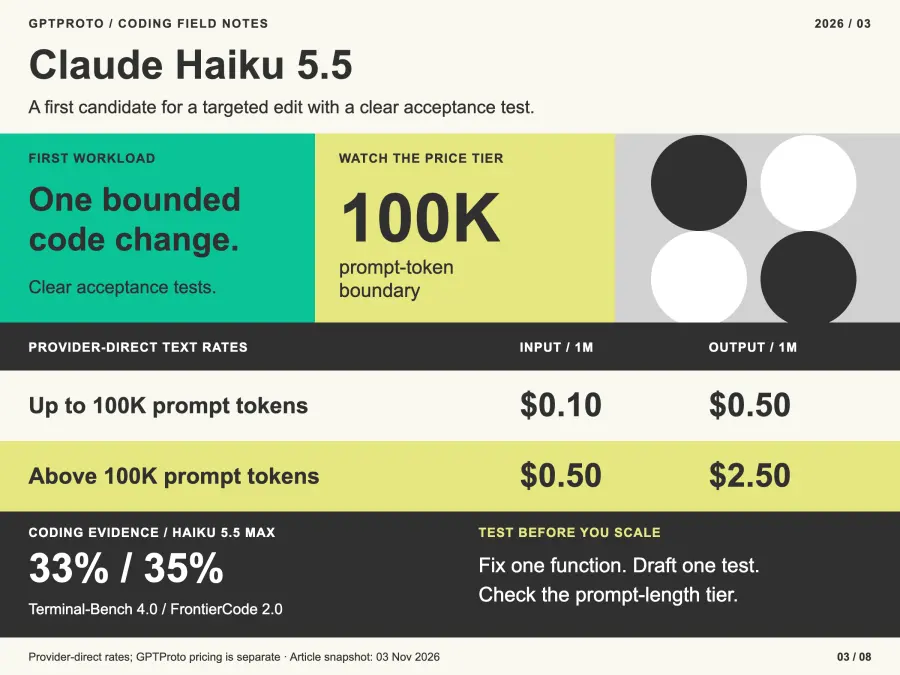
Claude Haiku 5.5 é nosso primeiro candidato para uma edição direcionada com um teste de aceitação claro e um prompt abaixo de 100 mil tokens. Seus resultados de codificação acima fazem com que valha a pena avaliá-lo antes de pagar por um modelo Claude maior.
O anúncio de lançamento da Anthropic posiciona o Haiku como um modelo para trabalho repetitivo e subtarefas de codificação, ao lado do Sonnet e do Opus. Isso sugere um escopo inicial prático: corrigir uma função, redigir um teste ou investigar uma falha contida.
O limite de custo importante é o tamanho do prompt. As taxas de entrada/saída sobem de US$ 0,10/US$ 0,50 para US$ 0,50/US$ 2,50 por milhão de tokens acima de 100 mil tokens de prompt. Uma janela de contexto grande não torna o nível mais barato disponível em toda essa janela.
2. GPT-6 Luna para solicitações frequentes e focadas
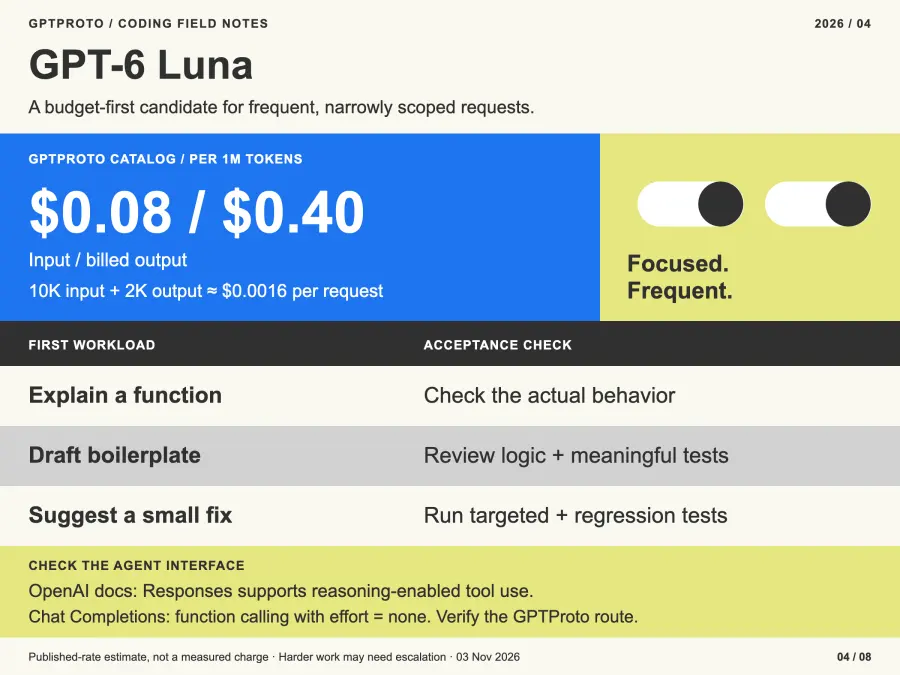
GPT-6 Luna é o candidato focado em orçamento para solicitações repetidas e limitadas: explicar uma função, redigir um boilerplate ou sugerir uma pequena correção que testes existentes possam avaliar.
Sua taxa publicada no catálogo GPT Proto é de US$ 0,08 de entrada e US$ 0,40 de saída por milhão de tokens. As pontuações públicas de codificação são menores que as do Haiku, então faríamos o Luna conquistar um papel mais amplo por meio de avaliação específica da tarefa.
Verifique a superfície de integração ao criar um agente. A documentação do modelo OpenAI especifica o uso de ferramentas com raciocínio habilitado por meio de Respostas; o Chat Completions permite a chamada de função com o esforço de raciocínio definido como nenhum. Confirme o que a rota GPT Proto expõe antes de tratar a troca de modelo como uma alteração apenas de configuração.
3. GLM-5.3 Flash para codificação visual econômica
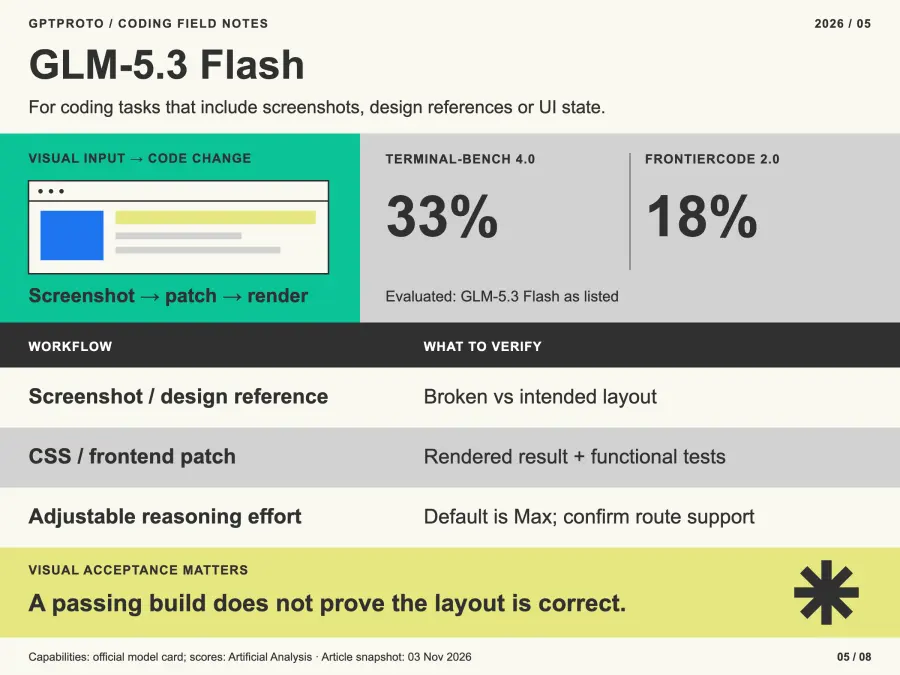
GLM-5.3 Flash deve estar na lista de candidatos quando uma tarefa de codificação incluir uma captura de tela, referência de design ou interface renderizada. Por exemplo, um assistente de frontend pode precisar comparar um layout quebrado com o estado pretendido antes de propor alterações de CSS.
O cartão oficial do modelo GLM-5.3 Flash documenta entrada multimodal, pesos abertos e esforço de raciocínio ajustável. Seu esforço padrão publicado é o máximo. Use outra configuração apenas após verificar como a rota hospedada a suporta.
Suas duas pontuações de codificação diferem substancialmente. Esse é um motivo para testar sua combinação de tarefas em vez de tratar um benchmark terminal como um ranking universal de edição de código. Correções visuais também precisam de uma comparação renderizada; a compilação por si só não pode estabelecer que o layout está correto.
4. DeepSeek V4.1 Flash para Agentes de Programação Orientada a Testes
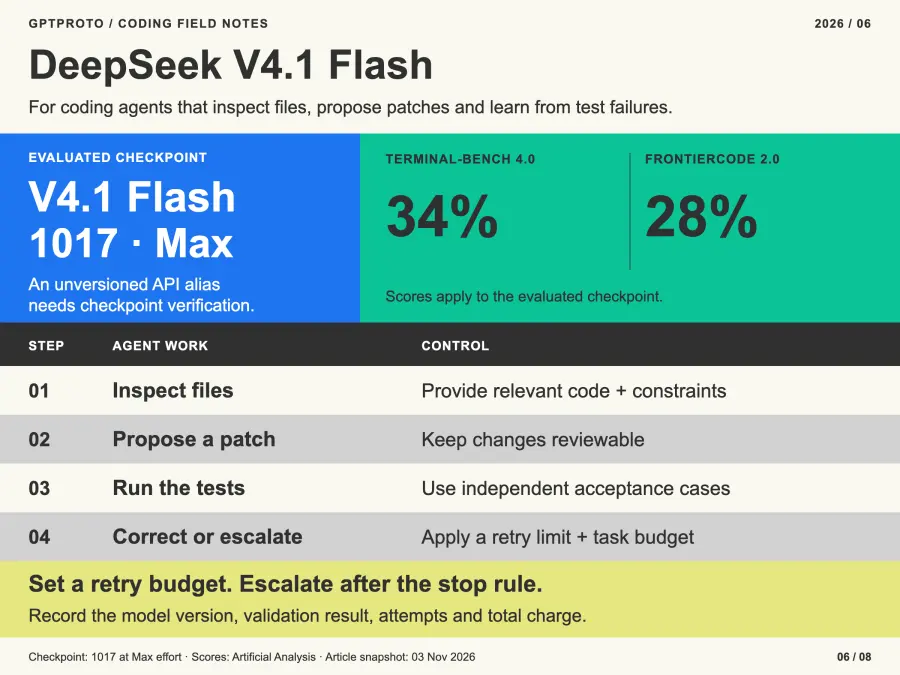
DeepSeek Flash vale a pena ser avaliado para agentes que inspecionam arquivos, propõem alterações, recebem falhas de teste e tentam novamente dentro de um orçamento definido.
O anúncio de lançamento de 17 de outubro descreve melhorias no desempenho de codificação, velocidade de conclusão de tarefas e tamanho de saída. Os resultados independentes em nossa tabela referem-se especificamente ao V4.1 Flash 1017 com esforço máximo. Um alias sem versão não prova, por si só, que sua plataforma atende a esse checkpoint; registre a versão resolvida sempre que disponível.
Para uma visão mais ampla de DeepSeek, GLM, Qwen e Kimi, veja nossa comparação de LLMs chineses para programação. Mantenha os candidatos mais fortes disponíveis quando uma alteração difícil no repositório esgotar a rota de baixo custo.
5. Gemini 3.8 Flash para Fluxos de Trabalho Existentes do Gemini
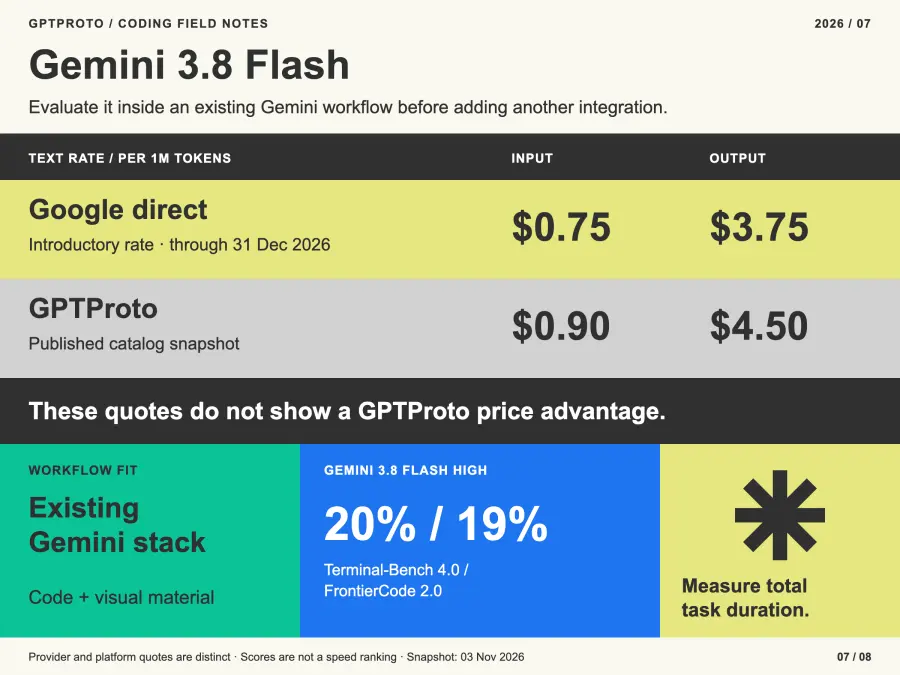
Gemini 3.8 Flash é um candidato quando seu aplicativo já utiliza o Gemini ou combina código com material visual. Avalie-o nesse fluxo de trabalho existente antes de adicionar outra integração específica de provedor.
A atualização do modelo do Google documenta o raciocínio ajustável e uma taxa introdutória de provedor direto de US$ 0,75 de entrada/US$ 3,75 de saída por milhão de tokens até 31 de dezembro de 2026. O snapshot do catálogo do GPT Proto publicado é de US$ 0,90/US$ 4,50. Esses números não sustentam a alegação de que o GPT Proto é mais barato que a promoção atual do Google.
Incluiríamos o Gemini pela adequação ao fluxo de trabalho, não por conceder a ele um título de velocidade por causa da palavra Flash. Meça o tempo até uma resposta utilizável e a duração total da tarefa em seus prompts.
Comparativo de Preços da API de LLM para Programação
Esta tabela utiliza tarifas públicas diretas do provedor sob as condições declaradas, não as tarifas de faturamento do GPT Proto. Manter a fonte e a carga de trabalho explícitas torna a comparação reproduzível.
A solicitação pequena contém 10 mil tokens de entrada e 2 mil tokens de saída faturados. A linha de base do repositório contém 200 mil tokens de entrada e 20 mil tokens de saída faturados. Ambos assumem que não há cache hits; a saída faturada deve incluir tokens de raciocínio quando aplicável.
| Modelo e condição de preço |
Entrada / saída por 1 milhão de tokens |
Solicitação pequena |
Linha de base do repositório |
| Haiku 5.5 com até 100 mil tokens de prompt |
$0,10 / $0,50 |
$0,0020 |
Use o próximo nível |
| Haiku 5.5 acima de 100 mil tokens de prompt |
$0,50 / $2,50 |
Não aplicável |
$0,1500 |
| GPT-6 Luna dentro de seu nível de contexto base |
$0,10 / $0,50 |
$0,0020 |
$0,0300 |
| GLM-5.3 Flash na tarifa padrão publicada |
$0,15 / $0,50 |
$0,0025 |
$0,0400 |
| DeepSeek Flash na tarifa de pico upstream |
$0,30 / $1,20 |
$0,0054 |
$0,0840 |
| Gemini 3.8 Flash na tarifa direta introdutória |
$0,75 / $3,75 |
$0,0150 |
$0,2250 |
As evidências das tarifas vêm da documentação do modelo vinculada e das comparações independentes acima. As notas de lançamento da DeepSeek confirmam que as tarifas de tokens fora do horário de pico são metade das tarifas de pico. O Luna aplica tarifas mais altas para a solicitação completa acima de 272 mil tokens de entrada. As tarifas introdutórias do Gemini terminam em 2026. Verifique a rota e a data aplicáveis antes de fazer o orçamento.
Para acesso ao GPT Proto, use o painel de preços em tempo real nas páginas dos modelos vinculados. Dois exemplos claros de catálogo são o Luna a $0,08/$0,40 e o Haiku a $0,09/$0,45 no nível de preço baixo. A mesma solicitação pequena estima $0,0016 e $0,0018, respectivamente. Estes são cálculos de tarifas publicadas, não cobranças medidas.
Para um pequeno aplicativo que faz 10.000 solicitações pequenas por mês, o exemplo do Luna upstream ou do Haiku de nível baixo totaliza $20 antes de novas tentativas e outras cobranças. Essa estimativa deixa de ser útil se o aplicativo enviar uma quantidade diferente de contexto ou gerar saídas muito mais longas.
O cache precisa de seu próprio cálculo: adicione entrada não armazenada em cache, leituras de cache, quaisquer gravações ou armazenamento em cache e saída faturada. Um prefixo de repositório estável pode ajudar, mas alterar o prompt ou perder o cache altera a economia.
O teste do Haiku 5.5 de Simon Willison fornece um exemplo concreto de como diferentes configurações de esforço alteram o tempo e o custo. Ele também discute mudanças no tokenizador. A lição para o orçamento é medir o uso real em vez de assumir que cada modelo fatura o mesmo número de tokens para textos idênticos.
Qual modelo se adequa à sua tarefa de programação
| Tarefa |
Candidatos iniciais |
Verificação de aceitação |
| Uma edição de código contida ou correção de bug |
Haiku 5.5 e Luna |
Testes direcionados mais testes de regressão existentes |
| Elaboração de testes unitários ou boilerplate |
Luna e Haiku 5.5 |
Revisar asserções e verificar casos de falha significativos |
| Uma correção de frontend visual |
GLM-5.3 Flash e Gemini 3.8 Flash |
Comparação renderizada mais testes funcionais |
| Um agente de programação de várias etapas |
DeepSeek Flash e Haiku 5.5 |
Tarefa concluída, chamadas de ferramenta válidas, contagem de tentativas e custo total |
Estes são pontos de partida para avaliação. Um teste gerado que simplesmente repete a suposição equivocada do modelo pode passar, enquanto o recurso permanece incorreto. Preserve casos de aceitação independentes e inspecione as alterações nos próprios testes.
Para agentes que também pesquisam documentos, classificam solicitações ou realizam tarefas de suporte, nosso guia de API de LLM acessível para agentes de IA cobre a combinação mais ampla de cargas de trabalho.
Quando um modelo de programação premium vale a pena
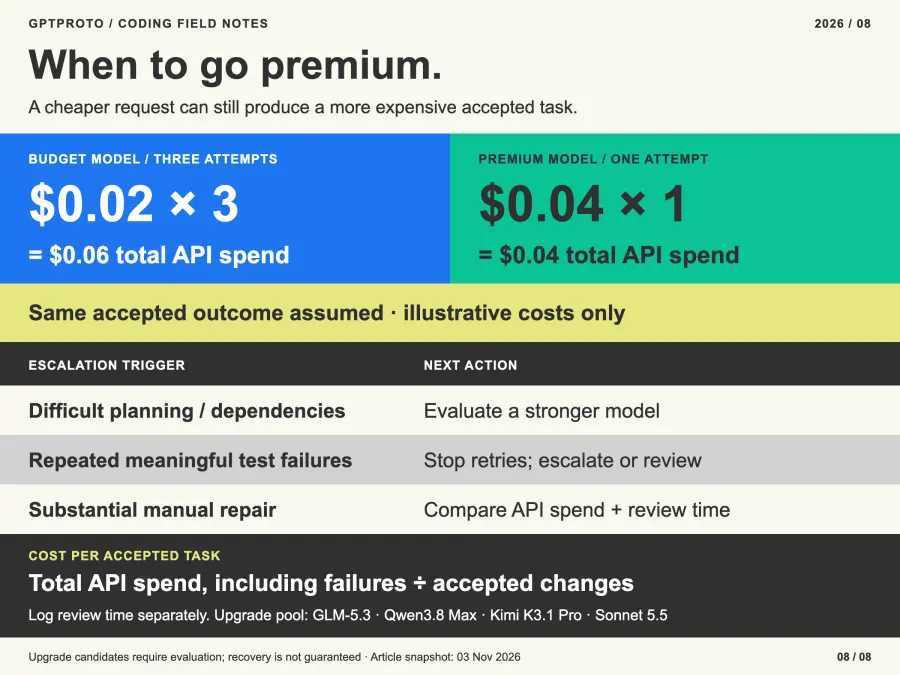
Escale quando a tarefa exigir planejamento difícil, falhar repetidamente em testes significativos ou exigir reparo manual substancial. GLM-5.3, Qwen3.8 Max, Kimi K3.1 Pro e Claude Sonnet 5.5 podem formar um grupo de avaliação separado para esse trabalho. A inclusão deles aqui é um caminho de atualização a ser investigado, não uma afirmação de que eles sempre recuperam tarefas de modelos de baixo custo que falharam.
Use o custo por tarefa aceita: gasto total com API durante a avaliação dividido pelo número de alterações aceitas. Inclua os gastos com tentativas fracassadas. Registre o tempo de revisão separadamente para que uma conta de API baixa não oculte limpezas dispendiosas feitas pelo desenvolvedor.
Para uma comparação ilustrativa, três tentativas de $0,02 custam $0,06. Uma tentativa de $0,04 que conclui a mesma tarefa imediatamente custa menos no geral. Suas taxas de sucesso medidas decidem se essa compensação é válida.
Como usar modelos de baixo custo sem tentativas infinitas
Defina a verificação de aceitação e a regra de parada antes da primeira solicitação. Uma política inicial prática é uma tentativa inicial, uma correção usando a falha do teste e, em seguida, escalonamento ou revisão humana. Ajuste essa política usando os resultados observados e um orçamento de tarefa.
O aplicativo deve registrar o modelo e o checkpoint, a configuração de raciocínio, o uso de tokens, o tempo decorrido, o resultado da validação e a cobrança total. O modelo propõe um patch; seu executor executa testes; sua lógica de roteamento decide o que acontece a seguir.
Uma API de vários modelos simplifica o acesso e o faturamento. Testes de aprovação, roteamento consciente do orçamento e escalonamento automático ainda exigem recursos de plataforma verificados ou lógica de aplicativo. Nosso guia de gateways de IA para desenvolvedores compara as diferentes camadas de acesso e controle.
Experimente um modelo de codificação acessível através do GPT Proto
Abra a página de um modelo selecionado, escolha Experimentar este modelo e revise o Guia de Início Rápido e os preços atuais. Prepare uma chave de API e saldo. Se o painel oferecer Copiar Markdown para IA, passe esse guia para o seu assistente de codificação com a tarefa e os critérios de aceitação. Mantenha a chave real em seu ambiente local ou no armazenamento de segredos do servidor.
Para um primeiro exercício reproduzível, corrija esta função de paginação: as páginas começam em um, page e per_page são números inteiros, valores abaixo de um devem gerar um ValueError, e a lista de entrada deve permanecer inalterada.
Salve o seguinte como request_patch.py em uma nova pasta de trabalho. Ele usa a biblioteca padrão do Python, solicita uma função candidata, verifica sua sintaxe e a salva para revisão. Ele não executa o código retornado.
import ast
import json
import os
import time
from pathlib import Path
from urllib.error import HTTPError, URLError
from urllib.request import Request, urlopen

key = os.environ.get("GPTPROTO_API_KEY")
if not key:
    raise SystemExit("Defina GPTPROTO_API_KEY no seu ambiente.")

source = """def paginate(items, page, per_page):
    start = page * per_page
    return items[start:start + per_page]
"""
task = (
    "Corrija paginate. As páginas começam em um. page e per_page são "
    "inteiros; gere um ValueError se qualquer um for menor que 1. Retorne uma "
    "lista vazia após a última página. Não altere items. Mantenha "
    "a assinatura. Retorne apenas a função, sem Markdown "
    "ou explicações.\n\n" + source
)
payload = {
    "model": os.environ.get("GPTPROTO_MODEL", "gpt-6-luna"),
    "messages": [{"role": "user", "content": task}],
}
request = Request(
    "https://gptproto.com/v1/chat/completions",
    data=json.dumps(payload).encode("utf-8"),
    headers={
        "Authorization": f"Bearer {key}",
        "Content-Type": "application/json",
    },
    method="POST",
)
started = time.perf_counter()
try:
    with urlopen(request, timeout=60) as response:
        result = json.load(response)
except HTTPError as exc:
    raise SystemExit(f"A API retornou HTTP {exc.code}.") from exc
except (URLError, TimeoutError) as exc:
    raise SystemExit("A solicitação falhou ou excedeu o tempo limite.") from exc

try:
    code = result["choices"][0]["message"]["content"]
except (KeyError, IndexError, TypeError) as exc:
    raise SystemExit("Nenhum texto candidato na resposta da API.") from exc
if not isinstance(code, str) or not code.strip():
    raise SystemExit("A resposta não continha código Python.")
code = code.strip()
try:
    ast.parse(code)
except SyntaxError as exc:
    raise SystemExit("Revise a resposta; não é um Python simples.") from exc

Path("candidate.py").write_text(code + "\n", encoding="utf-8")
print("candidate.py salvo. Revise-o antes de executar os testes.")
print("Segundos:", round(time.perf_counter() - started, 2))
print("Uso:", json.dumps(result.get("usage", {})))
Salve estas verificações de aceitação como test_candidate.py:
import unittest
from candidate import paginate


class PaginationTests(unittest.TestCase):
    def test_pages(self):
        items = [0, 1, 2, 3, 4]
        self.assertEqual(paginate(items, 1, 2), [0, 1])
        self.assertEqual(paginate(items, 2, 2), [2, 3])
        self.assertEqual(paginate(items, 3, 2), [4])
        self.assertEqual(paginate(items, 4, 2), [])
        self.assertEqual(items, [0, 1, 2, 3, 4])

    def test_empty_input(self):
        self.assertEqual(paginate([], 1, 2), [])

    def test_invalid_values(self):
        for page, per_page in [(0, 2), (-1, 2), (1, 0), (1, -1)]:
            with self.subTest(page=page, per_page=per_page):
                with self.assertRaises(ValueError):
                    paginate([0, 1], page, per_page)


if __name__ == "__main__":
    unittest.main()
Com a chave de ambiente configurada, execute python request_patch.py. Revise candidate.py e, em seguida, execute python -m unittest -v test_candidate.py. Uma verificação de sintaxe apenas estabelece que o Python consegue analisar a saída; os testes avaliam o comportamento declarado. Este pequeno exercício não é um benchmark em escala de repositório.
Repita com outro ID de modelo documentado através de GPTPROTO_MODEL. Registre tanto as falhas quanto os sucessos e use o uso retornado juntamente com a taxa de cobrança aplicável para comparar os custos. Um tempo limite ou uma tentativa falha ainda deve constar no registro de avaliação.
Escolha uma tarefa específica, mantenha suas verificações de aceitação fixas e compare dois candidatos. Acesse a página da API do Claude Haiku 5.5 ou a página da API do GPT-6 Luna para revisar os preços atuais e iniciar sua primeira solicitação de codificação.