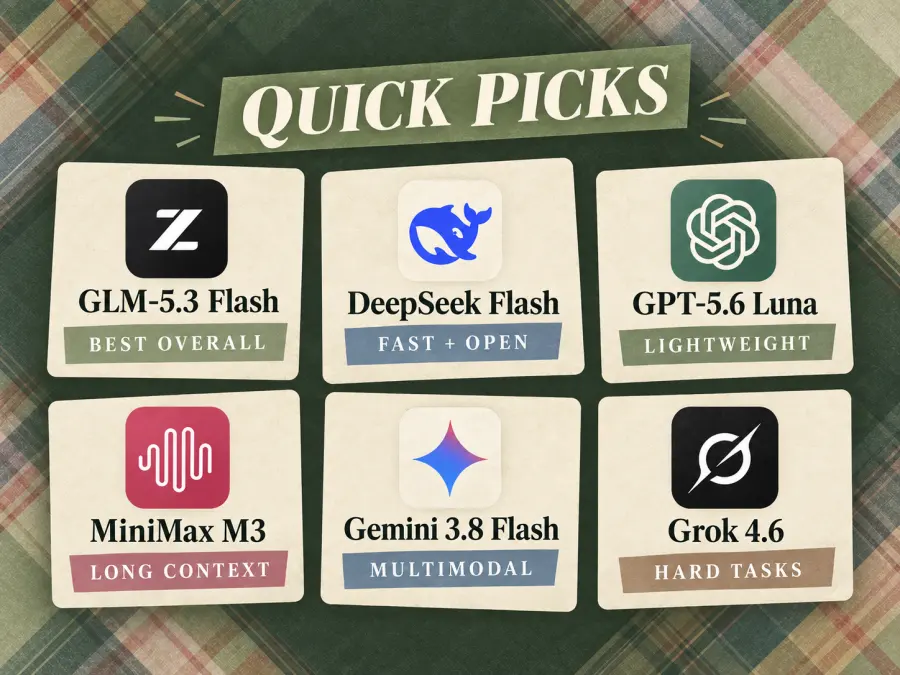
Melhores APIs de LLM Acessíveis para Agentes em Resumo
| Ranking |
Modelo |
String de modelo GPT Proto |
Preço de entrada/saída GPT Proto por 1M de tokens |
Contexto |
Melhor para |
| 1 |
GLM-5.3 Flash |
glm-5.3-flash |
$0.15 / $0.50 |
Até 1M |
Melhor API acessível geral para agentes |
| 2 |
DeepSeek Flash |
deepseek-flash |
$0.30 / $1.20 |
Até 1M |
Agentes rápidos, de pesos abertos e com muita entrada |
| 3 |
GPT-5.6 Luna |
gpt-5.6-luna |
Confirme a tarifa GPT Proto ativa antes da publicação |
Cerca de 1M |
Chamadas de agente leves e de alto volume |
| 4 |
MiniMax M3 |
MiniMax-M3 |
$0.48 / $0.96 |
Cerca de 1M |
Agentes de documentos com contexto longo |
| 5 |
Gemini 3.8 Flash |
gemini-3.8-flash |
$0.90 / $4.50 |
Cerca de 1M |
Agentes multimodais rápidos |
| 6 |
Grok 4.6 |
grok-4.6 |
$1.20 / $3.60 |
500K |
Escalonamento difícil em várias etapas |
Os preços foram verificados em 15 de setembro de 2026. As tarifas de API e descontos promocionais podem mudar, então confirme a página do modelo ativa antes de estimar um orçamento de produção.
Compare antes de se comprometer: Explore os modelos de IA disponíveis da GPT Proto e mantenha os IDs dos modelos pré-selecionados atrás de configuração para poder trocar sem reconstruir todo o agente.
Como Classificamos Estes LLMs Acessíveis para IA Agêntica
Simon Willison oferece uma definição prática útil: um agente LLM executa ferramentas em loop para atingir um objetivo. Esse loop muda como a acessibilidade deve ser medida. Uma comparação normal de chatbot pode focar no custo de uma resposta; uma comparação de agentes também deve contar chamadas de ferramentas, resultados de ferramentas, tentativas repetidas, tokens de raciocínio e execuções malsucedidas.
Usamos a seguinte ordem de avaliação.
1. O modelo precisa passar por um portão de capacidade de agente
Um modelo não foi incluído apenas por ter um preço baixo por token. Cada opção pré-selecionada precisava de uma rota documentada para chamada de função ou uso de ferramentas, além de uma forma utilizável de retornar dados estruturados ou continuar um fluxo de trabalho com múltiplos turnos.
2. Evidências públicas de agentes importam mais do que uma pontuação de conhecimento geral
O Berkeley Function Calling Leaderboard é especialmente útil para entender o que uma avaliação de uso de ferramentas deve inspecionar: seleção correta de função, argumentos válidos, comportamento em múltiplos turnos e casos em que o modelo deve evitar chamar uma ferramenta. No entanto, seu leaderboard público foi atualizado pela última vez em 12 de abril de 2026, o que antecede a maioria dos modelos deste artigo. Portanto, usamos sua metodologia em vez de atribuir suas pontuações mais antigas a lançamentos mais recentes.
Também fazemos referência à Artificial Analysis. Seu Intelligence Index inclui trabalho de conhecimento agêntico, trabalho do mundo real, automação SaaS, uso de terminal e avaliações de contexto longo. Ele continua sendo um índice misto — não uma pontuação pura de chamada de função — e deve ser tratado como evidência de triagem, não como garantia para um agente específico.
3. Custo por tarefa bem-sucedida importa mais do que preço por token
A métrica útil de produção é:
Custo por tarefa bem-sucedida = Custo total da API de todas as tentativas e repetições / Conclusões de tarefas aceitas
Esse cálculo deve incluir entrada não cacheada, entrada cacheada, saída, tokens de raciocínio ocultos ou cobrados quando aplicável, tentativas falhas e chamadas de recuperação. Se um modelo conclui 90 de 100 tarefas e outro conclui 60, comparar apenas suas taxas de token de destaque esconde o custo de reparar as outras 40 tarefas.
4. Velocidade, verbosidade e atrito de integração afetam o custo
Tokens de saída por segundo medem apenas a fase de geração. Eles não capturam o tempo até a primeira resposta, raciocínio interno, execução de ferramentas, atrasos por limite de taxa ou chamadas repetidas. Um modelo verboso também pode transformar um preço baixo de saída em uma conta final maior.
Por fim, APIs semelhantes ainda têm regras específicas de modelo. Campos de raciocínio, parâmetros de amostragem não suportados, IDs de resposta de função e capitalização de nomes de modelo podem quebrar um fluxo de trabalho que de outra forma seria portável. É por isso que a string exata do modelo GPT Proto é incluída para cada entrada.
1. GLM-5.3 Flash — Melhor API de LLM Acessível Geral para Agentes
O GLM-5.3 Flash atualmente oferece o melhor equilíbrio entre tarifas baixas por token e recursos de agente documentados nesta lista. Na GPT Proto, o modelo está listado a $0.15 por milhão de tokens de entrada, $0.03 por milhão de tokens de entrada em cache e $0.50 por milhão de tokens de saída.
O modelo aceita texto, imagens, vídeo e arquivos e pode retornar texto ou chamadas de ferramentas. Ele suporta chamada de função, JSON estruturado, cache de contexto, streaming de resposta e argumentos de ferramentas transmitidos. Sua janela de contexto grande é útil quando um agente precisa reter documentos, resultados anteriores de ferramentas, capturas de tela ou um longo histórico de trabalho.
A triagem independente é promissora. A Artificial Analysis relata uma pontuação no Intelligence Index de 42 e uma velocidade de saída de cerca de 107 tokens por segundo. O modelo gerou mais tokens de saída do que a mediana de comparação durante essa avaliação, então as equipes ainda devem definir limites de saída e etapas.
A principal desvantagem é que o raciocínio está sempre ativado. Isso pode ajudar em decisões ambíguas sobre ferramentas, mas é uma sobrecarga desnecessária para classificação ou extração básica. “Flash” não deve ser interpretado como prova de que toda solicitação terá a menor latência ponta a ponta.
Escolha o GLM-5.3 Flash quando:
um agente precisa de chamadas de função baratas em volume significativo;
um fluxo de trabalho combina texto com capturas de tela, vídeo, gráficos ou arquivos;
saída estruturada e argumentos de ferramentas transmitidos importam;
pesos abertos e acesso hospedado são ambas opções úteis.
Evite usá-lo como único modelo quando: o fluxo de trabalho inclui muitas solicitações triviais em que o raciocínio sempre ativado adiciona custo sem melhorar as taxas de aceitação.
Para a maioria das equipes, glm-5.3-flash é o primeiro modelo mais sensato a avaliar.
2. DeepSeek Flash — Melhor Modelo Rápido de Pesos Abertos para Agentes Baseados em Ferramentas
A string de modelo GPT Proto deepseek-flash atualmente roteia para DeepSeek V4.1 Flash. A rota suporta entrada de texto e imagem, chamadas de ferramentas, saída JSON, streaming, operação com e sem raciocínio e uma janela de contexto de até um milhão de tokens.
Sua tarifa GPT Proto é $0.30 por milhão de tokens de entrada, $0.006 por milhão de tokens de leitura de cache e $1.20 por milhão de tokens de saída. Essa taxa extremamente baixa de leitura de cache é relevante para agentes que reutilizam repetidamente instruções estáveis, descrições de ferramentas ou material de referência.
A Artificial Analysis mediu uma pontuação no Intelligence Index de 40 e cerca de 222 tokens de saída por segundo. Ele foi substancialmente mais rápido que o GLM-5.3 Flash nessa medição, embora também tenha sido altamente verboso em todo o conjunto de avaliação. Um modelo rápido ainda pode gerar uma conta alta se produzir mais tokens do que a tarefa precisa.
O DeepSeek Flash é particularmente atraente para agentes com muita entrada. Seu contexto de um milhão de tokens, teto longo de saída, compreensão de imagens e modos de raciocínio alternáveis o tornam adequado para análise de documentos, fluxos de trabalho assistidos por capturas de tela, inspeção de repositórios e automação em várias etapas.
Há um detalhe importante de compatibilidade. No fluxo de trabalho nativo de ferramentas em modo de raciocínio do DeepSeek, o reasoning_content anterior pode precisar ser preservado quando mensagens subsequentes são enviadas. Confirme como a rota GPT Proto mapeia esse campo antes de mover um loop de ferramentas com estado para produção.
Escolha o DeepSeek Flash quando:
prompts em cache compõem uma grande parte do tráfego do seu agente;
você precisa de alta velocidade de geração e pesos abertos;
o mesmo agente alterna entre trabalho rotineiro sem raciocínio e raciocínio mais difícil;
entrada longa ou evidências de imagem precisam permanecer no contexto de trabalho.
Fique atento a: saída excessiva, estado de raciocínio ausente em solicitações de múltiplos turnos e argumentos de ferramentas que passam na análise JSON, mas falham na validação de negócios.
3. GPT-5.6 Luna — Melhor para Agentes Leves e de Alto Volume
O GPT-5.6 Luna é o membro sensível a custo da família GPT-5.6. Ele é destinado a tarefas frequentes como classificação, extração, sumarização, roteamento e chat voltado ao usuário. Esses trabalhos geralmente aparecem no início de um fluxo de trabalho de agente, antes que um modelo mais caro seja necessário.
O modelo aceita texto, imagens e documentos, suporta um contexto de aproximadamente um milhão de tokens e funciona com prompts no estilo OpenAI, esquemas JSON e definições de ferramentas. A Artificial Analysis relata uma pontuação no Intelligence Index de 38 e uma velocidade de saída de cerca de 116 tokens por segundo. Seu preço oficial de referência atual é $0.20 por milhão de tokens de entrada e $1.20 por milhão de tokens de saída.
O Luna não deve controlar automaticamente todas as partes de um agente complexo. Seu melhor papel geralmente é a primeira camada barata:
classificar a solicitação;
extrair ou normalizar campos obrigatórios;
tentar uma chamada de ferramenta simples;
validar o resultado;
escalar apenas se a solicitação falhar ou exceder um limite de complexidade.
Esse design impede que um modelo mais forte lide com milhares de solicitações simples, ao mesmo tempo que protege fluxos de trabalho difíceis de tentativas repetidas de baixa qualidade.
Escolha o GPT-5.6 Luna quando: volume, trabalho estruturado previsível e compatibilidade com um agente existente no estilo OpenAI forem mais importantes que o desempenho máximo de longo horizonte.
Escale em vez de tentar novamente indefinidamente quando: o modelo não conseguir se recuperar de um resultado de ferramenta com falha, perder detalhes importantes no fundo do contexto ou violar repetidamente um esquema de saída estrito.
4. MiniMax M3 — Melhor API Acessível para Agentes de Documentos com Contexto Longo
O MiniMax M3 é projetado para codificação sustentada e trabalho de agente em um contexto de aproximadamente um milhão de tokens. Na GPT Proto, use a string de modelo exata e com distinção entre maiúsculas e minúsculas MiniMax-M3. O preço listado é $0.48 por milhão de tokens de entrada e $0.96 por milhão de tokens de saída.
O modelo suporta uso de ferramentas e decomposição de tarefas em várias etapas. Sua capacidade de contexto o torna um candidato prático para agentes de pesquisa, revisão de contratos, comparação de políticas, grandes históricos de suporte e fluxos de trabalho que precisam reter resultados de muitos documentos.
A Artificial Analysis dá ao MiniMax M3 uma pontuação no Intelligence Index de 30, cerca de 107 tokens de saída por segundo e um total de tokens de saída menor que vários outros modelos desta lista. Essa concisão relativa pode importar em loops de agente, porque cada turno extra do modelo se torna contexto para a próxima solicitação.
A desvantagem é a capacidade. A pontuação composta independente do MiniMax M3 está abaixo dos outros candidatos principais, então seu contexto longo não deve ser confundido com raciocínio uniformemente mais forte. Mais contexto só ajuda quando as evidências certas são recuperadas, as instruções permanecem claras e o modelo consegue usar as informações corretamente.
Escolha o MiniMax M3 quando:
o agente precisa reter uma grande coleção de documentos ou um longo histórico de trabalho;
custo de saída e concisão de resposta importam;
o fluxo de trabalho pode validar resultados intermediários;
você quer um modelo de pesos abertos, mas prefere acesso hospedado à API.
Teste com cuidado quando: a conclusão bem-sucedida depender de raciocínio sutil entre documentos, em vez de localizar e transformar informações.
5. Gemini 3.8 Flash — Melhor API Rápida de Agente Multimodal
O Gemini 3.8 Flash é o candidato mais forte aqui quando um agente precisa processar texto, imagens, áudio, vídeo e PDFs. Ele suporta chamada de função, saída estruturada, cache e níveis ajustáveis de raciocínio. Na GPT Proto, a string de modelo é gemini-3.8-flash, com tarifas listadas de $0.90 por milhão de tokens de entrada, $0.09 por milhão de tokens de entrada em cache e $4.50 por milhão de tokens de saída.
Seu recurso de destaque é a velocidade. A Artificial Analysis mediu aproximadamente 303 tokens de saída por segundo com uma pontuação no Intelligence Index de 41. Ele foi o modelo mais rápido em sua classe de comparação no momento da medição.
Isso não o torna a opção mais barata. A Artificial Analysis também considerou o modelo verboso, enquanto sua tarifa de saída na GPT Proto é consideravelmente maior que a do GLM-5.3 Flash, DeepSeek Flash e MiniMax M3. Um agente multimodal longo que raciocina, chama ferramentas e verifica seu próprio trabalho pode consumir substancialmente mais saída do que uma solicitação curta de chat.
O Gemini 3.8 Flash é melhor quando suas capacidades substituem etapas extras de pré-processamento. Por exemplo, um agente de suporte que pode inspecionar um vídeo, ler um PDF e chamar um sistema de cliente em um único fluxo de trabalho pode ser mais simples que um pipeline que precisa de modelos separados de transcrição, visão e linguagem.
Escolha o Gemini 3.8 Flash quando:
áudio, vídeo, capturas de tela, gráficos ou PDFs forem centrais para a tarefa;
responsividade voltada ao usuário importar;
raciocínio ajustável ajudar a equilibrar solicitações rotineiras e difíceis;
uma única solicitação multimodal pode substituir várias chamadas de pré-processamento.
Fique atento a: alto uso de tokens de saída e à diferença entre geração rápida e latência total do fluxo de trabalho.
6. Grok 4.6 — Melhor Modelo Acessível de Escalonamento para Tarefas Difíceis
O Grok 4.6 não é o modelo padrão mais barato deste ranking. Ele está incluído porque um modelo ainda pode ser econômico quando evita falhas caras em trabalhos difíceis.
A rota GPT Proto grok-4.6 suporta entrada de texto e imagem, chamada de função, saída estruturada, quatro níveis de raciocínio e uma janela de contexto de 500.000 tokens. As tarifas padrão da GPT Proto estão listadas em $1.20 por milhão de tokens de entrada, $0.30 por milhão de tokens de entrada em cache e $3.60 por milhão de tokens de saída.
A Artificial Analysis relata uma pontuação no Intelligence Index de 44 — a mais alta desta lista —, mas uma velocidade de geração de cerca de 59 tokens por segundo. Sua saída foi menos verbosa que várias alternativas de custo mais baixo, mas tanto a latência quanto o preço por token o tornam inadequado para toda solicitação rotineira.
O papel prático é o escalonamento. Um modelo de custo mais baixo pode tentar a tarefa primeiro, e o agente pode rotear para o Grok 4.6 quando a validação falhar, o plano exigir muitas etapas dependentes ou o custo de um resultado incompleto exceder a despesa adicional de API.
Escolha o Grok 4.6 quando:
o agente precisar persistir em um fluxo de trabalho difícil de várias etapas;
evidências visuais e raciocínio precisarem ser combinados;
um resultado com falha criar mais custo do que uma solicitação mais cara;
o aplicativo puder selecionar menor esforço de raciocínio para etapas mais simples.
Não o use por padrão para: extração básica, reescrita, roteamento ou outro trabalho de alto volume já realizado de forma confiável por um modelo mais barato.
Por que o LLM Absolutamente Mais Barato Não Está em Primeiro Lugar
A GPT Proto lista modelos com preços por token abaixo de todas as entradas principais deste guia. Por exemplo, o Doubao Seed 1.6 Flash tem uma tarifa de entrada de destaque muito menor. Isso o torna interessante para cargas de trabalho específicas, mas não estabelece que seja a API de LLM mais barata para um agente.
Antes que um modelo entre em um ranking de agentes, ele deve demonstrar quatro coisas:
consegue selecionar a ferramenta correta entre alternativas realistas;
seus argumentos satisfazem consistentemente o esquema exigido e as regras de negócios;
consegue continuar após receber um resultado ou erro de ferramenta;
evita chamadas de ferramentas desnecessárias quando nenhuma função disponível se encaixa.
Uma tabela de preços não consegue responder a essas perguntas. Nem uma pontuação de raciocínio geral. Um modelo ultra barato pode ser excelente para classificação, marcação ou reescrita, mas continuar sendo um controlador ruim para um fluxo de trabalho que pode modificar um banco de dados ou enviar uma mensagem externa.
A regra de decisão mais segura é simples: estabeleça primeiro um limite de taxa de aceitação, depois compare o custo entre os modelos que o atingem.
Uma Estratégia Prática de Roteamento de Modelos de Baixo Custo
Muitos agentes de produção devem usar mais de um modelo. Isso não significa necessariamente vários agentes autônomos. Pode ser uma regra simples de roteamento dentro de um aplicativo.
| Tarefa do agente |
Comece com |
Escale quando |
| Classificação, extração e roteamento de solicitações |
GPT-5.6 Luna |
A saída falha na validação do esquema ou a solicitação é ambígua |
| Fluxo de trabalho geral baseado em ferramentas |
GLM-5.3 Flash |
Várias decisões dependentes ou etapas de recuperação são necessárias |
| Trabalho rápido, cacheado e com muita entrada |
DeepSeek Flash |
O modelo perde o estado ou não consegue verificar o resultado |
| Grande sessão de documentos ou conhecimento |
MiniMax M3 |
Raciocínio sutil entre documentos falha nas verificações de aceitação |
| Fluxo de trabalho de áudio, vídeo, PDF ou visual |
Gemini 3.8 Flash |
A tarefa se torna um plano difícil de longo horizonte |
| Trabalho difícil de várias etapas |
Grok 4.6 |
A aprovação humana é necessária para a próxima ação |
Um loop de agente com custo controlado pode seguir cinco regras:
Comece com o modelo menos caro que passou na avaliação da sua tarefa.
Valide cada resposta estruturada e argumento de ferramenta antes da execução.
Limite o número máximo de etapas do modelo, tokens de saída, tempo decorrido e custo total.
Escale após uma falha definida em vez de repetir o mesmo modelo indefinidamente.
Exija confirmação humana para ações irreversíveis, financeiras, que alteram permissões ou visíveis externamente.
Como os modelos pré-selecionados estão disponíveis por meio de um catálogo de modelos GPT Proto, um aplicativo pode manter uma conta e credencial de API enquanto seleciona uma string de modelo diferente para cada solicitação. A lógica de orquestração ainda pertence ao aplicativo ou framework de agente; a chave de API sozinha não cria nem coordena vários agentes.
Solicitação Mínima de Chamada de Ferramenta com GPT Proto
O exemplo abaixo fornece ao GLM-5.3 Flash uma definição de função. O modelo pode propor uma chamada, mas seu aplicativo — não o modelo — deve executar a função, validar permissões e retornar o resultado à conversa.
curl https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.3-flash",
    "messages": [
      {
        "role": "user",
        "content": "Where is order A-1042?"
      }
    ],
    "tools": [
      {
        "type": "function",
        "function": {
          "name": "get_order_status",
          "description": "Return the current status of one order.",
          "parameters": {
            "type": "object",
            "properties": {
              "order_id": {
                "type": "string",
                "description": "The order identifier."
              }
            },
            "required": ["order_id"],
            "additionalProperties": false
          }
        }
      }
    ],
    "tool_choice": "auto"
  }'
Se a resposta contiver um tool_call, o aplicativo deve:
confirmar que a função solicitada é permitida;
validar order_id em relação ao esquema JSON e às regras de negócios;
executar get_order_status no aplicativo;
enviar o resultado da ferramenta de volta com o identificador de chamada correto;
deixar o modelo produzir a resposta final voltada ao usuário.
Alterar o valor de model permite enviar a mesma solicitação de avaliação para outra rota compatível. Não mude o tráfego de produção apenas porque a solicitação teve sucesso uma vez; execuções repetidas são necessárias para expor escolhas e argumentos de ferramentas inconsistentes.
Como Testar uma API de LLM Acessível para Seu Agente
Uma pequena avaliação é mais útil que um grande benchmark genérico se refletir suas ferramentas reais. Comece com quatro categorias:
Seleção de ferramenta única: Dê ao modelo várias ferramentas semelhantes e verifique se ele escolhe a correta.
Chamadas paralelas: Peça informações que exijam duas chamadas de ferramenta independentes e verifique se nenhuma delas é omitida.
Relevância sem ferramenta: Inclua solicitações que não podem ou não devem usar nenhuma função disponível.
Recuperação: Retorne um erro de ferramenta realista e verifique se o modelo corrige a solicitação sem entrar em um loop descontrolado.
Execute cada caso pelo menos cinco vezes por modelo com o mesmo prompt, ferramentas, contexto, configuração de raciocínio, limite de saída e critérios de aceitação. Registre:
taxa de tarefas aceitas;
taxa de seleção correta de ferramentas;
taxa de argumentos válidos no esquema;
chamadas desnecessárias;
sucesso de recuperação;
etapas totais do modelo;
tokens de entrada, entrada em cache, raciocínio e saída;
tempo até a primeira resposta e tempo total do fluxo de trabalho;
custo total, incluindo falhas e repetições.
Com seis modelos, quatro tarefas e cinco repetições, a comparação mínima contém 120 execuções. Dez repetições são preferíveis quando a decisão afeta tráfego de produção significativo.
O Que os Criadores de Agentes Dizem Sobre Latência
Relatos da comunidade adicionam contexto que páginas de preços não conseguem fornecer. Em uma discussão da comunidade AI Agents, um sistema de recuperação simples supostamente respondeu em menos de um segundo, enquanto uma versão mais agêntica levou quase três segundos. Para suporte ao cliente, essa diferença foi descrita como um impeditivo.
Outros participantes discordaram da conclusão universal. Eles observaram que usuários de pesquisa e análise interna podem aceitar esperas muito mais longas quando o uso de ferramentas melhora materialmente a resposta. A lição útil não é que três segundos sejam sempre muito lentos. É que o mesmo modelo pode ser acessível para um agente e inadequado para outro porque latência, qualidade e custos de falha têm valores diferentes.
Trate comentários da comunidade como relatos de experiência, não como resultados de benchmark. Use-os para identificar casos de falha para sua própria avaliação.
Recomendação Final
Para a maioria dos agentes baseados em ferramentas sensíveis a custo, comece avaliando o GLM-5.3 Flash. Ele combina a menor tarifa de saída confirmada na lista principal com chamada de função, saída estruturada, entradas multimodais, cache e uma janela de contexto grande.
Escolha o DeepSeek Flash quando velocidade, pesos abertos, raciocínio alternável ou leituras de cache muito baratas importarem. Use o GPT-5.6 Luna para etapas leves de alto volume depois de confirmar o preço ativo na GPT Proto. Selecione o MiniMax M3 para sessões longas de documentos, o Gemini 3.8 Flash para fluxos de trabalho multimodais rápidos e o Grok 4.6 como modelo de escalonamento quando tarefas mais difíceis justificarem seu preço mais alto.
O melhor LLM acessível para um agente é o modelo menos caro que conclui sua tarefa de forma confiável — não o modelo com o menor número em uma tabela de preços.
Crie uma lista reduzida com uma API: Explore modelos de LLM na GPT Proto, teste o mesmo esquema de ferramentas entre os candidatos e roteie cada tarefa para o modelo de menor custo que atenda ao seu limite de aceitação.