Claude vs ChatGPT para Programação: Veredito Rápido
A melhor escolha depende de como você programa e de quanto da tarefa você quer que a IA conclua de forma independente.
| Tarefa de programação |
Melhor ponto de partida |
Por quê |
| Pequenas funções e scripts |
Empate |
A qualidade do prompt e o nível do modelo geralmente importam mais do que o provedor |
| Programação em par interativa |
Claude Code |
Feedback rápido e personalização profunda do terminal |
| Trabalhos longos de programação autônoma |
Codex |
Forte capacidade de delegar e revisar e fluxos de trabalho em segundo plano |
| Geração de frontend e UI |
Claude |
Uma leve vantagem qualitativa para implementação visual e iteração |
| Depuração intensiva no terminal |
ChatGPT/Codex |
GPT-5.6 Sol lidera por pouco a comparação compartilhada do Terminal-Bench |
| Refatoração de repositório inteiro |
Claude Opus 5 |
Forte desempenho em migração de código e engenharia com vários arquivos |
| Desenvolvimento em Python |
Empate |
O vencedor muda conforme a tarefa, as bibliotecas, os testes e o acesso ao repositório |
| Bases de código grandes |
Claude, leve vantagem |
Forte raciocínio sobre repositórios, embora ambas as famílias agora suportem contextos muito grandes |
| Assinatura de programação de entrada |
ChatGPT Plus |
Sua cota publicada do Codex geralmente é mais fácil de estimar e estender |
| Implantação de API |
Depende do nível do modelo |
O custo por resultado aceito importa mais do que a requisição individual mais barata |
Escolha o Claude para colaboração próxima e grandes mudanças interconectadas. Escolha o ChatGPT com Codex quando você preferir delegar e revisar. Equipes de API devem avaliar modelos individuais em vez de tratar qualquer um dos provedores como um produto fixo.
O Que Estamos Comparando: Claude, ChatGPT, Claude Code ou Codex?
A diferença entre Claude e ChatGPT começa pela superfície do produto.
Claude.ai e ChatGPT são aplicações gerais para explicar, gerar e revisar código. Claude Code e Codex são agentes de programação que podem inspecionar repositórios, editar arquivos, executar comandos e testes e revisar falhas. Isso muda a tarefa de “escrever código” para “produzir e verificar uma mudança funcional”.
APIs são outra camada: a aplicação ao redor seleciona arquivos e ferramentas, executa comandos, retorna erros e decide quando o trabalho está concluído. Um modelo que escreve uma função correta no chat pode, portanto, se comportar de forma diferente dentro de um agente. Uma comparação justa entre Claude AI e ChatGPT deve avaliar tanto o modelo quanto seu ambiente de trabalho.
Modelos Claude e GPT Atuais para Programação
Um guia atual de Claude vs ChatGPT para programação deve comparar níveis equivalentes de modelo. Anthropic recomenda Claude Opus 5 para a maioria das cargas de trabalho complexas e Fable 5.1 para trabalhos de longo horizonte especialmente exigentes. OpenAI posiciona GPT-5.6 Sol como seu carro-chefe para programação complexa, com Terra e Luna para cargas de trabalho mais leves.
| Modelo |
Melhor adequação para programação |
Janela de contexto |
Principal contrapartida |
| Claude Fable 5.1 |
Programação agêntica exigente e de longa duração |
1M tokens |
Preço mais alto da API Claude e latência mais lenta |
| Claude Opus 5 |
Programação complexa, migrações e trabalho em repositório |
1M tokens |
Mais caro que modelos de nível intermediário |
| Claude Sonnet 5 |
Programação cotidiana com menor latência |
1M tokens |
Teto mais baixo nas tarefas de engenharia mais difíceis |
| GPT-5.6 Sol |
Programação complexa, agentes e trabalho no terminal |
1.05M tokens |
Custo e latência mais altos que modelos GPT menores |
| GPT-5.6 Terra |
Tarefas cotidianas de desenvolvimento e produção |
1.05M tokens |
Menos capaz que o Sol nos trabalhos mais difíceis |
| GPT-5.6 Luna |
Scripts focados e transformações em alto volume |
1.05M tokens |
Não destinado às tarefas de engenharia mais ambíguas |
Você pode revisar a atual família de modelos Claude e a família de modelos OpenAI no GPT Proto. Para cargas de trabalho de programação difíceis, as páginas individuais mais relevantes são Claude Fable 5.1, Claude Opus 5 e GPT-5.6 Sol. Para trabalho de produção rotineiro, GPT-5.6 Terra é um ponto de comparação mais econômico.
Combine modelos por carga de trabalho e depois meça o custo total necessário para obter um resultado aceitável.
O Que os Benchmarks de Programação Realmente Mostram
As evidências atuais de benchmarks não sustentam um vencedor universal. Claude lidera algumas avaliações de repositório e geração de código, enquanto GPT-5.6 Sol lidera por pouco um benchmark de terminal compartilhado.
| Benchmark |
Resultado do Claude |
Resultado do GPT |
O que sugere |
| Terminal-Bench 2.1 |
Fable 5.1: 85.02% |
GPT-5.6 Sol: 85.77% |
GPT tem uma leve vantagem em tarefas de agente baseadas em terminal |
| SWE-bench Verified |
Opus 5: 97.00% |
GPT-5.6 Sol: 96.20% |
Ambos são altamente competitivos em problemas reais de repositório |
| Vibe Code Bench |
Fable 5.1: 90.26% |
GPT-5.6 Sol: 80.50% |
Claude mostra vantagem na geração de aplicativos ponta a ponta |
| LiveCodeBench |
Fable 5.1: 90.52% |
— |
Forte resolução de problemas de código, mas não uma comparação completa de produtos |
Esses resultados vêm das avaliações da Vals de Claude Fable 5.1, Claude Opus 5 e GPT-5.6 Sol, mas ainda exigem contexto.
Por exemplo, o Fable 5.1 foi avaliado com fallbacks do Claude no lado do servidor para recusas. A Vals relata que sua pontuação no Terminal-Bench 2.1 cai de 85.02% para 79.03% quando tarefas assistidas por fallback são contadas como falhas. As configurações de avaliação também diferem: Fable 5.1 e GPT-5.6 Sol usaram esforço máximo, enquanto Opus 5 usou esforço alto para o Terminal-Bench.
Claude tem desempenho especialmente bom em avaliações de geração de código, migração e construção de aplicativos. GPT-5.6 Sol está próximo na resolução de repositórios e ligeiramente à frente no benchmark de terminal compartilhado. Essas diferenças podem se inverter com agentes, ferramentas ou bases de código diferentes.
Claude vs ChatGPT para Geração de Código
Para tarefas pequenas e claramente especificadas de geração de código, Claude e ChatGPT são próximos o suficiente para que não haja um vencedor universal confiável. Ambos podem gerar funções, transformações de dados, manipuladores de API, casos de teste e pequenos aplicativos quando o prompt contém os requisitos relevantes.
Claude é um bom ponto de partida para planejamento de implementação e coordenação entre vários arquivos. ChatGPT é igualmente prático para scripts focados, saídas estruturadas e tarefas com uma definição precisa de concluído. Dentro do Codex, os modelos GPT podem implementar e verificar mudanças em vez de apenas sugerir código.
Ao comparar Claude ou ChatGPT para programação, forneça a ambos as mesmas versões de linguagem e dependências, arquivos editáveis, comportamento esperado, restrições de compatibilidade e testes necessários. Uma resposta mais curta ainda pode ser melhor se o código passar na primeira tentativa. Meça a saída aceita, não o quão impressionante a resposta parece.
Claude vs ChatGPT para Depuração
Claude vs ChatGPT para depuração não é uma única comparação. Depurar um stack trace colado é diferente de encontrar uma regressão espalhada por um repositório desconhecido. 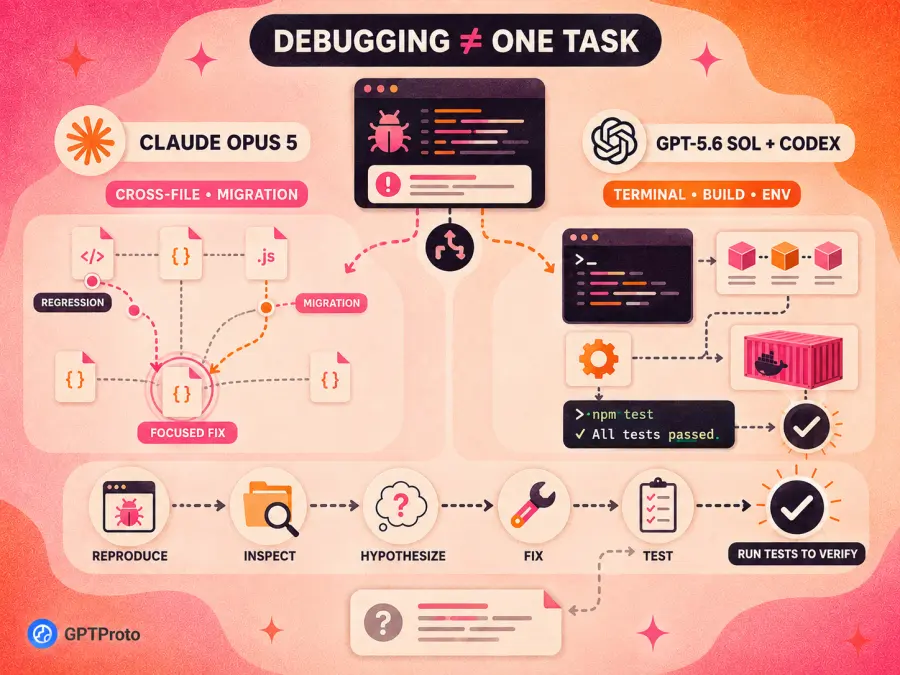
Para uma única mensagem de erro, ambos os produtos geralmente conseguem explicar causas prováveis e propor verificações. O resultado depende muito de o usuário incluir o código ao redor, a versão de runtime, as versões das dependências, os dados de entrada e o erro completo, em vez de apenas sua linha final.
Para problemas de terminal, dependências, build e ambiente, GPT-5.6 Sol com Codex é um forte ponto de partida. Sua pequena vantagem no Terminal-Bench sugere força em tarefas que exigem interação de linha de comando, embora a diferença em relação ao Fable 5.1 seja menor que um ponto percentual sob as configurações relatadas.
Para bugs de lógica entre arquivos, migrações e regressões arquiteturais, Claude Opus 5 é uma primeira escolha razoável. Seus fortes resultados em repositórios e migração de código indicam que ele pode ser eficaz quando uma correção depende de entender relacionamentos entre vários módulos.
Na prática, a qualidade da depuração depende de o agente conseguir reproduzir a falha, inspecionar os arquivos relevantes, formular uma hipótese testável, aplicar uma correção focada e executar os testes afetados. Se ele não puder acessar o ambiente, trate sua resposta como uma hipótese — não como uma correção verificada.
Claude vs ChatGPT para Programação Frontend
Claude tem uma leve vantagem qualitativa para programação frontend, especialmente quando a tarefa envolve traduzir uma direção visual em componentes, layouts, comportamento responsivo, animações ou estados interativos. Relatos iniciais sobre o Claude Opus 5 também destacaram melhorias na construção de aplicativos full-stack, incluindo trabalho visual e interativo.
Isso não significa que toda saída do Claude parecerá polida. Ambos os produtos podem recorrer a cards genéricos, gradientes e layouts com foco em desktop quando o briefing é vago. Forneça a ambos a mesma referência de design, tamanhos de viewport, framework, regras de marca, estados de interação, requisitos de acessibilidade e critérios de aceitação.
Nenhum modelo deve julgar sua própria saída visual apenas pelo código-fonte. O desempenho melhora quando o agente consegue abrir a página, inspecionar capturas de tela, compará-las com a referência e revisar o CSS. Claude pode oferecer a melhor primeira tentativa; o melhor fluxo de trabalho é o que inclui verificação visual.
Claude vs ChatGPT para Python
Não há um vencedor geral para Claude vs ChatGPT para Python porque “programação em Python” abrange tudo, desde um script de dez linhas para renomear arquivos até um grande serviço Django ou pipeline de machine learning.
| Tarefa em Python |
Melhor ponto de partida |
| Pequeno script de automação |
Claude ou ChatGPT |
| Limpeza e transformação de dados |
Um modelo equilibrado como Sonnet 5 ou GPT-5.6 Terra |
| Refatoração de grande aplicação Python |
Claude Opus 5 |
| Solução de problemas de CLI, pacote ou ambiente |
GPT-5.6 Sol com Codex |
| Explicação longa de notebook |
Claude geralmente é mais fácil de acompanhar |
| Transformação repetitiva em alto volume |
Um modelo menor e mais barato após validação |
Avalie ambos no mesmo ambiente e verifique compatibilidade de dependências, casos extremos, manipulação de arquivos, checagem de tipos, linting e resultados do pytest. Uma explicação limpa importa menos que comportamento verificado.
Claude vs ChatGPT para Grandes Bases de Código
Claude é a primeira escolha mais forte para muitas análises de repositório inteiro, migrações de código e mudanças coordenadas em vários arquivos. Claude Opus 5 tem desempenho forte em benchmarks de migração de código e repositório, enquanto Fable 5.1 é destinado a trabalho agêntico exigente e de longa duração.
No entanto, o tamanho da janela de contexto por si só não estabelece essa vantagem. Os atuais modelos carro-chefe da Claude oferecem uma janela de contexto de até 1M tokens, enquanto a família GPT-5.6 oferece aproximadamente 1.05M tokens. Ambos são grandes o suficiente para comportar código substancial, mas inserir cegamente um repositório inteiro pode desperdiçar tokens e obscurecer as dependências relevantes.
O desempenho em bases de código grandes depende de o agente conseguir mapear o repositório, localizar arquivos relevantes, seguir instruções do projeto, preservar interfaces e verificar suas mudanças. Seleção e compactação eficazes de contexto podem importar mais do que o máximo anunciado.
Escolha Claude Opus 5 quando a tarefa envolver uma migração ampla, raciocínio arquitetural ou mudanças coordenadas entre módulos interconectados. Escolha GPT-5.6 Sol com Codex quando a tarefa for bem especificada, intensiva em terminal e adequada para uma execução autônoma mais longa. Para qualquer opção, divida mudanças muito grandes em etapas verificáveis e exija testes em cada limite.
Claude Code vs Codex: O Agente Pode Importar Tanto Quanto o Modelo
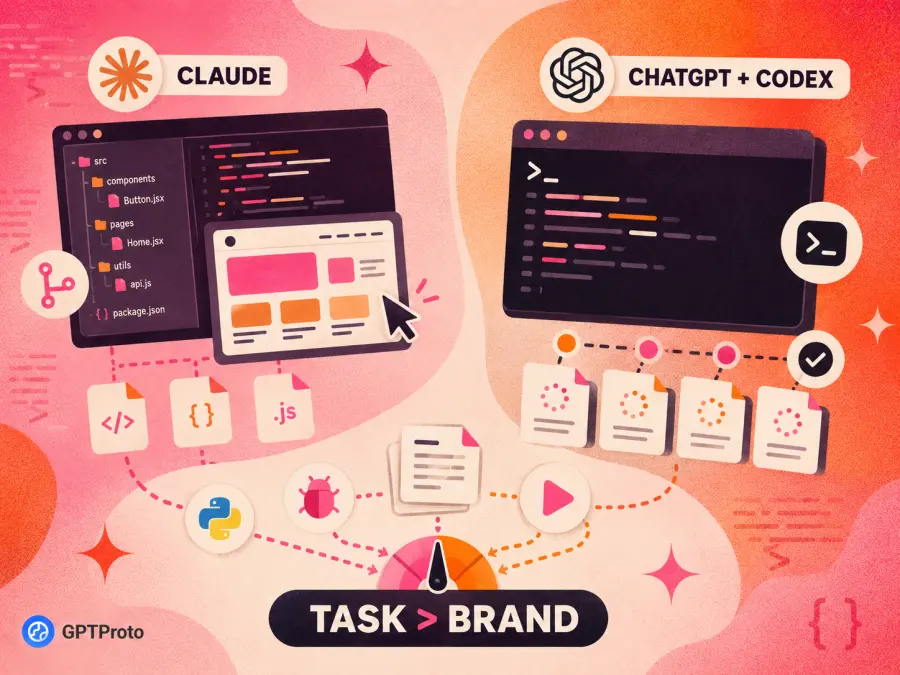
Claude Code e Codex diferem no fluxo de trabalho mesmo antes de seus modelos padrão serem considerados.
| Dimensão |
Claude Code |
Codex |
| Fluxo de trabalho típico |
Desenvolvimento interativo no terminal |
Delegar, executar e revisar |
| Instruções do repositório |
CLAUDE.md |
AGENTS.md |
| Personalização |
Hooks profundos, skills e configuração de agente |
Mais padrões gerenciados e controles de sandbox |
| Estilo de feedback |
Rápido e interativo |
Mais deliberado e autônomo |
| Boa adequação |
Desenvolvedores que permanecem muito envolvidos |
Trabalho em segundo plano, revisão e tarefas paralelas |
| Principal contrapartida |
Sessões complexas podem consumir limites rapidamente |
Algumas tarefas demoram mais para terminar |
Um teste útil de terceiros da Composio ajuda a separar o harness do modelo subjacente. O avaliador executou o mesmo modelo DeepSeek V4 Flash no Claude Code e no Codex, usando 30 tarefas idênticas multiaplicação, a mesma configuração de MCP hospedado, raciocínio máximo e um limite de 900 segundos por tarefa.
| Resultado |
Claude Code |
Codex |
| Tarefas aprovadas |
16/30 |
16/30 |
| Tempo mediano de conclusão |
122.7 segundos |
245.0 segundos |
| Chamadas de ferramentas |
358 |
448 |
| Custo total estimado |
$3.116 |
$1.294 |
| Custo por sucesso |
$0.195 |
$0.081 |
Os dois harnesses alcançaram a mesma contagem de aprovações. Claude Code terminou em cerca de metade do tempo mediano, enquanto Codex custou aproximadamente 58% menos. A comparação completa da Composio sustenta uma conclusão restrita: Claude Code ofereceu feedback mais rápido nessa configuração, enquanto Codex estendeu mais o orçamento. Isso não prova que os modelos Claude são mais inteligentes, porque o teste usou o mesmo modelo de terceiros em ambas as ferramentas.
Taxas de Uso do Claude Pro Comparadas com o ChatGPT Pro
As taxas de uso do Claude Pro comparadas com o ChatGPT Pro são frequentemente descritas com contagens fixas de mensagens enganosas. Ambos os provedores variam o consumo de acordo com o modelo selecionado, o comprimento do contexto, o esforço de raciocínio, as ferramentas e a complexidade da tarefa.
A comparação de preços atual mais próxima é:
| Preço mensal |
Plano Anthropic |
Plano OpenAI |
| $20 |
Claude Pro |
ChatGPT Plus |
| $100 |
Claude Max 5x |
ChatGPT Pro 5x |
| $200 |
Claude Max 20x |
ChatGPT Pro 20x |
uso do Claude é compartilhado entre Claude.ai, Claude Desktop e Claude Code. Seus planos combinam limites de sessão de cinco horas com limites semanais; os usuários podem esperar por uma redefinição, fazer upgrade ou ativar créditos de uso cobrados separadamente.
ChatGPT Work e Codex também compartilham o orçamento de uso aplicável. A OpenAI publica estimativas amplas para mensagens locais do Codex por janela de cinco horas. Para GPT-5.6 Sol, as faixas atuais são aproximadamente 10–100 no Plus, 50–500 no Pro 5x e 200–2,000 no Pro 20x. Tarefas na nuvem podem consumir mais que mensagens locais, e duas tarefas aparentemente semelhantes podem usar quantidades diferentes.
Essas são faixas de planejamento, não garantias. Uma longa tarefa de repositório pode consumir mais capacidade do que várias edições focadas. A $20, o ChatGPT Plus geralmente é o ponto de partida mais seguro para uso sustentado de agentes; usuários intensivos do Claude Code podem precisar da capacidade Max ou de créditos de uso. A $100 e $200, o fluxo de trabalho preferido importa mais do que o multiplicador anunciado.
API Claude vs ChatGPT para Desenvolvedores
Planos de assinatura são destinados a pessoas que trabalham dentro dos produtos Claude ou ChatGPT. Desenvolvedores que criam uma aplicação devem comparar modelos de API e cobrança baseada em uso.
| Carga de trabalho |
Opção Claude |
Opção GPT |
| Trabalho agêntico de longo horizonte mais difícil |
Claude Fable 5.1 |
GPT-5.6 Sol |
| Programação diária complexa |
Claude Opus 5 |
GPT-5.6 Sol |
| Carga de trabalho de produção equilibrada |
Claude Sonnet 5 |
GPT-5.6 Terra |
| Tarefas focadas em alto volume |
Claude Haiku 4.5 |
GPT-5.6 Luna |
Preços oficiais de tokens podem ajudar a selecionar um modelo inicial, mas não revelam o custo total de um fluxo de trabalho de programação. Um modelo mais capaz pode terminar com menos tentativas. Um modelo mais barato pode ser econômico para tarefas repetitivas, mas caro se engenheiros precisarem reparar repetidamente sua saída.
No seu próprio conjunto de tarefas, acompanhe conclusão na primeira tentativa, testes aprovados, tentativas, intervenções humanas, chamadas de ferramentas com falha, tokens totais, tempo e custo por resultado aceito. O vencedor pode mudar por etapa: Claude pode cuidar da análise de repositório, GPT da implementação intensiva em terminal, e um modelo menor das transformações repetitivas.
Você Pode Usar Modelos Claude e GPT Juntos?
Você não precisa selecionar um provedor para cada carga de trabalho de programação. Aplicações podem rotear tarefas de acordo com complexidade, latência, custo ou o tipo de trabalho de engenharia envolvido.
O GPT Proto fornece acesso às famílias de modelos Claude e GPT por meio de uma única chave de API e saldo compartilhado. Isso facilita enviar as mesmas tarefas de avaliação para ambos os provedores, comparar qualidade e custo e trocar de modelo sem manter contas de cobrança separadas de cada provedor.
Isso não significa que uma chave GPT Proto substitua uma assinatura Claude ou ChatGPT dentro de todo cliente de programação nativo. Desenvolvedores podem chamar APIs Claude e GPT compatíveis de suas próprias aplicações; a compatibilidade do cliente ainda depende de suporte a endpoint personalizado e esquema de requisição.
Claude ou ChatGPT para Programação: Decisão Final
Escolha Claude se você passa a maior parte do tempo em um fluxo de trabalho interativo no terminal, se importa com implementação frontend ou precisa de um modelo para raciocinar em um repositório grande e interconectado. Claude Opus 5 é o ponto de partida sensato para a maioria dos trabalhos de desenvolvimento complexos, enquanto Fable 5.1 é destinado às tarefas de longo horizonte mais difíceis.
Escolha ChatGPT com Codex se você preferir fluxos de trabalho de delegar e revisar, tarefas autônomas intensivas em terminal ou acesso de programação integrado a uma assinatura ChatGPT mais ampla. GPT-5.6 Sol é a opção GPT mais forte para trabalho difícil, enquanto Terra e Luna podem reduzir o custo para tarefas mais claras e repetitivas.
Para desenvolvimento de API, decida entre Claude vs ChatGPT para programação com seus próprios testes de aceitação. Execute as mesmas tarefas, ferramentas e testes em níveis comparáveis e depois meça resultados bem-sucedidos, correções, latência e custo. As evidências públicas mostram duas famílias altamente competitivas — não um campeão permanente.