DeepSeek Flash vs GLM 5.3 Flash: Veredito Rápido
| Carga de trabalho |
Melhor escolha |
Por quê |
| Assistente de codificação interativo |
DeepSeek Flash |
Latência menor e quase o dobro da velocidade de saída medida |
| Agentes de terminal e linha de comando |
GLM 5.3 Flash |
Pequena vantagem no Terminal-Bench 4.0 independente |
| Automação de fluxo de trabalho |
DeepSeek Flash |
Pontuação independente mais alta no AutomationBench-AA |
| Preço padrão de API mais baixo |
GLM 5.3 Flash |
Preços mais baixos para nova entrada e saída |
| Agentes com uso intenso de cache fora de pico |
DeepSeek Flash |
Entrada em cache cai para US$ 0,003 por milhão de tokens |
| Captura de tela para código |
Testar ambos |
Ambos aceitam imagens; ainda não há comparação independente decisiva de codificação visual |
| Saída gerada muito longa |
DeepSeek Flash |
Até 384K de saída, em comparação com 128K para GLM |
| Implantação local |
GLM 5.3 Flash |
Modelo total menor, embora ainda exigente para hospedar |
Minha recomendação padrão é direta: comece com DeepSeek Flash para um assistente de codificação responsivo. Comece com GLM 5.3 Flash para processamento em lote e trabalhos de terminal sensíveis a custo. Se o aplicativo já oferece suporte a roteamento de modelos, mantenha ambos.
Quais modelos estamos realmente comparando?
A nomenclatura é especialmente fácil de errar.
DeepSeek Flash agora significa DeepSeek V4.1 Flash
deepseek-flash é a string de modelo de API atual. DeepSeek V4.1 Flash é a versão do modelo servida por trás dela.
Os nomes mais antigos deepseek-v4-flash e deepseek-v4-flash-vision-exp referem-se a modelos aposentados. O DeepSeek ainda aceita esses aliases, mas as solicitações agora são tratadas pelo V4.1 Flash e cobradas na taxa Flash atual.
Isso é importante ao ler comparações mais antigas. Uma página publicada antes de 10 de setembro de 2026 pode descrever o V4 Flash original, com 284B de parâmetros e orientado a texto. O modelo atual tem uma espinha dorsal de 552B, entrada nativa de imagem e uma arquitetura diferente.
Para novas integrações GPT Proto, use a atual deepseek-flash página de API e registre a versão do modelo resolvida em seus logs de avaliação.
GLM 5.3 Flash não é uma configuração mais rápida para GLM 5.3
GLM 5.3 e GLM 5.3 Flash são modelos separados.
O GLM 5.3 padrão é um modelo focado em texto, construído a partir da linha GLM-5.2. O GLM 5.3 Flash parte de uma base multimodal recém-treinada. Ele combina atenção esparsa e linear, contém 320B de parâmetros totais e ativa aproximadamente 18B por token.
Ele pode receber texto, imagens, vídeos e arquivos. O GLM 5.3 padrão permanece somente texto.
Essa distinção é importante para o desenvolvimento frontend. A API do GLM 5.3 Flash pode inspecionar uma captura de tela ou gravação de interface; o endpoint GLM 5.3 de nome semelhante não pode.
DeepSeek V4.1 Flash vs GLM 5.3 Flash em Resumo
| Especificação |
DeepSeek V4.1 Flash |
GLM 5.3 Flash |
| String de modelo da API |
deepseek-flash |
glm-5.3-flash |
| Desenvolvedor |
DeepSeek |
Z.ai |
| Lançamento |
Setembro de 2026 |
Agosto de 2026 |
| Entrada |
Texto e imagens |
Texto, imagens, vídeos e arquivos |
| Saída |
Texto e chamadas de ferramentas |
Texto e chamadas de ferramentas |
| Janela de contexto |
1M tokens |
1M tokens |
| Saída máxima |
384K tokens |
128K tokens |
| Parâmetros totais |
552B |
320B |
| Parâmetros ativos |
8B durante o prefill; 16B durante a decodificação |
Aproximadamente 18B |
| Raciocínio |
Pensante ou não pensante |
Raciocínio sempre ativado |
| Chamada de ferramentas |
Sim |
Sim |
| Pesos abertos |
Licença MIT |
Licença MIT |
| Implantação local |
Suportado, com hardware substancial |
Suportado, com hardware substancial |
O tamanho do modelo por si só não prevê a velocidade da API. O GLM tem menos parâmetros totais, mas medições hospedadas atuais mostram o DeepSeek gerando saída mais rapidamente.
Os números de contexto também precisam de perspectiva. Um limite de um milhão de tokens é um teto, não uma instrução para enviar um repositório inteiro a cada chamada. Arquivos de origem irrelevantes aumentam a latência, o custo de tokens e a chance de o modelo focar na dependência errada.
Comparação de Desempenho Independente
A comparação pública mais limpa vem da Artificial Analysis porque ambos os modelos são medidos dentro do mesmo framework de avaliação.
| Métrica independente |
DeepSeek V4.1 Flash |
GLM 5.3 Flash |
| Índice de Inteligência |
40 |
42 |
| AutomationBench-AA |
69% |
60% |
| Terminal-Bench 4.0 |
27% |
33% |
| SciCode |
52% |
52% |
| Último Exame da Humanidade |
39% |
40% |
| Recuperação de contexto longo |
84% |
80% |
| Custo médio por tarefa |
US$ 0,27 |
US$ 0,25 |
| Tokens de saída por tarefa |
89K |
69K |
Fonte: comparação direta da Artificial Analysis.
A liderança de dois pontos do GLM no Índice de Inteligência é real, mas não é uma vitória completa. O GLM tem melhor desempenho na avaliação de terminal, enquanto o DeepSeek lidera por nove pontos percentuais no AutomationBench-AA e por quatro pontos no teste de recuperação de contexto longo. O SciCode está empatado.
Os números de uso de tokens são igualmente importantes. O DeepSeek gerou aproximadamente 89.000 tokens de saída por tarefa avaliada, em comparação com 69.000 para o GLM. O DeepSeek pode retornar tokens mais rapidamente, mas também pode retornar mais deles.
Em termos simples: o GLM é ligeiramente mais eficiente em todo o conjunto de benchmarks. O DeepSeek é mais rápido e vence algumas das cargas de trabalho que mais importam para sistemas automatizados.
O que os benchmarks dos fornecedores acrescentam
DeepSeek e Z.ai também publicam resultados de codificação e agentes. Eles fornecem evidências de apoio úteis, mas não devem ser apresentados como um teste controlado direto.
O DeepSeek relata 74,2 no DeepSWE v1.1 e 90,6 no Terminal-Bench 2.1 para o V4.1 Flash. A Z.ai relata 63,4 e 84,3, respectivamente, para o GLM 5.3 Flash.
A conclusão tentadora é que o DeepSeek vence ambos. Eu não faria essa afirmação.
As empresas usaram suas próprias configurações de modelo, estratégias de contexto, configurações de agente e infraestrutura de avaliação. Mesmo quando o nome do benchmark é idêntico, a configuração ao redor pode não ser. As pontuações dos fornecedores mostram o que cada equipe conseguiu alcançar com seu próprio modelo. A tabela independente acima é a comparação mais justa.
DeepSeek Flash vs GLM 5.3 Flash para Codificação
Ambos os modelos podem escrever funções, explicar código desconhecido, gerar testes, refatorar módulos e diagnosticar erros. A diferença fica mais clara quando a codificação se transforma em uma sequência mais longa de ações.
Codificação e Depuração em Nível de Repositório
A liderança independente do GLM no Terminal-Bench o torna o melhor primeiro candidato para tarefas que envolvem comandos de shell, instalação de dependências, execução de testes e alterações repetidas no repositório.
O DeepSeek tem duas vantagens diferentes.
Primeiro, ele responde mais rápido. Isso importa quando um desenvolvedor está esperando por uma explicação, aprovando cada patch ou ajustando repetidamente a mesma implementação.
Segundo, o DeepSeek suporta uma saída máxima de 384K e operação opcional não pensante. A maioria das solicitações de codificação nunca deve se aproximar desse limite de saída, mas a margem adicional pode ajudar com grandes planos de migração, auditorias de código e artefatos gerados.
Minha divisão prática é:
Use GLM 5.3 Flash para trabalho autônomo de terminal e revisões em lote de menor custo.
Use DeepSeek Flash para depuração interativa, iteração rápida de código e fluxos de trabalho de editor sensíveis à latência.
Mantenha o modelo existente quando ele já passa nos seus testes de regressão. Uma diferença de dois pontos no benchmark não vale uma migração de produção não testada.
Codificação Frontend e Captura de Tela para Código
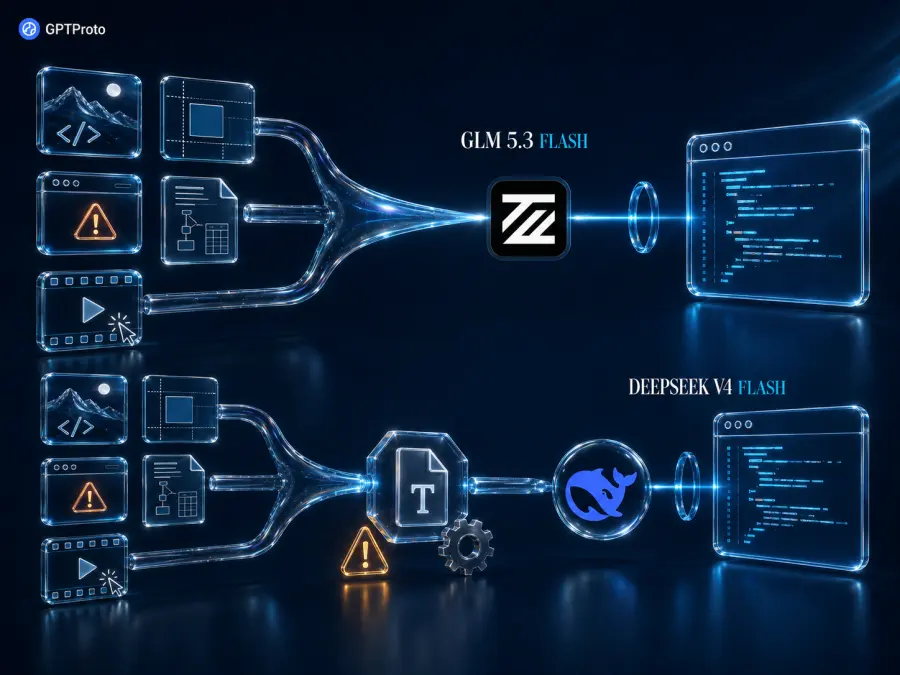
Ambos os modelos agora são multimodais. Isso invalida uma das principais conclusões em comparações mais antigas do DeepSeek V4 Flash.
O DeepSeek Flash pode inspecionar capturas de tela, diagramas e gráficos. O GLM 5.3 Flash aceita imagens, vídeos e arquivos, dando-lhe uma superfície de entrada mais ampla para fluxos de trabalho de interface.
Um agente frontend pode usar qualquer um dos modelos para:
Reconstruir uma página a partir de uma captura de tela
Comparar uma interface renderizada com uma referência de design
Diagnosticar problemas de espaçamento e alinhamento
Ler capturas de tela de erros do navegador
Revisar vários estados de interface
Combinar código-fonte com evidências visuais
Discussões da comunidade às vezes descrevem o GLM como melhor em tarefas orientadas a design e o DeepSeek como mais responsivo. Trate isso como uma pista de teste, não como um fato estabelecido. As mesmas discussões incluem desenvolvedores relatando o resultado oposto, e a latência do provedor varia consideravelmente. Uma discussão no OpenCode captura essa discordância claramente.
Ainda não há evidências controladas suficientes para declarar um vencedor em codificação visual. Uma avaliação melhor usa as mesmas três tarefas em ambos os modelos:
Recriar um componente responsivo a partir de uma captura de tela.
Reparar uma página com uma falha visível de layout móvel.
Comparar a nova renderização com a referência e listar as diferenças restantes.
Julgue o resultado renderizado, não a confiança da resposta.
Qual modelo é melhor para agentes de IA?
A palavra “agente” abrange vários sistemas diferentes. Um assistente de chat que chama uma ferramenta de busca tem pouco em comum com um processo de codificação que edita arquivos, executa testes e tenta novamente por 30 minutos.
Chamada de Ferramentas e Automação de Fluxo de Trabalho
Ambos os modelos suportam chamadas de ferramentas, saída estruturada e streaming. Ambos podem receber históricos de conversa longos e continuar após os resultados das ferramentas serem retornados.
O resultado de 69% do DeepSeek no AutomationBench-AA dá a ele o sinal independente mais forte para automação geral de fluxo de trabalho. Ele também oferece modos pensante e não pensante, então a seleção rotineira de ferramentas nem sempre precisa do mesmo orçamento de raciocínio que uma tarefa difícil de planejamento.
O GLM tem melhor desempenho no Terminal-Bench 4.0 e tem preço padrão de saída mais baixo. Essa combinação é atraente para sistemas em segundo plano que executam muitos comandos ou produzem saída substancial.
O framework de agente ainda controla o fluxo de trabalho. O modelo propõe uma chamada de ferramenta; sua aplicação valida os argumentos, executa a ferramenta, retorna o resultado e decide se outro passo é permitido. Trocar para um modelo melhor não substitui permissões, timeouts, tentativas novamente ou sandboxing.
Agentes Interativos vs Agentes em Segundo Plano
Para um agente que trabalha ao lado de uma pessoa, a latência é parte da qualidade. Esperar quase 20 segundos pelo primeiro token de resposta é diferente de esperar cerca de 11 segundos, mesmo quando as saídas finais recebem pontuações semelhantes.
O DeepSeek é a melhor escolha para:
Assistentes de codificação interativos
Depuração baseada em chat
Chamadas de ferramentas aprovadas por humanos
Agentes que expõem o progresso enquanto trabalham
Aplicações onde os usuários abandonam solicitações lentas
O GLM é a melhor escolha para:
Revisões de repositório em segundo plano
Análise de código em lote
Tarefas de terminal sensíveis a custo
Fluxos de trabalho de documentos e arquivos
Sistemas onde o custo de conclusão importa mais do que o feedback imediato
Para agentes de longa duração, teste ambos. A recuperação de erros pode apagar uma vantagem nominal de preço. Um modelo que é 20% mais barato por token, mas precisa de mais tentativas, pode custar mais por tarefa concluída.
Velocidade e Latência
As medições independentes atuais mostram a diferença mais clara nesta comparação.
| Métrica de desempenho |
DeepSeek V4.1 Flash |
GLM 5.3 Flash |
| Velocidade de saída |
214 tokens/s |
114 tokens/s |
| Tempo até o primeiro token |
1,37s |
2,45s |
| Tempo até o primeiro token de resposta |
10,70s |
19,96s |
| Tempo de resposta ponta a ponta |
13,03s |
24,34s |
| Tempo médio por tarefa avaliada |
320,60s |
529,28s |
Neste instantâneo, o DeepSeek completou a resposta medida em aproximadamente metade do tempo.
Não trate esses números como garantias permanentes do provedor. O comprimento do prompt, o esforço de raciocínio, a carga atual do servidor, o comportamento de streaming e o comprimento da saída podem alterar a latência percebida.
A direção ainda é consistente entre as medições: DeepSeek Flash é o modelo interativo mais rápido.
Preços do DeepSeek Flash vs GLM 5.3 Flash
A GPT Proto atualmente fornece o GLM 5.3 Flash com 10% abaixo de suas taxas padrão de entrada e saída. O DeepSeek Flash usa seu preço variável padrão, com uma taxa de 50% fora de pico.
| Preço por 1M de tokens |
GLM 5.3 Flash |
DeepSeek fora de pico |
DeepSeek em pico |
| Nova entrada |
US$ 0,135 |
US$ 0,15 |
US$ 0,30 |
| Entrada em cache |
US$ 0,03 |
US$ 0,003 |
US$ 0,006 |
| Saída |
US$ 0,45 |
US$ 0,60 |
US$ 1,20 |
Os preços podem mudar. Verifique as páginas dos modelos GLM 5.3 Flash e DeepSeek Flash ao vivo antes de colocar taxas fixas em seu produto.
Exemplo 1: Solicitação curta de codificação
Suponha que uma solicitação use 10.000 novos tokens de entrada e produza 3.000 tokens de saída.
| Modelo |
Custo estimado |
| GLM 5.3 Flash |
US$ 0,00270 |
| DeepSeek fora de pico |
US$ 0,00330 |
| DeepSeek em pico |
US$ 0,00660 |
O GLM é menos caro para esta solicitação comum, sem cache.
Exemplo 2: Solicitação em escala de repositório
Suponha 200.000 novos tokens de entrada e 20.000 tokens de saída.
| Modelo |
Custo estimado |
| GLM 5.3 Flash |
US$ 0,036 |
| DeepSeek fora de pico |
US$ 0,042 |
| DeepSeek em pico |
US$ 0,084 |
O GLM mantém sua vantagem de preço quando a maior parte do contexto do repositório é nova.
Exemplo 3: Carga de trabalho de agente com uso intenso de cache
Agora suponha que uma carga de trabalho mensal use:
| Modelo |
Custo estimado |
| DeepSeek fora de pico |
US$ 9,24 |
| GLM 5.3 Flash |
US$ 9,60 |
| DeepSeek em pico |
US$ 18,48 |
Esta é a exceção escondida pelos preços de manchete.
O GLM tem entrada e saída normais mais baratas. A entrada em cache fora de pico do DeepSeek é dez vezes mais barata, permitindo que ele fique abaixo do GLM quando um agente reutiliza repetidamente o mesmo prompt de sistema, contexto de repositório e definições de ferramentas.
Uma taxa de acerto de cache de 80% não é automática. Meça-a em produção antes de usar este exemplo como previsão de orçamento.
Qual modelo é mais econômico?
Para chamadas de API comuns, o GLM 5.3 Flash é mais econômico. Suas taxas de entrada e saída na GPT Proto são menores, e a avaliação independente relata um custo médio por tarefa ligeiramente menor: US$ 0,25 contra US$ 0,27.
Para cargas de trabalho com uso intenso de cache executadas fora de pico, o DeepSeek pode custar menos.
Para produtos voltados ao usuário, a velocidade complica o cálculo. Uma resposta mais rápida pode melhorar as taxas de conclusão e reduzir solicitações abandonadas. Esse valor não aparece em uma tabela de preços de tokens.
A regra de decisão honesta é:
Escolha o GLM quando a maior parte da entrada é nova e o custo de saída domina.
Escolha o DeepSeek fora de pico quando a maior parte do contexto é reutilizada.
Escolha o DeepSeek quando o tempo de resposta faz parte da experiência do produto.
Compare o custo por resultado aceito quando falhas e tentativas novamente são comuns.
Usando Ambos os Modelos com Uma Única Chave de API GPT Proto
Você não precisa de duas integrações separadas de provedor para avaliar esses modelos.
A GPT Proto fornece acesso compatível com OpenAI para ambos. A chave de API, URL base e estrutura de solicitação podem permanecer as mesmas; altere a string do modelo para rotear uma solicitação.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["GPTPROTO_API_KEY"],
    base_url="https://gptproto.com/v1",
)

# Use "glm-5.3-flash" for lower standard token prices.

# Switch to "deepseek-flash" for lower latency.
MODEL = "deepseek-flash"

response = client.chat.completions.create(
    model=MODEL,
    messages=[
        {
            "role": "system",
            "content": (
                "You are a coding assistant. Inspect the problem, "
                "propose the smallest safe change, and explain how to test it."
            ),
        },
        {
            "role": "user",
            "content": (
                "This Python function occasionally returns duplicate IDs. "
                "Find the likely race condition and propose a fix."
            ),
        },
    ],
)

print(response.choices[0].message.content)
Uma única chave não cria um sistema multiagente por si só. Sua aplicação, ferramenta de codificação ou framework de agente ainda decide qual trabalhador recebe uma tarefa, qual modelo ele usa e como os resultados são combinados.
O que a API compartilhada remove é a duplicação de integração. Você pode rotear tarefas de terminal para o GLM, solicitações interativas para o DeepSeek e manter um fallback sem gerenciar credenciais e saldos separados de provedores.
Explore ambos os modelos no catálogo de modelos GPT Proto.
Veredito Final
O DeepSeek Flash é a melhor escolha para codificação interativa e agentes sensíveis à latência. Ele produz tokens muito mais rápido, alcança a primeira resposta mais cedo, suporta saída longa e tem bom desempenho em automação de fluxo de trabalho e recuperação de contexto longo.
O GLM 5.3 Flash é a melhor escolha para custos padrão de tokens mais baixos, agentes orientados a terminal e cargas de trabalho em lote. Sua pontuação independente geral é ligeiramente maior, e ele usa menos tokens de saída por tarefa avaliada.
Para codificação frontend, não há vencedor comprovado. Ambos aceitam capturas de tela. O GLM aceita entradas adicionais de vídeo e arquivo, enquanto o DeepSeek responde mais rápido. Execute a mesma tarefa de regressão visual em ambos antes de decidir.
Para custos de agente, não pare na tabela de preços. O GLM é mais barato para tokens comuns. O DeepSeek pode se tornar mais barato quando o contexto repetido produz uma alta taxa de acerto de cache durante horários fora de pico.
Se eu estivesse construindo um novo produto de codificação, não escolheria apenas um. Eu usaria o DeepSeek Flash como padrão interativo, o GLM 5.3 Flash para tarefas selecionadas em lote e de terminal, e manteria as decisões de roteamento atrás da mesma interface de API.