O que é o GLM-5.3 Flash?
Z.ai descreve o GLM-5.3 Flash como um modelo criado para codificação, agentes multimodais e tarefas profissionais envolvendo interfaces, documentos, gráficos e outras informações visuais. Diferentemente do GLM-5.3, que é um modelo de texto aprimorado principalmente por meio de pós-treinamento adicional, o Flash usa um novo modelo base treinado em um corpus multimodal de 30 trilhões de tokens.
Estas são as principais especificações no lançamento:
| Especificação |
GLM-5.3 Flash |
| Desenvolvedor |
Z.ai / Zhipu AI |
| Data de lançamento |
26 de agosto de 2026 |
| Arquitetura |
Mixture of Experts com atenção híbrida linear e esparsa |
| Parâmetros totais |
320B |
| Parâmetros ativos |
18B por token |
| Camadas Transformer |
45 |
| Janela de contexto |
1.048.576 tokens |
| Saída máxima |
131.072 tokens |
| Entrada |
Texto, imagens, vídeo e arquivos |
| Saída |
Texto |
| Raciocínio |
Sempre ativado; esforço baixo, alto e máximo |
| ID oficial do modelo |
glm-5.3-flash |
| Licença dos pesos |
MIT |
Os pesos oficiais do modelo estão disponíveis sob a licença MIT. Isso torna o modelo de pesos abertos e comercialmente utilizável nos termos da licença. Isso não torna a inferência hospedada gratuita: computação, armazenamento e tokens de API ainda custam dinheiro.
O GLM-5.3 Flash é o modelo carro-chefe da Z.ai?
No. A Z.ai posiciona o GLM-5.3 como seu modelo carro-chefe de texto, enquanto o GLM-5.3 Flash ocupa um lugar diferente: inferência de menor custo aliada a entrada multimodal nativa.
Essa distinção importa porque os dois modelos não compartilham a mesma base. O GLM-5.3 é uma atualização de pós-treinamento construída sobre a base do GLM-5.2. O GLM-5.3 Flash foi treinado como um novo modelo base multimodal. Chamar o Flash de uma configuração mais barata do GLM-5.3 ignora a diferença arquitetural mais importante.
Qual é a relação entre o GLM-5.3 Flash e o OxAlpha?
O OxAlpha era a identidade anônima de pré-visualização do GLM-5.3 Flash.
Antes do lançamento formal, a Z.ai disponibilizou o modelo sob o nome ox-alpha por meio do OpenCode e de uma rota pública de pré-visualização. A empresa diz que usou o lançamento anônimo para coletar feedback sem colocar a marca GLM diante dos usuários. Segundo a Z.ai, o OxAlpha se tornou o modelo mais usado nesses serviços durante sua semana de pré-visualização, com o tráfego atendido em chips de IA chineses.
Isso não foi o primeiro teste anônimo de modelo da Z.ai. A abordagem separa parte do comportamento do usuário das expectativas de marca, embora acesso gratuito, posicionamento dentro de ferramentas de codificação e curiosidade ainda afetem o uso.
O mistério ainda produziu evidências úteis. Patrick Collison, CEO da Stripe, experimentou o modelo e escreveu que “É muito impressionante”. Um pequeno teste de codificação da comunidade relatou oito tarefas de repositório bem-sucedidas em dez. Essa manchete se espalhou rapidamente, mas a amostra era minúscula e a comparação usou uma tentativa do OxAlpha contra quatro tentativas dos modelos de referência.
Uma execução pública da comunidade DeepSWE posterior oferece melhor contexto: o OxAlpha resolveu 66 de 113 tarefas, ou 58,4%, usando uma configuração documentada de miniagente de engenharia de software. Ele também perdeu algumas tarefas por formatação de chamadas de ferramentas, e não pela solução de código subjacente. Ainda é uma única execução da comunidade, não um ranking universal de modelos. Mas 113 tarefas dizem mais do que dez.
A reação no Reddit seguiu o mesmo padrão. Tópicos de revelação em r/LocalLLaMA e r/singularity atraíram centenas de votos. Desenvolvedores gostaram da licença MIT e do preço dos tokens; usuários de modelos locais apontaram que um checkpoint de 320B não tem tamanho de desktop. Outros relataram planejamento inconsistente ou respostas lentas na pré-visualização. São anedotas, mas identificam os testes certos: retenção de instruções, confiabilidade de agentes, latência e uso total de tokens.
A conclusão prática é simples: OxAlpha e GLM-5.3 Flash são a mesma linha de modelo, mas os resultados do OxAlpha descrevem um período de pré-visualização anônima. Use esses relatos como evidência inicial de campo e depois valide o modelo lançado em seu próprio repositório e fluxo de trabalho.
O que mudou no GLM-5.3 Flash?
A eficiência do modelo vem de mais do que ativar menos especialistas.
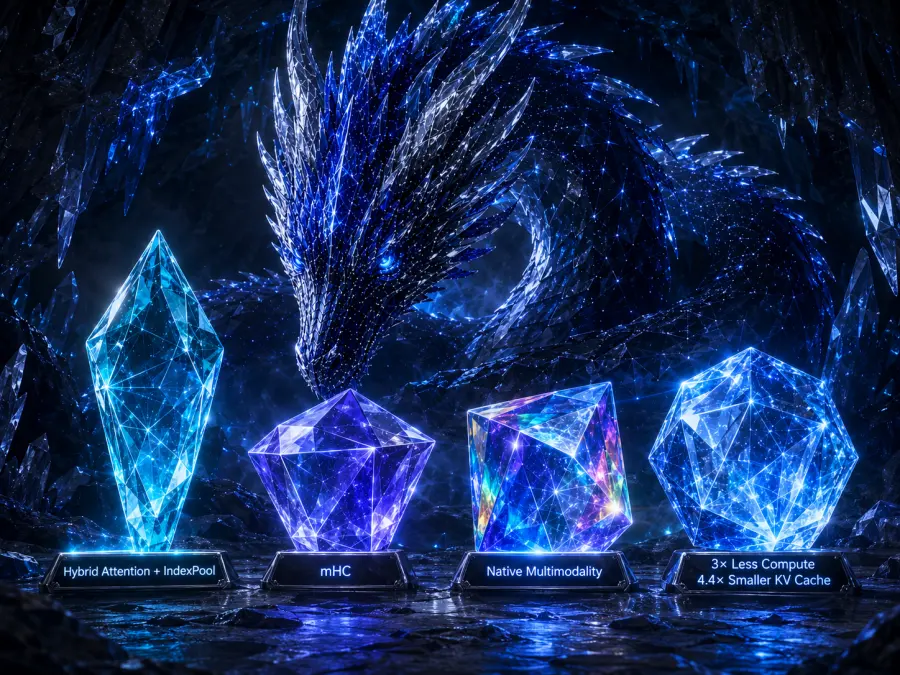
Primeiro, o GLM-5.3 Flash combina atenção linear para dependências locais com atenção esparsa para recuperar informações de partes distantes do contexto. A Z.ai também introduziu o IndexPool, que agrupa quatro vetores-chave do indexador em um. Isso reduz o custo de memória e latência de encontrar tokens relevantes em um prompt de um milhão de tokens.
Segundo, o modelo usa Manifold-Constrained Hyper-Connections, ou mHC. Em termos simples, o mHC muda como as informações são combinadas entre camadas, para que a Z.ai possa escalar o modelo mantendo o treinamento e a inferência estáveis.
Terceiro, a multimodalidade faz parte do pré-treinamento, em vez de ser um adaptador de imagem adicionado depois que um modelo de texto foi concluído. Um agente de codificação pode inspecionar uma página renderizada, notar um layout quebrado, editar o código e verificar a próxima renderização. O mesmo ciclo se aplica ao uso de navegador, operação de desktop, gráficos e documentos.
A Z.ai calcula que o Flash usa cerca de três vezes menos computação de atenção que o GLM-5.3 e um cache KV médio 4,4 vezes menor. Esses são cálculos do fornecedor, não medições independentes de serviço. Eles explicam como um modelo de 320B no total pode ser oferecido a um preço por token muito menor.
Uma frase resume o trade-off: mais barato de invocar, não necessariamente mais rápido de acompanhar.
O que o GLM-5.3 Flash pode fazer?
O GLM-5.3 Flash foi projetado para tarefas em que raciocínio de linguagem e feedback visual se encontram.
Para agentes de codificação, isso inclui análise de repositório, depuração, trabalho no terminal, chamada de funções e alterações de longa duração que exigem várias etapas de ferramentas. A visão nativa acrescenta replicação de frontend a partir de capturas de tela, inspeção de UI renderizada, operação de navegador, desenvolvimento de jogos e verificações visuais de cenas 3D. Um modelo somente texto pode escrever CSS; um modelo multimodal também pode olhar o resultado.
Para trabalho de escritório, ele pode interpretar PDFs, planilhas, apresentações, dashboards, diagramas e capturas de tela. Pode localizar um gráfico, compará-lo com o texto ao redor, retornar JSON estruturado e passar o resultado para outra ferramenta. A janela de um milhão de tokens oferece espaço para grandes repositórios ou relatórios longos, embora usá-la aumente o custo de entrada e a latência.
O conjunto de recursos da API inclui chamada de funções, saída estruturada, streaming, cache de contexto, uso de navegador e uso de computador. O raciocínio permanece ativado, com níveis de esforço baixo, alto e máximo. Esforço mais baixo é o melhor ponto de partida para extração rotineira; esforço máximo é destinado a tarefas difíceis de codificação e de agente. Mais raciocínio pode melhorar uma resposta difícil, mas também adiciona tokens e tempo.
O GLM-5.3 Flash oferece suporte a entrada de vídeo?
Sim. O GLM-5.3 Flash oferece suporte a entrada de vídeo nativa e retorna texto.
A entrada de vídeo importa quando a informação é temporal, e não contida em um único quadro. O modelo pode analisar uma gravação de tela, identificar a sequência que causou um erro de UI, resumir uma demonstração, localizar eventos em uma reunião ou transformar um tutorial em instruções ordenadas. Ele também pode combinar vídeo com código — por exemplo, revisar uma interação quebrada e sugerir alterações no frontend.
Isso é compreensão de vídeo, não geração de vídeo. O GLM-5.3 Flash pode descrever, raciocinar sobre e agir com base em informações de vídeo, mas não gera um novo arquivo de vídeo.
Preços do GLM-5.3 Flash
A Z.ai lançou o GLM-5.3 Flash com uma promoção temporária de 50%. A promoção termina às 24:00 de 9 de setembro de 2026, UTC+8. O preço de lançamento da GPT Proto é calculado com base na tarifa padrão de tabela da Z.ai, não na promoção temporária.
| Por 1M tokens |
Z.ai padrão |
Promoção de lançamento da Z.ai |
Preço de lançamento da GPT Proto |
| Nova entrada |
$0.15 |
$0.075 |
$0.015 |
| Entrada em cache |
$0.03 |
$0.015 |
$0.003 |
| Saída |
$0.50 |
$0.25 |
$0.05 |
Planeje com base na tarifa padrão, não na tarifa de lançamento. Promoções expiram; cargas de trabalho de produção normalmente não.
O preço padrão é muito menor que a tarifa de $1.40 de entrada e $4.40 de saída do GLM-5.3. Mas o preço dos tokens é apenas parte da conta. O Artificial Analysis considerou o modelo excepcionalmente verboso em sua avaliação do Intelligence Index. Um modelo que emite mais tokens de raciocínio e resposta pode apagar parte de sua aparente vantagem por token. O cache de contexto ajuda quando um agente de codificação envia repetidamente o mesmo contexto de repositório, mas novos prompts e saída gerada ainda contam.
A $0.015 por milhão de novos tokens de entrada e $0.05 por milhão de tokens de saída, o preço de lançamento da GPT Proto é 10% da tarifa padrão da Z.ai — uma redução de 90%. Você pode conferir a disponibilidade mais recente e os detalhes de cobrança na página do modelo GLM-5.3 Flash API.
Quão bom é o GLM-5.3 Flash?
Há duas respostas: os benchmarks de lançamento da Z.ai e as primeiras medições independentes. Elas não devem ser misturadas em uma única afirmação.
Resultados de benchmark publicados pela Z.ai
A Z.ai relata os seguintes resultados. A comparação é útil para identificar os pontos fortes pretendidos, mas continua sendo uma avaliação conduzida pelo fornecedor.
| Benchmark |
GLM-5.3 Flash |
GLM-5.2 |
DeepSeek V4 Vision Exp |
Claude Opus 4.8 |
| Terminal-Bench 2.1 |
84.3 |
81.0 |
83.9 |
85.0 |
| DeepSWE v1.1 |
63.4 |
46.2 |
59.3 |
58.0 |
| Toolathlon Verified |
78.4 |
59.9 |
75.9 |
76.2 |
| AutomationBench |
48.8 |
26.2 |
38.8 |
41.0 |
| Chartography com ferramentas |
78.0 |
— |
64.3 |
75.0 |
Esses resultados sustentam uma conclusão mais restrita do que “o Flash supera o Opus”. O modelo da Z.ai parece competitivo em codificação, uso de ferramentas e tarefas de agente visual, mas o Opus 4.8 ainda lidera algumas linhas, incluindo Terminal-Bench e NL2Repo. Mais importante, esta tabela compara o Opus 4.8 — não o Claude Opus 5.
O que os testes independentes mostram
Em 27 de agosto, o Artificial Analysis atribui ao GLM-5.3 Flash uma pontuação de 57 no Intelligence Index. Ele mediu a saída em cerca de 50 tokens por segundo e estimou um custo de aproximadamente $0.09 por tarefa do Intelligence Index na tabela de preços. A avaliação também classificou o modelo como mais lento que a média e muito verboso dentro de sua classe de comparação.
Esse é um bom resultado para o preço. Não é evidência de que o Flash seja o modelo mais rápido ou o mais forte no geral.
GLM-5.3 Flash vs GLM-5.3, DeepSeek V4 Pro e Claude Opus 5
A tabela abaixo usa o mesmo avaliador independente e variantes de raciocínio de esforço máximo quando disponíveis. Estes são snapshots de serviço em mudança, então trate os números de velocidade como medições, não como especificações permanentes.
| Modelo |
Intelligence Index |
Velocidade de saída |
Custo por tarefa |
Entrada / saída de tabela |
| GLM-5.3 Flash |
57 |
~50 tok/s |
$0.09 |
$0.15 / $0.50 |
| GLM-5.3 |
60 |
~87 tok/s |
$0.68 |
$1.40 / $4.40 |
| DeepSeek V4 Pro 0813 |
53 |
~67 tok/s |
$0.27 |
$1.32 / $3.96 |
| Claude Opus 5 |
63 |
~55 tok/s |
$2.34 |
$5.00 / $25.00 |
Escolha o GLM-5.3 Flash quando precisar de entrada de imagem ou vídeo, pesos abertos ou o menor custo por token. Escolha o GLM-5.3 quando o trabalho for somente texto e os três pontos extras no Intelligence Index, pontuações de codificação mais altas e saída mais rápida justificarem o preço.
Este não é um caminho de upgrade normal, no qual o sufixo mais novo substitui o modelo mais antigo. Os dois ramos otimizam para restrições diferentes. Veja o GLM-5.3 na GPT Proto se sua carga de trabalho atual for codificação somente texto ou trabalho de agente de longo horizonte.
GLM-5.3 Flash vs DeepSeek V4 Pro
O GLM-5.3 Flash pontuou quatro pontos a mais no snapshot independente e custa menos na tabela de preços. Ele também aceita entradas visuais, enquanto a rota testada do DeepSeek V4 Pro é somente texto. O DeepSeek V4 Pro gerou saída mais rápido e pode continuar sendo a melhor opção para pipelines estabelecidos de texto e codificação, nos quais a multimodalidade não agrega valor.
Não escolha apenas com base em uma pontuação composta. Execute a mesma tarefa de repositório com testes de aceitação fixos e um registro de tentativas e tokens. Você pode avaliar o DeepSeek V4 Pro na GPT Proto antes de testar os dois fluxos de trabalho.
GLM-5.3 Flash vs DeepSeek V4 Flash Vision Exp
Estes são concorrentes mais próximos em formato de produto: ambos miram tarefas de codificação e visuais de menor custo. Na avaliação da própria Z.ai, o GLM-5.3 Flash pontuou 63.4 contra 59.3 no DeepSWE e 78.0 contra 64.3 no Chartography com ferramentas. Trate esses números como alegações da Z.ai até que os modelos recebam uma comparação independente e controlada de agentes visuais.
O GLM-5.3 Flash tem pesos licenciados sob MIT, entrada nativa de vídeo e arquivos, e uma janela de contexto de um milhão de tokens. O DeepSeek V4 Flash Vision Exp continua sendo um ramo experimental de visão e pode fazer mais sentido para equipes que já usam sua família de modelos ao redor. Veja o DeepSeek V4 Flash Vision Exp na GPT Proto.
GLM-5.3 Flash vs Claude Opus 5
O Claude Opus 5 continua mais forte no composto independente: 63 contra 57. Seu preço de tabela upstream também é muito maior, a $5 por milhão de tokens de entrada e $25 por milhão de tokens de saída. O GLM-5.3 Flash é a escolha pelo custo; o Opus 5 é a escolha que prioriza qualidade quando uma tarefa malsucedida custa mais que a conta de tokens.
A correção principal é metodológica. O gráfico de lançamento da Z.ai compara o Flash com o Opus 4.8, então não pode sustentar a alegação de que o GLM-5.3 Flash supera o Opus 5. Para a opção atual do Opus, veja o Claude Opus 5 na GPT Proto.
Você pode executar o GLM-5.3 Flash localmente?
Sim, mas “18B ativos” não significa que o modelo caiba como um modelo denso de 18B.
Pense nos 320B de parâmetros como um armazém e nos 18B de parâmetros ativos como as prateleiras consultadas para um pedido. O roteador reduz a computação por token, mas o armazém ainda precisa de um lugar para ficar.
O checkpoint FP8 tem aproximadamente 328GB em armazenamento decimal, ou cerca de 306GiB. O guia de implantação do KTransformers específico do modelo recomenda pelo menos 350GB de memória de sistema disponível antes de contabilizar tudo o mais que estiver rodando na máquina. A Z.ai também lista SGLang, vLLM e TokenSpeed como opções de inferência compatíveis.
Portanto, a descrição honesta não é “um pequeno modelo local”. É um modelo grande e eficiente em computação que pode ser auto-hospedado por equipes com capacidade séria de memória. Para a maioria dos desenvolvedores individuais e equipes pequenas, o acesso à API hospedada será mais simples do que armazenar e servir o checkpoint completo.
Barato de invocar. Caro de possuir.
Como acessar o GLM-5.3 Flash
No lançamento, desenvolvedores podem usar o modelo hospedado da Z.ai com o ID glm-5.3-flash, acessá-lo por meio de planos de codificação elegíveis ou baixar os pesos licenciados sob MIT para serviço local.
A API do GLM-5.3 Flash na GPT Proto está sendo lançada agora com as entradas nativas de texto, imagem, vídeo e arquivos do modelo. Ela usa o saldo compartilhado da GPT Proto e tem preço de 10% da tarifa padrão de tabela da Z.ai.
Para alternativas, use o GLM-5.3 para codificação com foco em texto, o DeepSeek V4 Pro para fluxos de trabalho de texto e agente, ou o Claude Opus 5 quando a capacidade importar mais que o preço dos tokens.
Vale a pena usar o GLM-5.3 Flash?
Sim — se sua carga de trabalho realmente se beneficia da combinação de entrada multimodal, contexto longo e preços baixos por token.
O GLM-5.3 Flash é um forte candidato para agentes de codificação visual, documentos grandes, compreensão de vídeo e tarefas de agente em lote em que o GLM-5.3 ou o Opus 5 custariam demais. Os pesos MIT também oferecem um caminho de auto-hospedagem.
Ele é menos adequado quando você precisa da resposta visível mais rápida, espera um checkpoint local pequeno ou quer a maior pontuação de raciocínio disponível independentemente do preço. O GLM-5.3 é mais rápido na medição independente atual. O Opus 5 pontua mais alto. Ambos custam mais.
Minha leitura é que a Z.ai escolheu o compromisso certo. O GLM-5.3 Flash não substitui o carro-chefe. Ele torna econômica uma classe diferente de carga de trabalho: agentes multimodais que precisam olhar, raciocinar, chamar ferramentas e continuar sem cobrar tarifas de carro-chefe por cada token.