Várias páginas publicadas imediatamente após o lançamento do DeepSeek V4 Flash Vision Exp já estão citando o preço errado. É assim que este lançamento está avançando rápido.
O DeepSeek V4 Flash Vision Exp é uma versão experimental do V4 Flash que pode aceitar imagens junto com texto. Ele pode inspecionar capturas de tela, ler texto em imagens, analisar gráficos e passar o resultado para ferramentas. A DeepSeek o lançou em 21 de agosto de 2026 sob o ID de modelo deepseek-v4-flash-vision-exp. 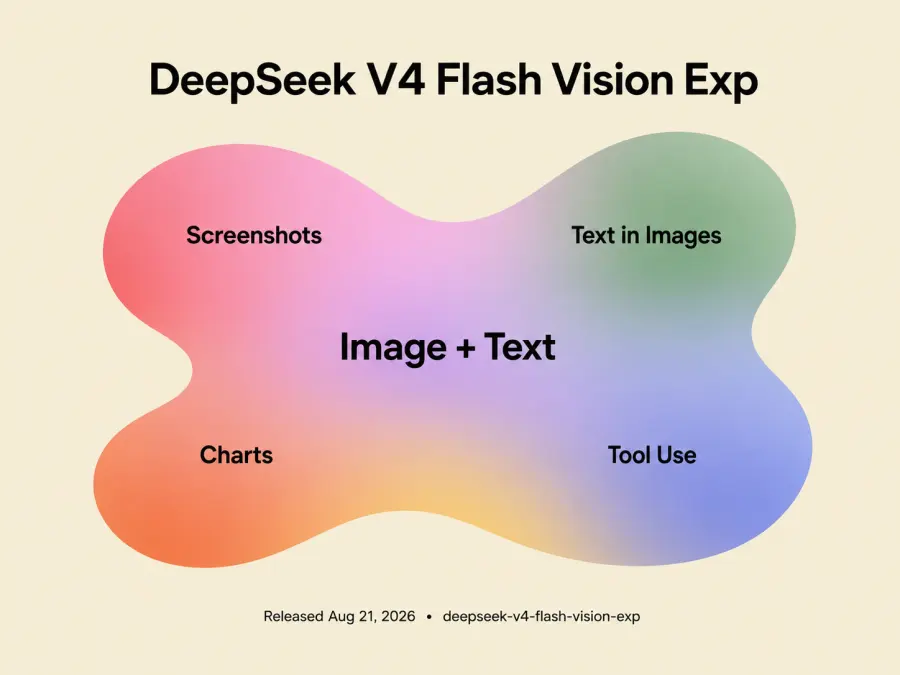
A distinção importante é o que ele não é. Este não é um novo gerador de imagens, e não é uma atualização geral para toda carga de trabalho do V4 Flash. A DeepSeek o posiciona como uma ramificação experimental com suporte a visão e com capacidades de texto aproximadamente iguais às do V4 Flash. Se sua aplicação nunca envia uma imagem, o modelo de texto padrão continua sendo a escolha mais simples.
O DeepSeek V4 Flash Vision Exp agora está disponível por meio do GPTProto. Desenvolvedores podem enviar entrada de texto e imagem pela rota GPTProto do modelo usando a mesma conta, chave de API e saldo compartilhado usados para outros modelos compatíveis. A página do modelo ao vivo atualmente lista o preço padrão de $0.44 por milhão de tokens de entrada e $1.32 por milhão de tokens de saída, com taxas fora de pico baseadas em horário também disponíveis.
O modelo continua experimental. Antes de direcionar tráfego de produção para ele, teste o formato exato de imagem, os limites de requisição, a latência e o comportamento de fallback mostrados no Início Rápido ao vivo da GPTProto.
O que mudou em relação ao DeepSeek V4 Flash?
A atualização é limitada, mas útil: o V4 Flash agora pode receber contexto visual. Uma requisição pode conter texto mais uma ou mais imagens JPEG, PNG, GIF ou WebP. A DeepSeek expõe essa capacidade por meio de suas APIs Chat Completions e Responses compatíveis com OpenAI, bem como de sua API Messages compatível com Anthropic.
As imagens podem chegar de três maneiras:
Uma URL de dados Base64 embutida na requisição.
Uma URL HTTP ou HTTPS publicamente acessível.
Um file_id criado por meio da API de Arquivos.
A terceira opção importa quando um agente precisa inspecionar a mesma captura de tela mais de uma vez. Faça o upload uma vez, reutilize o identificador e evite enviar o arquivo inteiro a cada requisição. A DeepSeek diz que os uploads na Files API são gratuitos, mas a inferência não é: a imagem ainda é convertida em tokens de entrada e cobrada junto com o texto que a acompanha.
Aqui está a divisão prática entre as três rotas V4 atuais:
| Modelo |
Entrada de imagem |
Contexto oficial / saída máxima |
Entrada/saída de pico com cache miss |
Adequação prática |
| DeepSeek V4 Flash Vision Exp |
Sim |
1M / 384K |
$0.44 / $1.32 por 1M de tokens |
Experimentos com capturas de tela, gráficos, imagens de documentos e agentes de GUI |
| DeepSeek V4 Flash |
Não |
1M / 384K |
$0.44 / $1.32 por 1M de tokens |
Texto em alto volume, extração, chat e subtarefas rotineiras de agentes |
| DeepSeek V4 Pro |
Não |
1M / 384K |
$1.32 / $3.96 por 1M de tokens |
Codificação mais difícil, raciocínio e tarefas de agente mais longas |
Essas são as taxas de pico oficiais atuais, não uma promessa de que os preços permanecerão inalterados. A DeepSeek reserva-se explicitamente o direito de ajustá-las.
Minha leitura prática é simples. Escolha o Vision Exp porque você precisa de entrada de imagem, não porque Vision soa como um nível superior. Escolha o V4 Flash quando o trabalho for somente texto e sensível a custo. Mova tarefas de texto difíceis para o V4 Pro quando a qualidade de raciocínio adicional valer aproximadamente três vezes o preço oficial dos tokens.
Recursos do DeepSeek V4 Flash Vision Exp — e seus limites reais
A lista curta de recursos parece generosa: texto e imagens misturados, chamadas de ferramentas, saída JSON, modo de pensamento selecionável, três formatos de API e o mesmo contexto de 1M de tokens mostrado para os outros modelos V4. Os limites são o que determina se esses recursos sobrevivem ao contato com uma carga de trabalho de produção.
| Método de entrada |
Limite |
Melhor uso |
Base64 ou inline file_data |
Corpo inteiro da requisição: 48 MiB |
Imagens locais e requisições de uso único |
| URL externa |
URL: 8,192 caracteres; imagem: 32 MiB; download: 60 segundos |
Imagens públicas que já estão hospedadas |
Files API file_id |
Imagem: 64 MiB |
Imagens reutilizadas ou requisições que excederiam o limite do corpo inline |
A colocação da imagem depende do formato da API. Em requisições Chat Completions e Messages compatíveis com Anthropic, o conteúdo de imagem pertence a uma mensagem de usuário. A API Responses também pode receber imagens em mensagens de desenvolvedor e em saídas de chamadas de ferramentas compatíveis. Imagens colocadas em mensagens de sistema ou assistente retornam um erro 400. Enviar uma imagem para as rotas V4 Flash ou V4 Pro somente texto também retorna um erro, porque esses modelos não aceitam entrada nativa de imagem.
O Vision Exp oferece suporte a configurações de detalhe low, high, original e auto para entradas image_url, mas o modelo ainda aplica seu processo de redimensionamento documentado. Imagens abaixo de aproximadamente 384×384 na escala total de pixels são ampliadas. Imagens maiores são reduzidas preservando a proporção até que sua contagem total de pixels seja aproximadamente equivalente a 800×800.
Esse redimensionamento produz um teto de 384 tokens de entrada por imagem. Isso torna o custo previsível. O trade-off é a resolução: rótulos minúsculos, planilhas densas, anotações finas em diagramas e textos pequenos de UI podem não sobreviver à redução. Uma fonte de 5,000×5,000 não compra mais tokens de imagem do que uma fonte de 2,000×2,000.
Mais um limite é fácil de passar despercebido. O Vision Exp não oferece suporte a FIM completion, enquanto o V4 Flash e o V4 Pro o suportam no modo não pensante. Desenvolvedores que criam ferramentas de preenchimento de código inline não devem tratar a rota de visão como um substituto direto.
Preços do DeepSeek V4 Flash Vision Exp
Verifiquei a tabela de preços ao vivo da DeepSeek em 24 de agosto de 2026. As tarifas são:
| Tipo de token |
Fora de pico |
Pico |
| Entrada com cache hit |
$0.007 por 1M |
$0.014 por 1M |
| Entrada com cache miss |
$0.22 por 1M |
$0.44 por 1M |
| Saída |
$0.66 por 1M |
$1.32 por 1M |
Os horários de pico vão das 01:00–04:00 e 06:00–10:00 UTC, de segunda a sexta-feira. Todos os outros períodos, incluindo fins de semana, usam a tarifa fora de pico com metade do preço.
Alguns explicadores indexados recentemente ainda citam $0.14 por milhão de tokens de entrada e $0.28 por milhão de tokens de saída. Não monte um orçamento com base nesses números. Eles não correspondem mais à tabela oficial.
Com o teto documentado de 384 tokens por imagem, o cálculo de entrada somente de imagem é:
Fora de pico: 384 × $0.22 / 1,000,000 = $0.00008448 por imagem
Pico:     384 × $0.44 / 1,000,000 = $0.00016896 por imagem
Isso dá aproximadamente $0.08448–$0.16896 para 1,000 imagens antes de texto e saída. É barato, mas a manchete pode ser enganosa. Uma resposta de 1,000 tokens custa $0.00132 na tarifa de pico de saída — quase oito vezes a cobrança máxima de entrada por uma imagem. Respostas concisas e max_tokens controlado podem importar mais do que economizar alguns tokens na imagem.
O número 384 também é um máximo, não uma cobrança fixa por imagem. O uso real de tokens depende das dimensões após a etapa de redimensionamento da DeepSeek.
DeepSeek V4 Flash Vision Exp vs Opus 4.8
A DeepSeek diz que o Vision Exp traz desempenho de agente multimodal próximo ao Opus 4.8. Seu próprio gráfico de benchmark sustenta uma afirmação mais restrita: os modelos alternam vitórias em quatro avaliações selecionadas de agentes multimodais.
| Benchmark de agente multimodal |
Vision Exp |
Opus 4.8 |
Maior pontuação |
| ApexBench, Pass@1 |
36.5 |
39.4 |
Opus 4.8 |
| Agents' Last Exam |
27.3 |
25.7 |
Vision Exp |
| Chartography |
64.3 |
65.0 |
Opus 4.8 |
| ZeroBench, Pass@5 |
35.0 |
34.0 |
Vision Exp |
Duas vitórias para cada. Isso é competitivo, mas não é prova de que o Vision Exp iguala o Opus 4.8 em precisão de OCR, taxas de alucinação visual, leitura de textos pequenos, navegação de UI ou agentes de longa duração.
Os resultados de agentes de texto adicionam mais contexto. O gráfico da DeepSeek contém sete avaliações baseadas em texto. O Vision Exp lidera sobre o Opus 4.8 apenas no DeepSWE, 59.3 a 58.0. Ele fica atrás em Terminal Bench 2.1, NL2Repo, Cybergym, Toolathlon-Verified, DSBench-Hard e AutomationBench.
Esses números também vêm da DeepSeek, não de um avaliador independente. A empresa executou seus modelos no Minimal Mode com comprimento máximo de saída, top_p=0.95 e temperature=1.0. Em 24 de agosto, não consegui encontrar o Vision Exp nos resultados do Artificial Analysis ou do LMArena. Minha conclusão, portanto, é provisória: os dados de lançamento justificam testar o modelo, não declarar um vencedor geral.
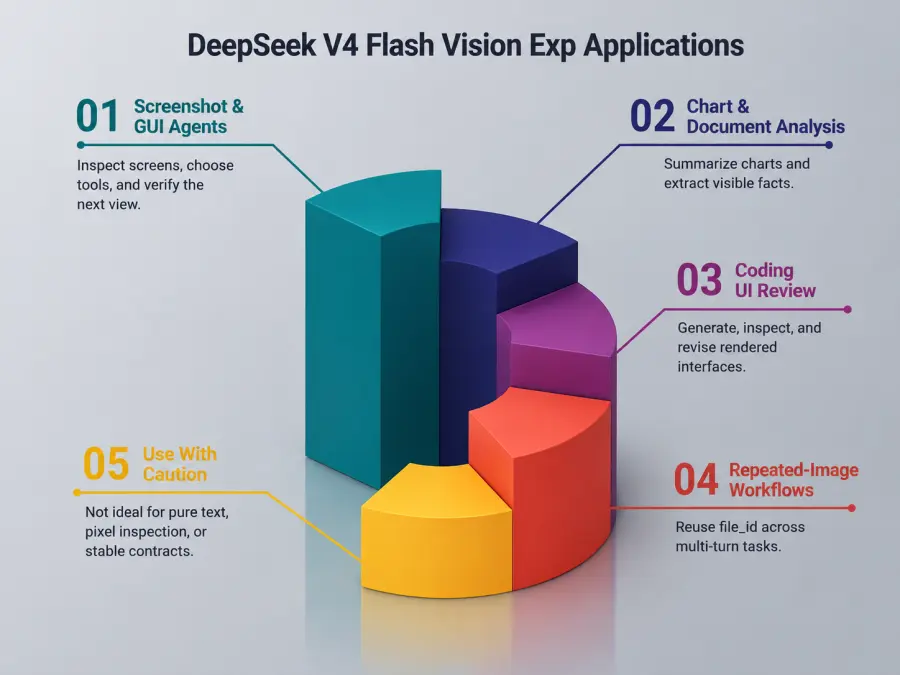
Aplicações do DeepSeek V4 Flash Vision Exp
Agentes de captura de tela e GUI
Um agente de navegador ou desktop pode inspecionar uma tela, decidir qual ferramenta chamar e revisar a próxima captura de tela. O baixo teto de tokens de imagem mantém observações repetidas baratas. O custo é a precisão visual, então teste rótulos pequenos, texto de erro e menus densos antes de confiar em cliques autônomos.
Análise de gráficos e imagens de documentos
O modelo pode resumir gráficos, extrair fatos visíveis e combiná-los com instruções de texto. Ele deve funcionar melhor em páginas limpas e legíveis. Letras miúdas digitalizadas e planilhas grandes são mais arriscadas porque as imagens são redimensionadas antes da inferência.
Agentes de codificação que revisam interfaces
Um agente de codificação pode gerar uma página, inspecionar o resultado renderizado e então revisar o código. Isso fecha uma lacuna deixada pelo V4 Flash somente texto. Ainda assim, uma captura de tela não é uma árvore DOM: o modelo pode notar um botão fora de lugar sem identificar a regra CSS exata que causou isso.
Fluxos de trabalho com imagens repetidas
A Files API é adequada para catálogos de produtos, revisão de documentos ou qualquer fluxo que se refira a uma imagem ao longo de vários turnos. Reutilizar um file_id economiza largura de banda de requisição. Isso não remove as cobranças de tokens de imagem quando o modelo processa esse arquivo novamente.
Quando não usá-lo
O Vision Exp é um padrão fraco para texto puro, inspeção em nível de pixel ou sistemas que exigem um contrato de modelo estável. O sufixo -exp importa. Mantenha testes de regressão, registre o comportamento do modelo e mantenha uma rota de fallback se um fluxo visual afetar dinheiro, permissões ou dados de clientes.
Como usar o DeepSeek V4 Flash Vision Exp via API
O DeepSeek V4 Flash Vision Exp está disponível por meio do endpoint compatível com OpenAI da GPT Proto. O exemplo em Python a seguir envia uma imagem pública de gráfico junto com uma instrução de texto:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["GPTPROTO_API_KEY"],
    base_url="https://gptproto.com/v1",
)

response = client.chat.completions.create(
    model="deepseek-v4-flash-vision-exp",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "text",
                    "text": "Leia este gráfico e liste as três descobertas mais importantes."
                },
                {
                    "type": "image_url",
                    "image_url": {
                        "url": "https://api-docs.deepseek.com/img/v4_260821_benchmark_en.png"
                    }
                }
            ]
        }
    ],
)

print(response.choices[0].message.content)
O exemplo usa a imagem pública de benchmark da DeepSeek, então pode ser executado sem preparar uma imagem primeiro. Para um arquivo local, codifique-o como uma URL de dados Base64; para um arquivo grande ou usado repetidamente, faça o upload primeiro e envie seu file_id. O guia da API de Visão da DeepSeek documenta todos os três formatos.
Usando o Vision Exp através da GPT Proto
A GPT Proto agora expõe o DeepSeek V4 Flash Vision Exp como uma rota multimodal com entrada de texto e imagem e saída de texto. A tarifa padrão atual é $0.44 por milhão de tokens de entrada e $1.32 por milhão de tokens de saída. Tokens de imagem são adicionados à conta de entrada de texto, com a DeepSeek documentando um teto de 384 tokens de entrada por imagem.
A vantagem prática é a consolidação de conta: a mesma chave GPT Proto e o saldo compartilhado também podem chamar DeepSeek V4 Flash e DeepSeek V4 Pro somente texto. Isso facilita direcionar tarefas visuais para o Vision Exp enquanto mantém o trabalho de texto rotineiro no modelo Flash estável.
Vale a pena usar o DeepSeek V4 Flash Vision Exp?
Sim — para testar agentes cientes de imagem onde o custo de entrada e capturas de tela repetidas importam. Não — como uma atualização automática para um aplicativo somente texto.
Os pontos fortes confirmados são ampla compatibilidade de API, uso previsível de tokens de imagem, um contexto de 1M de tokens e resultados relatados pelo fornecedor que são pelo menos competitivos com o Opus 4.8 em quatro testes de agentes multimodais. Os custos são um contrato experimental, redimensionamento agressivo de imagem, nenhum resultado de benchmark independente ainda e desempenho misto contra o Opus em vez de uma vitória limpa.
Se sua carga de trabalho for somente texto, comece com DeepSeek V4 Flash e escale solicitações difíceis de codificação ou raciocínio para DeepSeek V4 Pro. Se capturas de tela, gráficos, renderizações de interface ou imagens de documentos contiverem informações de que o agente precisa, teste a API do DeepSeek V4 Flash Vision Exp diretamente através da GPT Proto.
Não promova a rota experimental para produção com base apenas em quatro benchmarks relatados pelo fornecedor. Teste-a contra seus próprios textos pequenos, painéis densos, bugs visuais e fluxos de trabalho de ferramentas em várias etapas primeiro.