O que é o Hunyuan 4 — ou Hy4 Preview?
O Hy4 preview é um grande modelo de linguagem de pesos abertos desenvolvido pela Tencent Hy Team. Ele foi criado principalmente para trabalhos de produtividade de longa duração: engenharia de software, análise de documentos, modelagem financeira, desenvolvimento de jogos, pesquisa científica e agentes que precisam planejar, chamar ferramentas e verificar resultados em várias etapas.
É um modelo de texto. A família Hunyuan mais ampla da Tencent inclui sistemas de imagem, vídeo e 3D, mas essas capacidades de nível familiar não devem ser atribuídas ao próprio Hy4 preview. A listagem atual do TokenHub cobre entrada e saída de texto, além de raciocínio, saída estruturada, Function Calling e cache de prompt.
| Especificação |
Hy4 preview |
| Desenvolvedor |
Tencent Hy Team |
| Data de lançamento |
28 de agosto de 2026 |
| Status de lançamento |
Prévia |
| Arquitetura |
Mixture-of-Experts |
| Parâmetros totais |
770B |
| Parâmetros ativos |
49B por token |
| Camadas do backbone |
78 |
| Janela de contexto |
1M tokens |
| Entrada máxima da API |
960K tokens |
| Saída máxima da API |
64K tokens |
| Modalidade de entrada |
Texto |
| Modalidade de saída |
Texto |
| ID do modelo na API |
hy4-preview |
| Licença |
Apache 2.0 |
| Disponibilidade no GPT Proto |
Em breve |
O Hy4 Preview é o mesmo que Hunyuan-4B?
Não. Os nomes parecem semelhantes, mas descrevem modelos muito diferentes.
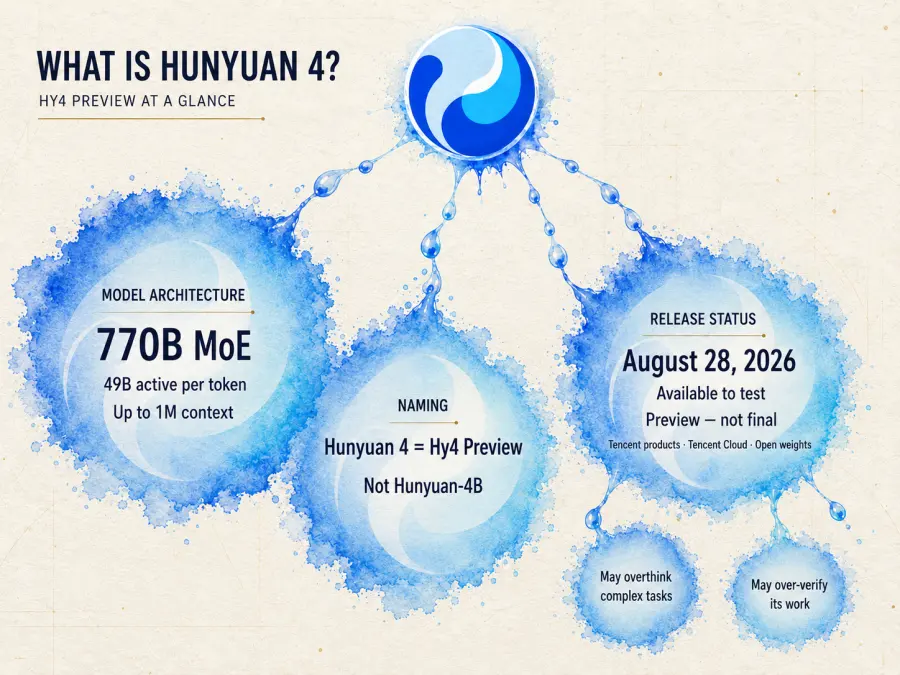
Hunyuan-4B é um membro de quatro bilhões de parâmetros da família anterior de modelos densos da Tencent. O “4B” refere-se à contagem de parâmetros. Hy4 preview é o carro-chefe de próxima geração da Tencent, com 770 bilhões de parâmetros totais e uma arquitetura Mixture-of-Experts.
Usar “Hunyuan 4” sem a palavra “preview” é compreensível para fins de busca, mas a documentação técnica deve usar Hy4 preview para evitar confusão.
Por que ele se chama Hy4 “Preview”?
A Tencent lança modelos preview antes que a geração final esteja completa para que a equipe possa coletar feedback de fluxos reais de codificação, pesquisa e produtividade. O Hy4 preview, portanto, é mais do que uma demonstração fechada — os pesos, a documentação e a API hospedada já estão disponíveis —, mas seu comportamento e sua configuração de serving ainda podem mudar.
A Tencent não anunciou uma data de lançamento final do Hy4. Seu anúncio de lançamento apenas afirma que mais modelos da série Hy4 devem chegar em breve. Qualquer mês exato que esteja circulando atualmente para a versão final é especulação.
O rótulo preview também vem com duas limitações divulgadas:
Esses comportamentos podem melhorar a confiabilidade em um problema de engenharia difícil. A contrapartida é maior latência e, potencialmente, mais tokens de saída em tarefas que um modelo menor ou mais rápido poderia responder diretamente.
Minha leitura é simples: o Hy4 preview está pronto para avaliação, não para migração cega. Uma equipe pode executá-lo em uma carga de trabalho paralela hoje, mas substituir um modelo de produção existente deve esperar até que ele passe nos próprios testes de regressão dessa equipe.
Como o Hy4 Preview Funciona?
O Hy4 preview é grande até mesmo pelos padrões atuais de modelos abertos, mas seus 770 bilhões de parâmetros não são todos usados para cada token.
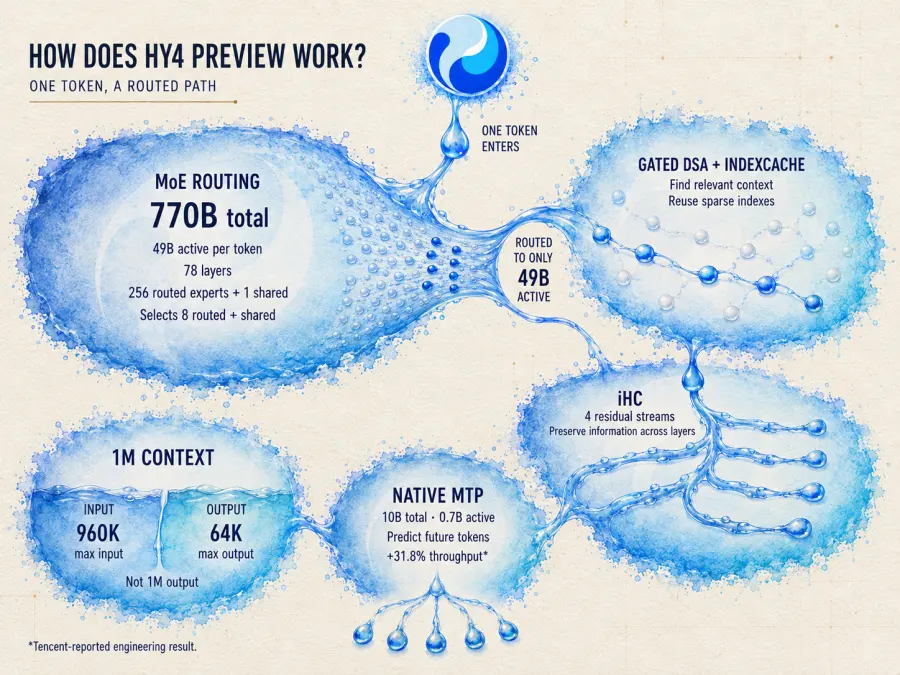
770B de Parâmetros Totais, 49B Ativos
O modelo usa uma arquitetura Mixture-of-Experts. Uma maneira simples de imaginá-la é como uma grande organização técnica: existem muitas equipes especializadas, mas apenas os especialistas relevantes para o problema atual são chamados para cada reunião.
O Hy4 preview tem um backbone de 78 camadas. A primeira camada usa uma rede feed-forward densa padrão, enquanto as outras 77 camadas usam blocos MoE. Cada um desses blocos contém 256 especialistas roteados e um especialista compartilhado. Para cada token, o modelo seleciona oito especialistas roteados junto com o especialista compartilhado.
Essa seleção reduz a computação por token em comparação com a ativação de todos os 770 bilhões de parâmetros. No entanto, isso não torna o modelo pequeno. Os pesos completos ainda precisam ser armazenados, transferidos e distribuídos durante a auto-hospedagem.
DSA com Gating e IndexCache
O Hy4 preview usa Gated DeepSeek Sparse Attention, ou Gated DSA, com IndexCache. Em vez de tratar cada token anterior como igualmente relevante, a atenção esparsa tenta identificar as partes de um contexto longo que mais importam para a etapa atual.
O IndexCache reutiliza índices de atenção esparsa entre camadas. O objetivo é reduzir o trabalho repetido quando o modelo processa documentos ou bases de código muito longos.
iHC e Múltiplos Fluxos Residuais
O modelo também usa identity Hyper-Connections, abreviado como iHC. Seu backbone mantém quatro fluxos residuais para ampliar como as informações podem se mover entre as camadas.
Para a maioria dos usuários de API, o nome importa menos do que o resultado pretendido: o modelo foi projetado para preservar e transformar informações ao longo de tarefas longas e de várias etapas, em vez de responder apenas a prompts curtos e isolados.
MTP Nativo para Decodificação Especulativa
Fora do backbone principal, a Tencent inclui uma camada nativa de Multi-Token Prediction com 10 bilhões de parâmetros totais e 0,7 bilhão de parâmetros ativos. Ela pode prever vários tokens futuros para decodificação especulativa, o que pode melhorar a taxa de geração quando a pilha de serving oferece suporte.
A Tencent também relata que o Hy4 preview ajudou a analisar e otimizar partes de seu próprio sistema de inferência. Mudanças envolvendo fusão de operadores e comunicação aumentaram a taxa de transferência ponta a ponta em 31,8% em relação à linha de base da Tencent. Esse é um resultado de engenharia relatado pelo fornecedor, ainda não um benchmark de serving reproduzido de forma independente.
Uma Janela de Contexto de 1M Não Significa 1M de Tokens de Saída
A janela de contexto anunciada é de um milhão de tokens, mas os limites hospedados são mais específicos:
Isso é capacidade de entrada suficiente para grandes repositórios, coleções de documentos ou longos históricos de agentes. Não significa que o modelo possa gerar uma resposta de um milhão de tokens. A própria documentação do TokenHub da Tencent limita a saída a 64K tokens.
Principais Recursos do Hunyuan 4
Codificação de Longo Horizonte e Trabalho com Agentes
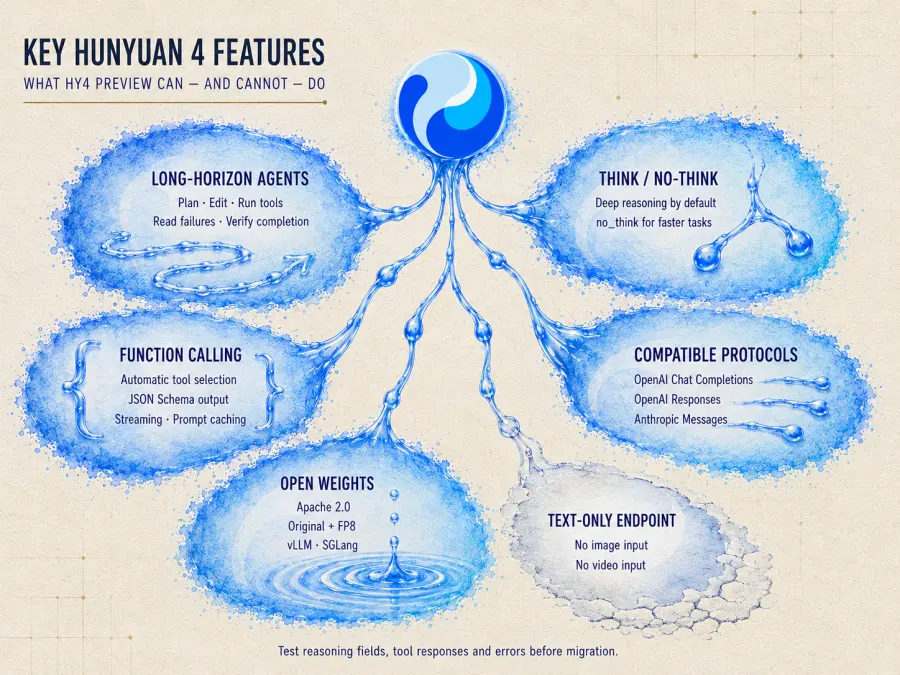
A Tencent posiciona o Hy4 preview para tarefas de codificação que exigem mais do que gerar uma única função. Sua carga de trabalho pretendida inclui entender um repositório, planejar mudanças, editar arquivos, executar ferramentas, ler falhas e verificar se uma tarefa está realmente concluída.
Esta é uma distinção importante. Um modelo pode ter bom desempenho em perguntas isoladas de código e, ainda assim, perder o controle do estado após dez chamadas de ferramentas. O Hy4 preview está sendo treinado e avaliado em torno do ciclo completo.
A Tencent também co-projetou o modelo com produtos como CodeBuddy e WorkBuddy. Isso dá aos seus testes internos mais relevância prática do que uma coleção de perguntas de múltipla escolha, embora continuem sendo avaliações conduzidas pela Tencent.
Modos de Raciocínio High e No-Think
O Hy4 preview oferece suporte tanto a modos de raciocínio profundo quanto de resposta direta. O raciocínio profundo é habilitado por padrão no exemplo oficial de implantação e destina-se a tarefas difíceis de codificação, matemática e pesquisa.
Para trabalhos mais simples, os desenvolvedores podem desabilitar o raciocínio estendido com no_think ou o parâmetro correspondente da API. Isso é útil para:
Deixar o raciocínio profundo habilitado para todas as solicitações pode desperdiçar tempo e tokens de saída. As próprias limitações conhecidas do modelo tornam essa decisão de roteamento especialmente importante.
Function Calling e Saída Estruturada
O modelo hospedado oferece suporte a Function Calling, seleção automática de ferramentas e saída restrita por JSON Schema. Esses recursos tornam o Hy4 preview adequado para agentes que precisam interagir com busca, bancos de dados, ambientes de desenvolvimento ou serviços internos.
Ele também oferece suporte a streaming e cache de prompt. O streaming melhora o tempo de resposta percebido em gerações longas, enquanto o preço de entrada em cache pode reduzir o custo de enviar repetidamente o mesmo prompt de sistema, contexto de repositório ou documentos de referência.
Protocolos Compatíveis com OpenAI e Anthropic
A Tencent Cloud documenta suporte para:
OpenAI Chat Completions
OpenAI Responses
Anthropic Messages
Um aplicativo existente pode, portanto, conseguir testar o Hy4 preview alterando sua URL base, autenticação e ID do modelo, em vez de reescrever toda a estrutura de requisição.
Isso não garante comportamento idêntico. Campos de raciocínio, respostas de chamadas de ferramentas, saída máxima e tratamento de erros ainda devem ser testados antes de migrar o tráfego.
Pesos Abertos Sob Apache 2.0
A Tencent lançou tanto o modelo original quanto uma versão FP8 sob a licença Apache 2.0. Os desenvolvedores podem inspecionar o modelo, implantá-lo com vLLM ou SGLang, ajustá-lo com fine-tuning e criar versões quantizadas.
As receitas oficiais de FP8 usam paralelismo de tensores em oito vias. Pesos abertos removem a dependência de um único endpoint hospedado, mas não eliminam a exigência de infraestrutura. Um modelo de 770B continua sendo um projeto de implantação sério.
O Hunyuan 4 Oferece Suporte a Imagens ou Vídeo?
O endpoint atual do Hy4 preview é somente texto.
Este é um de seus limites mais claros em comparação com modelos de codificação multimodais mais recentes. Ele não pode inspecionar diretamente uma captura de tela, ler um mock-up de UI ou raciocinar sobre uma gravação de vídeo por meio do endpoint documentado.
Para um fluxo de trabalho de repositório ou documento somente texto, isso pode não importar. Para um agente de frontend que precisa inspecionar a saída visual, isso pode decidir a escolha do modelo antes mesmo de considerar as pontuações de benchmark.
Preços e Disponibilidade do Hunyuan 4
O preço internacional oficial da Tencent é:
| Tipo de token |
Preço do Hy4 preview |
| Entrada |
$0,834 por 1M de tokens |
| Saída |
$2,501 por 1M de tokens |
| Entrada em cache |
$0,042 por 1M de tokens |
A entrada em cache custa cerca de 5% da tarifa padrão de entrada. Isso pode mudar materialmente o custo de um agente que lê repetidamente as mesmas instruções de projeto ou documentos.
Atualmente, o Hy4 preview pode ser acessado por meio do Tencent Cloud TokenHub e de produtos Tencent, incluindo WorkBuddy, CodeBuddy, Yuanbao e ima. A Tencent também ofereceu um teste de duas semanas durante o período de lançamento por meio do WorkBuddy e do CodeBuddy. Como se trata de uma promoção temporária, não deve ser tratado como o nível gratuito permanente do modelo.
A Auto-Hospedagem É Mais Barata?
Possivelmente em alto volume sustentado. Não automaticamente.
Os pesos originais são grandes o suficiente para exigir infraestrutura especializada, e os exemplos oficiais de implantação FP8 distribuem o modelo em oito GPUs. A auto-hospedagem também adiciona tempo de engenharia, monitoramento, upgrades, armazenamento, rede e capacidade ociosa.
A AngelSlim lançou um GGUF quantizado STQ1 de 229GB junto com uma versão Q4 de 467GB. O download menor torna a experimentação local mais realista, mas membros da comunidade questionaram corretamente se a retenção média de benchmark se transfere para codificação de contexto longo e chamadas repetidas de ferramentas. Pequenos erros podem se acumular ao longo de uma execução longa de agente, mesmo quando testes curtos permanecem estáveis.
Para muitas equipes, a tarifa de tokens hospedada será mais fácil de avaliar do que a economia de infraestrutura de uma implantação com oito GPUs.
Benchmarks do Hunyuan 4: Quão Forte É o Hy4 Preview?
O Hy4 preview tem um extenso apêndice de benchmarks, mas quase todos os números do dia de lançamento vêm da Tencent. Isso não os torna inúteis. Significa que devem ser rotulados corretamente.
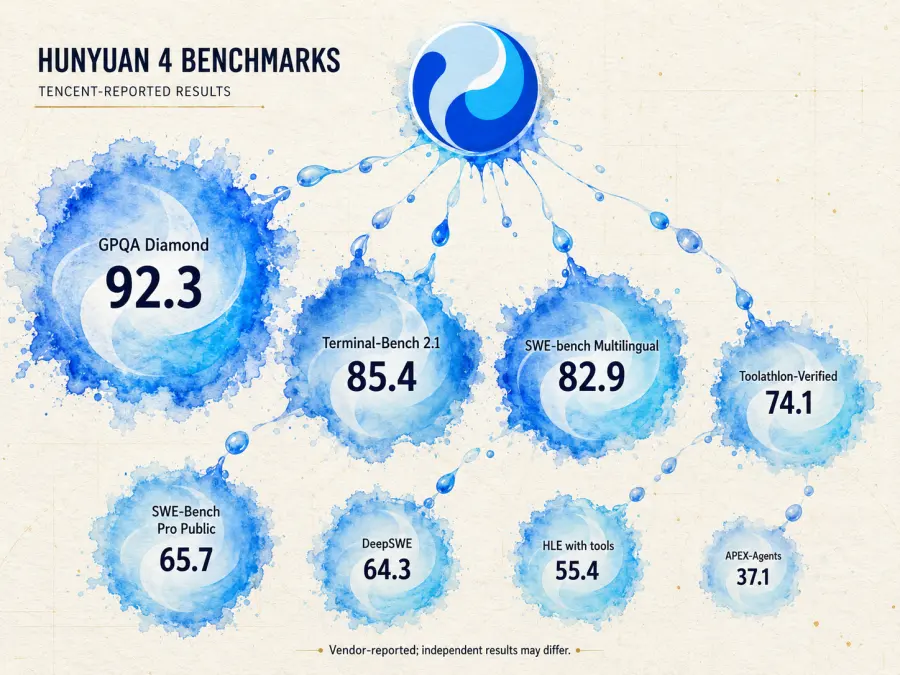
Resultados selecionados relatados pela Tencent incluem:
| Benchmark |
Hy4 preview |
Status da evidência |
| GPQA Diamond |
92.3 |
Relatado pelo fornecedor |
| Terminal-Bench 2.1 |
85.4 |
Relatado pelo fornecedor |
| SWE-bench Multilingual |
82.9 |
Relatado pelo fornecedor |
| Toolathlon-Verified |
74.1 |
Relatado pelo fornecedor |
| SWE-Bench Pro Public |
65.7 |
Relatado pelo fornecedor |
| DeepSWE |
64.3 |
Relatado pelo fornecedor |
| HLE com ferramentas |
55.4 |
Relatado pelo fornecedor |
| APEX-Agents |
37.1 |
Relatado pelo fornecedor |
Esses resultados sugerem que codificação, uso de ferramentas e raciocínio científico são centrais para o treinamento do modelo. Eles não provam o mesmo ranking sob um framework de agente, orçamento de ferramentas ou configuração de serving diferentes.
[Espaço para imagem: Benchmarks selecionados do Hy4 preview separados entre evidências relatadas pelo fornecedor e externas]
Teste Cego Interno de 203 Tarefas da Tencent
A Tencent também pediu que 163 especialistas internos avaliassem as saídas do modelo em 203 tarefas de engenharia.
| Modelo |
Pontuação média |
| Hy4 preview |
2,99 / 4 |
| Kimi K3 |
2,94 / 4 |
| GLM‑5.3 |
2,92 / 4 |
Contra o GLM‑5.3, o Hy4 preview registrou 46,8% de vitórias, 12,8% de empates e 40,4% de derrotas. Contra o Kimi K3, registrou 51,2% de vitórias, 7,9% de empates e 40,9% de derrotas.
Essa é uma liderança estreita dentro do próprio ambiente de produtividade da Tencent — não é evidência de que o Hy4 preview seja universalmente melhor.
Há também um erro fácil de nomenclatura a evitar: a Tencent comparou o Hy4 preview com GLM‑5.3 e Kimi K3. Não o comparou com GLM‑5.3 Flash ou MiniMax M3 neste teste cego.
Evidência Inicial do Arena WebDev
O WebDev AutoEval inicial da Arena colocou o GLM‑5.3 Flash com 1.634 pontos e o Hy4 preview com 1.633. Uma diferença de um ponto é efetivamente um empate nesta fase.
Ambas as pontuações foram produzidas por meio do AutoEval, em que um modelo de recompensa treinado com preferências humanas dá os votos. Elas ainda não se baseavam em votos humanos ao vivo suficientes para um ranking público estável. A conclusão útil é que o Hy4 preview parece competitivo em geração de frontend — não que tenha definitivamente vencido ou perdido.
O Que os Primeiros Usuários Estão Dizendo Sobre o Hy4 Preview?
A resposta inicial da comunidade é mais contida do que várias manchetes de lançamento.
Um tópico muito discutido no LocalLLaMA geralmente colocou o Hy4 preview no nível do GLM‑5.3. Os usuários notaram a grande melhoria em relação ao Hy3, mas questionaram se o próprio gráfico da Tencent sustentava uma conclusão ampla de que “supera GLM e Kimi”. Eles também se concentraram na dificuldade prática de executar pesos de 770B fora de um ambiente de data center.
Essa reação é razoável. O Hy4 preview parece um modelo aberto sério, mas as afirmações mais dramáticas ainda dependem da própria configuração de teste da Tencent.
Uma Pequena Comparação FlappyBench
Um teste da comunidade comparou Hy4 preview, Kimi K3 e GLM‑5.3 em uma tarefa de design no estilo Flappy Bird:
| Modelo |
Custo de execução relatado |
Observação do testador |
| Hy4 preview |
$0,0480 |
UI e jogabilidade mais distintas |
| Kimi K3 |
$0,0740 |
Jogabilidade mais difícil |
| GLM‑5.3 |
$0,0184 |
Jogabilidade fluida e menor custo |
Os comentaristas discordaram da interpretação original. Alguns preferiram o Kimi K3 porque a jogabilidade mais difícil era mais próxima do jogo original, enquanto outro comentarista observou que o prompt não foi fornecido com detalhes suficientes para julgar a comparação.
Essa discordância é útil. Ela mostra por que o “melhor resultado de frontend” depende dos critérios de aceitação. Distinção visual, fidelidade, dificuldade e custo são métricas diferentes. Um único prompt compartilhado não consegue resolver todas as quatro.
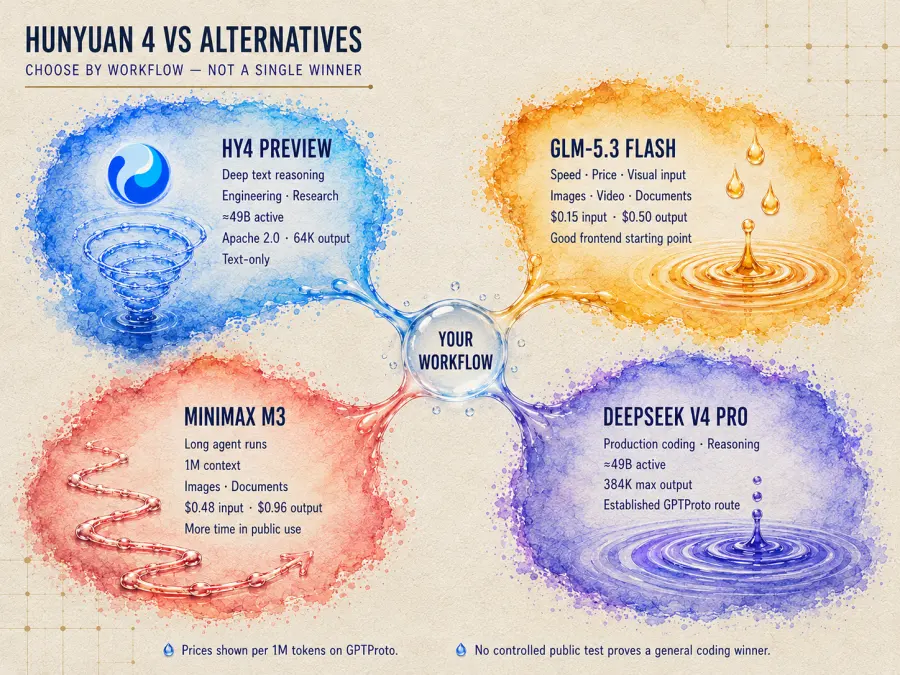
Hunyuan 4 vs GLM‑5.3 Flash, MiniMax M3 e DeepSeek V4 Pro
O Hy4 preview entra em um grupo concorrido de modelos chineses criados para codificação, agentes e cargas de trabalho de milhões de tokens.
| Fator de decisão |
Hy4 preview |
GLM‑5.3 Flash |
MiniMax M3 |
DeepSeek V4 Pro |
| Estágio de lançamento |
Preview |
Lançado |
Lançado |
Lançado |
| Janela de contexto |
1M |
1M |
1M |
1M |
| Saída máxima documentada |
64K |
Depende da rota |
Até aproximadamente 512K |
384K |
| Entrada no GPT Proto |
Ainda não disponível |
Texto, imagem, vídeo, documento |
Texto, imagem, documento |
Texto |
| Principal ponto forte |
Agentes de texto difíceis e pesquisa |
Codificação multimodal rápida |
Execuções longas de agentes multimodais |
Codificação e raciocínio STEM |
| Licença aberta |
Apache 2.0 |
MIT |
MiniMax Community |
MIT |
| Preço de entrada no GPT Proto |
Em breve |
$0,15/1M |
$0,48/1M |
Ver página do modelo ao vivo |
| Preço de saída no GPT Proto |
Em breve |
$0,50/1M |
$0,96/1M |
Ver página do modelo ao vivo |
Os preços do GPT Proto nesta tabela referem-se às rotas disponíveis no GPT Proto, enquanto o preço do Hy4 discutido anteriormente é a tarifa oficial da Tencent. Os preços ao vivo podem mudar e devem ser verificados na página de cada modelo antes da implantação.
Hunyuan 4 vs GLM‑5.3 Flash
O Hy4 preview é o candidato mais interessante para tarefas difíceis de engenharia ou pesquisa somente de texto, em que uma equipe está disposta a trocar tempo de resposta por raciocínio mais profundo.
GLM‑5.3 Flash é a escolha mais prática quando preço, velocidade de resposta ou entrada visual importam. Sua rota no GPT Proto aceita imagens, vídeos e documentos, enquanto o Hy4 preview atualmente aceita texto. Ele também custa $0,15 por milhão de tokens de entrada e $0,50 por milhão de tokens de saída no GPT Proto — muito abaixo da tarifa oficial atual do Hy4.
As pontuações iniciais do Arena WebDev são quase idênticas. Para codificação de frontend, eu começaria com o GLM‑5.3 Flash porque ele pode inspecionar referências visuais e custa menos, depois testaria o Hy4 nos casos mais difíceis de planejamento e depuração baseados em texto.
Hunyuan 4 vs MiniMax M3
MiniMax M3 é outro modelo MoE de um milhão de tokens criado para execuções longas de agentes. No GPT Proto, ele custa $0,48 por milhão de tokens de entrada e $0,96 por milhão de tokens de saída. Entrada de imagem e documento está disponível por meio de sua rota multimodal.
O Hy4 preview oferece uma licença Apache 2.0 e fortes resultados iniciais em benchmarks de uso de ferramentas e engenharia. O MiniMax M3 tem um preço hospedado menor no GPT Proto, saída documentada mais longa e mais tempo de uso público.
Para um novo agente de pesquisa somente texto, vale a pena adicionar o Hy4 ao conjunto de avaliação. Para um fluxo de trabalho de produção sensível a custos ou um agente que precisa inspecionar imagens e arquivos, o MiniMax M3 atualmente é mais fácil de justificar.
Hunyuan 4 vs DeepSeek V4 Pro
DeepSeek V4 Pro e Hy4 preview ativam aproximadamente 49 bilhões de parâmetros por token e miram tarefas difíceis de codificação e raciocínio. O DeepSeek V4 Pro tem uma contagem total de parâmetros maior e uma saída máxima documentada de 384K tokens, em comparação com 64K do Hy4 preview.
O Hy4 oferece pesos Apache 2.0 e a integração da Tencent com WorkBuddy/CodeBuddy. O DeepSeek V4 Pro já tem uma rota estabelecida no GPT Proto e é mais adequado para equipes que precisam de um endpoint de produção agora.
Não há um teste público controlado o suficiente para declarar um vencedor geral em codificação. Teste edição de repositório, recuperação de falhas e custo total na mesma carga de trabalho.
Para Que Você Pode Usar o Hunyuan 4?
O Hy4 preview combina melhor com tarefas difíceis o suficiente para justificar seu processo de raciocínio mais longo.
Codificação em Escala de Repositório
Um agente de desenvolvimento pode usar a grande janela de contexto para ler documentação do projeto, arquivos-fonte, falhas de teste e alterações anteriores em uma única sessão de trabalho. O teste mais útil não é se ele escreve uma função corretamente, mas se preserva o estado do projeto após edições repetidas.
Análise de Documentos Longos e Financeira
A Tencent treinou o modelo em torno de fluxos de trabalho de escritório e análise envolvendo documentos, planilhas, equações e modelos financeiros. Seu contexto de um milhão de tokens o torna relevante para grandes coleções de material com muito texto.
Dados privados ou regulamentados ainda exigem uma revisão separada das políticas de retenção, localização e acesso do provedor de hospedagem escolhido.
Agentes de Pesquisa que Usam Ferramentas
O Hy4 preview oferece suporte a Function Calling e raciocínio estendido, permitindo que ele pesquise, execute experimentos, inspecione resultados e revise uma abordagem. A Tencent relata usá-lo em pesquisa de IA, dinâmica molecular, física da matéria condensada e matemática.
Essas são tarefas de alta variabilidade. A revisão humana continua necessária, especialmente quando o modelo gera afirmações científicas ou interpreta resultados experimentais.
Prototipagem de Jogos
A Tencent demonstra o Hy4 preview trabalhando com engines de jogos para criar e revisar protótipos jogáveis. Este é um bom teste de agente porque combina código, lógica de interação, gerenciamento de estado e depuração.
Uma demo jogável não é um jogo pronto para produção. Licenciamento de assets, desempenho, compatibilidade de plataforma e entrega limpa do projeto ainda precisam de verificações separadas.
Cargas de Trabalho em que Outro Modelo Faz Mais Sentido
O Hy4 preview não deve ser a escolha padrão quando:
O agente precisa inspecionar capturas de tela, imagens ou vídeos.
A tarefa é uma solicitação curta de classificação ou extração.
Baixa latência importa mais do que raciocínio profundo.
A equipe não pode tolerar mudanças de comportamento na fase Preview.
O hardware local não consegue suportar um modelo muito grande.
O sistema de produção não tem uma suíte de regressão específica para o modelo.
Vale a Pena Usar o Hunyuan 4 Agora?
Vale a pena testar o Hy4 preview, mas é cedo demais para tratá-lo como substituto automático do GLM‑5.3 Flash, MiniMax M3 ou DeepSeek V4 Pro.
O modelo se destaca mais para equipes que avaliam agentes de pesos abertos e somente texto em bases de código longas, material de pesquisa ou fluxos complexos de ferramentas. Sua licença Apache 2.0, contexto de um milhão de tokens e resultados iniciais de engenharia são vantagens significativas.
Os custos são igualmente reais. É um modelo grande, seu preço hospedado atual é mais alto do que várias alternativas chinesas rápidas, sua saída é limitada a 64K tokens, e a Tencent já reconheceu raciocínio excessivo e verificação excessiva.
Use-o agora se você tiver seu próprio conjunto de avaliação e puder executá-lo ao lado de um modelo de produção existente. Espere se precisar de latência estável, entrada multimodal ou um modelo que já acumulou meses de testes independentes.
O Hy4 preview está chegando ao GPT Proto. Enquanto isso, os desenvolvedores podem comparar GLM‑5.3 Flash, MiniMax M3 e DeepSeek V4 Pro por meio de uma única conta e saldo compartilhado.