MiniMax M3 vs DeepSeek V4 Flash: Veredito Rápido
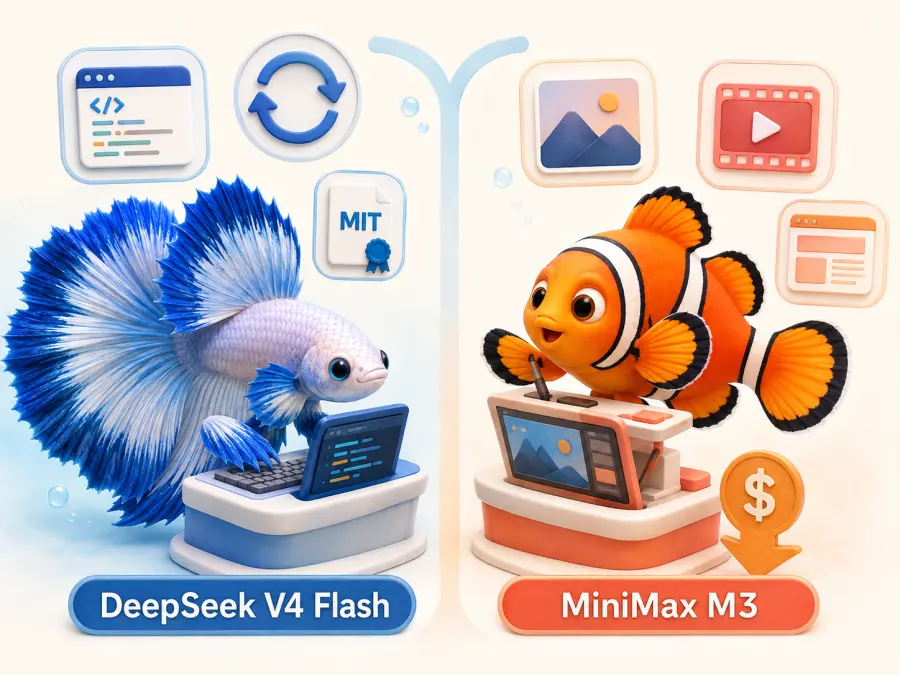
O DeepSeek V4 Flash é a melhor opção padrão para a maioria dos desenvolvedores que trabalham apenas com texto. Sua versão com raciocínio máximo lidera o Índice de Inteligência independente, escreve um pouco mais rápido, usa uma licença MIT e tem leituras de cache baratas — útil quando agentes reenviam contexto do repositório e esquemas de ferramentas.
O MiniMax M3 é mais amplo. Ele aceita imagens e vídeo, oferece suporte a uma saída máxima maior e atualmente custa menos por token de saída no GPT Proto. Ele se adequa a captura de tela para código, depuração visual e saída longa.
| Sua carga de trabalho |
Modelo recomendado |
| Codificação apenas com texto |
DeepSeek V4 Flash |
| Agentes de repositório com contexto repetido |
DeepSeek V4 Flash |
| Captura de tela para código |
MiniMax M3 |
| Depuração visual de frontend |
MiniMax M3 |
| Chamadas com muita saída durante horários de pico do DeepSeek |
MiniMax M3 |
| Trabalhos em lote agendados fora do pico |
DeepSeek V4 Flash |
| Auto-hospedagem comercial |
DeepSeek V4 Flash |
| Entrada nativa de imagem e vídeo |
MiniMax M3 |
Para código de alto risco, nenhum dos modelos deve ser escolhido apenas pela posição em rankings. Alterações de autenticação, migrações de banco de dados, trabalho de infraestrutura e refatorações de vários serviços precisam de testes, verificações estáticas ou uma revisão separada, porque o custo de corrigir uma alteração errada pode exceder a economia de tokens de dezenas de chamadas bem-sucedidas.
Experimente o MiniMax M3 no GPT Proto ou experimente o DeepSeek V4 Flash no GPT Proto.
MiniMax M3 vs DeepSeek V4 Flash: Visão Geral
A tabela abaixo usa as versões hospedadas atuais e as tarifas do GPT Proto disponíveis em 28 de agosto de 2026. Preços e limites hospedados podem mudar, portanto as páginas de modelos ao vivo devem continuar sendo a referência final antes da implantação.
| Especificação |
MiniMax M3 |
DeepSeek V4 Flash 0731 |
| Lançamento |
1º de junho de 2026 |
Atualização da API de 31 de julho de 2026 |
| Arquitetura |
428B no total / 23B ativos |
284B no total / 13B ativos |
| Janela de contexto |
1,048,576 tokens; mínimo garantido de 512K |
1,048,576 tokens combinados |
| Saída máxima |
Cerca de 512K tokens |
Até 384K tokens |
| Entrada nativa |
Texto, imagem e vídeo |
Texto |
| Saída |
Texto |
Texto |
| Controle de raciocínio |
Ativado, adaptativo ou desativado |
Sem raciocínio, baixo, alto ou máximo |
| Chamada de ferramentas |
Sim |
Sim |
| Preço de entrada nova do GPT Proto |
USD 0,48/1M tokens |
USD 0,44/1M tokens no pico |
| Preço de saída do GPT Proto |
USD 0,96/1M tokens |
USD 1,32/1M tokens no pico |
| Taxa de cache do GPT Proto |
USD 0,10 gravação / USD 0,10 leitura por 1M |
USD 0,014 leitura por 1M no pico |
| Licença |
Licença Comunitária MiniMax |
MIT |
| Melhor aplicação |
Fluxos de trabalho multimodais e visuais |
Codificação em texto e loops repetidos de agentes |
O MiniMax é nativamente multimodal, mas o GPT Proto separa chamadas de texto de sua rota de imagem para texto. O DeepSeek V4 Flash padrão é texto para texto; deepseek-v4-flash-vision-exp é um modelo experimental separado.
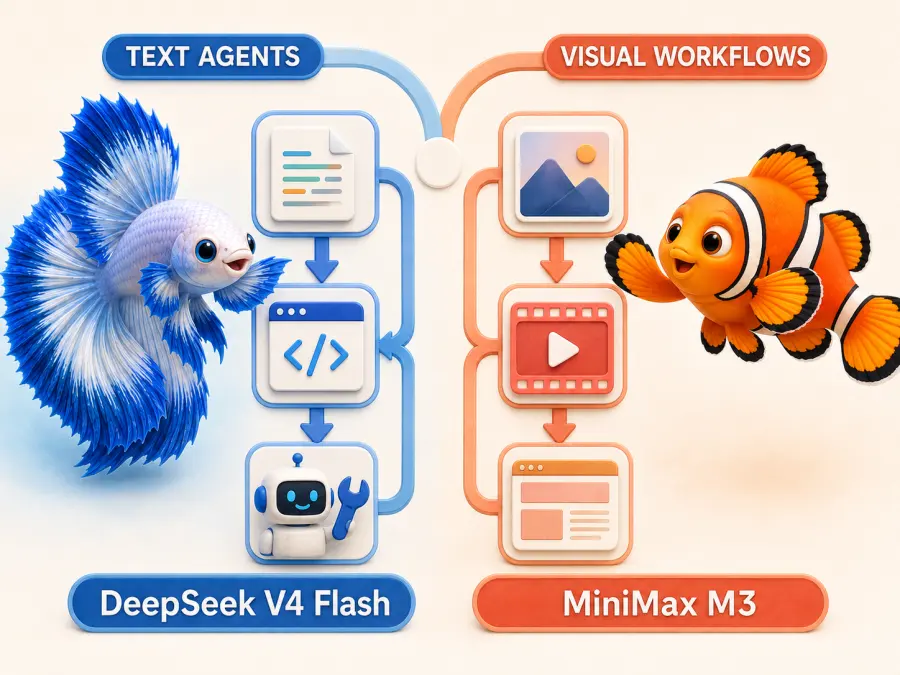
Os objetivos de design por trás da tabela são diferentes. A MiniMax construiu o M3 em torno do MiniMax Sparse Attention e do treinamento nativo em texto, imagem e vídeo. A DeepSeek criou a camada menor V4 Flash para inferência de texto eficiente e depois usou a atualização pós-treinamento 0731 para fortalecer agentes e adicionar suporte nativo à API Responses. O MiniMax oferece entradas mais amplas; o DeepSeek oferece uma rota mais estreita, focada em texto, com leituras de cache mais baratas e uma licença MIT.
Comparação de benchmarks: o modo de raciocínio muda o vencedor
A comparação independente mais limpa vem da Artificial Analysis. Com o DeepSeek definido para raciocínio máximo, ele lidera o MiniMax M3 no Índice de Inteligência e é um pouco mais rápido.
| Métrica independente |
MiniMax M3 |
DeepSeek V4 Flash 0731, raciocínio máximo |
| Índice de Inteligência da Artificial Analysis |
45 |
52 |
| Velocidade de saída |
114 tokens/s |
119 tokens/s |
| Tempo até o primeiro token |
1,17 segundos |
1,12 segundos |
| Janela de contexto |
1M tokens |
1M tokens |
A diferença de inteligência é significativa; a diferença de velocidade é pequena, e a taxa de transferência hospedada pode mudar. O resultado mais revelador aparece quando o DeepSeek roda sem raciocínio: a Artificial Analysis lista o MiniMax M3 com 45 e o DeepSeek V4 Flash sem raciocínio com 29. “O desempenho do DeepSeek V4 Flash” fica, portanto, incompleto a menos que a configuração de raciocínio seja nomeada. O raciocínio máximo é a comparação relevante para código complexo e planejamento de agentes; o modo sem raciocínio se adequa a trabalhos delimitados, como classificação, extração e autocompletar.
Gráficos de fornecedores adicionam contexto, mas não criam um teste justo de confronto direto. A MiniMax relata 59,0% no SWE-Bench Pro, 66,0 no Terminal-Bench 2.1 e 74,2 no MCP Atlas. A DeepSeek relata 82,7 no Terminal-Bench 2.1, 54,2 no NL2Repo e 70,3 no Toolathlon Verified. As empresas usaram infraestrutura, scaffolding, frameworks de avaliação e configurações diferentes, então comparar 82,7 diretamente com 66,0 seria enganoso.
A conclusão defensável é mais restrita: a comparação independente favorece o DeepSeek no raciocínio máximo. Gráficos de lançamento não nos dizem qual modelo concluirá uma tarefa específica de repositório com menos correções.
MiniMax M3 vs DeepSeek V4 Flash para programação
Para tarefas de programação pequenas e verificáveis, o DeepSeek é o melhor ponto de partida. Testes unitários, conversão de esquemas, explicação de código, correções de bugs isolados e edições repetitivas se beneficiam de sua pontuação de raciocínio e taxa de cache — especialmente quando testes, linters ou validadores podem verificar o resultado.
O trabalho em todo o repositório é menos direto. Capacidade não é o mesmo que compreensão confiável: um agente precisa seguir as regras do repositório, evitar edições não relacionadas, recuperar-se após comandos com falha e manter um plano. Eu ainda começaria com o DeepSeek para trabalho de repositório apenas com texto porque seu resultado com raciocínio máximo é mais forte e as leituras de cache são baratas. O MiniMax se torna mais atraente quando a tarefa inclui capturas de tela, diagramas, recursos de design ou outras entradas visuais.
Um primeiro patch mais barato não é mais barato se exigir recuperação manual. Para alterações de alto risco, compare chamadas totais, ferramentas com falha, correções, testes e tempo até um entregável aceito.
Qual é melhor para programação de frontend?
“Programação de frontend” pode descrever dois trabalhos diferentes, e muitas comparações os misturam.
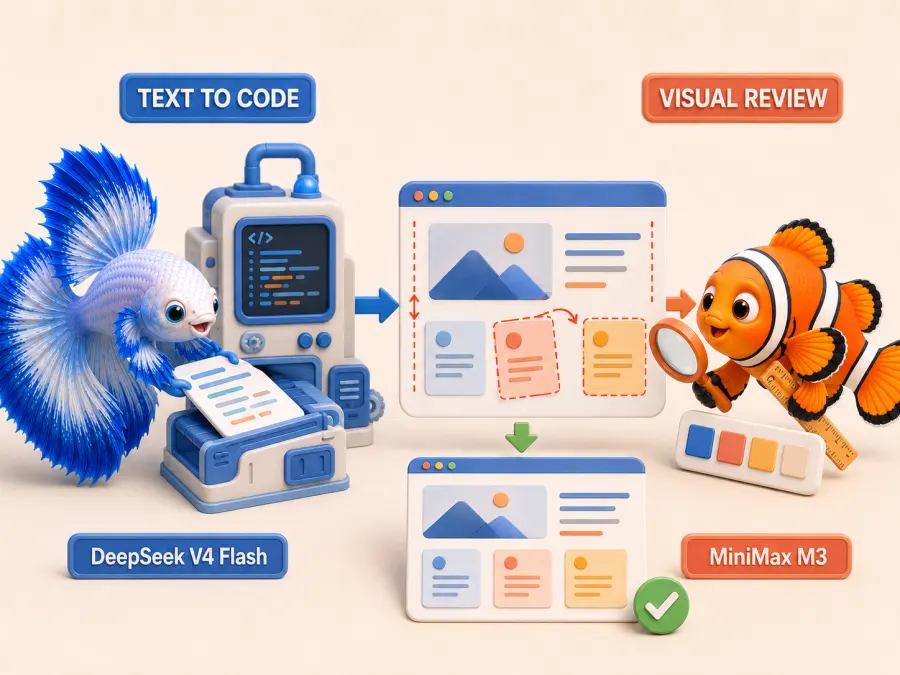
O primeiro é texto para código. Um desenvolvedor fornece uma especificação escrita e pede um componente React, CSS responsivo, lógica de estado, correções de acessibilidade ou um layout de página. Não há imagem para o modelo inspecionar. Para essa carga de trabalho, o DeepSeek V4 Flash é o padrão mais forte com base na comparação independente atual de raciocínio e em sua adequação a agentes de codificação baseados em texto.
O segundo é iteração visual de frontend. O modelo recebe uma captura de tela, página renderizada ou gravação de tela e deve identificar erros de espaçamento, cor ou alinhamento. O MiniMax M3 tem a capacidade decisiva aqui porque o DeepSeek V4 Flash padrão não consegue aceitar entrada visual.
Essa distinção produz uma conclusão mais precisa do que “o MiniMax é melhor para frontend”. O MiniMax M3 não é automaticamente o melhor programador de frontend. Ele é o melhor modelo visual de frontend. O DeepSeek continua sendo o melhor padrão apenas para texto, enquanto o MiniMax lida com o ciclo de feedback que começa depois que a página foi renderizada.
Qual modelo é melhor para agentes de IA?
Ambos os modelos podem chamar ferramentas, retornar argumentos estruturados, ler resultados e continuar por uma tarefa de várias etapas. O DeepSeek é o padrão prático para agentes de texto que pesquisam repositórios, inspecionam logs, geram testes ou executam fluxos de dados repetíveis. Sua taxa de cache importa porque esses sistemas reenviam as mesmas instruções e definições de ferramentas. O MiniMax se adequa a agentes que precisam interpretar gráficos, telas de aplicativos, referências de design ou gravações antes de escolher a próxima ação.
O seguimento de instruções é a parte menos confortável de ambas as histórias. Em uma discussão da comunidade sobre o MiniMax M3, usuários relataram ter que lutar contra o modelo por causa de regras e instruções, embora outros usuários tenham descrito bons resultados em fluxos de agentes de codificação. O DeepSeek 0731 recebeu críticas semelhantes: desenvolvedores relataram problemas para seguir regras, habilidades e instruções não relacionadas à codificação em um tópico focado em codificação e em uma discussão separada sobre confiabilidade.
Esses são relatos, não avaliações controladas. Eles explicam por que o teste final de migração deve usar seu prompt de sistema real, regras do repositório, esquema de ferramentas e instruções de recuperação de erros. Um fluxo de trabalho misto sensato envia implementação em texto e subtarefas repetitivas para o DeepSeek, e então encaminha análise de capturas de tela e depuração visual para o MiniMax.
Preços: qual modelo é realmente mais econômico?
O preço por token sozinho dá a resposta errada porque esses modelos têm taxas diferentes de entrada, saída, cache e baseadas em tempo. Os cálculos a seguir usam as tarifas do GPT Proto exibidas em 28 de agosto de 2026.
O MiniMax M3 tem tarifas fixas de USD 0,48 por milhão de tokens de entrada nova e USD 0,96 por milhão de tokens de saída. Gravações e leituras de cache atualmente custam USD 0,10 por milhão cada.
O DeepSeek V4 Flash tem tarifas de pico de USD 0,44 por milhão de tokens de entrada nova, USD 0,014 por milhão de tokens de leitura de cache e USD 1,32 por milhão de tokens de saída. Chamadas fora do pico são cobradas pela metade dessas tarifas. Atualmente, o GPT Proto define as janelas fora do pico no horário de Pequim como 18:00–09:00 e 12:00–14:00; a cobrança real segue o horário da solicitação.
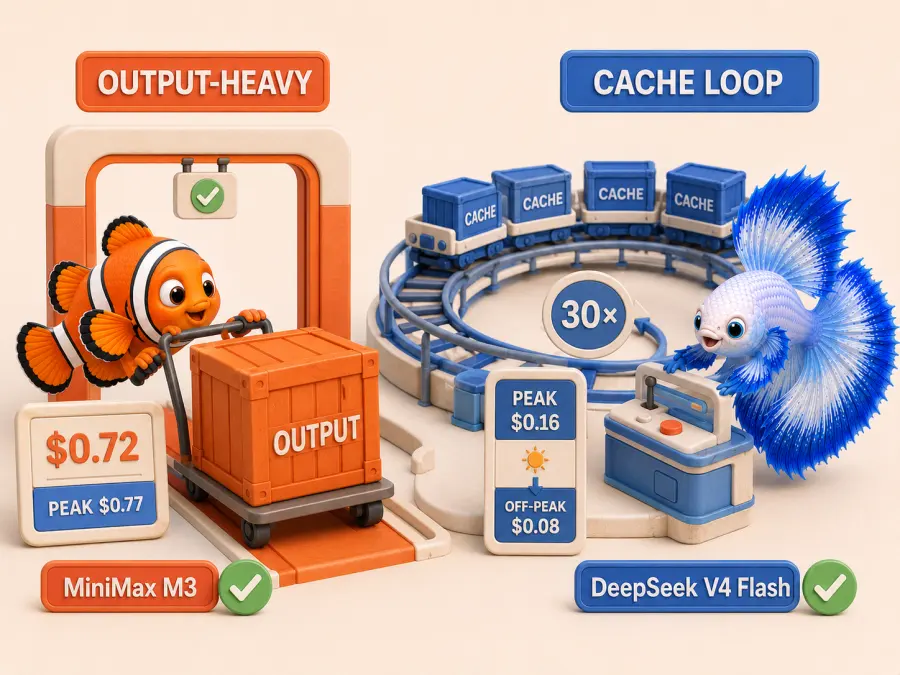
Exemplo 1: solicitação com muita saída e sem cache
Suponha que uma solicitação use um milhão de tokens de entrada nova e produza 250.000 tokens de saída.
| Modelo e momento |
Custo estimado |
| MiniMax M3 |
USD 0,7200 |
| DeepSeek V4 Flash no pico |
USD 0,7700 |
| DeepSeek V4 Flash fora do pico |
USD 0,3850 |
O MiniMax é cerca de USD 0,05 mais barato durante o período de pico do DeepSeek porque sua taxa de saída é menor. Quando a mesma chamada do DeepSeek passa para fora do pico, o DeepSeek custa quase metade do MiniMax.
Exemplo 2: agente de codificação com uso intenso de cache
Agora suponha uma sessão de agente de codificação de 30 turnos. Cada turno lê 100.000 tokens em cache, adiciona 3.000 tokens de entrada nova e produz 2.000 tokens de saída. A estimativa do MiniMax também inclui uma gravação inicial de cache de 100.000 tokens.
| Modelo e momento |
Custo estimado de 30 turnos |
| MiniMax M3 |
USD 0,4108 |
| DeepSeek V4 Flash no pico |
USD 0,1608 |
| DeepSeek V4 Flash fora do pico |
USD 0,0804 |
Esta é a distinção de preços que a maioria das tabelas de comparação simples não percebe. O MiniMax M3 pode vencer em solicitações sem cache e com muita saída. O DeepSeek V4 Flash geralmente vence em loops de agentes com uso intenso de cache, mesmo em tarifas de pico. Agendar trabalhos adiáveis fora do pico amplia novamente a diferença.
Estas são estimativas, não faturas de um teste ao vivo pareado. As equipes devem recalcular com sua própria proporção de tokens, taxa de acerto de cache, tentativas repetidas e taxa de tarefas aceitas.
Janela de contexto, multimodalidade e implantação
Ambos os modelos anunciam aproximadamente um milhão de tokens de contexto, mas esse é um orçamento operacional combinado. Para o DeepSeek, entrada, histórico, resultados de ferramentas, raciocínio e saída compartilham a janela de 1,048,576 tokens; a saída máxima é de até 384K. O MiniMax lista o mesmo contexto de destaque, um mínimo garantido de 512K e saída máxima em torno de 512K. Agentes de contexto longo ainda devem reservar espaço para a saída e selecionar arquivos relevantes em vez de enviar um repositório não filtrado.
Multimodalidade não é empate. O MiniMax aceita texto, imagens e vídeo; o DeepSeek V4 Flash aceita texto. Um fluxo de trabalho do DeepSeek que precise de capturas de tela deve encaminhar a etapa visual para outro modelo, como o modelo Vision Exp hospedado separadamente.
O licenciamento cria a diferença final. A DeepSeek publica os pesos do V4 Flash sob a Licença MIT, que é mais fácil para auto-hospedagem comercial, redistribuição e modificação. A MiniMax publica o M3 sob a Licença Comunitária MiniMax, que adiciona condições de atribuição, aviso e autorização dependente de receita. Usuários de API hospedada podem se importar principalmente com disponibilidade de rota e termos de dados; equipes de auto-hospedagem precisam revisar a licença dos pesos antes da implantação.
Qual modelo você deve escolher?
Escolha o MiniMax M3 quando o agente precisar inspecionar imagens ou vídeo, o trabalho de frontend incluir feedback de página renderizada ou chamadas em horário de pico gerarem muita saída. Escolha o DeepSeek V4 Flash quando o fluxo de trabalho for baseado em texto, o cache importar, trabalhos em lote puderem rodar fora do pico ou uma licença MIT for necessária. Use ambos quando o aplicativo se dividir naturalmente entre implementação em texto e revisão visual.
Execute MiniMax M3 e DeepSeek V4 Flash com uma única chave de API
Testar ambos os modelos não deve exigir dois saldos de conta separados ou duas camadas de integração. O GPT Proto fornece acesso ao MiniMax M3 e ao DeepSeek V4 Flash pela mesma conta e saldo compartilhado.
Para chamadas de texto, ambos se encaixam em uma estrutura de aplicação compatível com OpenAI. Altere o ID do modelo, mantenha a tarefa e os critérios de aceitação fixos e registre conclusão, chamadas de ferramentas com falha, correções, latência, uso de tokens e custo total. Antes de migrar o tráfego, execute testes canário para streaming, argumentos de ferramentas, análise de JSON, configurações de raciocínio, tentativas repetidas e comportamento de tokens máximos.
Experimente ambos os modelos no GPT Proto
Use uma chave e um saldo compartilhado para comparar os dois modelos no trabalho que seu aplicativo realmente executa.
Veredito final
O DeepSeek V4 Flash 0731 é a melhor opção padrão para codificação apenas com texto e agentes com uso intenso de cache. Ele lidera a comparação independente atual de raciocínio máximo, usa uma licença MIT e se torna particularmente barato quando um aplicativo reutiliza contexto ou agenda chamadas fora do pico.
O MiniMax M3 é a melhor escolha quando o fluxo de trabalho precisa de entrada de imagem ou vídeo, feedback visual de frontend, saída mais longa ou uma taxa de saída menor em horário de pico. Sua vantagem é a amplitude, não uma alegação geral de que escreve código melhor.
Para trabalho em produção, escolha pelo custo por tarefa aceita, não apenas pelo preço por token: conclusão, adesão às instruções, verificações aprovadas e esforço de recuperação.