Qu’est-ce que Step 5 Preview ?
Step 5 Preview est un modèle de raisonnement multimodal développé par StepFun, basé à Shanghai. Il est conçu pour planifier, appeler des outils, inspecter les résultats, réviser son approche et continuer jusqu’à produire un livrable.
Voici les principaux faits tirés de la documentation officielle du modèle et de la page de lancement de StepFun :
| Spécification |
Step 5 Preview |
| Développeur |
StepFun |
| ID du modèle |
step-5-preview |
| Architecture |
Mélange d’experts clairsemé |
| Paramètres |
600B au total, 27B actifs par token |
| Fenêtre de contexte |
1M de tokens |
| Sortie maximale |
64K de tokens |
| Entrée |
Texte, images et vidéo |
| Sortie |
Texte |
| Contrôle du raisonnement |
low, medium, ou high |
| Statut de l’API |
Disponible auprès de StepFun |
| Statut des poids ouverts |
Prévu pour le 15 octobre 2026 |
| Statut GPT Proto |
Pas encore disponible ; intégration prévue |
« Preview » est important. L’API peut être utilisée dès maintenant, mais son comportement, ses limites, sa tarification et même son nom peuvent changer avant une version stable. StepFun indique que les poids du modèle seront publiés le 15 octobre 2026. D’ici là, il convient de le traiter comme un modèle propriétaire hébergé, et non comme un modèle à poids ouverts déjà auto-hébergeable.
Fonctionnalités et architecture de Step 5 Preview
600B de paramètres sans activer les 600B en totalité
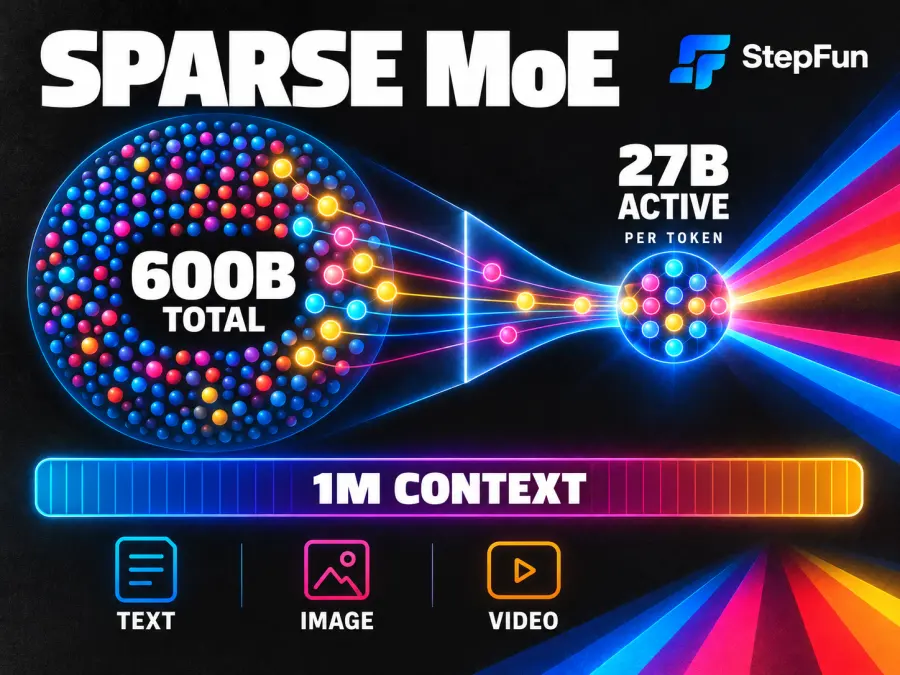
Step 5 Preview utilise une conception de mélange d’experts clairsemé, ou MoE. Il contient 600 milliards de paramètres au total, mais seulement 27 milliards sont actifs pour chaque token. Un système de routage sélectionne les experts pertinents pour l’entrée actuelle.
« 600B » décrit la capacité totale ; cela ne signifie pas que chaque token subit le coût d’un modèle dense de 600B. Le nombre actif est plus pertinent pour l’efficacité d’inférence, mais le matériel, le traitement par lots, la longueur du raisonnement et la capacité du fournisseur déterminent toujours les performances réelles.
Un contexte de 1M de tokens et une sortie de 64K tokens
La fenêtre de contexte de 1 million de tokens cible les grands dépôts, rapports, conversations et collections de documents. La sortie maximale est de 64,000 tokens. Un grand contexte exige toujours une récupération disciplinée : davantage de matière peut ajouter des preuves non pertinentes, des instructions contradictoires et du coût.
La mise en cache des prompts rend le travail répété sur la même base de code, bibliothèque de politiques ou corpus de recherche bien moins cher que l’envoi répété d’entrées non mises en cache.
Entrée texte, image et vidéo
Le modèle accepte du texte, jusqu’à 60 images par requête et de la vidéo. Les images peuvent être au format JPEG, PNG, WebP ou GIF statique. Les formats vidéo incluent MP4, QuickTime et Matroska ; StepFun recommande des clips de moins de cinq minutes.
Vous pouvez voir des bases de données tierces ne lister que les entrées texte et image. Cela ne contredit pas nécessairement StepFun. Par exemple, Artificial Analysis enregistre les modalités couvertes par sa fiche et ses tests, tandis que StepFun documente la prise en charge de la vidéo dans sa propre API. Pour les limites d’implémentation, utilisez la documentation propriétaire ; pour les performances comparatives, utilisez des tests indépendants.
L’appel d’outils n’est pas un accès intégré au monde extérieur
Step 5 Preview prend en charge le streaming, l’appel de fonctions, le mode JSON, JSON Schema et un effort de raisonnement ajustable. Cependant, le modèle ne navigue pas indépendamment sur le Web, n’exécute pas de code et n’accède pas aux fichiers d’un développeur. StepFun déclare explicitement que la recherche, l’exécution de code, la gestion de documents et d’autres outils doivent être fournis par l’application d’intégration.
Le modèle peut décider quand et comment utiliser un outil, mais le système d’agent environnant contrôle ses outils, ses permissions et la validation des résultats.
Step 5 Preview pour le codage et le travail agentique
Dans un agent de codage, le modèle reçoit un objectif, lit des fichiers, applique des modifications, exécute des tests, observe les échecs et itère. Son long contexte peut préserver la structure du dépôt et les décisions antérieures tout au long de cette boucle.
StepFun rapporte les résultats suivants pour le modèle avec un effort de raisonnement élevé :
| Benchmark |
Score de Step 5 Preview |
Ce qu’il teste |
| DeepSWE v1.1 |
67.7% |
Ingénierie logicielle au niveau du dépôt |
| StepCodeBench |
49.0% |
Tâches d’ingénierie multilingues |
| Terminal-Bench v4 |
33.3% |
Utilisation d’outils de codage et de terminal |
| Agents’ Last Exam (ALE-CLI) |
29.5% |
Tâches d’agent d’utilisation d’ordinateur |
| GPQA Diamond |
93.5% |
Raisonnement et connaissances de niveau supérieur |
| HLE |
46.5% |
Questions d’expert larges et difficiles |
Il s’agit de résultats rapportés par le fournisseur. StepCodeBench est interne ; certains concurrents utilisent l’effort « Max » tandis que Step 5 utilise « High » ; et certaines comparaisons HLE avec outils utilisent des sous-ensembles différents. Les scores montrent une capacité, pas une supériorité garantie sur un dépôt particulier.
StepFun reconnaît un écart significatif sur les tâches de codage longues les plus difficiles. Testez la correction de bugs, les changements de fonctionnalités, la génération de tests et le rollback sur votre propre code, puis mesurez les tâches acceptées par dollar et par minute.
Les premières preuves communautaires sont minces. Dans un fil de lancement Linux DO, un utilisateur a apprécié le raisonnement intermédiaire visible ; la discussion Reddit s’est davantage concentrée sur les poids fuités ou mis en miroir que sur la fiabilité en production. Ces anecdotes du jour du lancement suggèrent des questions à tester, pas un classement.
Pourquoi Step 5 Preview se concentre sur la finance
Step 5 Preview dans la finance ne se contente pas de répondre à des questions comptables. StepFun cible les flux de travail des analystes qui rassemblent des dépôts réglementaires et des données de marché, réconcilient les définitions, construisent des valorisations, exécutent des calculs et produisent un rapport auditable. Les sources, hypothèses, formules et sensibilités doivent rester traçables.
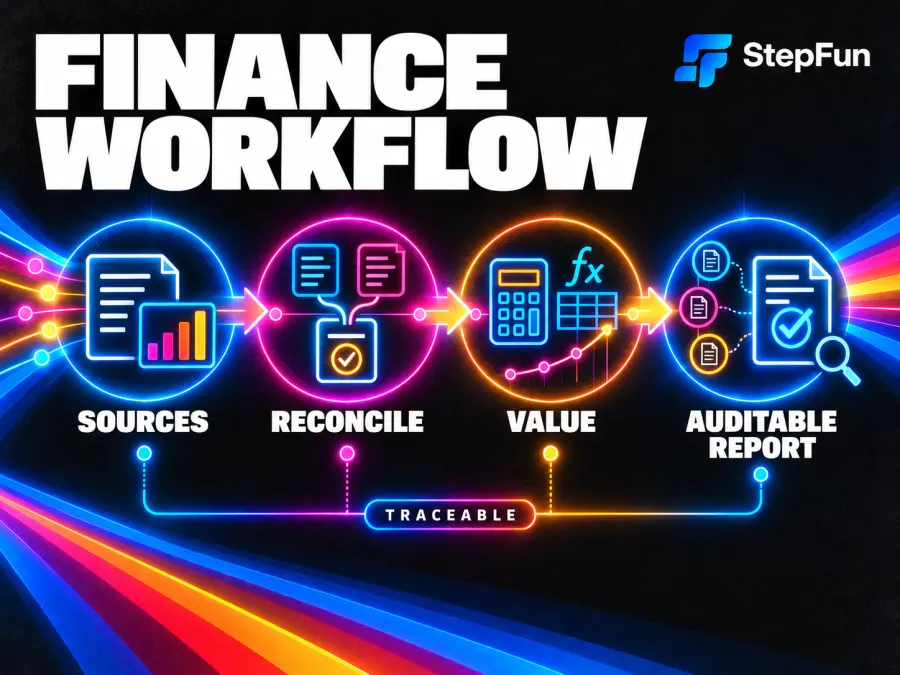
StepFun rapporte 66.4% sur le benchmark externe FrontierFinance. Il rapporte également 74.5% sur FinStepBench LiveSearch, 60.6% sur CorporateValuation et 55.8% sur Finance Deep Research. Les trois derniers sont des benchmarks internes de StepFun, ils doivent donc peser moins que des tests indépendants tant que des tiers n’ont pas reproduit les résultats.
Un score élevé ne rend pas sûres les décisions financières non supervisées. Conservez les liens sources, les traces de calcul, les points d’approbation et la revue humaine, en particulier pour les décisions d’investissement, de crédit, fiscales ou de conformité.
Quelle est la qualité de Step 5 Preview dans les tests indépendants ?
Artificial Analysis attribue à Step 5 Preview un score d’Indice d’intelligence de 44. Il a mesuré une sortie à 99.8 tokens par seconde, un temps jusqu’au premier token de 2.96 secondes et $0.72 par tâche de l’Indice d’intelligence sur l’API de StepFun.
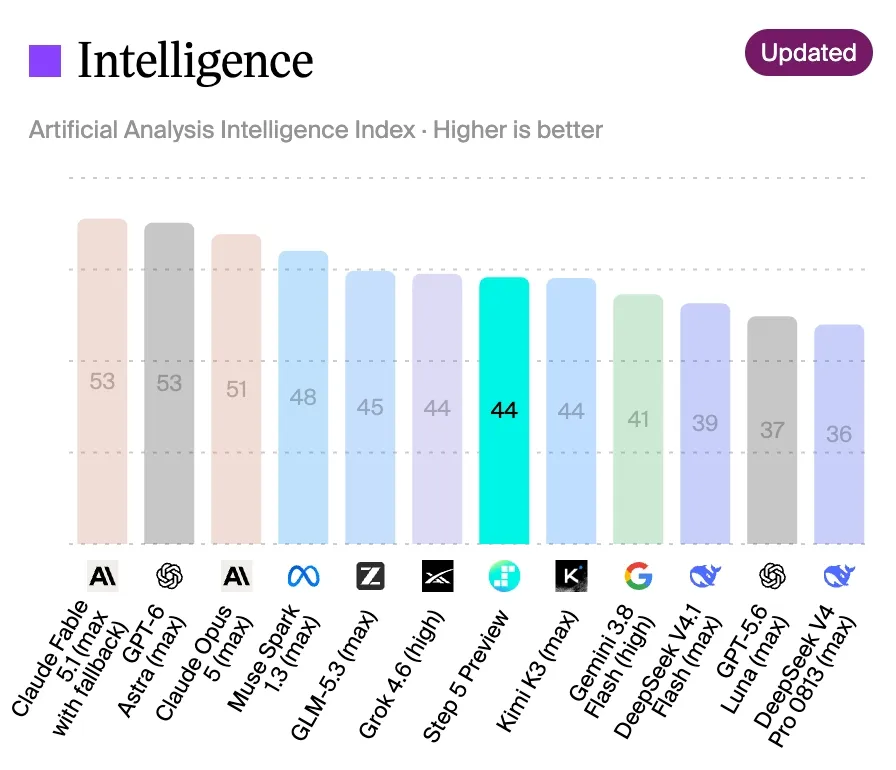
L’avertissement important est la verbosité : 160 millions de tokens de sortie sur l’ensemble de l’évaluation, contre une médiane de classe de 92 millions. Un prix raisonnable par token peut tout de même produire un coût élevé par tâche, donc les systèmes de production ont besoin de plafonds de sortie, d’un effort de raisonnement approprié et de conditions d’arrêt.
Les tests indépendants listent également les entrées texte et image, pas la vidéo. Cela reflète la portée de la fiche modèle de l’évaluateur ; la documentation officielle de l’API de StepFun reste la source pour la capacité vidéo. Garder ces deux types de preuves séparés évite de transformer une différence de couverture de test en fausse contradiction.
Explication de la tarification de Step 5 Preview
La page de tarification officielle de StepFun liste trois tarifs par million de tokens :
| Type de token |
Prix |
| Entrée non mise en cache |
$1.00 |
| Entrée mise en cache |
$0.05 |
| Sortie |
$2.70 |
Pour Step 5 Preview, la tarification des entrées en cas de défaut de cache inclut l’écriture de nouveau contenu dans le cache. La facturation des sorties inclut à la fois les tokens de raisonnement et la réponse finale, donc le raisonnement caché n’est pas gratuit.
Par exemple, 100,000 tokens d’entrée non mis en cache plus 10,000 tokens de sortie coûtent environ $0.127. Avec l’entrée entièrement mise en cache, la même requête coûte environ $0.032. Les boucles d’outils, les nouvelles tentatives et la longueur du raisonnement peuvent modifier le total.
Il s’agit du prix de StepFun, pas d’un prix GPT Proto. GPT Proto n’a pas encore ajouté le modèle, il n’existe donc aucun tarif GPT Proto légitime pour Step 5 Preview à citer.
Step 5 Preview vs GLM 5.3 Flash vs DeepSeek Flash
Ce tableau utilise les données d’Artificial Analysis en date du 21 septembre 2026. DeepSeek Flash désigne DeepSeek V4.1 Flash avec un effort de raisonnement maximal.
| Modèle |
Indice d’intelligence |
Vitesse de sortie |
Entrée / sortie par 1M de tokens |
Coût par tâche |
Contexte |
Poids |
| Step 5 Preview |
44 |
99.8 tok/s |
$1.00 / $2.70 |
$0.72 |
1M |
Prévu le 15 oct. |
| GLM 5.3 Flash |
42 |
95.0 tok/s |
$0.15 / $0.50 |
$0.25 |
1M |
Ouvert, MIT |
| DeepSeek V4.1 Flash |
39 |
242.3 tok/s |
$0.30 / $1.20 |
$0.27 |
1M |
Ouvert, MIT |
GLM 5.3 Flash vs Step 5 Preview
Step 5 Preview devance de deux points d’Indice à vitesse similaire. GLM est bien moins cher et ses poids sous licence MIT sont déjà disponibles. Step 5 est plus intéressant pour les flux de travail spécifiques à la finance ou l’entrée vidéo officielle ; GLM constitue un meilleur point de départ pour le coût et l’auto-hébergement.
Step 5 Preview vs DeepSeek Flash
Step 5 devance de cinq points d’Indice, mais DeepSeek est plus de deux fois plus rapide, coûte bien moins cher par tâche et est déjà à poids ouverts. Choisissez Step 5 uniquement si son raisonnement produit suffisamment de travail supplémentaire accepté pour justifier des exécutions plus lentes et plus coûteuses.
GPT Proto propose actuellement à la fois GLM 5.3 Flash et DeepSeek Flash. Pour une comparaison plus approfondie entre ces options disponibles, voir GLM 5.3 Flash vs DeepSeek V4 Flash.
Comment accéder à Step 5 Preview ?
Les développeurs peuvent appeler le point de terminaison POST /v1/chat/completions de StepFun avec l’ID de modèle step-5-preview. La forme de sa requête suit le style chat-completions d’OpenAI. Cet exemple cible directement StepFun ; il ne s’agit pas d’un point de terminaison GPT Proto.
curl https://api.stepfun.ai/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $STEP_API_KEY" \
  -d '{
    "model": "step-5-preview",
    "messages": [
      {
        "role": "user",
        "content": "Examinez ce plan de migration de dépôt et listez les trois hypothèses les plus risquées."
      }
    ],
    "reasoning_effort": "medium",
    "max_tokens": 1200
  }'
La référence officielle de l’API doit être consultée avant toute utilisation en production pour connaître les paramètres actuels, les erreurs, les limites de débit et les formats de requêtes multimodales.
Si vous préférez un solde unique et une interface unifiée pour de nombreux modèles, GPT Proto prévoit d’ajouter Step 5 Preview plus tard. Tant que le modèle n’apparaît pas dans le catalogue en direct, ne supposez pas qu’un nom similaire, un miroir tiers ou une route non officielle constitue l’intégration GPT Proto.
Step 5 Preview vaut-il la peine d’être essayé ?
Step 5 Preview mérite une évaluation contrôlée pour les documents longs, les agents de codage, la recherche multimodale ou les flux de travail financiers traçables. Son score d’intelligence indépendant est solide et son contexte de 1M est utile.
Ce n’est pas le choix par défaut. GLM est moins cher et à poids ouverts ; DeepSeek est bien plus rapide ; et Step 5 reste verbeux, en preview et indisponible sur GPT Proto.
La meilleure mesure de décision est le travail terminé et révisé, pas le nombre de paramètres ni un seul benchmark. Faites exécuter les mêmes tâches représentatives à chaque candidat, enregistrez l’exactitude, le taux d’intervention, la latence et le coût total en tokens, puis choisissez le modèle qui produit le coût le plus faible par résultat accepté.