Les alternatives à OpenRouter en un coup d’œil
| Plateforme |
Type de produit |
Modèle tarifaire publié |
Couverture des modalités |
Auto-hébergé |
Idéal pour |
Principal compromis |
| OpenRouter |
Passerelle de modèles gérée |
Tarifs des fournisseurs plus 5,5 % de frais d’achat de crédits |
Texte, image, vidéo, audio, PDF |
Non |
Large choix de fournisseurs et contrôles de routage détaillés |
Frais d’achat de crédits ; aucune option d’auto-hébergement |
| GPT Proto |
API d’IA tout-en-un gérée |
Paiement à l’usage ; certains modèles à tarif réduit |
Texte, image, vidéo, audio |
Non |
Accès multimodal abordable avec une seule clé et un seul solde |
Catalogue public de modèles et de fournisseurs plus restreint qu’OpenRouter |
| Requesty |
Passerelle d’IA gérée |
Modèles gratuits ou tarif du fournisseur plus 5 % de majoration |
Varie selon le modèle |
Non |
Routage géré, budgets et résidence des données dans l’UE |
Majoration de 5 % sur l’utilisation de modèles payants |
| Portkey |
Plateforme de passerelle et d’observabilité |
Forfait développeur gratuit ; Production à partir de 49 $/mois |
Dépend du fournisseur |
Disponible |
Journaux, traces, garde-fous et gouvernance d’équipe |
Ajoute une couche de gestion plutôt qu’un accès à prix réduit aux modèles |
| LiteLLM |
SDK et proxy open source |
Logiciel open source ; infrastructure et utilisation des fournisseurs séparées |
Dépend du fournisseur |
Oui |
Équipes qui souhaitent contrôler leur infrastructure |
Vous exploitez la passerelle et gérez les comptes fournisseurs |
| Vercel AI Gateway |
Passerelle d’IA gérée |
Tarifs catalogue des fournisseurs, sans majoration des tokens |
Texte, image, vidéo, audio |
Non |
Projets Vercel et AI SDK |
Moins différenciée en dehors de son écosystème principal |
| Bifrost |
Passerelle d’IA open source |
Logiciel open source ; infrastructure et utilisation des fournisseurs séparées |
Texte, image, audio, streaming |
Oui |
Routage auto-hébergé et contrôle de la passerelle |
Nécessite un déploiement et une exploitation continus |
| Eden AI |
API d’IA multi-services gérée |
Tarifs des fournisseurs plus 5,5 % de frais de plateforme au paiement |
IA générative, OCR, parole, traduction, vision |
Déploiements privés avec des forfaits personnalisés |
Services d’IA d’entreprise plus étendus |
Frais de plateforme et périmètre produit plus large et plus complexe |
Le tableau met en évidence un problème propre à de nombreuses listes d’alternatives : ces produits ne sont pas interchangeables. GPT Proto et OpenRouter vendent un accès géré aux modèles. Portkey ajoute des contrôles et de l’observabilité autour du trafic de production. LiteLLM et Bifrost sont des logiciels que vous exploitez vous-même. Eden AI va au-delà des modèles génératifs pour proposer des services tels que l’OCR et la traduction. Les comparer sans nommer ces catégories produit un tableau élégant, mais conduit à une mauvaise décision.
Pourquoi chercher une alternative à OpenRouter ?
OpenRouter répertorie actuellement plus de 400 modèles provenant de plus de 70 fournisseurs. La plateforme permet également aux développeurs de définir l’ordre des fournisseurs, de limiter les fournisseurs autorisés, d’exiger la prise en charge de certains paramètres et de désactiver le basculement automatique. Sa documentation multimodale couvre la génération d’images, un point de terminaison vidéo asynchrone, la génération vocale, la transcription, les PDF, la compréhension des images et la compréhension des vidéos.
Ce sont des faits. Un article honnête sur les alternatives ne devrait donc pas prétendre qu’OpenRouter ne prend pas en charge le multimodal ou les contrôles des fournisseurs.
Il existe néanmoins de bonnes raisons de chercher ailleurs.
La première concerne la facturation. OpenRouter répercute les prix d’inférence sous-jacents sans majoration, mais facture 5,5 % lors de l’achat de crédits, avec des frais minimums de 0,80 $. Une autre plateforme peut appliquer une majoration par requête, des frais logiciels mensuels, un tarif réduit pour les modèles ou aucun frais de passerelle. La réponse la moins chère dépend donc à la fois du modèle sélectionné et du mécanisme de facturation de la plateforme.
La deuxième concerne le déploiement. Une passerelle gérée élimine le travail d’infrastructure, mais certaines équipes ne peuvent pas faire transiter leur trafic par un service tiers. LiteLLM et Bifrost répondent à ce besoin en permettant à l’équipe d’exécuter sa propre passerelle. Le coût est déplacé plutôt que supprimé : le logiciel peut être open source, mais les serveurs, les mises à niveau, la surveillance et la gestion des incidents restent à la charge de l’équipe.
La troisième concerne l’orientation du produit. Une équipe a besoin d’un routage au niveau des fournisseurs. Une autre a besoin de journaux d’audit et de garde-fous. Un petit studio peut davantage se soucier de partager un même solde entre la génération de texte, d’images, de vidéos et d’audio. Un créateur qui ne code pas voudra peut-être tester une idée dans un navigateur avant de l’automatiser via une API.
C’est là que se situe la véritable ligne de démarcation. La question n’est pas : « Quelle plateforme propose des modèles d’IA ? » Elles le font toutes. La question est de savoir ce qui entoure ces modèles.
Comment nous avons choisi ces alternatives
J’ai évalué les plateformes selon six dimensions pratiques :
La manière dont la plateforme facture : remises sur les modèles, frais d’achat de crédits, majorations d’utilisation, abonnements ou coûts d’auto-hébergement.
La couverture du texte uniquement ou son extension aux tâches d’image, de vidéo et d’audio.
La possibilité pour un seul compte, une seule clé API et un seul solde de couvrir plusieurs fournisseurs ou modalités.
Le niveau de contrôle du routage, du basculement automatique, du budget, de la journalisation et de la gouvernance.
Le caractère géré ou auto-hébergé de la plateforme.
La partie qui assume la charge opérationnelle en cas de panne.
Je n’ai pas classé ces plateformes selon les affirmations de latence publiées par les fournisseurs. Ces chiffres sont rarement mesurés avec la même charge de travail, la même région, le même modèle, le même niveau de concurrence ou les mêmes conditions de panne. Affirmer qu’une passerelle ajoute quelques microsecondes ne dit pas grand-chose sur le temps total d’une requête de modèle qui peut prendre plusieurs secondes.
L’ordre est donc éditorial et non le résultat d’un score de benchmark synthétique. Chaque produit est classé pour un cas d’usage défini, et chaque recommandation inclut son coût.
1. GPT Proto — Meilleure API d’IA tout-en-un abordable
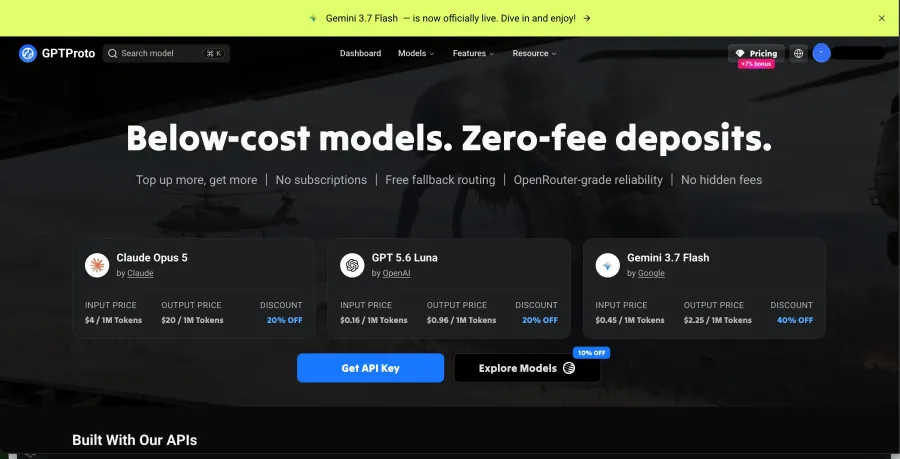
GPT Proto est la meilleure alternative à OpenRouter de cette liste pour les utilisateurs qui souhaitent un solde prépayé et une clé API uniques pour accéder à des modèles de texte, d’image, de vidéo et d’audio. Sa galerie de modèles d’IA actuelle répertorie plus de 200 modèles, notamment des LLM, des générateurs d’images, des générateurs de vidéos, des modèles multimodaux et des modèles de synthèse vocale.
La principale différence est économique plutôt qu’architecturale. GPT Proto publie des tarifs réduits pour certains modèles au lieu d’appliquer la même règle à toutes les références. Au 17 août 2026, par exemple, son API GLM-5.2 était proposée à 1,26 $ par million de tokens d’entrée et 3,96 $ par million de tokens de sortie, soit 10 % de moins que les tarifs de référence de Z.ai, de 1,40 $ et 4,40 $. D’autres références du catalogue bénéficiaient de remises différentes. Cette formulation est importante : certains modèles sont moins chers, mais affirmer que « chaque modèle est toujours le moins cher » serait une promesse infondée.
GPT Proto permet également à des clés API distinctes de comporter une limite de montant, une période de limitation et une liste de modèles autorisés. Un freelance peut isoler l’utilisation d’un client. Une petite équipe peut empêcher une application expérimentale de consommer l’intégralité du solde du compte. Les requêtes échouées recréditent immédiatement le solde débité, ce qui protège le budget, même s’il ne faut pas confondre un remboursement avec un basculement automatique vers un autre fournisseur.
L’API reste le produit principal. L’espace dédié aux créateurs vient ensuite, mais il est utile. Il est possible de générer une image dans l’espace de travail d’images accessible depuis un navigateur, de tester un concept vidéo dans l’espace de travail vidéo, ou de poursuivre la retouche dans Canvas avant de transformer le processus en flux de travail via API. Les galeries de prompts et de fonctionnalités offrent des points de départ lorsque le problème n’est pas l’intégration, mais la page blanche.
Ce pont est particulièrement pertinent pour les non-développeurs, les professionnels du marketing et les petits studios. Ils peuvent valider les résultats d’un modèle avant de payer quelqu’un pour les automatiser. Les développeurs bénéficient toujours de l’API unifiée ; les créateurs disposent d’un accès visuel au même écosystème de modèles.
Le compromis concerne la taille du catalogue et la profondeur du routage. GPT Proto publie une collection de modèles plus réduite qu’OpenRouter et ne documente pas publiquement le même niveau de contrôle de l’ordre des fournisseurs et du basculement automatique. Je choisirais GPT Proto lorsque l’accès multimodal partagé, les références à prix réduit et la simplicité des budgets de projet comptent davantage que la configuration maximale au niveau des fournisseurs. Je ne le choisirais pas uniquement pour obtenir davantage de contrôles de routage qu’OpenRouter.
Idéal pour : les développeurs, les petites équipes, les studios et les créateurs non développeurs qui souhaitent accéder à des modèles multimodaux abordables sans comptes fournisseurs ni abonnements distincts.
2. Requesty — Idéal pour le routage géré et les politiques budgétaires
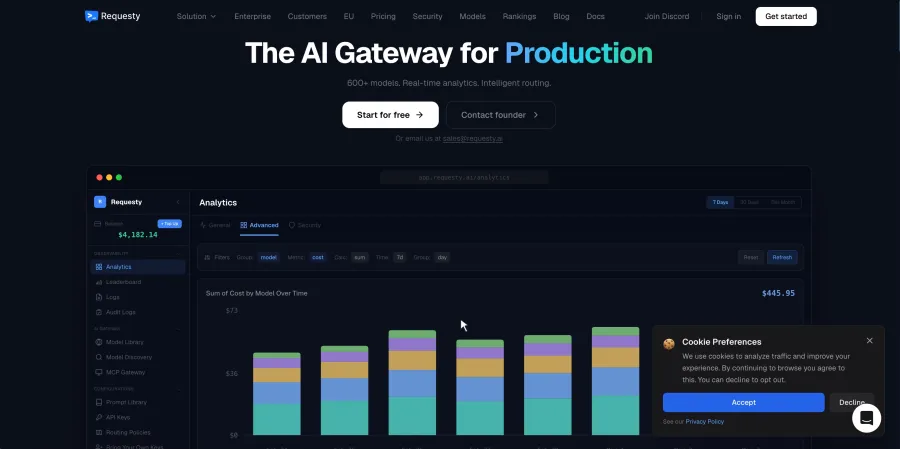
Requesty est plus proche du rôle de passerelle d’OpenRouter que la plupart des produits de cette liste. Son forfait à l’usage annonce plus de 600 modèles provenant de plus de 20 fournisseurs, ainsi que la prise en charge de vos propres clés, des politiques de routage, un basculement automatique, l’équilibrage de charge, la mise en cache des prompts, des limites de dépenses et de l’observabilité.
Sa tarification est facile à calculer. Requesty ajoute une majoration de 5 % au coût de base du modèle. Si un fournisseur facture 10 $ pour une quantité d’utilisation donnée, le prix indicatif de Requesty est de 10,50 $. Ce forfait ne comporte ni abonnement, ni frais par utilisateur, ni dépense minimale. L’offre gratuite permet jusqu’à 200 requêtes par jour sur des modèles gratuits, sans carte bancaire requise.
Cette structure convient à une équipe qui souhaite bénéficier d’un routage géré et de règles budgétaires sans exploiter LiteLLM ou Bifrost. La résidence des données dans l’UE est également incluse dans les forfaits publiés, tandis que les clients professionnels peuvent ajouter le SSO, le RBAC, les journaux d’audit, les politiques de modèles approuvés et des SLA personnalisés.
Le coût est la majoration. Cinq pour cent semble peu sur un prototype, mais devient visible à grande échelle. Requesty peut tout de même faire gagner du temps d’ingénierie, mais cela ne revient pas à affirmer qu’il s’agit du moyen le moins cher d’acheter de l’inférence.
Idéal pour : les équipes qui souhaitent une passerelle gérée avec des politiques de routage explicites, des plafonds budgétaires et une résidence des données en Europe.
3. Portkey — Idéal pour l’observabilité en production
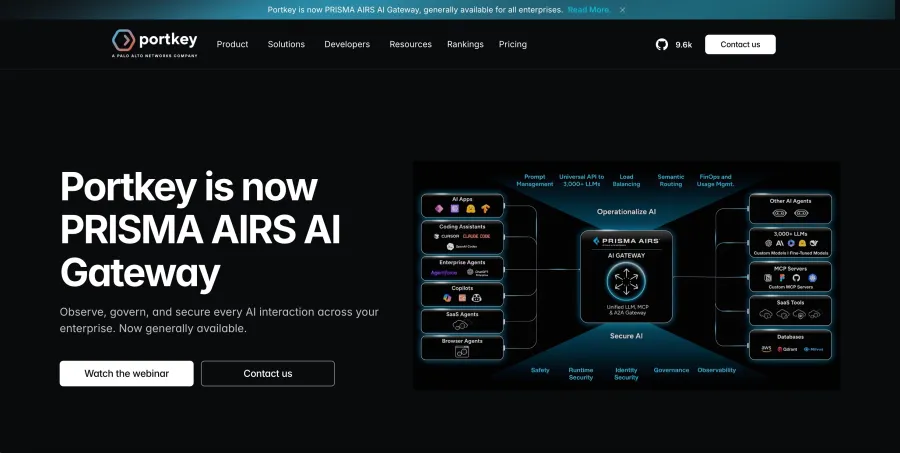
Portkey ne cherche pas tant à trouver un modèle moins cher qu’à comprendre ce qui se passe lorsqu’une application commence à recevoir du trafic réel. Sa passerelle inclut des mécanismes de basculement, l’équilibrage de charge, les nouvelles tentatives, la mise en cache et une API universelle. Sa couche d’observabilité ajoute des journaux, des traces, des retours, des métadonnées, des filtres et des alertes. Les garde-fous et le versionnage des prompts se trouvent dans le même plan de contrôle.
L’offre gratuite Developer comprend 10 000 journaux enregistrés par mois, avec une conservation des journaux de trois jours et des métriques de 30 jours. L’offre Production publiée coûte 49 $ par mois, inclut 100 000 journaux enregistrés et facture 9 $ pour chaque tranche supplémentaire de 100 000 journaux jusqu’à la limite indiquée. La conservation des journaux en Production passe à 30 jours, tandis que les métriques restent disponibles pendant 90 jours.
Cette tarification est pertinente lorsque le temps consacré au débogage et la traçabilité ont une valeur monétaire. Si un bot de support change silencieusement de modèle, si une modification de prompt provoque des échecs ou si un client entraîne une hausse inattendue des coûts, les traces et les métadonnées permettent d’en comprendre la cause. Un tarif d’inférence bas ne peut pas remplacer ces éléments.
Le compromis concerne le périmètre. Portkey ajoute une couche opérationnelle ; il ne s’agit pas principalement d’une place de marché de modèles à solde partagé et à prix réduit. Un petit utilisateur qui souhaite seulement appeler deux modèles peut donc payer pour des contrôles dont il n’a pas encore besoin.
Idéal pour : les équipes d’IA en production qui ont besoin de journaux, de traces, de gestion des prompts, de garde-fous et de contrôles basés sur les rôles.
4. LiteLLM — Meilleure alternative open source
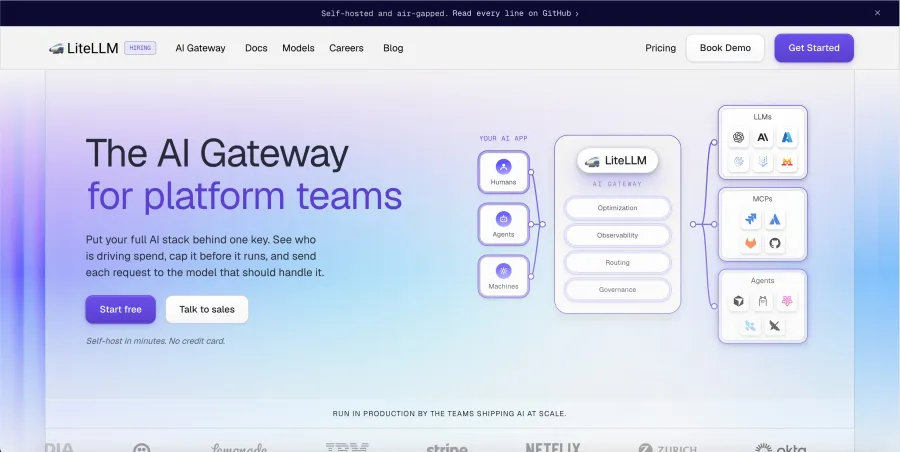
LiteLLM est une passerelle d’IA open source et un SDK Python qui exposent une interface unifiée pour plus de 100 fournisseurs de LLM. Les équipes peuvent importer directement le SDK dans une application ou déployer le proxy comme passerelle centrale. Il prend en charge les requêtes au format OpenAI ainsi que le suivi des coûts, les clés virtuelles, l’équilibrage de charge, la journalisation et les garde-fous.
L’intérêt principal est le contrôle. Les clés des fournisseurs restent au sein de l’infrastructure gérée par l’équipe. Les services internes peuvent appeler une seule passerelle plutôt que de maintenir des intégrations distinctes pour OpenAI, Anthropic, Bedrock, Vertex AI et d’autres fournisseurs. Les politiques et les budgets peuvent être gérés de manière centralisée.
Mais « open source » n’est pas synonyme d’« IA gratuite ». Les fournisseurs de modèles facturent toujours l’inférence. Le proxy doit être exécuté quelque part. Quelqu’un doit configurer les secrets, mettre à niveau les versions, surveiller les journaux, corriger les problèmes de sécurité et intervenir lorsqu’un fournisseur modifie un point de terminaison. Cela peut être un compromis raisonnable pour une équipe plateforme et un mauvais choix pour un créateur indépendant.
LiteLLM diffère également fondamentalement de GPT Proto. GPT Proto fournit à l’utilisateur un solde géré et un accès aux modèles. LiteLLM fournit un logiciel permettant de connecter des comptes fournisseurs que l’utilisateur contrôle déjà. Ces solutions répondent à des problèmes connexes, mais pas identiques.
Idéal pour : les équipes d’ingénierie qui souhaitent une passerelle autogérée et disposent déjà des ressources nécessaires pour l’exploiter.
5. Vercel AI Gateway — Idéal pour les utilisateurs de Vercel et d’AI SDK
Vercel AI Gateway regroupe le routage, la facturation et l’observabilité derrière une seule clé API. Son catalogue publié couvre les modèles de texte, d’image, de vidéo et d’audio, et les intégrations existantes compatibles avec OpenAI peuvent généralement être transférées en modifiant l’URL de base et les identifiants. Le basculement automatique est inclus en cas de panne d’un fournisseur.
La tarification constitue un point fort de l’offre. Vercel indique appliquer une majoration de zéro token, y compris lorsque les clients utilisent leurs propres clés fournisseurs. Chaque équipe Vercel peut recevoir 5 $ de crédits mensuels AI Gateway avec l’offre gratuite. Une fois que l’équipe achète des crédits payants, elle passe au paiement à l’usage et ne reçoit plus cette allocation récurrente de 5 $. Des frais de traitement des paiements peuvent toujours s’appliquer.
Pour une application Next.js qui utilise déjà l’AI SDK, cela réduit les frictions d’intégration. Les appels aux modèles, le suivi des dépenses et le déploiement restent proches du reste de la pile applicative. L’avantage est concret au sein de cet écosystème.
En dehors de cet écosystème, la décision est moins évidente. La passerelle fonctionne toujours avec les clients compatibles OpenAI, mais l’intégration Vercel environnante offre moins d’avantages à une équipe qui déploie ailleurs. L’absence de majoration est attrayante ; elle ne suffit pas à elle seule pour justifier la migration d’une pile existante qui n’utilise pas Vercel.
Idéal pour : les équipes qui développent avec Vercel, Next.js ou l’AI SDK et souhaitent une facturation unifiée et un basculement automatique sans majoration des tokens.
6. Bifrost — Meilleure passerelle auto-hébergée pour davantage de contrôle
Bifrost est une passerelle open source sous licence Apache 2.0 qui connecte plus de 23 fournisseurs via une interface unique compatible avec OpenAI. Ses fonctionnalités documentées incluent le basculement automatique, l’équilibrage de charge entre fournisseurs et clés, la mise en cache sémantique, la prise en charge de MCP et la gestion multimodale du texte, des images, de l’audio et du streaming.
Comme LiteLLM, Bifrost est surtout pertinent lorsque l’équipe souhaite exploiter sa propre passerelle. Il peut être installé dans l’environnement de l’entreprise, utiliser les comptes fournisseurs existants et centraliser l’accès aux modèles sans acheter de crédits d’inférence auprès d’une autre place de marché.
Bifrost publie des affirmations de performance ambitieuses. Je les considérerais comme des benchmarks du fournisseur jusqu’à ce qu’elles soient reproduites avec le même schéma de trafic, le même matériel, la même configuration et les mêmes paramètres de journalisation que l’application prévue. La surcharge de la passerelle ne constitue qu’une partie du temps de requête ; le modèle en amont domine généralement l’expérience.
Le compromis pratique est la responsabilité opérationnelle. L’installation peut être rapide, mais la maintenance en production ne s’arrête pas après la réussite de la première commande. L’équipe est responsable de la planification des capacités, de la disponibilité, des secrets, de l’observabilité et des mises à niveau.
Idéal pour : les équipes qui souhaitent une passerelle open source et auto-hébergée avec routage, mise en cache et prise en charge multimodale.
7. Eden AI — Idéal pour des services d’IA d’entreprise plus étendus
Eden AI couvre un périmètre plus large qu’un routeur de modèles génératifs. Son catalogue comprend plus de 500 modèles et services couvrant les modèles de langage, l’OCR, la parole, la traduction, la vision par ordinateur et d’autres tâches d’IA. Les utilisateurs peuvent créer plusieurs clés API, comparer les fournisseurs et surveiller les coûts et les performances depuis une seule plateforme.
L’AI API Gateway en libre-service applique des frais de plateforme de 5,5 % lors de l’achat de crédits. Eden AI précise que les prix des modèles de son catalogue reflètent ceux des fournisseurs et n’incluent pas de majoration d’inférence. Les forfaits avancés ajoutent une tarification personnalisée, des limites de débit plus élevées, des déploiements privés, des dispositifs de conformité, un support dédié et des SLA.
Cette étendue est utile lorsqu’une application doit extraire du texte de factures, le traduire, classer le contenu, puis en envoyer une partie à un LLM. Un routeur de modèles spécialisé peut couvrir la dernière étape, mais pas l’ensemble de la séquence.
Cette étendue ajoute aussi de la complexité. Si la tâche consiste simplement à « appeler trois modèles conversationnels avec une seule clé », une plateforme multi-services orientée entreprise peut proposer davantage de fonctionnalités que nécessaire. Les frais de 5,5 % doivent également être inclus dans toute comparaison de coûts.
Idéal pour : les organisations qui associent l’IA générative à l’OCR, la parole, la traduction, la vision et des exigences de déploiement d’entreprise.
Dans quels domaines OpenRouter reste meilleur
Une liste d’alternatives devient publicitaire lorsqu’elle refuse d’indiquer les domaines dans lesquels le produit d’origine est supérieur. OpenRouter conserve plusieurs avantages évidents.
Premièrement, son catalogue public est plus vaste que celui de GPT Proto : plus de 400 modèles et plus de 70 fournisseurs contre plus de 200 modèles pour GPT Proto. Les chiffres évoluent, mais la différence est suffisamment importante pour les développeurs qui comparent régulièrement plusieurs fournisseurs pour un même modèle.
Deuxièmement, OpenRouter documente en détail le routage des fournisseurs. Une requête peut inclure une liste de fournisseurs ordonnée, limiter les fournisseurs autorisés, exiger la prise en charge complète des paramètres, cibler un point de terminaison précis ou désactiver le basculement automatique. Les utilisateurs de GPT Proto peuvent choisir des modèles et appliquer des budgets au niveau des clés, mais la surface de contrôle des fournisseurs documentée publiquement est moins étendue.
Troisièmement, OpenRouter dispose de contrôles publics matures concernant l’activité, les exports, les budgets, les politiques de données et le routage sans conservation des données. La plateforme n’enregistre pas les prompts et les complétions par défaut, même si la politique du fournisseur en amont sélectionné reste déterminante.
Mon avis est simple : restez sur OpenRouter si l’étendue des fournisseurs et la précision du routage sont prioritaires. Envisagez GPT Proto lorsqu’un catalogue plus restreint mais toujours vaste, des modèles à prix réduit, une facturation multimodale partagée et des outils destinés aux créateurs correspondent mieux au flux de travail réel.
GPT Proto n’est pas une mise à niveau universelle par rapport à OpenRouter. Il répond à un besoin différent.
Quelle alternative à OpenRouter devriez-vous choisir ?
| Si vous avez besoin de… |
Choisissez |
| Modèles de texte, d’image, de vidéo et d’audio abordables partageant un même solde |
GPT Proto |
| Politiques de routage gérées, plafonds budgétaires et catalogue plus vaste |
Requesty |
| Journaux de production, traces, gestion des prompts et garde-fous |
Portkey |
| Une passerelle open source basée sur Python que vous contrôlez |
LiteLLM |
| Intégration native à Vercel et à l’AI SDK, sans majoration des tokens |
Vercel AI Gateway |
| Une passerelle open source axée sur le routage et la mise en cache auto-hébergés |
Bifrost |
| OCR, traduction, parole, vision et services d’IA d’entreprise |
Eden AI |
| Choix maximal de fournisseurs publics et contrôle de leur ordre |
OpenRouter |
Pour un créateur indépendant ou un petit studio, je commencerais par le modèle de facturation plutôt que par la liste de fonctionnalités la plus longue. Si un seul solde doit couvrir un chatbot, des images de produit, une sortie vocale et de courtes vidéos, GPT Proto élimine plusieurs comptes distincts. Si l’application est déjà en production et que le problème concerne le débogage plutôt que l’accès aux modèles, Portkey est la réponse la plus pertinente. Si la politique de l’organisation exige l’auto-hébergement, les services gérés ne sont plus les vrais candidats ; comparez LiteLLM et Bifrost.
Comment passer d’OpenRouter à GPT Proto
La migration la plus sûre consiste à transférer un modèle et un flux de travail non critique à la fois. Ne modifiez pas tous les identifiants de modèle un vendredi après-midi en appelant cela un plan de déploiement.
1. Trouvez le modèle équivalent
Recherchez dans la galerie de modèles GPT Proto le modèle actuellement utilisé via OpenRouter. Consultez la page du modèle en ligne pour vérifier les modalités d’entrée et de sortie prises en charge. Les capacités du modèle en amont et la route exposée par une plateforme d’API ne sont pas toujours identiques.
Par exemple, la page GPT Proto consacrée à GLM-5.2 indique actuellement une entrée de texte, d’image et de document, avec une sortie textuelle. La chaîne de modèle de son API est glm-5.2.
2. Créez une clé API distincte
Créez une clé pour la migration plutôt que de réutiliser une clé générale du compte. Appliquez une limite de montant, sélectionnez une période de limitation et restreignez les modèles autorisés lorsque le projet n’en nécessite qu’un petit sous-ensemble. Cela réduit le coût d’une erreur de configuration.
3. Modifiez le point de terminaison, la clé et l’identifiant du modèle
La documentation actuelle de GPT Proto pour GLM-5.2 utilise la requête suivante :
curl --request POST "https://gptproto.com/v1/chat/completions" \
  --header "Authorization: Bearer $GPTPROTO_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "glm-5.2",
    "messages": [
      {
        "role": "user",
        "content": "Résumez les trois principaux risques de ce plan de déploiement."
      }
    ]
  }'
Il s’agit d’un exemple d’intégration basé sur la documentation, et non de l’affirmation selon laquelle le corps de chaque requête OpenRouter peut être copié tel quel. Les appels d’outils, les sorties structurées, les paramètres propres aux fournisseurs et le contenu multimodal doivent être vérifiés sur la page du modèle GPT Proto sélectionné.
4. Traitez la génération de médias comme un flux de travail asynchrone
Une conversation textuelle renvoie souvent une réponse dans la requête d’origine. La génération d’images et de vidéos peut plutôt utiliser la création d’une tâche, l’interrogation de son état, puis une URL finale vers le fichier. GPT Proto prend en charge les tâches asynchrones d’image et de vidéo, l’interrogation de leur état et les webhooks, mais le point de terminaison et la charge utile exacts dépendent du modèle.
Ne forcez pas un flux vidéo à passer par un exemple de conversation textuelle simplement parce que les deux produits utilisent une seule clé.
5. Vérifiez la facture avant d’augmenter le trafic
Exécutez un petit lot contrôlé et notez :
l’identifiant du modèle ;
le type de tâche ;
la taille des entrées et des sorties ;
le statut renvoyé ;
le nombre de requêtes échouées ;
le solde avant et après le lot ;
le comportement des remboursements pour les requêtes échouées ;
la conformité du format de sortie avec l’analyseur syntaxique de l’application.
Cet article ne présente pas ces valeurs comme un benchmark, car nous n’avons pas exécuté cette charge de travail. La liste de contrôle est fournie afin que le lecteur puisse valider les éléments qui dépendent de sa propre application.
Verdict final
Choisissez GPT Proto lorsque la priorité est un accès tout-en-un abordable aux modèles de texte, d’image, de vidéo et d’audio. Une clé, un solde, des remises sur certains modèles, des limites au niveau des clés et des espaces de travail destinés aux créateurs en font un pont pratique entre l’expérimentation et l’utilisation d’une API.
Choisissez Requesty lorsque le routage géré et les politiques budgétaires comptent davantage que l’absence de majoration. Choisissez Portkey lorsque l’application reçoit déjà du trafic et nécessite de meilleures informations sur les échecs, les coûts et les prompts. Choisissez LiteLLM ou Bifrost lorsque la passerelle doit s’exécuter au sein d’une infrastructure que vous contrôlez. Choisissez Vercel AI Gateway pour une application centrée sur Vercel, et Eden AI lorsque le flux de travail s’étend à l’OCR, la parole, la traduction et la vision par ordinateur.
Restez sur OpenRouter lorsque l’étendue de ses fournisseurs et ses contrôles de routage correspondent au problème. Changer de plateforme n’est pas l’objectif. Il s’agit de supprimer la mauvaise contrainte.
Découvrez plus de 200 modèles d’IA avec une seule clé API GPT Proto.