Que devrait réellement remplacer une alternative à l’API Venice ?
Une comparaison utile commence par les vrais différenciateurs de Venice, pas par une liste générique de fonctionnalités.
Venice expose plus de 350 modèles de texte, d’image, de vidéo et d’audio via une seule clé. Son API est largement compatible avec les clients OpenAI, tandis que quatre modes de confidentialité — Anonymous, Private, environnement d’exécution de confiance (TEE) et chiffrement de bout en bout (E2EE) — la distinguent. Elle prend également en charge les crédits prépayés, une allocation quotidienne DIEM et les paiements x402 en USDC.
Ces atouts ont des limites. TEE et E2EE ne prennent actuellement en charge que le texte, et E2EE désactive les fonctions qui nécessitent du texte en clair, notamment la recherche web, la mémoire, les résumés et certains outils. Venice peut ajouter son prompt système sauf si cela est désactivé, et les fenêtres de dépréciation des modèles peuvent ne durer que 7 à 15 jours.
J’ai évalué chaque concurrent de l’API Venice selon six questions :
Couverture : Quels modèles de texte, d’image, de vidéo et d’audio sont disponibles ?
Compatibilité : Un client OpenAI peut-il se connecter en changeant l’URL de base et le nom du modèle ?
Confidentialité : La protection est-elle contractuelle, technique ou dépendante du fournisseur ?
Opérations : Comment les files d’attente, les nouvelles tentatives, les démarrages à froid, les limites et les mises hors service sont-ils gérés ?
Personnalisation : Le fine-tuning, les adaptateurs, les modèles personnalisés ou l’auto-hébergement sont-ils disponibles ?
Coût : Quels frais ou coûts d’infrastructure s’ajoutent au tarif indiqué ?
Aucune alternative ne gagne sur les six points. Le meilleur choix dépend de l’avantage de Venice qui est essentiel et de celui qui n’est que pratique.
Meilleures alternatives à l’API Venice : comparaison rapide
| Rang |
Alternative |
Idéal pour |
Modalités |
Voie compatible OpenAI |
Compromis principal |
| 1 |
GPT Proto |
Accès multimodal abordable |
Texte, image, vidéo, audio |
Oui |
Ne revendique pas la confidentialité TEE ou E2EE de style Venice |
| 2 |
OpenRouter |
Routage LLM et repli entre fournisseurs |
Principalement texte et vision |
Oui |
La confidentialité et la disponibilité varient selon le fournisseur routé |
| 3 |
Together AI |
Modèles à poids ouverts et fine-tuning |
Texte, image, vidéo, audio |
Oui, sur plusieurs endpoints |
Moins utile pour un large accès aux modèles fermés |
| 4 |
Fireworks AI |
Inférence de modèles ouverts en production |
Principalement du texte et des modèles ouverts multimodaux |
API de style OpenAI et Anthropic |
Plus axé sur l’infrastructure que sur le catalogue |
| 5 |
fal |
Applications d’image et de vidéo |
Image, vidéo, audio, 3D |
Pas une API de chat prête à l’emploi |
Les schémas spécifiques aux modèles nécessitent du code de workflow |
| 6 |
Replicate |
Expérimentations avec modèles communautaires et personnalisés |
Texte, image, vidéo, audio |
Non |
Démarrages à froid et intégration propre aux prédictions |
| 7 |
vLLM |
Confidentialité et contrôle auto-hébergés |
Principalement des modèles de langage et d’embedding |
Oui |
Vous possédez les GPU, la sécurité, la mise à l’échelle et les opérations |
1. GPT Proto — Meilleure alternative globale et abordable à l’API Venice
GPT Proto est la correspondance la plus proche pour les développeurs qui utilisent Venice comme passerelle unique. Il propose plus de 200 modèles de texte, d’image, de vidéo et d’audio. Son URL de base compatible OpenAI signifie que de nombreuses intégrations de chat n’ont besoin que d’une nouvelle clé, d’une URL et d’un identifiant de modèle.
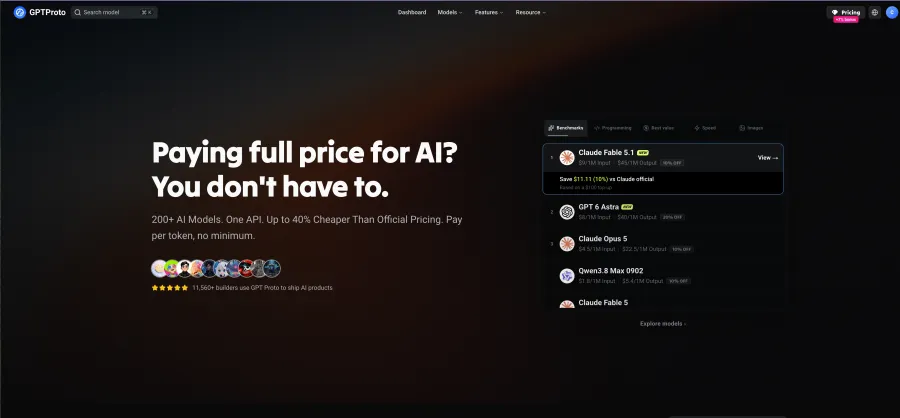
Le catalogue comprend des options d’image et de vidéo issues de familles de modèles chinois, utiles pour comparer la qualité visuelle et le rapport prix-performance au-delà des fournisseurs américains habituels.
GPT Proto applique des remises sur les tarifs officiels des modèles et utilise une facturation à l’usage sans minimum. Un exemple actuel avec GLM-5.3 :
| Plateforme |
Entrée pour 1M de tokens |
Sortie pour 1M de tokens |
| GPT Proto |
$1.26 |
$3.96 |
| Together AI |
$1.40 |
$4.40 |
| API Venice |
$1.75 |
$5.50 |
Pour 100 millions de tokens en entrée et 20 millions en sortie, ces tarifs impliquent 205,20 $ sur GPT Proto, 228 $ sur Together AI et 285 $ sur Venice. Cela dépend du modèle ; recalculez selon votre propre mélange.
GPT Proto n’est pas un remplacement équivalent en matière de confidentialité. Il ne met pas en avant la conception à quatre modes de Venice ni les voies TEE et E2EE limitées au texte. Si une séparation cryptographique est requise, un coût inférieur ne remplace pas ces garanties.
Idéal pour : Les produits SaaS, les agents IA, les outils internes et les applications multimodales qui veulent un large choix de modèles et une tarification d’usage prévisible.
Pourquoi il arrive en tête : Il combine une clé, de nombreux modèles, des requêtes familières et une économie solide.
Explorez la passerelle de modèles de GPT Proto si le coût et la couverture multimodale sont vos principaux critères de sélection.
2. OpenRouter — Idéal pour le routage LLM et les replis
OpenRouter est une alternative solide à l’API Venice lorsque votre problème principal est un routage résilient des modèles de langage. Il peut router les requêtes entre plusieurs fournisseurs, appliquer des replis et permettre aux équipes d’apporter leurs propres clés de fournisseur. Son interface compatible OpenAI le rend accessible aux applications qui utilisent déjà le SDK OpenAI.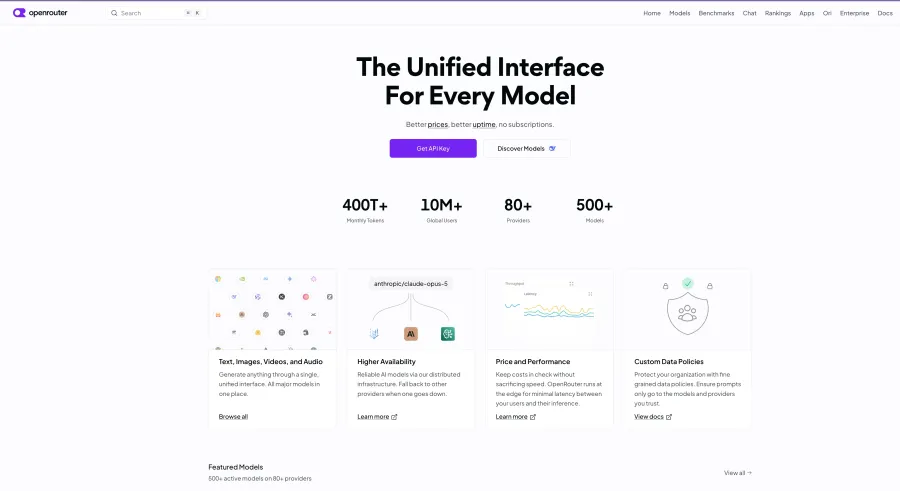
Le routage est aussi la complication. La confidentialité, la conservation, le traitement régional et la disponibilité varient selon le fournisseur. Les équipes de production doivent épingler les routes autorisées et vérifier la politique de chaque fournisseur.
Les achats de crédits entraînent des frais de 5,5 % avec un minimum de 0,80 $, donc le coût effectif ne se limite pas au tarif d’inférence affiché.
Il est moins convaincant pour les produits d’image ou de vidéo, car il s’agit principalement d’une place de marché de routage de modèles de langage.
Idéal pour : Les équipes qui ont besoin d’un accès LLM multi-fournisseurs, de replis automatiques et de contrôles de routage.
Choisissez-le plutôt que GPT Proto lorsque : La sélection des fournisseurs et la logique de basculement comptent plus qu’un large catalogue média ou le coût effectif le plus bas de la passerelle.
3. Together AI — Idéal pour les modèles ouverts et le fine-tuning
Together AI convient aux équipes qui construisent autour de modèles à poids ouverts. Il propose plus de 100 modèles serverless et des API pour le chat, la vision, les images, la parole, les embeddings et d’autres charges de travail, avec des schémas de style OpenAI sur de nombreux endpoints.
Les équipes peuvent fine-tuner des modèles, entraîner des adaptateurs LoRA et les exécuter sur la même plateforme. L’inférence par lots peut réduire les coûts éligibles jusqu’à 50 % pour l’évaluation hors ligne, l’étiquetage, le résumé ou les rattrapages.
Ce n’est pas une passerelle neutre vers tous les grands modèles fermés. Choisissez sa profondeur de personnalisation lorsque vous prévoyez de construire sur des familles telles que Llama, Qwen ou DeepSeek.
Idéal pour : Les produits basés sur des modèles ouverts, les programmes de fine-tuning, les pipelines d’évaluation et l’inférence par lots.
À surveiller : Les différences au niveau des endpoints. « Compatible OpenAI » ne garantit pas encore que chaque champ, séquence d’appel d’outil ou événement de streaming se comporte de manière identique.
4. Fireworks AI — Idéal pour l’inférence de modèles ouverts en production
Fireworks AI sert plus de 100 modèles ouverts via des déploiements serverless, dédiés à la demande et réservés. Il prend en charge l’appel de fonctions, les sorties structurées, le fine-tuning et la personnalisation LoRA.
Un prototype peut commencer sur l’inférence serverless, puis passer à une capacité dédiée pour un débit ou une latence plus stricts. Les interfaces compatibles OpenAI et Anthropic réduisent les modifications client pour les requêtes courantes.
Ce n’est pas le meilleur catalogue de modèles fermés ou d’outils média pour créateurs. Sa valeur réside dans les performances d’inférence et le contrôle du déploiement.
Idéal pour : Les applications de production qui standardisent des modèles ouverts et prévoient une capacité dédiée.
Choisissez-le plutôt que Together AI lorsque : Les performances de service et les contrôles de déploiement pèsent plus lourd que la recherche étendue, l’entraînement ou l’expérimentation multimodale.
5. fal — Meilleure alternative à l’API Venice pour l’image et la vidéo
fal propose plus de 1 000 modèles d’image, de vidéo, d’audio et de 3D. Il prend en charge les requêtes synchrones, les tâches en file d’attente, les webhooks et les connexions en temps réel pour des générations qui peuvent prendre quelques secondes ou minutes.
fal documente jusqu’à 10 tentatives automatiques pour certains échecs et facture généralement les sorties réussies plutôt que les erreurs de file d’attente ou de serveur.
Ce n’est pas un remplacement direct du chat Venice : les modèles ont leurs propres schémas, et les URL des médias générés peuvent rester publiques jusqu’à expiration. Les actifs confidentiels nécessitent un workflow délibéré de stockage et de suppression.
Idéal pour : Les applications créatives, l’édition d’images, la génération vidéo, les outils audio et les pipelines de production média.
Choisissez-le plutôt que GPT Proto lorsque : La profondeur des modèles média et l’orchestration des tâches comptent plus que le maintien du texte et des médias derrière une seule API de style OpenAI.
6. Replicate — Idéal pour les modèles communautaires et personnalisés
Replicate propose plus de 100 modèles officiels ainsi que des modèles communautaires, des fine-tunes, des modèles privés et des déploiements personnalisés. La facturation au temps de traitement ou propre au modèle permet aux équipes de tester des modèles inhabituels sans provisionner de matériel.
Les modèles publics partagés peuvent démarrer à froid ou faire la queue, et l’intégration tourne autour des prédictions plutôt que d’un contrat de chat OpenAI. Les endpoints de prédiction standard autorisent environ 600 requêtes par minute et de nombreux autres endpoints environ 3 000, sous réserve des conditions du modèle et du compte.
Il fonctionne mieux comme laboratoire de modèles ou couche d’exécution personnalisée, pas comme API de chat uniforme.
Idéal pour : Tester des modèles communautaires, déployer des modèles personnalisés et livrer des prototypes avant que les besoins d’infrastructure ne soient fixés.
À surveiller : La latence de démarrage à froid, les schémas par modèle, la persistance des sorties et la différence entre matériel partagé et dédié.
7. vLLM — Meilleure alternative auto-hébergée pour un contrôle maximal
vLLM exécute les modèles pris en charge sur l’infrastructure que vous contrôlez. Il expose des endpoints OpenAI compatibles pour le chat, les complétions, les réponses et les embeddings, avec streaming, sortie structurée et appel d’outils lorsque pris en charge.
Il peut garder les prompts, les poids, les journaux et les chemins réseau dans votre environnement, mais vous devez configurer l’isolation, le chiffrement, la journalisation, les sauvegardes et la conservation. Son paramètre --api-key ne protège pas chaque endpoint, donc les déploiements durcis nécessitent un proxy inverse authentifié.
Il n’y a pas de marge de passerelle, mais les coûts de GPU, d’ingénierie, de surveillance, de mise à l’échelle et d’astreinte subsistent. Une utilisation élevée et régulière peut les justifier ; un trafic irrégulier souvent non.
Idéal pour : Les déploiements réglementés, les réseaux privés, les charges de travail soutenues sur modèles ouverts et les équipes ayant de l’expérience en opérations GPU.
Ne le choisissez pas si : Vous avez besoin de modèles fermés, d’une largeur de catalogue instantanée ou d’un service géré sans possession d’infrastructure.
Quelle alternative à l’API Venice devriez-vous choisir ?
Utilisez la décision qui correspond à votre goulot d’étranglement :
| Votre exigence principale |
Meilleur choix |
Pourquoi |
| Une API abordable pour de nombreuses modalités |
GPT Proto |
Large catalogue, accès compatible OpenAI et tarification des modèles avec remise |
| Routage automatique entre fournisseurs LLM |
OpenRouter |
Politiques de routage, replis et prise en charge de clés propres |
| Fine-tuning de modèles ouverts |
Together AI |
Fine-tuning, LoRA, tâches par lots et inférence serverless |
| Service de modèles ouverts en production |
Fireworks AI |
Plusieurs niveaux de déploiement et contrôles axés sur l’inférence |
| Catalogue approfondi d’images et de vidéos |
fal |
Grand catalogue média plus files d’attente, webhooks et nouvelles tentatives |
| Tests de modèles communautaires ou personnalisés |
Replicate |
Couche de prédiction flexible et large écosystème de modèles publics |
| Confidentialité au niveau de l’infrastructure |
vLLM |
Chemin de données auto-hébergé et contrôle opérationnel complet |
| Modes Private, TEE ou E2EE spécifiques à Venice |
Restez avec Venice |
Aucune des alternatives gérées ne reproduit la conception complète de confidentialité |
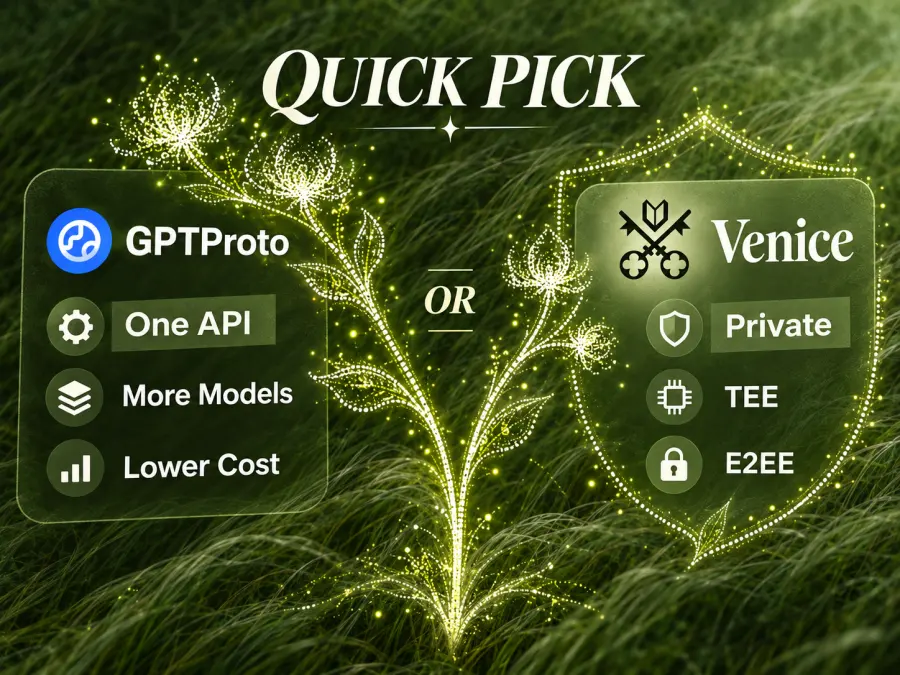
La plupart des équipes n’ont pas besoin de reproduire chaque fonctionnalité de Venice. Elles ont besoin d’une passerelle fiable, des bons modèles et d’une facture prévisible. GPT Proto est la meilleure option par défaut ; le classement change lorsque le routage, le fine-tuning, la spécialisation média ou la confidentialité cryptographique dominent.
Comment passer de l’API Venice à GPT Proto
Pour une intégration standard de complétions de chat, le premier changement de code est minime :
| Paramètre |
API Venice |
GPT Proto |
| Variable d’environnement de clé API |
Votre clé Venice |
GPTPROTO_API_KEY |
| URL de base |
URL de base de l’API Venice |
https://gptproto.com/v1 |
| Modèle |
Identifiant du modèle Venice |
Identifiant du modèle GPT Proto, tel que glm-5.3 |
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["GPTPROTO_API_KEY"],
    base_url="https://gptproto.com/v1",
)

response = client.chat.completions.create(
    model="glm-5.3",
    messages=[
        {
            "role": "user",
            "content": "Résumez les principaux risques dans ce plan de lancement de produit.",
        }
    ],
)

print(response.choices[0].message.content)
La compatibilité OpenAI couvre la forme de la requête, pas un comportement identique. Avant de déplacer le trafic de production, testez :
-
Mode JSON et sortie contrainte par schéma
-
Définitions d’outils, appels d’outils parallèles et résultats d’outils multi-tours
-
Ordre des événements de streaming et comptabilisation de l’usage
-
Objets d’erreur, codes de statut réessayables et comportement d’expiration
-
Limites de fenêtre de contexte et comportement de troncature
-
Entrées et sorties d’image, d’audio ou de vidéo utilisées par votre application
-
Alias de modèles, avis de mise hors service et comportement de repli
-
Tout paramètre spécifique à Venice, y compris son contrôle du prompt système
Un rapport public de développeur a montré pourquoi : une couche SDK générique compatible a supprimé les métadonnées de raisonnement lors d’un usage multi-tours des outils Gemini, et la requête suivante a échoué avec une erreur 400. Ce n’était pas nécessairement un défaut de Venice ; cela montre comment les adaptateurs peuvent perdre un état propre au fournisseur.
Envoyez d’abord un petit pourcentage de trafic, comparez la latence et la validité des sorties structurées, et gardez un commutateur de routage réversible jusqu’à ce que les erreurs se stabilisent. L’URL de base est la partie facile ; l’audit du comportement est la migration.
Quand devriez-vous rester avec l’API Venice ?
Restez avec Venice lorsque l’une de ces conditions définit le produit :
-
Vous avez besoin de ses modes d’inférence spécifiques Anonymous, Private, TEE ou E2EE.
-
Vous voulez accéder à plus de 350 modèles dans son catalogue et ses politiques actuels.
-
Votre application dépend de la sélection permissive de modèles de Venice.
-
L’allocation DIEM ou les paiements x402 en USDC correspondent à votre conception de facturation.
-
Vous avez déjà testé des paramètres spécifiques à Venice et ne gagnez pas assez en changeant pour justifier un autre cycle de compatibilité.
L’absence de conservation des données n’est pas la même chose que le chiffrement de bout en bout, et l’auto-hébergement n’est pas sûr simplement parce que le serveur se trouve dans votre compte. Comparez les modèles de menace, pas les étiquettes.
Si vous restez, définissez la préférence de prompt système de Venice, surveillez les mises hors service et vérifiez quels modes de confidentialité prennent en charge vos outils. E2EE ne peut pas coexister avec des fonctionnalités côté serveur qui nécessitent du texte en clair.
Verdict final
GPT Proto est la meilleure alternative à l’API Venice en 2026 pour les développeurs qui cherchent un accès abordable aux modèles de texte, d’image, de vidéo et d’audio via une API familière. Il offre le remplacement pratique le plus proche du rôle de passerelle de Venice, avec un prix inférieur dans la comparaison GLM-5.3 et des changements de code minimaux pour les requêtes de chat standard.
OpenRouter est meilleur pour le routage entre fournisseurs. Together AI et Fireworks AI sont meilleurs pour la personnalisation de modèles ouverts et l’inférence en production. fal mène pour les workflows spécifiques aux médias, Replicate pour l’expérimentation communautaire, et vLLM pour le contrôle auto-hébergé.
Venice gagne toujours lorsque son architecture de confidentialité est le facteur décisif. Aucune alternative gérée de ce classement ne doit être décrite comme un substitut complet aux modes Private, TEE et E2EE de Venice.
Choisissez deux finalistes, rejouez un ensemble de tests représentatif et comparez le coût total, la latence p95, la validité des sorties et la récupération après échec. Pour la plupart des équipes sans exigence de confidentialité spécifique à Venice, GPT Proto est la première option que je testerais.