Um einen DeepSeek API-Key für Ihre App zu erhalten, erstellen Sie ein GPTProto-Konto, laden Sie Guthaben auf und generieren Sie einen Key im Quick Start-Bereich auf der DeepSeek Flash-Modellseite. Verwenden Sie deepseek-flash für Ihre erste Anfrage. Derselbe GPTProto-Key gewährt Ihnen Zugriff auf weitere unterstützte Modelle, einschließlich DeepSeek V4 Pro.
Tiffany Layne2026-02-03
So erhalten Sie einen DeepSeek API-Key im Jahr 2026
Holen Sie sich einen DeepSeek API-Key auf GPTProto, führen Sie Ihre erste Anfrage mit V4.1 Flash aus, vergleichen Sie Token-Preise und verbinden Sie DeepSeek mit Codex.
Inhaltsverzeichnis
Was ist die DeepSeek-API?
Mit der DeepSeek-API kann Ihre Anwendung Anfragen an gehostete DeepSeek-Modelle senden und Antworten als Code empfangen. Sie können sie verwenden, um einen Fehlerbericht in ein Issue-Ticket umzuwandeln oder Ihrem eigenen Produkt einen Coding-Assistenten hinzuzufügen. Die API verwendet einen Schlüssel und berechnet die Modellnutzung pro Token. Entwickler, die bereits das OpenAI SDK verwenden, können ihren Client mithilfe des DeepSeek-API-Schnellstarts anpassen.
DeepSeek wurde 2023 in Hangzhou gegründet. Der Gründer, Liang Wenfeng, gründete auch den quantitativen Hedgefonds High-Flyer, der das KI-Startup unterstützte. DeepSeek veröffentlichte im Dezember 2024 V3, ein allgemeines Sprachmodell. R1 folgte im Januar 2025. Die Veröffentlichung der Modellgewichte von R1 und der Fokus auf Schlussfolgerungen (Reasoning) verhalfen DeepSeek zu einem breiteren Publikum. Lesen Sie den Überblick des Congressional Research Service zu DeepSeek und die R1-Versionshinweise von DeepSeek.
Wenn Sie R1 in einem älteren Tutorial gesehen haben, überprüfen Sie die Modell-ID, bevor Sie den Code kopieren. Das folgende Beispiel beginnt mit DeepSeek V4.1 Flash und verwendet die Modell-ID deepseek-flash auf GPT Proto. Lesen Sie den Leitfaden zu DeepSeek Flash-Modell-IDs, wenn Sie eine ältere Integration migrieren.
So erhalten Sie einen DeepSeek-API-Schlüssel auf GPT Proto
Erstellen Sie ein GPT Proto-Konto und laden Sie Guthaben auf. Überprüfen Sie die Seite des Flash-Modells auf aktuelle Preise für Input, gecachten Input und Output, bevor Sie Guthaben aufladen.
Öffnen Sie den Schnellstart. Klicken Sie auf der Seite des DeepSeek Flash-Modells auf Dieses Modell ausprobieren, um das Einrichtungsfenster zu öffnen. Wählen Sie API-Schlüssel erstellen oder verwenden Sie Schlüssel auswählen, falls Sie bereits einen GPT Proto-Schlüssel besitzen.
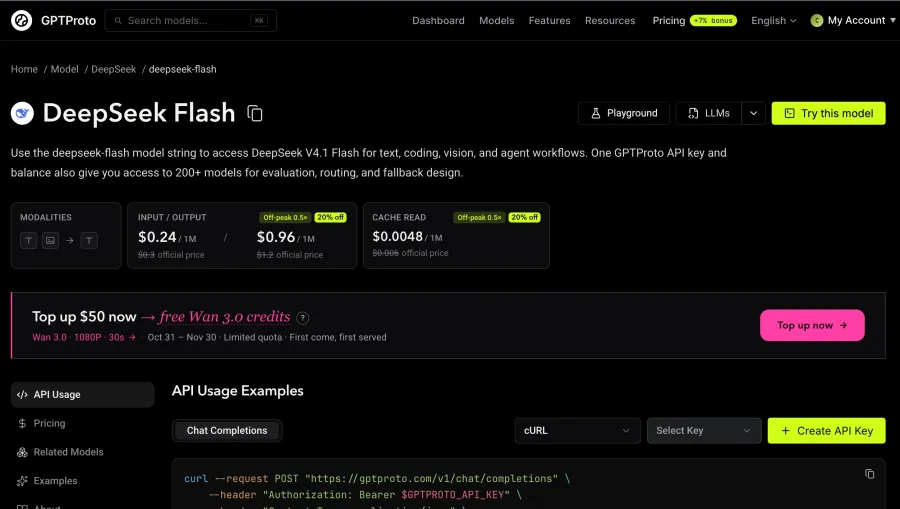
Wählen Sie die Verbindungsmethode. Klicken Sie für ein bestehendes Projekt auf Markdown für KI kopieren und fügen Sie den Leitfaden in Ihren Coding-Assistenten ein. Bitten Sie ihn, einen serverseitigen Aufruf unter Verwendung der Modell-ID und des Endpunkts aus dem Leitfaden hinzuzufügen. Setzen Sie
GPTPROTO_API_KEYin Ihrer lokalen Umgebung oder Ihrem Server-Secret-Store und halten Sie den Wert aus Ihrem Code und dem Assistenten-Chat fern.
Führen Sie Ihren ersten DeepSeek-API-Aufruf durch
Sobald GPTPROTO_API_KEY in Ihrem Terminal gesetzt ist, senden Sie eine kurze Anfrage. Dieses Beispiel verwendet den Chat-Completions-Endpunkt, der im DeepSeek Flash-Schnellstart gezeigt wird.
curl --fail-with-body --silent --show-error \
  https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer ${GPTPROTO_API_KEY}" \
  -H 'Content-Type: application/json' \
  --data '{
    "model": "deepseek-flash",
    "messages": [{"role": "user", "content": "Reply with API connected."}]
  }'
Suchen Sie nach der Antwort in choices[0].message.content. Wenn die Antwort ein usage-Objekt enthält, überprüfen Sie dieses, bevor Sie die Kosten für eine größere Anfrage schätzen.
Verwandeln Sie einen Bug-Report in ein Ticket
Wenn Sie eine kleine SaaS-Anwendung betreuen, probieren Sie Flash an einer Support-Nachricht aus, bevor Sie diese direkt mit Ihrem Issue-Tracker verknüpfen. Ersetzen Sie die Testnachricht durch diesen Prompt und den Beispielbericht.
Wandeln Sie diesen Bericht in ein JSON-Objekt mit
summary,reproduction_steps,acceptance_criteriaundmissing_detailsum. Basieren Sie die Schritte auf dem Bericht. Fügen Sie fehlende Umgebungsdetails oder Voraussetzungen inmissing_detailsein.Beispielbericht: Unter Safari habe ich eine CSV-Datei hochgeladen und auf Importieren geklickt. Der Ladebalken verschwand und die Seite zeigte null importierte Zeilen an. Dieselbe Datei funktionierte in Chrome.
Stellen Sie sicher, dass das Ticket die Ergebnisse von Safari und Chrome getrennt hält. Die Akzeptanzkriterien sollten beschreiben, wie ein erfolgreicher Import aussehen würde. Die Browserversion und der CSV-Inhalt gehören in missing_details. Wenn Sie dies automatisieren, validieren Sie das JSON und leiten Sie den Entwurf an einen menschlichen Prüfer weiter, bevor Sie das Ticket erstellen.
Warum GPT Proto für die DeepSeek API verwenden?
Zahlen Sie 20 % weniger als die veröffentlichten Spitzenpreise von DeepSeek für Flash. Die aufgeführten Preise von GPT Proto betragen 0,24 $ pro Million nicht zwischengespeicherter Eingabe-Token, 0,96 $ pro Million Ausgabe-Token und 0,0048 $ pro Million zwischengespeicherter Eingabe-Token. Prüfen Sie bei planbaren Aufgaben die geltenden Nebenzeiten-Tarife, bevor Sie entscheiden, wann und wo Sie diese ausführen. Die aktuellen Preise finden Sie auf der DeepSeek Flash Modellseite.
Behalten Sie einen Key und ein Guthaben, während Sie weitere Modelle testen. Beginnen Sie mit Flash für die Ticket-Triage. Wenn schwierigere Berichte mehr logisches Denken erfordern, testen Sie V4 Pro mit denselben Eingaben und denselben GPT Proto-Anmeldedaten. Der GPT Proto DeepSeek Modellkatalog listet die verfügbaren Routen und deren Preise auf.
Geben Sie Ihrer App ein Fallback, das Sie testen können. Sie können ein zweites unterstütztes Modell in Ihrer App für Timeouts oder Upstream-Fehler konfigurieren. Führen Sie dieselbe Eingabe durch beide Modelle und prüfen Sie, ob beide Antworten den Anforderungen Ihrer App entsprechen, bevor Sie sich auf das Fallback verlassen. Wenn Sie auf ein Einrichtungs- oder Abrechnungsproblem stoßen, nutzen Sie den Konsolen-Support-Chat, der im GPT Proto Installationshandbuch aufgeführt ist.
So verbinden Sie DeepSeek mit Codex mithilfe eines GPT Proto-API-Schlüssels
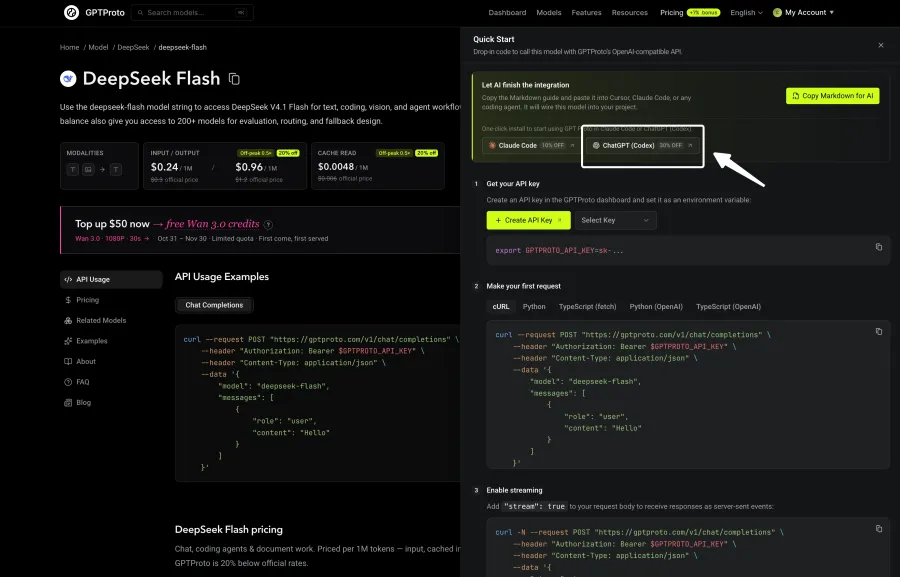
Verwenden Sie das ChatGPT (Codex)-Installationsprogramm, wenn Sie Codex mit Ihrem GPT Proto-Schlüssel konfigurieren möchten. Verwenden Sie Copy Markdown for AI, wenn Codex einen DeepSeek-API-Aufruf zum Code Ihrer App hinzufügen soll.
Öffnen Sie Quick Start auf der Seite des DeepSeek Flash-Modells.
Wählen Sie unter Let AI finish the integration die Option ChatGPT (Codex).
Wählen Sie einen GPT Proto-API-Schlüssel aus oder erstellen Sie einen neuen, wählen Sie Ihr Betriebssystem aus und befolgen Sie die Anweisungen auf dem Bildschirm im GPT Proto-Installationshandbuch.
Öffnen Sie Codex und bestätigen Sie den aktiven Anbieter und das Modell. Beginnen Sie mit einer schreibgeschützten Aufgabe, wie z. B. „Erkläre, was dieser Test abdeckt, und schlage einen fehlenden Fall vor.“ Wenn Ihr Workflow von Tool-Aufrufen abhängt, versuchen Sie es mit einer zweiten Aufgabe, die eine Datei liest und deren Inhalt in einem Folgeschritt verwendet.
Eine einzelne Antwort bestätigt die grundlegende Konnektivität. Wenn Sie Codex für längere Sitzungen verwenden möchten, testen Sie auch eine mehrstufige Aufgabe. Ein Entwickler berichtete von einem HTTP 400-Fehler während der Fortsetzung von Tool-Aufrufen in einer bestimmten DeepSeek-Antwortkonfiguration. Dieser Bericht bezieht sich auf eine direkte DeepSeek-Konfiguration und ist im Codex-Issue-Tracker dokumentiert.
Wichtige DeepSeek-API-Modelle auf GPT Proto verfügbar
Beginnen Sie für eine neue Integration mit DeepSeek V4.1 Flash. Evaluieren Sie V4 Pro, wenn schwierige Textaufgaben regelmäßig einen zweiten Durchlauf erfordern, oder V3.2, wenn Sie ein großes Volumen an kurzen Textaufgaben mit vorhersehbaren Ergebnissen ausführen. Die anderen Routen sind nützlich, wenn Sie bereits eine bestehende Integration haben oder eine Basislinie für Tests benötigen. Alle sieben sind im GPT Proto DeepSeek-Modellkatalog aufgeführt.
| DeepSeek-Modell | GPT Proto-Modell-ID | Wann Sie es ausprobieren sollten |
|---|---|---|
| V4.1 Flash | deepseek-flash |
Der Standard für alltägliche Programmieraufgaben, Ticket-Triage und Aufgaben, die Text und Screenshots kombinieren. |
| V4 Pro | deepseek-v4-pro |
Schwierige reine Textaufgaben, wie das Verfolgen eines Fehlers über mehrere Dateien hinweg oder die Überprüfung eines mehrstufigen technischen Plans. |
| V4 Flash | deepseek-v4-flash |
Ein Vergleichspunkt für bestehende reine Text-Workflows mit V4 Flash vor dem Wechsel zu V4.1 Flash. |
| V4 Flash Vision Exp | deepseek-v4-flash-vision-exp |
Eine experimentelle Route, die einen erneuten Test wert ist, falls ein bestehender Workflow für Screenshots oder Diagramme bereits davon abhängt. |
| V3.2 | deepseek-v3.2 |
Eine kostengünstigere Textoption zum Testen für Massen-Tagging, kurze Zusammenfassungen und repetitive Extraktionen. |
| V3 | deepseek-v3 |
Eine Basislinie für ältere Prompts oder Anwendungen, die bereits vom Ausgabeformat von V3 abhängen. |
| R1 | deepseek-r1 |
Eine Reasoning-Basislinie für einen Mathe- oder Logik-Workflow, der bereits auf R1 evaluiert wurde. Vergleichen Sie ihn mit Flash und Pro bei denselben Eingaben. |
Dies sind GPT Proto-Katalogrouten. Bei der direkten API von DeepSeek leiten die älteren V4 Flash- und Vision Exp-IDs jetzt auf V4.1 Flash um. Überprüfen Sie die ID im Quick Start der Modellseite, wann immer Sie den Anbieter wechseln oder eine bestehende Integration migrieren. Siehe die offizielle Modellauflistung und den Leitfaden zur DeepSeek Flash-Modell-ID.
So wählen Sie das richtige DeepSeek-Modell
Wenn Ihre Eingabe Screenshots oder Diagramme enthält, beginnen Sie mit V4.1 Flash. Senden Sie im Ticket-Beispiel den Fehler-Screenshot zusammen mit der Support-Nachricht und prüfen Sie, ob die Antwort den sichtbaren Fehler erfasst. Wenn Sie bereits Vision Exp verwenden, führen Sie beide auf denselben Bildern aus, bevor Sie wechseln.
Wenn Ihre Eingabe hauptsächlich aus kurzem, repetitivem Text besteht, vergleichen Sie V3.2 mit Flash anhand einer Reihe echter Tickets. Überprüfen Sie, wie viele Ergebnisse Ihrem JSON-Schema entsprechen, die richtigen Labels verwenden und keine Details erfinden. Vergleichen Sie die Kosten pro verwertbarem Ticket, einschließlich erneuter Versuche.
Wenn eine schlechte Antwort teuer zu korrigieren ist, versuchen Sie es bei Routinefällen mit Flash und testen Sie V4 Pro bei Fällen, die Flash nicht bewältigen kann. Verwenden Sie für eine Code-Korrektur bestandene Tests und die Anzahl der Wiederholungsversuche als Kriterien. Leiten Sie schwierige Fälle an Pro weiter, wenn dies die Ergebnisse ausreichend verbessert, um die zusätzlichen Kosten zu rechtfertigen.
Um im cURL-Beispiel zwischen Modellen zu wechseln, ersetzen Sie den Wert von model durch die oben genannte GPT Proto-Modell-ID. Der GPT Proto-Schlüssel bleibt gleich. Wenn Sie zwischen reinen Textmodellen und bildfähigen Modellen wechseln, stellen Sie sicher, dass die Anfrageeingabe dem entspricht, was das neue Modell akzeptiert.
Wenn Geschwindigkeit wichtig ist, messen Sie, wie lange der Benutzer auf den ersten Chunk wartet und wie lange die gesamte Aufgabe dauert. Eine schnelle Token-Generierung kann dazu führen, dass ein Benutzer dennoch auf einen langen Argumentationsschritt warten muss. Beide Metriken finden Sie in den unabhängigen Benchmarks für die direkte API von DeepSeek.
Für einen kleinen Coding-Workflow siehe den Vergleich zwischen DeepSeek Flash und Claude Haiku 5.5. Für eine umfassendere Bewertung vergleichen Sie DeepSeek Flash mit Kimi K3 für Coding-Agenten oder DeepSeek Flash mit GLM 5.3 Flash für Code und Kosten.
DeepSeek API-Preise pro Million Token
Die unten aufgeführten Preise verstehen sich in USD pro Million Token und wurden am 4. November 2026 überprüft. Die GPT Proto-Zeilen zeigen die gelisteten Tarife. Für die direkte DeepSeek-API gelten die Spitzenzeiten wochentags von 01:00–04:00 Uhr und 06:00–10:00 Uhr UTC, ausgenommen chinesische Feiertage.
| Route | Ungecachter Input | Gecachter Input | Output |
|---|---|---|---|
| GPT Proto DeepSeek Flash | $0.24 | $0.0048 | $0.96 |
| GPT Proto DeepSeek V4 Pro | $1.056 | $0.0352 | $3.168 |
| Offiziell Flash zu Spitzenzeiten | $0.30 | $0.006 | $1.20 |
| Offiziell Flash außerhalb der Spitzenzeiten | $0.15 | $0.003 | $0.60 |
| Offiziell V4 Pro zu Spitzenzeiten | $1.32 | $0.044 | $3.96 |
| Offiziell V4 Pro außerhalb der Spitzenzeiten | $0.66 | $0.022 | $1.98 |
Aktuelle Preise finden Sie im GPT Proto DeepSeek-Katalog und in der offiziellen DeepSeek API-Preisliste.
Angenommen, Ihre Ticket-Warteschlange verbraucht 1 Million ungecachte Input-Token und 250.000 Output-Token. Zum aufgeführten GPT Proto Flash-Tarif entspricht dies $0.48 an Modellnutzungskosten. Die gleiche Token-Mischung kostet $0.60 zu den offiziellen Spitzenzeiten von DeepSeek oder $0.30 zu den Preisen außerhalb der Spitzenzeiten. Dies sind Schätzungen für diese Token-Mischung. Berücksichtigen Sie bei der Budgetierung für einen Agenten auch Token aus zusätzlichen Interaktionen und Wiederholungsversuchen sowie alle separat berechneten Tools, die Ihr Setup verwendet.
Ein Key für Agenten, Coding & Apps
Stärken Sie Ihre KI-Agenten, Coding-Tools und Apps mit erschwinglichem Zugriff auf führende Modelle über einen einzigen API-Key.
API-Modelle durchsuchen
Verwandte Funktionen
Alle FunktionenKI-Katzen-Tanzvideo-Generator
Lade ein Katzenbild und ein Video mit einem menschlichen Tanz hoch, damit deine Katze mit KI tanzt. Übertrage die Referenzbewegung online mit GPTProto in ein lustiges Katzenvideo.
Anime zu Real Life KI
Laden Sie Anime-, Manga-, Cartoon- oder OC-Kunstwerke hoch und verwandeln Sie sie mit GPTProtos Online-Konverter für Anime zu Real Life KI in ein realistisches menschliches Porträt.
Verwandte Modelle
Alle Modelle
DeepSeek API FAQ
Ist die DeepSeek API kostenlos?
Sie können einen Key kostenlos erstellen. Die direkte API von DeepSeek berechnet die Nutzung basierend auf Ihrem Kontoguthaben, einschließlich etwaiger Ihnen gewährter Gutschriften. Der kostenlose Zugriff auf den Web-Chat von DeepSeek nutzt eine separate Schnittstelle. Überprüfen Sie die Abrechnungsregeln auf der offiziellen DeepSeek-Preisseite.
Wo erhalte ich einen offiziellen DeepSeek API-Key?
Erstellen Sie einen im API-Key-Dashboard der DeepSeek-Plattform für den direkten Zugriff. Wenn Sie den oben genannten GPTProto-Schritten folgen, verwenden Sie den im Quick Start erstellten GPTProto-Key und laden Sie das GPTProto-Guthaben auf.
Wie kaufe ich DeepSeek API-Zugriff aus dem Ausland?
Melden Sie sich bei dem Anbieter an, den Sie nutzen möchten, und prüfen Sie, welche Zahlungsmethoden und Währungen auf der Aufladeseite Ihres Kontos angezeigt werden. Fügen Sie bei GPTProto Guthaben zu Ihrem Konto hinzu und verwenden Sie Ihren GPTProto-Key für DeepSeek-Anfragen.
Warum funktioniert mein DeepSeek API-Key nicht?
Ein 401-Fehler deutet auf ein Authentifizierungsproblem hin. Überprüfen Sie, ob der Key geladen ist und ob er zu dem Anbieter in Ihrer Anfrage-URL gehört. Ein 402-Fehler bei der direkten DeepSeek API bedeutet, dass Sie Ihr Guthaben überprüfen müssen. Bei einem 429-Fehler prüfen Sie die Limits des Anbieters und reduzieren Sie parallele Anfragen, bevor Sie es erneut versuchen. Siehe die offiziellen DeepSeek API-Fehlercodes für direkte API-Fehler.
Verwandte Artikel
Weitere Blogbeiträge
Claude Haiku 5.5 vs DeepSeek V4.1 Flash: Which Is Better for Coding and Agents?
Claude Haiku 5.5 vs DeepSeek V4.1 Flash looks like a simple budget-model comparison until context length changes the answer. On GPTProto, Haiku is cheaper for a typical short request. Once a prompt exceeds 100,000 tokens, Haiku moves to its long-context rate, while DeepSeek Flash keeps the same standard rate. The lower-cost choice can therefore flip with the workload. Capability is just as conditional. Haiku leads several independent reasoning and terminal measures and fits neatly into Claude-based subagent systems. DeepSeek V4.1 Flash offers much longer output, open weights, and notably stronger results on one independent automation benchmark. There is no honest universal winner. Get Haiku 5.5 API
Tiffany Layne | 2026-10-12
DeepSeek Flash vs. Kimi K3: Was ist besser für Programmierung und KI-Agenten?
DeepSeek Flash und Kimi K3 setzen nahezu auf gegensätzliche Strategien. DeepSeek Flash priorisiert Geschwindigkeit, niedrige Tokenkosten und kontrollierbares Schlussfolgern. Kimi K3 setzt mehr Rechenleistung – und deutlich mehr Geld – ein, um einen höheren Gesamtintelligenz-Score und bessere Ergebnisse in Präferenztests für Frontends zu erzielen. Damit ist die Antwort auf den ersten Blick ganz einfach. Für Coding mit hohem Volumen, die Wartung von Repositories und ausführungsintensive Agenten solltest du mit DeepSeek Flash beginnen. Für komplexe Planung, Frontend-Arbeit, bei der visuelles Urteilsvermögen zählt, oder Workflows, die native Videoeingabe erfordern, ist Kimi K3 der bessere erste Test. Wenn du verschiedene Phasen einer Aufgabe unterschiedlichen Modellen zuweisen kannst, ist Kimi für die Planung und DeepSeek für die Ausführung oft die sinnvollste Kombination. DeepSeek-Flash-Schlüssel abrufen Kimi-K3-Schlüssel abrufen Die Preise und die aktuellen Platzierungen in der Bestenliste für diesen Vergleich wurden am 16. September 2026 überprüft.
Schuyler Stacy | 2026-09-16
DeepSeek V4 Flash, V4.1 Flash und DeepSeek Flash: Modellbezeichnungen erklärt
Status geprüft: 14. September 2026. Du kannst deepseek-v4-flash in einer API-Anfrage verwenden, ohne eine Fehlermeldung zu erhalten – und trotzdem nicht das ursprüngliche Modell DeepSeek V4 Flash nutzen. Das ist die Ursache für die meisten Verwirrungen rund um die Bezeichnungen. DeepSeek V4 Flash, DeepSeek V4.1 Flash und DeepSeek Flash bezeichnen keine drei aktuellen Leistungsklassen. DeepSeek V4 Flash ist der Vorgänger, der nicht mehr angeboten wird. DeepSeek V4.1 Flash ist das Modell, das jetzt die Arbeit erledigt. deepseek-flash ist die von DeepSeek empfohlene API-Modellbezeichnung, um dieses Modell aufzurufen. Aus Kompatibilitätsgründen leitet DeepSeek die alten Kennungen deepseek-v4-flash und deepseek-v4-flash-vision-exp vorübergehend ebenfalls an V4.1 Flash weiter. Auf GPTProto verweisen deepseek-flash , deepseek-v4-flash und deepseek-v4.1-flash derzeit auf dasselbe zugrunde liegende Modell V4.1 Flash. Dadurch funktionieren ältere Integrationen weiterhin. Zugleich ergibt sich eine weniger offensichtliche Folge: Dieselbe Modellbezeichnung kann Ergebnisse von einem neueren Modell liefern als dem, das du ursprünglich getestet hast. DeepSeek Flash auf GPTProto ausprobieren
Michael Johnson | 2026-09-09
DeepSeek Flash vs. GLM 5.3 Flash: Welches Modell eignet sich besser für Programmierung und Agenten?
DeepSeek Flash ist die schnellere Wahl für interaktives Programmieren, während GLM 5.3 Flash niedrigere Standard-Tokenpreise und einen kleinen Vorsprung bei unabhängigen Gesamtevaluierungen bietet. Das ist die kurze Antwort. Die nützlichere Antwort hängt von der Arbeitslast ab. Aktuelle unabhängige Messungen zeigen, dass DeepSeek V4.1 Flash rund 214 Ausgabetokens pro Sekunde erreicht, verglichen mit 114 Tokens pro Sekunde bei GLM 5.3 Flash. Beim selben Intelligence Index erzielt GLM jedoch 42 Punkte gegenüber 40 Punkten für DeepSeek und kostet pro ausgewerteter Aufgabe etwas weniger. Die Preise machen die Sache noch etwas komplizierter. GLM hat niedrigere reguläre Preise für Eingabe und Ausgabe, aber DeepSeeks ungewöhnlich günstige Preise für Cache-Eingaben können es für Agenten mit intensiver Cache-Nutzung, die außerhalb der Spitzenzeiten laufen, günstiger machen. Es gibt keinen universellen Gewinner. Für jede Art von Arbeit gibt es einen klaren Gewinner. GLM-5.3-Flash-Schlüssel erhalten Deepseek-Flash-Schlüssel erhalten
Schuyler Stacy | 2026-09-01