DeepSeek Flash vs. GLM 5.3 Flash: schnelles Urteil
| Einsatzbereich |
Bessere Wahl |
Warum |
| Interaktiver Coding-Assistent |
DeepSeek Flash |
Geringere Latenz und fast doppelte gemessene Ausgabegeschwindigkeit |
| Terminal- und Kommandozeilen-Agenten |
GLM 5.3 Flash |
Kleiner Vorsprung im unabhängigen Terminal-Bench 4.0 |
| Workflow-Automatisierung |
DeepSeek Flash |
Höherer Wert im unabhängigen AutomationBench-AA |
| Niedrigster Standard-API-Preis |
GLM 5.3 Flash |
Niedrigere Preise für neue Eingaben und Ausgaben |
| Agenten mit hoher Cache-Nutzung außerhalb der Spitzenzeiten |
DeepSeek Flash |
Gecachte Eingaben kosten nur 0,003 $ pro Million Token |
| Screenshot-zu-Code |
Beide testen |
Beide akzeptieren Bilder; ein aussagekräftiger unabhängiger Vergleich für visuelles Coding liegt noch nicht vor |
| Sehr lange generierte Ausgaben |
DeepSeek Flash |
Bis zu 384K Ausgabe-Token, verglichen mit 128K bei GLM |
| Lokale Bereitstellung |
GLM 5.3 Flash |
Kleineres Gesamtmodell, aber weiterhin anspruchsvoll im Hosting |
Meine Standardempfehlung ist einfach: Beginne mit DeepSeek Flash für einen reaktionsschnellen Coding-Assistenten. Beginne mit GLM 5.3 Flash für die Stapelverarbeitung und kostenbewusste Terminal-Aufgaben. Wenn die Anwendung bereits Modell-Routing unterstützt, behalte beide.
Welche Modelle vergleichen wir eigentlich?
Die Modellnamen kann man ungewöhnlich leicht verwechseln.
DeepSeek Flash steht jetzt für DeepSeek V4.1 Flash
deepseek-flash ist die aktuelle API-Modellbezeichnung. DeepSeek V4.1 Flash ist die Modellversion, die dahinter bereitgestellt wird.
Die älteren Namen deepseek-v4-flash und deepseek-v4-flash-vision-exp beziehen sich auf eingestellte Modelle. DeepSeek akzeptiert diese Aliase zwar weiterhin, aber Anfragen werden jetzt von V4.1 Flash verarbeitet und zum aktuellen Flash-Tarif abgerechnet.
Das ist wichtig, wenn man ältere Vergleiche liest. Eine vor dem 10. September 2026 veröffentlichte Seite beschreibt möglicherweise das ursprüngliche textorientierte V4 Flash mit 284B Parametern. Das aktuelle Modell hat ein 552B-Backbone, native Bildeingabe und eine andere Architektur.
Verwende für neue GPT Proto-Integrationen die aktuelle API-Seite für deepseek-flash und protokolliere die aufgelöste Modellversion in deinen Evaluierungslogs.
GLM 5.3 Flash ist keine schnellere Einstellung für GLM 5.3
GLM 5.3 und GLM 5.3 Flash sind separate Modelle.
Das Standardmodell GLM 5.3 ist ein textorientiertes Modell aus der GLM-5.2-Reihe. GLM 5.3 Flash basiert auf einer neu trainierten multimodalen Grundlage. Es kombiniert Sparse- und lineare Attention, verfügt über insgesamt 320B Parameter und aktiviert etwa 18B pro Token.
Es kann Text, Bilder, Videos und Dateien verarbeiten. Das Standardmodell GLM 5.3 bleibt auf Text beschränkt.
Dieser Unterschied ist für die Frontend-Entwicklung wichtig. Die GLM 5.3 Flash API kann einen Screenshot oder eine Interface-Aufzeichnung analysieren; der ähnlich benannte GLM-5.3-Endpunkt hingegen nicht.
DeepSeek V4.1 Flash und GLM 5.3 Flash im Überblick
| Spezifikation |
DeepSeek V4.1 Flash |
GLM 5.3 Flash |
| API-Modellbezeichnung |
deepseek-flash |
glm-5.3-flash |
| Entwickler |
DeepSeek |
Z.ai |
| Veröffentlichung |
September 2026 |
August 2026 |
| Eingabe |
Text und Bilder |
Text, Bilder, Videos und Dateien |
| Ausgabe |
Text und Tool-Aufrufe |
Text und Tool-Aufrufe |
| Kontextfenster |
1M Token |
1M Token |
| Maximale Ausgabe |
384K Token |
128K Token |
| Parameter insgesamt |
552B |
320B |
| Aktive Parameter |
8B beim Prefill; 16B beim Decode |
Etwa 18B |
| Reasoning |
Mit oder ohne Thinking |
Reasoning immer aktiviert |
| Tool-Aufrufe |
Ja |
Ja |
| Offene Gewichte |
MIT-Lizenz |
MIT-Lizenz |
| Lokale Bereitstellung |
Unterstützt, erfordert jedoch umfangreiche Hardware |
Unterstützt, erfordert jedoch umfangreiche Hardware |
Die Modellgröße allein sagt die API-Geschwindigkeit nicht voraus. GLM hat insgesamt weniger Parameter, doch aktuelle Messungen gehosteter Modelle zeigen, dass DeepSeek Ausgaben schneller generiert.
Auch die Kontextwerte müssen richtig eingeordnet werden. Ein Limit von einer Million Token ist eine Obergrenze und keine Aufforderung, bei jedem Aufruf ein ganzes Repository zu senden. Irrelevante Quelldateien erhöhen die Latenz und die Tokenkosten und steigern das Risiko, dass sich das Modell auf die falsche Abhängigkeit konzentriert.
Unabhängiger Leistungsvergleich
Der aussagekräftigste öffentliche Vergleich stammt von Artificial Analysis, da beide Modelle im selben Evaluierungsrahmen gemessen werden.
| Unabhängige Kennzahl |
DeepSeek V4.1 Flash |
GLM 5.3 Flash |
| Intelligence Index |
40 |
42 |
| AutomationBench-AA |
69% |
60% |
| Terminal-Bench 4.0 |
27% |
33% |
| SciCode |
52% |
52% |
| Humanity’s Last Exam |
39% |
40% |
| Abruf aus langem Kontext |
84% |
80% |
| Durchschnittliche Kosten pro Aufgabe |
$0.27 |
$0.25 |
| Ausgabe-Token pro Aufgabe |
89K |
69K |
Quelle: Direktvergleich von Artificial Analysis.
Der Vorsprung von GLM um zwei Punkte beim Intelligence Index ist real, aber kein klarer Gesamtsieg. GLM schneidet bei der Terminal-Evaluierung besser ab, während DeepSeek AutomationBench-AA um neun Prozentpunkte und den Test zum Abruf aus langem Kontext um vier Punkte anführt. SciCode endet unentschieden.
Ebenso wichtig sind die Token-Nutzungswerte. DeepSeek erzeugte pro ausgewerteter Aufgabe etwa 89.000 Ausgabe-Token, GLM dagegen 69.000. DeepSeek gibt Token möglicherweise schneller zurück, kann aber auch mehr davon ausgeben.
Einfach gesagt: GLM ist über den gesamten Benchmark-Satz hinweg etwas effizienter. DeepSeek ist schneller und gewinnt bei einigen Workloads, die für automatisierte Systeme besonders wichtig sind.
Was die Hersteller-Benchmarks zusätzlich zeigen
Auch DeepSeek und Z.ai veröffentlichen Ergebnisse zu Coding und Agenten. Sie liefern nützliche zusätzliche Anhaltspunkte, sollten aber nicht als kontrollierter Direktvergleich dargestellt werden.
DeepSeek meldet für V4.1 Flash 74.2 bei DeepSWE v1.1 und 90.6 bei Terminal-Bench 2.1. Z.ai meldet für GLM 5.3 Flash jeweils 63.4 und 84.3.
Die naheliegende Schlussfolgerung lautet, dass DeepSeek bei beiden gewinnt. Diese Behauptung würde ich nicht aufstellen.
Die Unternehmen verwendeten eigene Modelleinstellungen, Kontextstrategien, Agentenkonfigurationen und Evaluierungsinfrastrukturen. Selbst bei identischem Benchmark-Namen kann sich das jeweilige Test-Setup unterscheiden. Die Ergebnisse der Anbieter zeigen, was jedes Team mit seinem eigenen Modell erreichen konnte. Die unabhängige Tabelle oben bietet den faireren Vergleich.
DeepSeek Flash vs. GLM 5.3 Flash beim Coding
Beide Modelle können Funktionen schreiben, unbekannten Code erklären, Tests generieren, Module refaktorieren und Fehler diagnostizieren. Der Unterschied wird deutlicher, wenn Coding zu einer längeren Abfolge von Aktionen wird.
Coding und Debugging auf Repository-Ebene
Der Vorsprung von GLM im unabhängigen Terminal-Bench macht es zum besseren Kandidaten für Aufgaben mit Shell-Befehlen, der Installation von Abhängigkeiten, Testausführungen und wiederholten Änderungen am Repository.
DeepSeek hat zwei andere Vorteile.
Erstens reagiert es schneller. Das ist wichtig, wenn Entwickler auf eine Erklärung warten, jeden Patch einzeln freigeben oder dieselbe Implementierung wiederholt anpassen.
Zweitens unterstützt DeepSeek eine maximale Ausgabe von 384K Token und optional einen Betrieb ohne Thinking. Die meisten Coding-Anfragen sollten diese Ausgabebegrenzung nie annähernd erreichen, aber der zusätzliche Spielraum kann bei umfangreichen Migrationsplänen, Code-Audits und generierten Artefakten hilfreich sein.
In der Praxis würde ich die Aufgaben so aufteilen:
Verwende GLM 5.3 Flash für autonome Terminal-Aufgaben und kostengünstigere Stapelprüfungen.
Verwende DeepSeek Flash für interaktives Debugging, schnelle Code-Iterationen und latenzempfindliche Editor-Workflows.
Behalte das vorhandene Modell bei, wenn es deine Regressionstests bereits besteht. Ein Unterschied von zwei Benchmark-Punkten rechtfertigt keine ungetestete Produktionsmigration.
Frontend-Coding und Screenshot-zu-Code
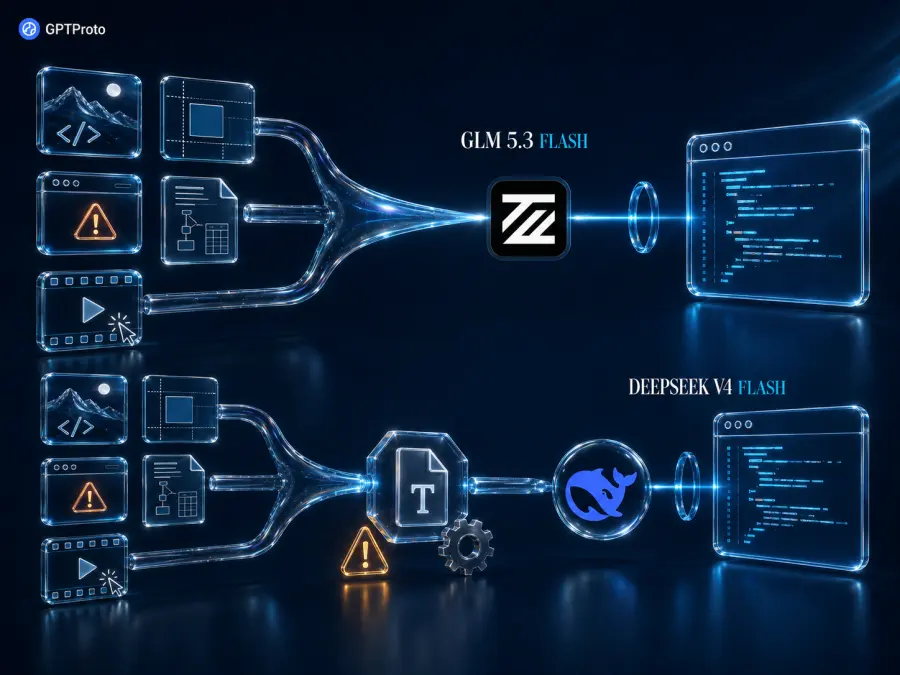
Beide Modelle sind jetzt multimodal. Damit ist eine der wichtigsten Schlussfolgerungen aus älteren Vergleichen mit DeepSeek V4 Flash überholt.
DeepSeek Flash kann Screenshots, Diagramme und Grafiken analysieren. GLM 5.3 Flash akzeptiert Bilder, Videos und Dateien und bietet damit eine breitere Eingabebasis für Interface-Workflows.
Ein Frontend-Agent könnte eines der beiden Modelle verwenden, um:
eine Seite anhand eines Screenshots nachzubauen
ein gerendertes Interface mit einer Designvorlage zu vergleichen
Abstands- und Ausrichtungsprobleme zu diagnostizieren
Screenshots von Browserfehlern auszulesen
mehrere Interface-Zustände zu prüfen
Quellcode mit visuellen Hinweisen zu kombinieren
In Community-Diskussionen wird GLM mitunter als besser für designorientierte Aufgaben und DeepSeek als reaktionsschneller beschrieben. Betrachte das als Ansatzpunkt für eigene Tests, nicht als gesicherte Tatsache. In denselben Diskussionen berichten Entwickler auch vom gegenteiligen Ergebnis, und die Latenz der Anbieter variiert erheblich. Eine Diskussion zu OpenCode bringt diese unterschiedlichen Einschätzungen deutlich zum Ausdruck.
Es gibt noch nicht genügend kontrollierte Belege, um einen Sieger beim visuellen Coding zu küren. Ein besserer Vergleich führt bei beiden Modellen dieselben drei Aufgaben durch:
Eine responsive Komponente anhand eines Screenshots nachbauen.
Eine Seite mit einem sichtbaren Fehler im mobilen Layout korrigieren.
Das neue Rendering mit der Vorlage vergleichen und die verbleibenden Unterschiede auflisten.
Beurteile das gerenderte Ergebnis, nicht die Selbstsicherheit der Antwort.
Welches Modell eignet sich besser für KI-Agenten?
Der Begriff „Agent“ umfasst ganz unterschiedliche Systeme. Ein Chat-Assistent, der ein Suchwerkzeug aufruft, hat wenig mit einem Coding-Prozess gemeinsam, der Dateien bearbeitet, Tests ausführt und es 30 Minuten lang erneut versucht.
Tool-Aufrufe und Workflow-Automatisierung
Beide Modelle unterstützen Tool-Aufrufe, strukturierte Ausgaben und Streaming. Beide können lange Gesprächsverläufe verarbeiten und fortfahren, nachdem Tool-Ergebnisse zurückgegeben wurden.
DeepSeeks Ergebnis von 69 % bei AutomationBench-AA ist das stärkere unabhängige Signal für die allgemeine Workflow-Automatisierung. Außerdem bietet es Thinking- und Non-Thinking-Modi, sodass die routinemäßige Tool-Auswahl nicht immer dasselbe Reasoning-Budget erfordert wie eine anspruchsvolle Planungsaufgabe.
GLM schneidet bei Terminal-Bench 4.0 besser ab und hat niedrigere Standardpreise für Ausgaben. Diese Kombination ist für Hintergrundsysteme attraktiv, die viele Befehle ausführen oder umfangreiche Ausgaben erzeugen.
Das Agenten-Framework steuert weiterhin den Workflow. Das Modell schlägt einen Tool-Aufruf vor; deine Anwendung validiert die Argumente, führt das Tool aus, gibt das Ergebnis zurück und entscheidet, ob ein weiterer Schritt zulässig ist. Der Wechsel zu einem besseren Modell ersetzt weder Berechtigungen noch Timeouts, Wiederholungsversuche oder Sandboxing.
Interaktive Agenten und Hintergrundagenten
Bei einem Agenten, der mit einem Menschen zusammenarbeitet, gehört die Latenz zur Qualität. Fast 20 Sekunden auf das erste Antwort-Token zu warten, fühlt sich anders an als etwa 11 Sekunden zu warten – selbst wenn die endgültigen Ausgaben ähnlich bewertet werden.
DeepSeek eignet sich besser für:
Interaktive Coding-Assistenten
Chatbasiertes Debugging
Tool-Aufrufe mit menschlicher Freigabe
Agenten, die während der Arbeit ihren Fortschritt anzeigen
Anwendungen, bei denen Nutzer langsame Anfragen abbrechen
GLM eignet sich besser für:
Hintergrundprüfungen von Repositories
Stapelanalysen von Code
Kostenbewusste Terminal-Aufgaben
Dokumenten- und Datei-Workflows
Systeme, bei denen die Kosten für die Fertigstellung wichtiger sind als sofortiges Feedback
Teste bei lang laufenden Agenten beide Modelle. Die Fehlerbehebung kann einen nominellen Preisvorteil zunichtemachen. Ein Modell, das pro Token 20 % günstiger ist, aber mehr Wiederholungsversuche braucht, kann pro abgeschlossener Aufgabe teurer sein.
Geschwindigkeit und Latenz
Die aktuellen unabhängigen Messungen zeigen in diesem Vergleich den deutlichsten Unterschied.
| Leistungskennzahl |
DeepSeek V4.1 Flash |
GLM 5.3 Flash |
| Ausgabegeschwindigkeit |
214 Token/s |
114 Token/s |
| Zeit bis zum ersten Token |
1.37s |
2.45s |
| Zeit bis zum ersten Antwort-Token |
10.70s |
19.96s |
| Antwortzeit insgesamt |
13.03s |
24.34s |
| Durchschnittliche Zeit pro ausgewerteter Aufgabe |
320.60s |
529.28s |
In dieser Momentaufnahme schloss DeepSeek die gemessene Antwort in etwa der halben Zeit ab.
Betrachte diese Werte nicht als dauerhafte Leistungszusagen der Anbieter. Prompt-Länge, Reasoning-Aufwand, aktuelle Serverauslastung, Streaming-Verhalten und Ausgabelänge können die wahrgenommene Latenz beeinflussen.
Die Richtung ist bei allen Messungen dennoch gleich: DeepSeek Flash ist das schnellere interaktive Modell.
Preise für DeepSeek Flash und GLM 5.3 Flash
GPT Proto bietet GLM 5.3 Flash derzeit 10 % unter den regulären Listenpreisen für Eingaben und Ausgaben an. Für DeepSeek Flash gelten die üblichen variablen Preise mit einem Rabatt von 50 % außerhalb der Spitzenzeiten.
| Preis pro 1 Mio. Token |
GLM 5.3 Flash |
DeepSeek außerhalb der Spitzenzeiten |
DeepSeek zu Spitzenzeiten |
| Neue Eingabe |
$0.135 |
$0.15 |
$0.30 |
| Gecachte Eingabe |
$0.03 |
$0.003 |
$0.006 |
| Ausgabe |
$0.45 |
$0.60 |
$1.20 |
Preise können sich ändern. Prüfe die aktuellen Modellseiten für GLM 5.3 Flash und DeepSeek Flash, bevor du feste Tarife in dein Produkt übernimmst.
Beispiel 1: Kurze Coding-Anfrage
Angenommen, eine Anfrage verwendet 10.000 neue Eingabe-Token und erzeugt 3.000 Ausgabe-Token.
| Modell |
Geschätzte Kosten |
| GLM 5.3 Flash |
$0.00270 |
| DeepSeek außerhalb der Spitzenzeiten |
$0.00330 |
| DeepSeek zu Spitzenzeiten |
$0.00660 |
Bei dieser gewöhnlichen Anfrage ohne Cache ist GLM günstiger.
Beispiel 2: Anfrage in Repository-Größe
Angenommen, es werden 200.000 neue Eingabe-Token und 20.000 Ausgabe-Token verwendet.
| Modell |
Geschätzte Kosten |
| GLM 5.3 Flash |
$0.036 |
| DeepSeek außerhalb der Spitzenzeiten |
$0.042 |
| DeepSeek zu Spitzenzeiten |
$0.084 |
GLM behält seinen Preisvorteil, wenn der größte Teil des Repository-Kontexts neu ist.
Beispiel 3: Agenten-Workload mit hoher Cache-Nutzung
Nehmen wir nun an, ein monatlicher Workload umfasst:
| Modell |
Geschätzte Kosten |
| DeepSeek außerhalb der Spitzenzeiten |
$9.24 |
| GLM 5.3 Flash |
$9.60 |
| DeepSeek zu Spitzenzeiten |
$18.48 |
Hier zeigt sich die Ausnahme, die von den Schlagzeilenpreisen verdeckt wird.
GLM bietet günstigere Standardpreise für Eingaben und Ausgaben. DeepSeeks gecachte Eingaben außerhalb der Spitzenzeiten sind zehnmal günstiger. Dadurch kann DeepSeek etwas unter GLM liegen, wenn ein Agent dieselbe Systemaufforderung, denselben Repository-Kontext und dieselben Tool-Definitionen wiederholt nutzt.
Eine Cache-Trefferquote von 80 % ist nicht selbstverständlich. Miss sie in der Produktion, bevor du dieses Beispiel als Budgetprognose verwendest.
Welches Modell ist kosteneffizienter?
Für gewöhnliche API-Aufrufe ist GLM 5.3 Flash kosteneffizienter. Die GPT Proto-Preise für Eingaben und Ausgaben sind niedriger, und die unabhängige Evaluierung weist etwas geringere durchschnittliche Aufgabenkosten aus: 0,25 $ gegenüber 0,27 $.
Bei Workloads mit hoher Cache-Nutzung außerhalb der Spitzenzeiten kann DeepSeek günstiger sein.
Bei nutzerorientierten Produkten macht die Geschwindigkeit den Vergleich komplizierter. Eine schnellere Antwort kann die Abschlussrate verbessern und abgebrochene Anfragen verringern. Dieser Wert ist in einer Tabelle mit Tokenpreisen nicht sichtbar.
Die faire Entscheidungsregel lautet:
Wähle GLM, wenn die meisten Eingaben neu sind und die Ausgabekosten den Ausschlag geben.
Wähle DeepSeek außerhalb der Spitzenzeiten, wenn der größte Teil des Kontexts wiederverwendet wird.
Wähle DeepSeek, wenn die Antwortzeit Teil des Produkterlebnisses ist.
Vergleiche die Kosten pro akzeptiertem Ergebnis, wenn Fehler und Wiederholungsversuche häufig sind.
Beide Modelle mit einem einzigen GPT Proto-API-Schlüssel nutzen
Du brauchst keine zwei separaten Anbieterintegrationen, um diese Modelle zu evaluieren.
GPT Proto bietet OpenAI-kompatiblen Zugriff auf beide Modelle. API-Schlüssel, Basis-URL und Anfrageformat können gleich bleiben; zum Weiterleiten einer Anfrage musst du nur die Modellbezeichnung ändern.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["GPTPROTO_API_KEY"],
    base_url="https://gptproto.com/v1",
)

# Use "glm-5.3-flash" for lower standard token prices.

# Switch to "deepseek-flash" for lower latency.
MODEL = "deepseek-flash"

response = client.chat.completions.create(
    model=MODEL,
    messages=[
        {
            "role": "system",
            "content": (
                "You are a coding assistant. Inspect the problem, "
                "propose the smallest safe change, and explain how to test it."
            ),
        },
        {
            "role": "user",
            "content": (
                "This Python function occasionally returns duplicate IDs. "
                "Find the likely race condition and propose a fix."
            ),
        },
    ],
)

print(response.choices[0].message.content)
Ein einzelner Schlüssel erstellt nicht von selbst ein Multi-Agenten-System. Deine Anwendung, dein Coding-Tool oder dein Agenten-Framework entscheidet weiterhin, welcher Worker eine Aufgabe erhält, welches Modell verwendet wird und wie die Ergebnisse zusammengeführt werden.
Die gemeinsame API macht doppelte Integrationen überflüssig. Du kannst Terminal-Aufgaben an GLM und interaktive Anfragen an DeepSeek weiterleiten und einen Fallback einrichten, ohne separate Anbieterzugangsdaten und Guthaben verwalten zu müssen.
Entdecke beide Modelle im GPT Proto-Modellkatalog.
Fazit
DeepSeek Flash ist die bessere Wahl für interaktives Coding und latenzempfindliche Agenten. Es erzeugt Token deutlich schneller, liefert das erste Antwort-Token früher, unterstützt lange Ausgaben und schneidet bei Workflow-Automatisierung und beim Abruf aus langem Kontext gut ab.
GLM 5.3 Flash ist die bessere Wahl bei niedrigeren Standardkosten pro Token, Terminal-orientierten Agenten und Stapelverarbeitung. Sein unabhängiger Gesamtwert ist etwas höher, und pro ausgewerteter Aufgabe werden weniger Ausgabe-Token benötigt.
Beim Frontend-Coding gibt es keinen nachgewiesenen Sieger. Beide akzeptieren Screenshots. GLM akzeptiert zusätzlich Video- und Dateieingaben, während DeepSeek schneller reagiert. Führe vor der Entscheidung denselben visuellen Regressionstest mit beiden Modellen durch.
Bei Agentenkosten solltest du nicht beim Preisverzeichnis stehen bleiben. GLM ist bei gewöhnlichen Token günstiger. DeepSeek kann günstiger werden, wenn wiederverwendeter Kontext außerhalb der Spitzenzeiten eine hohe Cache-Trefferquote bewirkt.
Wenn ich ein neues Coding-Produkt entwickeln würde, würde ich mich nicht für nur ein Modell entscheiden. Ich würde DeepSeek Flash als interaktive Standardoption nutzen, GLM 5.3 Flash für ausgewählte Stapel- und Terminal-Aufgaben einsetzen und Routing-Entscheidungen hinter derselben API-Schnittstelle verwalten.