Was ist GLM-5.3 Flash?
Z.ai beschreibt GLM-5.3 Flash als ein Modell für Programmierung, multimodale Agenten und professionelle Aufgaben mit Benutzeroberflächen, Dokumenten, Diagrammen und anderen visuellen Informationen. Anders als GLM-5.3, ein Textmodell, das vor allem durch zusätzliches Post-Training verbessert wurde, basiert Flash auf einem neuen Basismodell, das mit einem multimodalen Korpus aus 30 Billionen Tokens trainiert wurde.
Hier sind die wichtigsten Spezifikationen zum Marktstart:
| Spezifikation |
GLM-5.3 Flash |
| Entwickler |
Z.ai / Zhipu AI |
| Veröffentlichungsdatum |
26. August 2026 |
| Architektur |
Mixture of Experts mit hybrider linearer und sparsamer Attention |
| Parameter insgesamt |
320B |
| Aktive Parameter |
18B pro Token |
| Transformer-Schichten |
45 |
| Kontextfenster |
1,048,576 Tokens |
| Maximale Ausgabe |
131,072 Tokens |
| Eingabe |
Text, Bilder, Videos und Dateien |
| Ausgabe |
Text |
| Reasoning |
Immer aktiviert; geringer, hoher und maximaler Aufwand |
| Offizielle Modell-ID |
glm-5.3-flash |
| Lizenz für die Modellgewichte |
MIT |
Die offiziellen Modellgewichte sind unter der MIT-Lizenz verfügbar. Damit ist das Modell mit offenen Gewichten ausgestattet und kann gemäß den Lizenzbedingungen kommerziell genutzt werden. Das bedeutet nicht, dass gehostete Inferenz kostenlos ist: Rechenleistung, Speicher und API-Tokens kosten weiterhin Geld.
Ist GLM-5.3 Flash das Flaggschiffmodell von Z.ai?
Nein. Z.ai bezeichnet GLM-5.3 als sein Flaggschiff-Textmodell. GLM-5.3 Flash nimmt eine andere Rolle ein: kostengünstigere Inferenz und native multimodale Eingabe.
Dieser Unterschied ist wichtig, denn die beiden Modelle haben nicht dieselbe Basis. GLM-5.3 ist ein durch Post-Training verbessertes Modell auf Basis von GLM-5.2. GLM-5.3 Flash wurde als neues multimodales Basismodell trainiert. Flash als günstigere GLM-5.3-Einstellung zu bezeichnen, lässt den wichtigsten architektonischen Unterschied außer Acht.
Wie hängen GLM-5.3 Flash und OxAlpha zusammen?
OxAlpha war der anonyme Vorschau-Name von GLM-5.3 Flash.
Vor der offiziellen Veröffentlichung stellte Z.ai das Modell über OpenCode und eine öffentliche Vorschau-Route unter dem Namen ox-alpha bereit. Das Unternehmen erklärt, man habe den anonymen Start genutzt, um Feedback zu sammeln, ohne den Nutzern die Marke GLM zu präsentieren. Z.ai zufolge wurde OxAlpha während der Vorschauwoche zum meistgenutzten Modell auf diesen Diensten; der Datenverkehr wurde über chinesische KI-Chips verarbeitet.
Dies war nicht der erste anonyme Modelltest von Z.ai. Der Ansatz trennt einen Teil des Nutzerverhaltens von den Erwartungen an eine Marke, doch kostenloser Zugang, die Platzierung in Coding-Tools und Neugier beeinflussen die Nutzung weiterhin.
Das Geheimnis lieferte dennoch nützliche Erkenntnisse. Stripe-CEO Patrick Collison probierte das Modell aus und schrieb: „Es ist sehr beeindruckend“. Ein kleiner Community-Coding-Test meldete acht erfolgreich abgeschlossene Repository-Aufgaben von zehn. Diese Schlagzeile verbreitete sich schnell, doch die Stichprobe war winzig und verglichen wurde ein OxAlpha-Versuch mit vier Versuchen für die Referenzmodelle.
Ein späterer öffentlicher DeepSWE-Community-Test liefert einen besseren Kontext: OxAlpha löste 66 von 113 Aufgaben, also 58,4 %, mit einem dokumentierten Mini-Setup für einen Software-Engineering-Agenten. Einige Aufgaben scheiterten außerdem an der Formatierung von Tool-Aufrufen und nicht an der eigentlichen Code-Lösung. Es handelt sich weiterhin um einen einzelnen Community-Test, nicht um eine allgemeingültige Modellrangliste. Aber 113 Aufgaben sagen mehr aus als zehn.
Auch die Reaktionen auf Reddit folgten demselben Muster. Enthüllungs-Threads in r/LocalLLaMA und r/singularity erhielten Hunderte von Stimmen. Entwickler schätzten die MIT-Lizenz und den Tokenpreis; Nutzer lokaler Modelle wiesen darauf hin, dass ein 320B-Checkpoint nicht in einen Desktop-PC passt. Andere berichteten von inkonsistenter Planung oder langsamen Antworten in der Vorschau. Das sind Einzelfallberichte, aber sie zeigen die richtigen Prüfpunkte: Befolgung von Anweisungen, Zuverlässigkeit von Agenten, Latenz und Gesamtzahl der verwendeten Tokens.
Die praktische Schlussfolgerung ist einfach: OxAlpha und GLM-5.3 Flash gehören zur selben Modellreihe, doch OxAlpha-Ergebnisse stammen aus einer anonymen Vorschauphase. Betrachten Sie diese Berichte als erste Praxiserfahrungen und testen Sie anschließend das veröffentlichte Modell mit Ihrem eigenen Repository und Workflow.
Was hat sich bei GLM-5.3 Flash geändert?
Die Effizienz des Modells beruht nicht nur darauf, dass weniger Experten aktiviert werden.
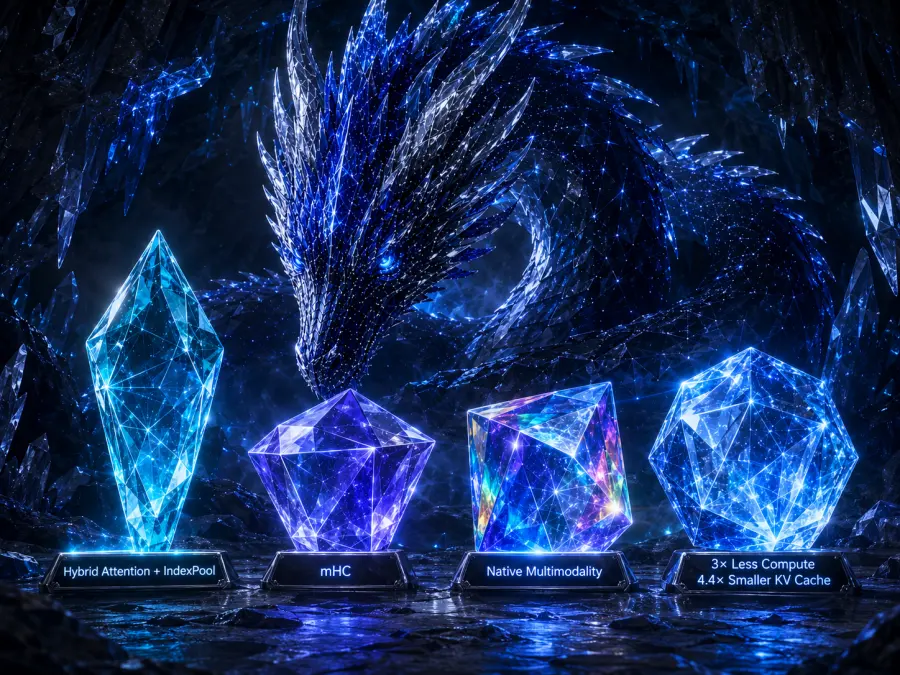
Erstens kombiniert GLM-5.3 Flash lineare Attention für lokale Abhängigkeiten mit sparsamer Attention, um Informationen aus weit entfernten Teilen des Kontexts abzurufen. Z.ai hat außerdem IndexPool eingeführt, das jeweils vier Schlüsselvektoren des Indexers zu einem zusammenfasst. Dadurch sinken Speicherbedarf und Latenz beim Auffinden relevanter Tokens in einem Prompt mit einer Million Tokens.
Zweitens verwendet das Modell Manifold-Constrained Hyper-Connections, kurz mHC. Einfach gesagt verändert mHC die Art und Weise, wie Informationen über die Schichten hinweg kombiniert werden. So kann Z.ai das Modell skalieren und gleichzeitig Training und Inferenz stabil halten.
Drittens ist Multimodalität Teil des Vortrainings und kein nachträglich hinzugefügter Bildadapter für ein fertig trainiertes Textmodell. Ein Coding-Agent kann eine gerenderte Seite prüfen, ein fehlerhaftes Layout erkennen, den Code bearbeiten und die nächste Darstellung überprüfen. Derselbe Ablauf funktioniert bei der Browser-Nutzung, der Bedienung eines Desktops, Diagrammen und Dokumenten.
Z.ai zufolge benötigt Flash etwa dreimal weniger Rechenleistung für Attention als GLM-5.3 und hat einen durchschnittlichen KV-Cache, der 4,4-mal kleiner ist. Das sind Berechnungen des Anbieters und keine unabhängigen Messungen des Inferenzbetriebs. Sie erklären jedoch, wie ein Modell mit insgesamt 320B Parametern zu einem deutlich niedrigeren Tokenpreis angeboten werden kann.
Ein Satz bringt den Kompromiss auf den Punkt: günstiger im Einsatz, aber nicht unbedingt schneller in der Antwort.
Was kann GLM-5.3 Flash?
GLM-5.3 Flash ist für Aufgaben konzipiert, bei denen sprachliches Schlussfolgern und visuelles Feedback zusammenkommen.
Für Coding-Agenten umfasst das Repository-Analysen, Debugging, Terminal-Aufgaben, Function Calling und lang laufende Änderungen, die mehrere Tool-Schritte erfordern. Die native Bildverarbeitung ermöglicht außerdem die Nachbildung von Frontends anhand von Screenshots, die Prüfung gerenderter Benutzeroberflächen, die Browser-Bedienung, Spieleentwicklung und visuelle Kontrollen von 3D-Szenen. Ein reines Textmodell kann CSS schreiben; ein multimodales Modell kann sich auch das Ergebnis ansehen.
Bei Büroarbeiten kann es PDFs, Tabellen, Präsentationen, Dashboards, Diagramme und Screenshots interpretieren. Es kann ein Diagramm finden, es mit dem umgebenden Text vergleichen, strukturiertes JSON zurückgeben und das Ergebnis an ein anderes Tool übergeben. Das Kontextfenster mit einer Million Tokens bietet Platz für große Repositories oder lange Berichte, doch seine Nutzung erhöht Kosten für Eingaben und Latenz.
Zu den API-Funktionen gehören Function Calling, strukturierte Ausgaben, Streaming, Kontext-Caching, Browser-Nutzung und Computer-Bedienung. Reasoning bleibt aktiviert, mit den Aufwandsstufen low, high und max. Für routinemäßige Datenextraktion ist eine niedrigere Stufe ein guter Ausgangspunkt; die maximale Stufe ist für schwierige Programmier- und Agentenaufgaben gedacht. Mehr Reasoning kann die Qualität einer anspruchsvollen Antwort verbessern, kostet aber zusätzliche Tokens und Zeit.
Unterstützt GLM-5.3 Flash Videoeingaben?
Ja. GLM-5.3 Flash unterstützt native Videoeingaben und gibt Text zurück.
Videoeingaben sind wichtig, wenn Informationen zeitlich verknüpft sind und nicht in einem einzelnen Bildausschnitt enthalten sind. Das Modell kann eine Bildschirmaufnahme analysieren, die Abfolge erkennen, die einen UI-Fehler verursacht hat, eine Demonstration zusammenfassen, Ereignisse in einer Besprechung finden oder aus einem Tutorial eine geordnete Anleitung erstellen. Es kann Videos auch mit Code kombinieren – zum Beispiel eine fehlerhafte Interaktion prüfen und Änderungen am Frontend vorschlagen.
Dabei geht es um das Verstehen von Videos, nicht um deren Erzeugung. GLM-5.3 Flash kann Videoinhalte beschreiben, darüber schlussfolgern und darauf basierend handeln, aber keine neue Videodatei ausgeben.
Preise für GLM-5.3 Flash
Z.ai führte GLM-5.3 Flash mit einer zeitlich begrenzten Aktion von 50 % Rabatt ein. Die Aktion endet am 9. September 2026 um 24:00 Uhr (UTC+8). Der Einführungspreis von GPT Proto basiert auf dem regulären Listenpreis von Z.ai und nicht auf der befristeten Aktion.
| Pro 1 Mio. Tokens |
Z.ai regulär |
Z.ai-Einführungsaktion |
GPT Proto-Einführungspreis |
| Neue Eingaben |
$0.15 |
$0.075 |
$0.015 |
| Gecachte Eingaben |
$0.03 |
$0.015 |
$0.003 |
| Ausgabe |
$0.50 |
$0.25 |
$0.05 |
Kalkulieren Sie mit dem regulären Preis, nicht mit dem Einführungspreis. Aktionen laufen aus; Produktions-Workloads in der Regel nicht.
Der reguläre Preis liegt deutlich unter dem von GLM-5.3: 1,40 $ für Eingaben und 4,40 $ für Ausgaben. Der Tokenpreis ist jedoch nur ein Teil der Kosten. Artificial Analysis stellte in seiner Intelligence-Index-Auswertung fest, dass das Modell ungewöhnlich ausführlich ist. Wenn ein Modell mehr Reasoning- und Antwort-Tokens ausgibt, kann das einen Teil des scheinbaren Preisvorteils pro Token zunichtemachen. Kontext-Caching hilft, wenn ein Coding-Agent wiederholt denselben Repository-Kontext übermittelt; neue Prompts und generierte Ausgaben werden jedoch weiterhin berechnet.
Bei 0,015 $ pro Million neuer Eingabe-Tokens und 0,05 $ pro Million Ausgabe-Tokens beträgt der Einführungspreis von GPT Proto 10 % des regulären Preises von Z.ai – eine Reduzierung um 90 %. Die aktuelle Verfügbarkeit und Abrechnungsdetails finden Sie auf der API-Modellseite für GLM-5.3 Flash.
Wie gut ist GLM-5.3 Flash?
Darauf gibt es zwei Antworten: die Benchmarks von Z.ai zum Marktstart und die ersten unabhängigen Messungen. Sie sollten nicht zu einer einzigen Aussage vermischt werden.
Veröffentlichte Benchmark-Ergebnisse von Z.ai
Z.ai berichtet die folgenden Ergebnisse. Der Vergleich ist hilfreich, um die vorgesehenen Stärken des Modells zu erkennen, bleibt aber eine vom Anbieter durchgeführte Bewertung.
| Benchmark |
GLM-5.3 Flash |
GLM-5.2 |
DeepSeek V4 Vision Exp |
Claude Opus 4.8 |
| Terminal-Bench 2.1 |
84.3 |
81.0 |
83.9 |
85.0 |
| DeepSWE v1.1 |
63.4 |
46.2 |
59.3 |
58.0 |
| Toolathlon Verified |
78.4 |
59.9 |
75.9 |
76.2 |
| AutomationBench |
48.8 |
26.2 |
38.8 |
41.0 |
| Chartography mit Tools |
78.0 |
— |
64.3 |
75.0 |
Diese Ergebnisse stützen eine engere Schlussfolgerung als „Flash schlägt Opus“. Das Modell von Z.ai scheint bei Programmierung, Tool-Nutzung und visuellen Agentenaufgaben konkurrenzfähig zu sein, doch Opus 4.8 liegt in einigen Kategorien, darunter Terminal-Bench und NL2Repo, weiterhin vorn. Noch wichtiger: In dieser Tabelle wird Opus 4.8 verglichen – nicht Claude Opus 5.
Was unabhängige Tests zeigen
Stand 27. August bewertet Artificial Analysis GLM-5.3 Flash mit einem Intelligence-Index-Wert von 57. Die gemessene Ausgabegeschwindigkeit lag bei ungefähr 50 Tokens pro Sekunde; die geschätzten Kosten pro Intelligence-Index-Aufgabe betrugen zum Listenpreis etwa 0,09 $. In der Bewertung wurde das Modell außerdem als langsamer als der Durchschnitt und im Vergleichsfeld als sehr ausführlich eingestuft.
Für den Preis ist das ein gutes Ergebnis. Es belegt jedoch nicht, dass Flash das schnellste oder insgesamt leistungsstärkste Modell ist.
GLM-5.3 Flash im Vergleich zu GLM-5.3, DeepSeek V4 Pro und Claude Opus 5
Die folgende Tabelle verwendet, sofern verfügbar, denselben unabhängigen Evaluator und Varianten mit maximalem Reasoning-Aufwand. Da sich diese Momentaufnahmen der Dienste ändern können, sollten Sie die Geschwindigkeitswerte als Messungen und nicht als dauerhafte Spezifikationen betrachten.
| Modell |
Intelligence Index |
Ausgabegeschwindigkeit |
Kosten pro Aufgabe |
Listenpreis Eingabe / Ausgabe |
| GLM-5.3 Flash |
57 |
~50 tok/s |
$0.09 |
$0.15 / $0.50 |
| GLM-5.3 |
60 |
~87 tok/s |
$0.68 |
$1.40 / $4.40 |
| DeepSeek V4 Pro 0813 |
53 |
~67 tok/s |
$0.27 |
$1.32 / $3.96 |
| Claude Opus 5 |
63 |
~55 tok/s |
$2.34 |
$5.00 / $25.00 |
Wählen Sie GLM-5.3 Flash, wenn Sie Bild- oder Videoeingaben, offene Modellgewichte oder möglichst niedrige Tokenkosten benötigen. Wählen Sie GLM-5.3, wenn Ihre Arbeit ausschließlich textbasiert ist und die zusätzlichen drei Intelligence-Index-Punkte, höheren Coding-Werte und schnellere Ausgabe den Preis rechtfertigen.
Das ist kein gewöhnlicher Upgrade-Pfad, bei dem das Modell mit der neueren Versionsnummer das ältere ersetzt. Die beiden Modellzweige sind auf unterschiedliche Anforderungen ausgelegt. GLM-5.3 auf GPT Proto ansehen, wenn Ihr aktueller Workload textbasiertes Coding oder Agentenaufgaben mit langem Zeithorizont umfasst.
GLM-5.3 Flash im Vergleich zu DeepSeek V4 Pro
In der unabhängigen Momentaufnahme erzielte GLM-5.3 Flash vier Punkte mehr und kostet zum Listenpreis weniger. Außerdem akzeptiert es visuelle Eingaben, während die getestete DeepSeek-V4-Pro-Route ausschließlich Text verarbeitet. DeepSeek V4 Pro erzeugte Ausgaben schneller und kann für etablierte Text- und Coding-Pipelines weiterhin besser geeignet sein, wenn Multimodalität keinen Mehrwert bietet.
Entscheiden Sie sich nicht allein aufgrund eines zusammengesetzten Werts. Führen Sie dieselbe Repository-Aufgabe mit festgelegten Abnahmetests durch und protokollieren Sie Wiederholungsversuche und Tokens. Sie können DeepSeek V4 Pro auf GPT Proto ansehen, bevor Sie beide Workflows testen.
GLM-5.3 Flash im Vergleich zu DeepSeek V4 Flash Vision Exp
Diese Modelle sind hinsichtlich ihres Produktprofils engere Konkurrenten: Beide zielen auf kostengünstige Coding- und visuelle Aufgaben ab. In der eigenen Bewertung von Z.ai erzielte GLM-5.3 Flash bei DeepSWE 63,4 gegenüber 59,3 und bei Chartography mit Tools 78,0 gegenüber 64,3. Betrachten Sie diese Zahlen als Angaben von Z.ai, bis die Modelle in einem kontrollierten, unabhängigen Vergleich visueller Agenten getestet wurden.
GLM-5.3 Flash bietet MIT-lizenzierte Gewichte, native Video- und Dateieingaben sowie ein Kontextfenster mit einer Million Tokens. DeepSeek V4 Flash Vision Exp ist weiterhin ein experimenteller Vision-Zweig und könnte für Teams sinnvoller sein, die bereits die zugehörige Modellfamilie nutzen. DeepSeek V4 Flash Vision Exp auf GPT Proto ansehen.
GLM-5.3 Flash im Vergleich zu Claude Opus 5
In der unabhängigen Gesamtbewertung liegt Claude Opus 5 mit 63 Punkten weiterhin vor GLM-5.3 Flash mit 57 Punkten. Auch der Listenpreis des Anbieters ist mit 5 $ pro Million Eingabe-Tokens und 25 $ pro Million Ausgabe-Tokens deutlich höher. GLM-5.3 Flash ist die kostengünstige Wahl; Opus 5 ist die erste Wahl, wenn Qualität Vorrang hat und eine fehlgeschlagene Aufgabe mehr kostet als die Tokenrechnung.
Die entscheidende methodische Korrektur lautet: In der Veröffentlichungstabelle von Z.ai wird Flash mit Opus 4.8 verglichen. Sie kann daher nicht belegen, dass GLM-5.3 Flash Opus 5 übertrifft. Informationen zur aktuellen Opus-Option finden Sie unter Claude Opus 5 auf GPT Proto ansehen.
Kann GLM-5.3 Flash lokal ausgeführt werden?
Ja, aber „18B aktiv“ bedeutet nicht, dass das Modell wie ein dichtes 18B-Modell in den Speicher passt.
Stellen Sie sich die 320B Parameter als Lagerhalle und die 18B aktiven Parameter als die Regale vor, auf die bei einer einzelnen Bestellung zugegriffen wird. Der Router reduziert den Rechenaufwand pro Token, aber die Lagerhalle muss trotzdem irgendwo untergebracht werden.
Der FP8-Checkpoint belegt ungefähr 328 GB dezimal beziehungsweise rund 306 GiB. Der modellspezifische KTransformers-Bereitstellungsleitfaden empfiehlt mindestens 350 GB verfügbaren Systemspeicher, ohne den Bedarf anderer gleichzeitig laufender Programme einzurechnen. Z.ai nennt außerdem SGLang, vLLM und TokenSpeed als unterstützte Inferenzoptionen.
Die ehrliche Beschreibung lautet also nicht „ein kleines lokales Modell“. Es ist ein großes, rechnungseffizientes Modell, das Teams mit viel Speicherkapazität selbst hosten können. Für die meisten einzelnen Entwickler und kleinen Teams ist der Zugriff über eine gehostete API einfacher, als den vollständigen Checkpoint zu speichern und bereitzustellen.
Günstig im Einsatz. Teuer im Betrieb.
So erhalten Sie Zugriff auf GLM-5.3 Flash
Zum Marktstart können Entwickler das gehostete Modell von Z.ai mit der ID glm-5.3-flash verwenden, über geeignete Coding-Tarife darauf zugreifen oder die MIT-lizenzierten Gewichte zur lokalen Bereitstellung herunterladen.
Die GLM-5.3-Flash-API auf GPT Proto wird jetzt eingeführt und unterstützt die nativen Text-, Bild-, Video- und Dateieingaben des Modells. Sie nutzt das gemeinsame Guthaben von GPT Proto und kostet 10 % des regulären Listenpreises von Z.ai.
Als Alternativen können Sie GLM-5.3 für textorientiertes Coding, DeepSeek V4 Pro für Text- und Agenten-Workflows oder Claude Opus 5 wählen, wenn Leistung wichtiger ist als der Tokenpreis.
Lohnt sich GLM-5.3 Flash?
Ja – wenn Ihr Workload tatsächlich von der Kombination aus multimodalen Eingaben, großem Kontext und niedrigen Tokenpreisen profitiert.
GLM-5.3 Flash ist eine starke Option für visuelle Coding-Agenten, umfangreiche Dokumente, Videoverständnis und Agentenaufgaben im Batchbetrieb, bei denen GLM-5.3 oder Opus 5 zu teuer wären. Die MIT-lizenzierten Gewichte ermöglichen außerdem Self-Hosting.
Weniger geeignet ist es, wenn Sie die schnellstmögliche sichtbare Antwort benötigen, ein kleines lokales Modell erwarten oder unabhängig vom Preis den höchsten verfügbaren Reasoning-Wert anstreben. In der aktuellen unabhängigen Messung ist GLM-5.3 schneller. Opus 5 erzielt einen höheren Wert. Beide kosten mehr.
Meine Einschätzung: Z.ai hat den richtigen Kompromiss gefunden. GLM-5.3 Flash ersetzt das Flaggschiff nicht. Es macht eine andere Art von Workload wirtschaftlich: multimodale Agenten, die Inhalte betrachten, Schlussfolgerungen ziehen, Tools aufrufen und weitermachen müssen, ohne dass für jedes Token der Preis eines Flaggschiffmodells anfällt.