Mehrere Seiten, die unmittelbar nach dem Start von DeepSeek V4 Flash Vision Exp veröffentlicht wurden, nennen bereits den falschen Preis. So schnell geht diese Veröffentlichung vonstatten.
DeepSeek V4 Flash Vision Exp ist eine experimentelle Version von V4 Flash, die neben Text auch Bilder akzeptieren kann. Sie kann Screenshots untersuchen, Text in Bildern lesen, Diagramme analysieren und das Ergebnis an Tools weitergeben. DeepSeek hat sie am 21. August 2026 unter der Modell-ID deepseek-v4-flash-vision-exp veröffentlicht. 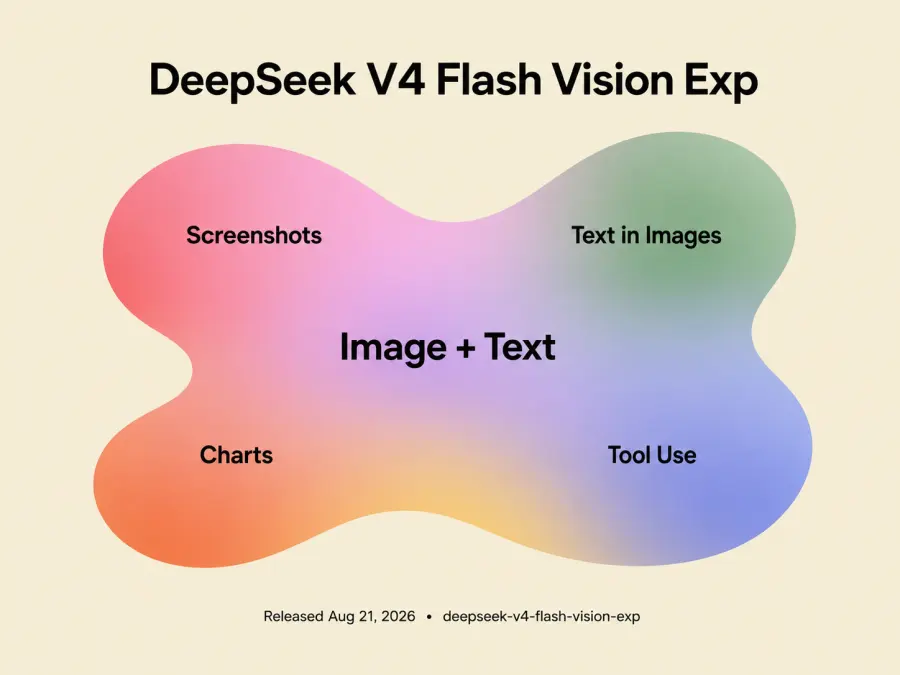
Entscheidend ist, was es nicht ist. Es handelt sich weder um einen neuen Bildgenerator noch um ein pauschales Upgrade für jeden V4-Flash-Workload. DeepSeek positioniert es als experimentellen, um Bildverarbeitung erweiterten Zweig mit weitgehend denselben Textfähigkeiten wie V4 Flash. Wenn Ihre Anwendung keine Bilder sendet, ist das standardmäßige Textmodell weiterhin die einfachere Wahl.
DeepSeek V4 Flash Vision Exp ist jetzt über GPTProto verfügbar. Entwickler können Text- und Bildeingaben über die GPTProto-Route des Modells senden und dafür dasselbe Konto, denselben API-Schlüssel und dasselbe gemeinsame Guthaben wie für andere unterstützte Modelle verwenden. Auf der aktuellen Modellseite sind Standardpreise von 0,44 $ pro Million Eingabe-Tokens und 1,32 $ pro Million Ausgabe-Tokens angegeben; außerdem gelten zeitabhängige Nebenzeitpreise.
Das Modell ist weiterhin experimentell. Bevor Sie Produktions-Traffic darauf umleiten, testen Sie das genaue Bildformat, die Anfragebeschränkungen, die Latenz und das Fallback-Verhalten, die im aktuellen Quick Start von GPTProto beschrieben sind.
Was hat sich gegenüber DeepSeek V4 Flash geändert?
Das Upgrade ist eng umrissen, aber nützlich: V4 Flash kann jetzt visuellen Kontext verarbeiten. Eine Anfrage kann Text sowie ein oder mehrere JPEG-, PNG-, GIF- oder WebP-Bilder enthalten. DeepSeek stellt diese Funktion über seine OpenAI-kompatiblen Chat Completions- und Responses-APIs sowie seine Anthropic-kompatible Messages-API bereit.
Bilder können auf drei Arten übermittelt werden:
Eine in die Anfrage eingebettete Base64-Daten-URL.
Eine öffentlich zugängliche HTTP- oder HTTPS-URL.
Eine über die Files API erstellte file_id.
Die dritte Option ist wichtig, wenn ein Agent denselben Screenshot mehrmals untersuchen muss. Laden Sie ihn einmal hoch, verwenden Sie die Kennung erneut und vermeiden Sie es, bei jeder Anfrage die gesamte Datei zu senden. DeepSeek zufolge sind Uploads über die Files API kostenlos, die Inferenz jedoch nicht: Das Bild wird weiterhin in Eingabetokens umgewandelt und zusammen mit dem begleitenden Text abgerechnet.
Hier ist der praktische Vergleich der drei aktuellen V4-Varianten:
| Modell |
Bildeingabe |
Offizieller Kontext / maximale Ausgabe |
Spitzenpreis für Cache-Miss-Eingabe / Ausgabe |
Geeignet für |
| DeepSeek V4 Flash Vision Exp |
Ja |
1M / 384K |
$0.44 / $1.32 pro 1 Mio. Tokens |
Experimente mit Screenshots, Diagrammen, Dokumentbildern und GUI-Agenten |
| DeepSeek V4 Flash |
Nein |
1M / 384K |
$0.44 / $1.32 pro 1 Mio. Tokens |
Textverarbeitung mit hohem Volumen, Extraktion, Chat und routinemäßige Agenten-Teilaufgaben |
| DeepSeek V4 Pro |
Nein |
1M / 384K |
$1.32 / $3.96 pro 1 Mio. Tokens |
Anspruchsvollere Programmier-, Reasoning- und längere Agentenaufgaben |
Das sind die derzeitigen offiziellen Spitzenpreise, keine Garantie dafür, dass die Preise unverändert bleiben. DeepSeek behält sich ausdrücklich das Recht vor, sie anzupassen.
Meine praktische Einschätzung ist einfach: Wählen Sie Vision Exp, weil Sie Bildeingaben benötigen – nicht, weil Vision nach einer höheren Modellklasse klingt. Wählen Sie V4 Flash, wenn die Arbeit ausschließlich textbasiert und kostensensibel ist. Für schwierige Textaufgaben empfiehlt sich V4 Pro, wenn die höhere Reasoning-Qualität ungefähr den dreifachen offiziellen Tokenpreis wert ist.
Die Funktionen von DeepSeek V4 Flash Vision Exp – und seine tatsächlichen Grenzen
Die kurze Funktionsliste wirkt großzügig: kombinierte Text- und Bildeingaben, Tool-Aufrufe, JSON-Ausgabe, einstellbarer Thinking-Modus, drei API-Formate und derselbe 1M-Token-Kontext wie bei den anderen V4-Modellen. Ob diese Funktionen in einem produktiven Workload tatsächlich bestehen, entscheiden jedoch die Grenzen.
| Eingabemethode |
Grenze |
Am besten geeignet für |
Base64 oder inline file_data |
Gesamter Anfrageinhalt: 48 MiB |
Lokale Bilder und einmalige Anfragen |
| Externe URL |
URL: 8.192 Zeichen; Bild: 32 MiB; Download: 60 Sekunden |
Öffentliche Bilder, die bereits gehostet werden |
Files API file_id |
Bild: 64 MiB |
Wiederverwendete Bilder oder Anfragen, die das Inline-Limit überschreiten würden |
Die Platzierung von Bildern hängt vom API-Format ab. Bei Chat Completions- und Anthropic-kompatiblen Messages-Anfragen gehören Bildinhalte in eine User-Nachricht. Die Responses API kann Bilder auch in Developer-Nachrichten und in unterstützten Tool-Call-Ausgaben empfangen. Bilder in System- oder Assistant-Nachrichten führen zu einem 400-Fehler. Auch das Senden eines Bildes an die reinen Textvarianten V4 Flash oder V4 Pro führt zu einem Fehler, da diese Modelle keine nativen Bildeingaben akzeptieren.
Vision Exp unterstützt die Detailstufen low, high, original und auto für image_url-Eingaben, wendet jedoch weiterhin den dokumentierten Skalierungsprozess an. Bilder mit einer Gesamtpixelgröße von ungefähr weniger als 384×384 werden vergrößert. Größere Bilder werden unter Beibehaltung des Seitenverhältnisses verkleinert, bis ihre Gesamtpixelzahl ungefähr 800×800 entspricht.
Durch diese Skalierung ergibt sich eine Obergrenze von 384 Eingabetokens pro Bild. Das macht die Kosten vorhersehbar. Der Kompromiss ist die Auflösung: Winzige Beschriftungen, dichte Tabellen, feine Diagramm-Anmerkungen und kleine UI-Texte überstehen die Verkleinerung möglicherweise nicht. Eine Quelle mit 5.000×5.000 Pixeln liefert nicht mehr Bildtokens als eine mit 2.000×2.000 Pixeln.
Eine weitere Einschränkung lässt sich leicht übersehen: Vision Exp unterstützt keine FIM-Vervollständigung, V4 Flash und V4 Pro dagegen schon – im Nicht-Thinking-Modus. Entwickler, die Inline-Codevervollständigungstools erstellen, sollten die Vision-Variante nicht als direkten Ersatz betrachten.
Preise für DeepSeek V4 Flash Vision Exp
Ich habe am 24. August 2026 DeepSeeks aktuelle Preistabelle geprüft. Die Preise lauten:
| Tokentyp |
Nebenzeiten |
Spitzenzeiten |
| Cache-Treffer-Eingabe |
$0.007 pro 1 Mio. |
$0.014 pro 1 Mio. |
| Cache-Miss-Eingabe |
$0.22 pro 1 Mio. |
$0.44 pro 1 Mio. |
| Ausgabe |
$0.66 pro 1 Mio. |
$1.32 pro 1 Mio. |
Die Spitzenzeiten sind montags bis freitags von 01:00–04:00 und 06:00–10:00 UTC. Zu allen anderen Zeiten, auch am Wochenende, gilt der halb so hohe Nebenzeitenpreis.
Einige kürzlich indexierte Erklärungen nennen noch $0.14 pro Million Eingabetokens und $0.28 pro Million Ausgabetokens. Richten Sie Ihr Budget nicht nach diesen Zahlen aus. Sie stimmen nicht mehr mit der offiziellen Tabelle überein.
Bei der dokumentierten Obergrenze von 384 Tokens pro Bild ergibt sich für die reinen Bildeingabekosten folgende Rechnung:
Nebenzeiten: 384 × $0.22 / 1,000,000 = $0.00008448 pro Bild
Spitzenzeiten:  384 × $0.44 / 1,000,000 = $0.00016896 pro Bild
Das entspricht ungefähr $0.08448–$0.16896 für 1.000 Bilder, ohne Text und Ausgabe. Das ist günstig, doch die Schlagzeile kann irreführend sein. Eine Antwort mit 1.000 Tokens kostet zum Spitzen-Ausgabetarif $0.00132 – fast achtmal so viel wie die maximale Eingabegebühr für ein Bild. Prägnante Antworten und ein kontrollierter Wert für max_tokens können wichtiger sein, als ein paar Tokens beim Bild einzusparen.
Die Zahl 384 ist außerdem ein Maximum und keine pauschale Gebühr pro Bild. Der tatsächliche Tokenverbrauch hängt von den Abmessungen nach der Skalierung durch DeepSeek ab.
DeepSeek V4 Flash Vision Exp im Vergleich zu Opus 4.8
DeepSeek zufolge kommt die Leistung von Vision Exp bei multimodalen Agenten nahe an Opus 4.8 heran. Die eigene Benchmark-Grafik des Unternehmens stützt eine engere Aussage: Bei vier ausgewählten Tests für multimodale Agenten erzielen die Modelle jeweils unterschiedliche Ergebnisse.
| Benchmark für multimodale Agenten |
Vision Exp |
Opus 4.8 |
Höherer Wert |
| ApexBench, Pass@1 |
36.5 |
39.4 |
Opus 4.8 |
| Agents' Last Exam |
27.3 |
25.7 |
Vision Exp |
| Chartography |
64.3 |
65.0 |
Opus 4.8 |
| ZeroBench, Pass@5 |
35.0 |
34.0 |
Vision Exp |
Jeweils zwei Siege. Das ist konkurrenzfähig, beweist aber nicht, dass Vision Exp Opus 4.8 bei OCR-Genauigkeit, visuellen Halluzinationen, dem Lesen kleiner Texte, der UI-Navigation oder lang laufenden Agenten ebenbürtig ist.
Die Ergebnisse für textbasierte Agenten liefern zusätzlichen Kontext. DeepSeeks Grafik enthält sieben textbasierte Tests. Vision Exp liegt nur bei DeepSWE mit 59.3 zu 58.0 vor Opus 4.8. Bei Terminal Bench 2.1, NL2Repo, Cybergym, Toolathlon-Verified, DSBench-Hard und AutomationBench schneidet es schlechter ab.
Auch diese Zahlen stammen von DeepSeek und nicht von einer unabhängigen Bewertungsstelle. Das Unternehmen testete seine Modelle im Minimal Mode mit maximaler Ausgabelänge, top_p=0.95 und temperature=1.0. Bis zum 24. August konnte ich Vision Exp weder in den Ergebnissen von Artificial Analysis noch in denen von LMArena finden. Mein Fazit ist daher vorläufig: Die Launch-Daten rechtfertigen es, das Modell zu testen, nicht aber, es zum Gesamtsieger zu erklären.
Anwendungsfälle für DeepSeek V4 Flash Vision Exp
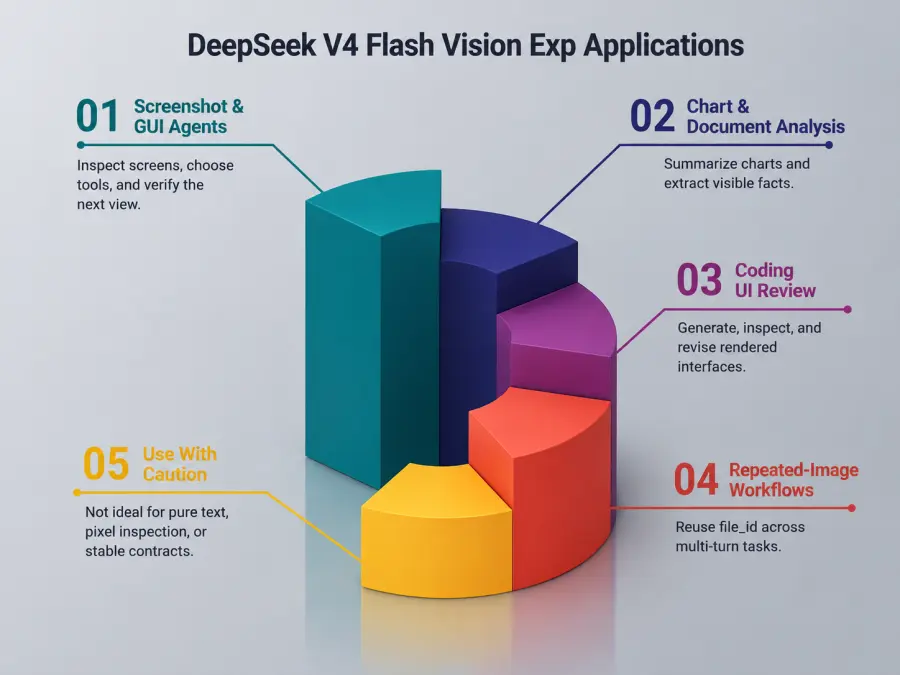
Screenshot- und GUI-Agenten
Ein Browser- oder Desktop-Agent kann einen Bildschirm untersuchen, entscheiden, welches Tool aufgerufen werden soll, und den nächsten Screenshot überprüfen. Die niedrige Obergrenze für Bildtokens hält wiederholte Beobachtungen kostengünstig. Der Kompromiss ist die visuelle Präzision. Testen Sie daher kleine Beschriftungen, Fehlermeldungen und dichte Menüs, bevor Sie automatisierten Klicks vertrauen.
Analyse von Diagrammen und Dokumentbildern
Das Modell kann Diagramme zusammenfassen, sichtbare Fakten extrahieren und sie mit Textanweisungen verknüpfen. Am besten sollte es bei klaren, gut lesbaren Seiten funktionieren. Gescannte Kleingedruckte und umfangreiche Tabellen sind riskanter, da Bilder vor der Inferenz skaliert werden.
Programmieragenten, die Benutzeroberflächen überprüfen
Ein Programmieragent kann eine Seite erstellen, das gerenderte Ergebnis prüfen und anschließend den Code überarbeiten. Damit schließt er eine Lücke, die V4 Flash als reines Textmodell offenlässt. Ein Screenshot ist jedoch kein DOM-Baum: Das Modell bemerkt möglicherweise einen falsch platzierten Button, ohne die genaue CSS-Regel zu erkennen, die dafür verantwortlich ist.
Workflows mit wiederholt verwendeten Bildern
Die Files API eignet sich für Produktkataloge, Dokumentenprüfungen und alle Abläufe, in denen dasselbe Bild über mehrere Gesprächsrunden hinweg verwendet wird. Die erneute Verwendung einer file_id spart Bandbreite bei Anfragen. Die Kosten für Bildtokens entfallen dadurch nicht, wenn das Modell die Datei erneut verarbeitet.
Wann Sie es nicht verwenden sollten
Für reine Textaufgaben, pixelgenaue Prüfungen oder Systeme, die einen stabilen Modellvertrag voraussetzen, ist Vision Exp keine gute Standardwahl. Der Suffix -exp ist relevant. Führen Sie Regressionstests durch, protokollieren Sie das Modellverhalten und halten Sie eine Ausweichroute bereit, wenn ein visueller Workflow Geld, Berechtigungen oder Kundendaten betrifft.
DeepSeek V4 Flash Vision Exp über die API verwenden
DeepSeek V4 Flash Vision Exp ist über den OpenAI-kompatiblen Endpunkt von GPT Proto verfügbar. Das folgende Python-Beispiel sendet ein öffentliches Diagrammbild zusammen mit einer Textanweisung:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["GPTPROTO_API_KEY"],
    base_url="https://gptproto.com/v1",
)

response = client.chat.completions.create(
    model="deepseek-v4-flash-vision-exp",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "text",
                    "text": "Read this chart and list the three most important findings."
                },
                {
                    "type": "image_url",
                    "image_url": {
                        "url": "https://api-docs.deepseek.com/img/v4_260821_benchmark_en.png"
                    }
                }
            ]
        }
    ],
)

print(response.choices[0].message.content)
Das Beispiel verwendet DeepSeeks öffentliches Benchmark-Bild und lässt sich daher ohne vorherige Bildvorbereitung ausführen. Bei einer lokalen Datei kodieren Sie diese als Base64-Daten-URL. Bei einer großen oder wiederholt verwendeten Datei laden Sie sie zunächst hoch und senden ihre file_id. DeepSeeks Vision API-Anleitung beschreibt alle drei Formate.
Vision Exp über GPT Proto verwenden
GPT Proto bietet DeepSeek V4 Flash Vision Exp jetzt als multimodale Variante mit Text- und Bildeingabe sowie Textausgabe an. Der aktuelle Standardpreis beträgt $0.44 pro Million Eingabetokens und $1.32 pro Million Ausgabetokens. Bildtokens werden der Text-Eingaberechnung hinzugefügt. DeepSeek gibt eine Obergrenze von 384 Eingabetokens pro Bild an.
Der praktische Vorteil ist die Bündelung in einem Konto: Mit demselben GPT Proto-Schlüssel und gemeinsam genutzten Guthaben können Sie auch das reine Textmodell DeepSeek V4 Flash und DeepSeek V4 Pro aufrufen. So lassen sich visuelle Aufgaben leichter an Vision Exp weiterleiten, während routinemäßige Textarbeit beim stabilen Flash-Modell bleibt.
Lohnt sich DeepSeek V4 Flash Vision Exp?
Ja – zum Testen bildverarbeitender Agenten, bei denen die Eingabekosten und wiederholte Screenshots eine Rolle spielen. Nein – nicht als automatisches Upgrade für eine reine Textanwendung.
Zu den bestätigten Stärken zählen breite API-Kompatibilität, ein vorhersehbarer Bildtokenverbrauch, ein 1M-Token-Kontext und vom Anbieter gemeldete Ergebnisse, die bei vier Tests für multimodale Agenten mindestens mit Opus 4.8 konkurrieren können. Nachteile sind ein experimenteller Modellvertrag, aggressive Bildskalierung, bislang keine unabhängigen Benchmark-Ergebnisse und durchwachsene Ergebnisse im Vergleich zu Opus statt eines eindeutigen Siegs.
Wenn Ihr Workload ausschließlich textbasiert ist, beginnen Sie mit DeepSeek V4 Flash und leiten Sie schwierige Programmier- oder Reasoning-Anfragen an DeepSeek V4 Pro weiter. Wenn Screenshots, Diagramme, gerenderte Oberflächen oder Dokumentbilder Informationen enthalten, die der Agent benötigt, testen Sie die DeepSeek V4 Flash Vision Exp API direkt über GPT Proto.
Überführen Sie die experimentelle Variante nicht allein aufgrund von vier vom Anbieter gemeldeten Benchmarks in die Produktion. Testen Sie sie zunächst mit eigenen Beispielen: kleinen Texten, dichten Dashboards, visuellen Fehlern und mehrstufigen Tool-Workflows.