Qwen 3.8 Max vs. GLM 5.3: die Kurzfassung
| Wenn deine Priorität ... ist |
Besserer Ausgangspunkt |
Warum |
| Coding und Terminal-Agenten für große Code-Repositories |
GLM 5.3 |
Leichter Vorsprung bei unabhängigen Coding-Präferenzen, bessere vom Anbieter gemeldete Agent-Ergebnisse, niedrigere Tokenkosten |
| Frontend-Coding und UI-Generierung |
Qwen 3.8 Max |
Deutlicher Vorsprung bei Arena WebDev und Frontend |
| Screenshot-zu-Code oder visuelles Debugging |
Qwen 3.8 Max |
Unterstützt Bild- und Videoeingaben; GPT Proto GLM-5.3 verarbeitet nur Text |
| Niedrigste API-Kosten |
GLM 5.3 |
$1.26/M Eingabe und $3.96/M Ausgabe auf GPT Proto |
| Steuerung des Reasonings |
Qwen 3.8 Max |
Unterstützt Thinking- und Non-Thinking-Modi; GLM 5.3 führt immer Reasoning durch |
| Text-Agenten mit langem Kontext |
GLM 5.3 |
1M Kontext, 128K Ausgabe, niedrigere Kosten und agentenorientiertes Post-Training |
| Ein Modell für gemischte Text- und visuelle Aufgaben |
Qwen 3.8 Max |
Breitere Eingabeunterstützung bei derselben Kontextgröße von 1M |
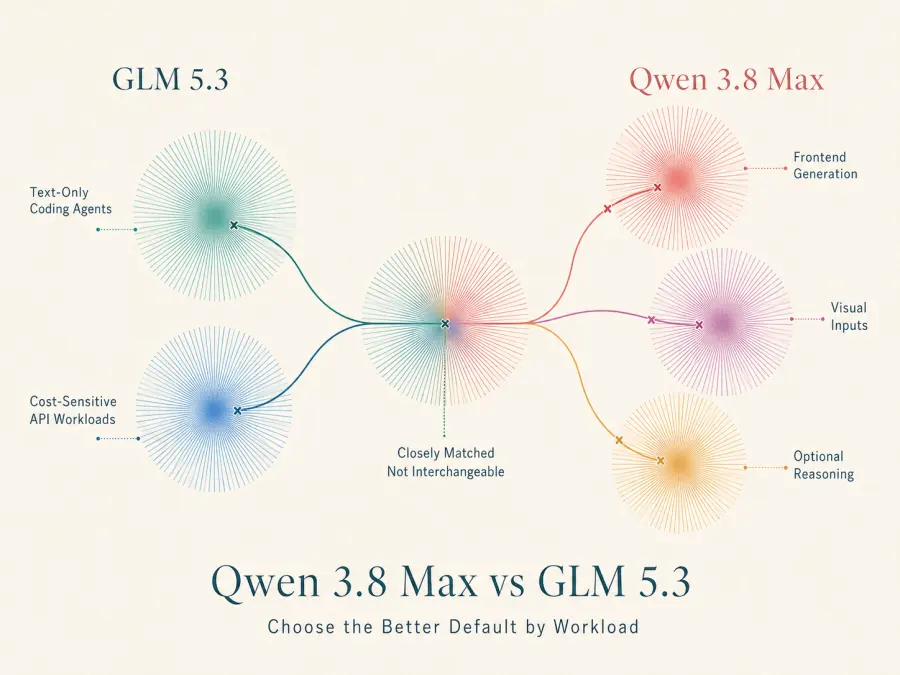
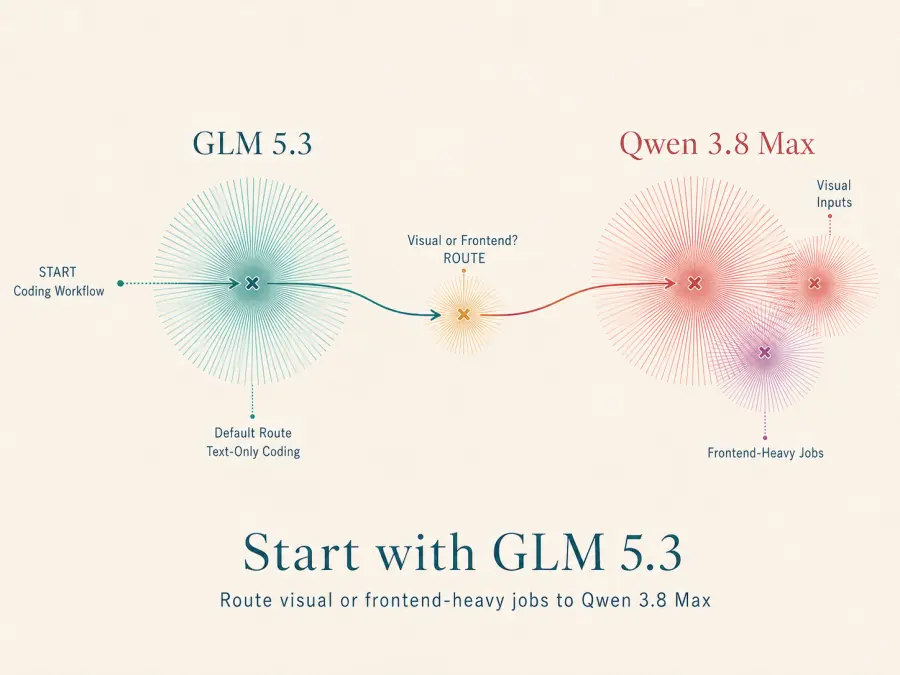
Für einen textbasierten Coding-Workflow solltest du mit GLM 5.3 beginnen und visuelle oder frontendlastige Aufgaben an Qwen 3.8 Max weiterleiten.
Qwen 3.8 Max vs. GLM 5.3 auf einen Blick
| Funktion |
Qwen 3.8 Max |
GLM 5.3 |
| Anbieter |
Alibaba Cloud / Qwen |
Z.ai |
| API-Modell-ID auf GPT Proto |
qwen3.8-max |
glm-5.3 |
| Eingabe auf GPT Proto |
Text, Bild, Video |
Nur Text |
| Ausgabe |
Text |
Text |
| Kontextfenster |
1M Tokens |
1M Tokens |
| Maximale Ausgabe |
131,072 Tokens |
128K Tokens |
| Reasoning |
Thinking oder Non-Thinking |
Immer aktiv; Aufwand kann niedrig, hoch oder maximal sein |
| Funktionsaufrufe |
Ja |
Ja |
| Strukturierte Ausgabe |
Ja |
Ja |
| Prompt-Caching |
Ja |
Ja |
| GPT Proto-Eingabepreis |
$1.80 pro 1M Tokens |
$1.26 pro 1M Tokens |
| GPT Proto-Ausgabepreis |
$5.40 pro 1M Tokens |
$3.96 pro 1M Tokens |
Die Qwen-Dokumentation von Alibaba's beschreibt Qwen 3.8 Max als ein Flaggschiffmodell mit 2,4 Billionen Parametern und einer Mixture-of-Experts-Architektur sowie einem Kontextfenster von einer Million Tokens. Es unterstützt visuelle Eingaben, Tool-Aufrufe, strukturierte Ausgaben und Prompt-Caching. Der gehostete Max-Dienst sollte nicht mit jedem Modell verwechselt werden, das den Namen Qwen 3.8 trägt.
Laut der GLM-5.3-Dokumentation von Z.ai's behält das Modell die Basisarchitektur von GLM 5.2 bei und erzielt seine wichtigsten Leistungssteigerungen durch Post-Training. Der Schwerpunkt liegt auf Coding, Agenten, Tool-Nutzung, Aufgaben mit langem Planungshorizont und effizienterem Reasoning. Auf GPT Proto ist die Route nur für Text-zu-Text ausgelegt.
Benchmark-Vergleich: Der Gewinner hängt von der Aufgabe ab
Unabhängige Intelligenz und Kosten
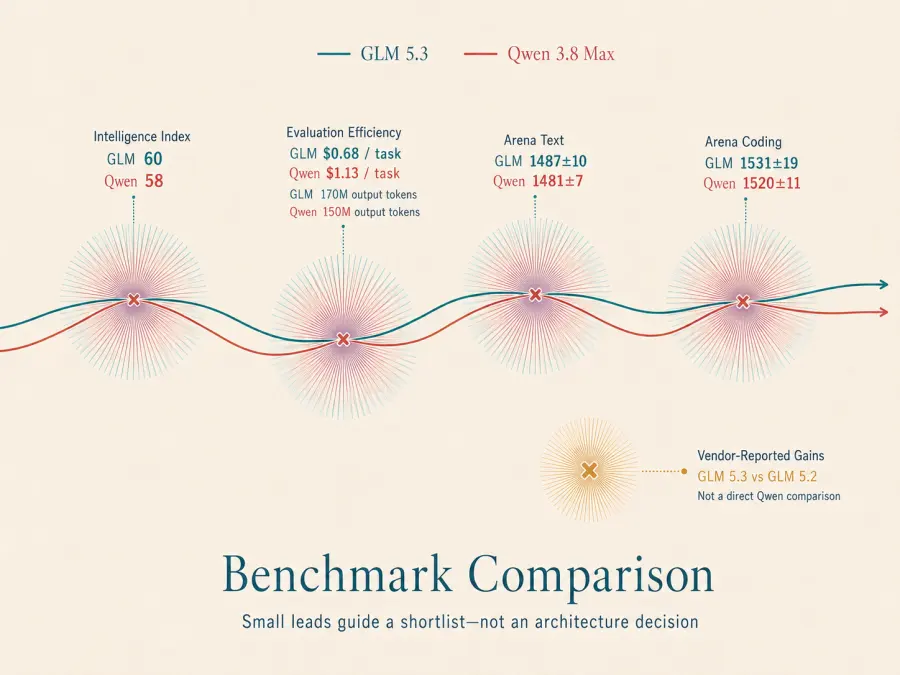
Artificial Analysis bewertet Qwen 3.8 Max mit einem Intelligence-Index von 58 und GLM 5.3 mit maximalem Reasoning-Aufwand mit 60. Der Abstand ist gering, doch das Effizienzergebnis ist interessanter: Die gemeldeten Kosten pro ausgewerteter Aufgabe betragen 1,13 $ für Qwen und 0,68 $ für GLM.
GLM erzeugte mehr Ausgabetokens bei der Auswertung – rund 170 Millionen gegenüber 150 Millionen –, kostete pro Aufgabe aber trotzdem weniger. Das ist ein nützlicher Hinweis für Agenten-Workloads, denn ein niedriger Tokenpreis kann durch lange Abläufe, Wiederholungsversuche oder wiederholte Tool-Aufrufe zunichtegemacht werden. Hier behielt GLM den Kostenvorteil, obwohl es mehr Tokens generierte.
Dabei handelt es sich um kontrollierte Ergebnisse, nicht um eine Prognose deiner Produktionskosten. Caching, Tool-Fehler und Wiederholungsversuche können das Ergebnis verändern.
Menschliche Präferenzen bei Text und Coding
Auf der Arena-Text-Bestenliste erzielte GLM 5.3 im für diesen Vergleich verwendeten Snapshot 1487±10 Punkte und Qwen 3.8 Max 1481±7. Im Coding-Teilbereich kam GLM auf 1531±19 Punkte gegenüber 1520±11 für Qwen.
Damit hat GLM einen tendenziellen Vorsprung, aber keinen überwältigenden. Die Konfidenzintervalle überschneiden sich, und GLMs Coding-Intervall ist relativ breit. Ein Abstand von sechs Punkten bei Text oder elf Punkten bei Coding kann bei der Vorauswahl helfen, sollte aber allein keine Architekturentscheidung bestimmen.
Vom Anbieter gemeldete Fortschritte bei Coding und Agenten
Z.ai berichtet von erheblichen Verbesserungen gegenüber GLM 5.2: Terminal-Bench 3 steigt von 4,6 auf 28,3, DeepSWE 1.1 von 46,2 auf 66,9 und Agents' Last Exam von 23,8 auf 28,5. Der interne Code-Benchmark soll sich von 23,4 % auf 34,5 % verbessern, während die Ausgabe pro Aufgabe von etwa 96K auf 75K Tokens sinkt.
Diese Ergebnisse stützen die Positionierung des Modells für längere Coding- und Agentenabläufe. Es handelt sich jedoch um vom Anbieter durchgeführte Vergleiche mit GLM 5.2 – nicht um direkte, unabhängige Tests von Qwen 3.8 Max gegen GLM 5.3. Sie sind ein Beleg für Fortschritte, aber kein Beweis dafür, dass GLM bei jeder Coding-Aufgabe gewinnt.
Welches Modell eignet sich besser zum Coding?
Für allgemeines Coding ist GLM 5.3 die bessere erste Wahl, wenn die Eingabe aus Text besteht. Es verbindet einen moderaten Vorsprung bei den Coding-Präferenzdaten von Arena mit niedrigeren API-Preisen und einem Post-Training, das auf die Arbeit mit Code-Repositories, die Nutzung des Terminals, Tool-Aufrufe und lange Agentenverläufe ausgerichtet ist.
GLM eignet sich besonders für:
Große Code-Repositories erkunden und Änderungen an mehreren Dateien vorschlagen
Mit einem Agenten eine Test-Korrektur-Test-Schleife durchlaufen
Pull Requests überprüfen oder Backend-Fehler nachverfolgen
Migrationen, Skripte und Service-Code generieren
Lange Textspezifikationen oder Protokolle in einem Kontext von 1M Tokens verarbeiten
Qwen 3.8 Max ist für die alltägliche Entwicklung weiterhin konkurrenzfähig. Seine praktischen Vorteile sind optionales Reasoning und visuelle Eingaben. Entwickler können den Non-Thinking-Modus für kurze Umwandlungen oder einfache Codegenerierung verwenden und für Architekturfragen, Debugging oder komplexe Refactorings tieferes Reasoning aktivieren. Das Reasoning von GLM 5.3 lässt sich nicht abschalten, sein Aufwand jedoch verringern.
Bei kurzen, latenzkritischen Aufgaben – etwa Symbole umbenennen, einen kleinen Unit-Test schreiben, ein Schema übersetzen oder eine Konfigurationsdatei bearbeiten – ist Qwens Non-Thinking-Modus möglicherweise leichter zu steuern. Für lange autonome Aufgaben, bei denen Tokenkosten und der zuverlässige Einsatz von Tools wichtig sind, ist GLM der überzeugendere Ausgangspunkt.
Qwen 3.8 Max vs. GLM 5.3 beim Frontend-Coding
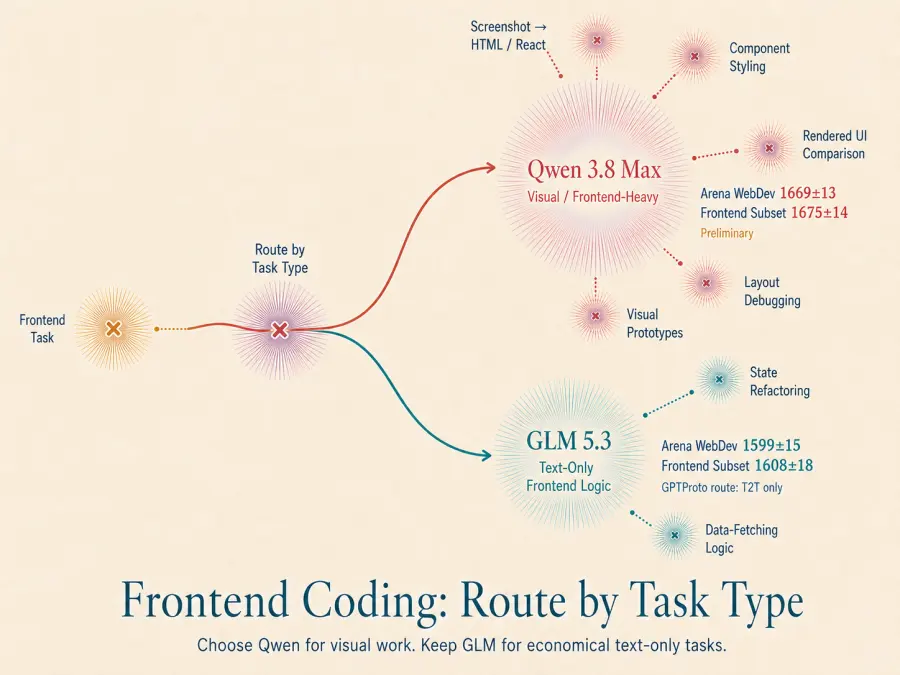
Frontend ist die deutlichste Ausnahme von GLMs allgemeinem Coding-Vorteil. Bei Arena WebDev erzielte Qwen 3.8 Max 1669±13 Punkte, verglichen mit 1599±15 für GLM 5.3. Im Frontend-Teilbereich kam Qwen auf 1675±14 Punkte gegenüber 1608±18 für GLM.
Qwens Ergebnis war im Bestenlisten-Snapshot als vorläufig gekennzeichnet und kann sich ändern, wenn weitere Stimmen eingehen. Trotz dieses Vorbehalts ist der beobachtete Abstand deutlich größer als bei den allgemeinen Text- und Coding-Bestenlisten.
Qwen akzeptiert außerdem Screenshots und Videoeingaben. Dadurch sind in einem Frontend-Workflow mehr Möglichkeiten gegeben: Ein Screenshot lässt sich mit einem Designbrief kombinieren, eine gerenderte Seite auf visuelle Fehler prüfen oder eine kurze Interaktionsaufzeichnung als Kontext für einen UI-Fehler nutzen. Da GPT Protos GLM-5.3-Route nur Text verarbeitet, kann sie solche visuellen Artefakte nicht direkt empfangen.
Wähle Qwen 3.8 Max zuerst für:
Screenshot-zu-HTML- oder Screenshot-zu-React-Aufgaben
Komponenten-Styling und Seitenaufbau
Eine gerenderte Benutzeroberfläche mit einer visuellen Referenz vergleichen
Layout, Abstände oder responsives Verhalten anhand von Bildern debuggen
Prototypen generieren, bei denen die visuelle Wirkung das wichtigste Abnahmekriterium ist
Wenn die Frontend-Aufgabe überwiegend aus Text besteht – etwa State-Management refaktorieren oder Datenabruflogik schreiben –, ist GLM möglicherweise weiterhin die günstigere Option. Leite Aufgaben je nach Aufgabentyp weiter, nicht nach der Bezeichnung des Repositories.
Welches Modell eignet sich besser für Agenten?
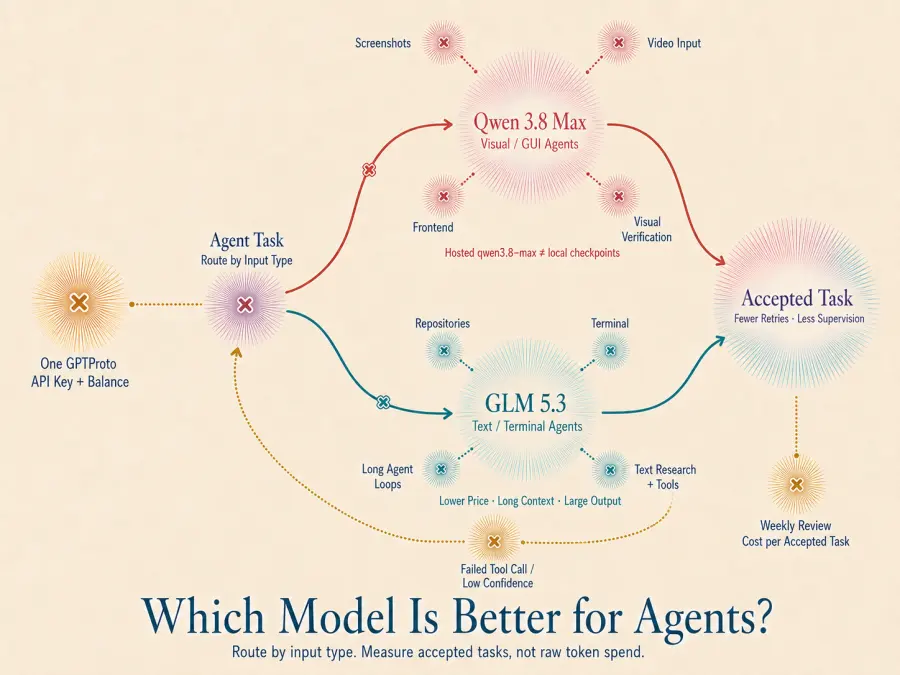
Für Text- und Terminal-Agenten hat GLM 5.3 die Nase vorn. Der niedrigere Preis, der lange Kontext, die großzügige Ausgabelänge, Funktionsaufrufe, strukturierte Ausgaben und das agentenorientierte Training machen es zur sinnvollen Standardwahl für autonomes Coding, Recherche in Textkorpora und toolgesteuerte Workflows.
Für visuelle oder GUI-fähige Agenten ist Qwen 3.8 Max die praktische Wahl, da es Bild- und Videoeingaben verarbeiten kann. Ein Browser-Agent, der einen Screenshot untersuchen muss, ein Support-Agent, der ein hochgeladenes Bild erhält, oder ein Coding-Agent, der eine visuelle Referenz mit einer gerenderten Seite vergleicht, benötigt einen Eingabekanal, den das reine Textmodell GLM auf GPT Proto nicht bietet.
Diskussionen unter Entwicklern liefern einen wichtigen Zusatz. In einer Hacker-News-Diskussion zu Qwen 3.8 geht es wiederholt um Tokenverbrauch, Wiederholungsversuche und das Agenten-Framework. Das beste Modell ist dasjenige, das eine akzeptierte Aufgabe mit weniger Fehlversuchen und geringerem Betreuungsaufwand abschließt – nicht einfach das mit dem niedrigsten Preis pro Million Tokens.
Dieselbe Vorsicht gilt für Social-Media-Beiträge und Diskussionen zu lokalen Modellen. Ergebnisse für Qwen3.8-27B oder einen anderen herunterladbaren Qwen-Checkpoint sind keine Ergebnisse für das gehostete Modell qwen3.8-max. Ähnliche Namen machen die Modelle nicht gleichwertig.
Eine praktische Routing-Strategie sieht so aus:
Textbasierte Aufgaben zu Code-Repositories, Terminal und langen Agentenabläufen an GLM 5.3 weiterleiten.
Screenshot-, Video-, Frontend- und visuelle Überprüfungsaufgaben an Qwen 3.8 Max weiterleiten.
Eine Ausweichregel für fehlgeschlagene Tool-Aufrufe oder Ausgaben mit geringer Zuverlässigkeit einrichten.
Wöchentlich die Kosten pro akzeptierter Aufgabe überprüfen, nicht nur den reinen Tokenverbrauch.
Beide Modelle sind mit einem einzigen GPT Proto-API-Schlüssel und Guthaben verfügbar. Für dieses Routing-Muster müssen also nicht zwei Anbieterintegrationen verwaltet werden.
Preise: Welches Modell ist kosteneffizienter?
Zu den am 24. August 2026 geprüften Preisen listet GPT Proto folgende Tarife:
| Modell |
Eingabe / 1M Tokens |
Ausgabe / 1M Tokens |
Cache-Lesezugriffe / 1M Tokens |
| Qwen 3.8 Max |
$1.80 |
$5.40 |
$0.225 |
| GLM 5.3 |
$1.26 |
$3.96 |
$0.234 |
Qwen berechnet außerdem 2,25 $ pro Million Tokens für Cache-Schreibvorgänge. Die beiden GPT Proto-Routen liegen 10 % unter den direkten Listenpreisen der Anbieter: Alibaba verlangt für Qwen 2 $ pro Eingabe- und 6 $ pro Ausgabetokens, während Z.ai für GLM 1,40 $ pro Eingabe- und 4,40 $ pro Ausgabetokens pro Million berechnet.
Nehmen wir einen Workload mit 10 Millionen nicht gecachten Eingabetokens und 2 Millionen Ausgabetokens:
GLM spart in diesem Beispiel 8,28 $ oder etwa 28,8 %. Sein Vorteil wächst, wenn die Ausgabe einen großen Anteil der Rechnung ausmacht. Qwens Preis für Cache-Lesezugriffe ist jedoch etwas niedriger, sodass sich der Abstand bei Workloads mit häufig wiederverwendetem, großem und stabilem Präfix verringern kann.
Dabei sollte es nicht bei dieser Rechnung bleiben. Erfasse für jede Produktionsaufgabe die Modell-ID, Aufgabenkategorie, Eingabetokens, Ausgabetokens, gecachten Tokens, Versuche, Testergebnis, Abnahme durch Prüfer und Gesamtlatenz. Teile die Gesamtkosten durch die Zahl der akzeptierten Aufgaben. So werden Wiederholungsversuche und Fehler berücksichtigt, die der Preis pro Token nicht abbildet.
Reasoning, Latenz und Steuerung im Produktionsbetrieb
Qwen 3.8 Max bietet eine explizitere Steuerung darüber, wie viel Überlegung eine Anfrage erfordert. Mit dem Thinking- und Non-Thinking-Modus kann ein Team schnelle Umwandlungen von Aufgaben trennen, die von tieferem Reasoning profitieren. Alibaba dokumentiert eine maximale Eingabe von 991,808 Tokens im Standardmodus und 983,616 Tokens im Thinking-Modus sowie bis zu 131,072 Ausgabetokens.
GLM 5.3 verwendet immer Reasoning. Entwickler können den Aufwand auf niedrig, hoch oder maximal einstellen; maximal ist der dokumentierte Standardwert. Das Reasoning lässt sich jedoch nicht deaktivieren. Dies kann die Ausdauer bei schwierigen Agentenaufgaben verbessern, macht aber Latenz und Tokenverbrauch bei trivialen Aufrufen weniger vorhersehbar.
Die Entscheidung für den Betrieb ist also einfach:
Wähle Qwen, wenn du über eine Modell-ID sowohl einen schnellen als auch einen Reasoning-Pfad brauchst.
Wähle GLM, wenn die meisten Anfragen gründliches Reasoning erfordern und niedrigere Tokenpreise wichtig sind.
Teste vollständige Workflows, wenn Latenz eine harte Anforderung ist. Die Generierungsgeschwindigkeit des Modells allein berücksichtigt weder Tool-Ausführung noch Wiederholungsversuche oder Wartezeiten in der Warteschlange.
Beide über einen einzigen OpenAI-kompatiblen Endpunkt ausprobieren
Am schnellsten triffst du eine Entscheidung, indem du dieselben repräsentativen Prompts über beide Routen ausführst. Diese cURL-Anfrage verwendet den OpenAI-kompatiblen Chat-Completions-Endpunkt von GPT Proto:
curl --request POST "https://gptproto.com/v1/chat/completions" \
  --header "Authorization: Bearer $GPTPROTO_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "glm-5.3",
    "messages": [
      {
        "role": "user",
        "content": "Review this Python function for correctness and return JSON with issues, fixes, and tests: ..."
      }
    ]
  }'
Ändere nur den Modellwert zu qwen3.8-max, um denselben Text-Prompt mit Qwen auszuführen. Verwende einen realistischen Aufgabensatz statt einiger weniger überzeugender Demos: Nimm einfache Änderungen, schwierige Repository-Änderungen, Tool-Aufrufe, Aufgaben mit langem Kontext und Frontend-Aufgaben auf. Bewerte Korrektheit, bestandene Tests, menschliche Abnahme, Latenz und Gesamtzahl der Tokens.
Offene Gewichte und Self-Hosting sind zwei verschiedene Fragen
Alibaba veröffentlicht den Checkpoint Qwen3.8-2.4T-A95B, doch dieser herunterladbare Checkpoint ist nicht identisch mit dem gehosteten Qwen-3.8-Max-Dienst. Die Max-API bietet zusätzlich einen Kontext von einer Million Tokens, visuelle Eingaben, einen Non-Thinking-Modus und gehostete Tool-Funktionen. Ein lokaler Benchmark mit einer kleineren Qwen3.8-Variante sollte nicht als direkter Vergleich mit Max verwendet werden.
Z.ai hat eine schrittweise Veröffentlichung offener Gewichte für GLM 5.3 angekündigt, doch zum Zeitpunkt der Erstellung dieses Textes konnten die GLM-5.3-Gewichte nicht öffentlich heruntergeladen werden. Teams, die heute eine Bereitstellungsentscheidung treffen, sollten die heute verfügbare API bewerten und nicht davon ausgehen, dass angekündigte Gewichte, Lizenzen, Quantisierungen oder Anforderungen an das Serving bereits feststehen.
Fazit
Wähle GLM 5.3 für textbasierte Coding-Agenten, die Arbeit mit Code-Repositories, lange toolgesteuerte Aufgaben und niedrigere API-Kosten. Wähle Qwen 3.8 Max für Frontend-Coding, Bild- oder Videoeingaben, visuelle Agenten und Workloads, die optionales Reasoning benötigen.
Wenn du eine Standardwahl für eine Entwicklerplattform brauchst, bietet GLM 5.3 das bessere Verhältnis von Kosten zu Leistungsfähigkeit. Wenn dein Produkt von Code zu visuellen Oberflächen übergeht, sind Qwens Eingabeunterstützung und Ergebnisse bei Frontend-Präferenzen wichtiger als GLMs kleiner Vorsprung bei allgemeiner Intelligenz.
Die beste Produktionsumgebung kann beide Modelle nutzen: Beginne bei Text-Agenten mit GLM 5.3, leite visuelle und Frontend-Aufgaben an Qwen 3.8 Max weiter und behalte für jede Kategorie das Modell, das die niedrigsten Kosten pro akzeptierter Aufgabe erzielt.