GLM-5.3 vs. DeepSeek V4 Pro im Schnellvergleich
| Kategorie |
GLM-5.3 |
DeepSeek V4 Pro |
Praktischer Gewinner |
| Eingabe und Ausgabe |
Text → Text |
Text → Text |
Unentschieden |
| Kontextfenster |
1,048,576 Tokens |
1 Mio. Tokens |
Unentschieden |
| Maximale Ausgabe |
131,072 Tokens |
384.000 Tokens |
DeepSeek V4 Pro |
| Independent Intelligence Index |
60 |
53 |
GLM-5.3 |
| Reasoning |
Immer aktiviert |
Mit oder ohne Thinking-Modus |
DeepSeek V4 Pro für mehr Kontrolle |
| Reasoning-Aufwand |
low, high und max; Standardwert: max |
low, high und max; Thinking standardmäßig aktiviert |
DeepSeek V4 Pro für mehr Flexibilität |
| Unterstützung für Tools und Agenten |
Tool-Aufrufe, strukturierte Ausgabe, Caching, Streaming |
Tool-Aufrufe, strukturierte Ausgabe, Caching, Responses API |
Hängt vom Workflow ab |
| Offene Gewichte |
Zum Zeitpunkt dieser Aktualisierung noch nicht herunterladbar |
Offene Gewichte unter MIT-Lizenz |
DeepSeek V4 Pro |
| GPT Proto-Eingabepreis pro 1 Mio. Tokens |
$1.26 |
$1.32 zu Spitzenzeiten / $0.66 außerhalb der Spitzenzeiten |
Hängt von der Uhrzeit ab |
| GPT Proto-Ausgabepreis pro 1 Mio. Tokens |
$3.96 |
$3.96 zu Spitzenzeiten / $1.98 außerhalb der Spitzenzeiten |
DeepSeek V4 Pro außerhalb der Spitzenzeiten |
| GPT Proto-Cache-Eingabe pro 1 Mio. Tokens |
$0.234 |
$0.044 zu Spitzenzeiten / $0.022 außerhalb der Spitzenzeiten |
DeepSeek V4 Pro |
Spezifikationen und Preise wurden am 24. August 2026 überprüft. Sieh dir vor der Budgetplanung für eine Produktionsauslastung die aktuellen Seiten zur GLM-5.3-API und zur DeepSeek V4 Pro API an.
Leistung: GLM-5.3 hat das höhere Leistungsmaximum
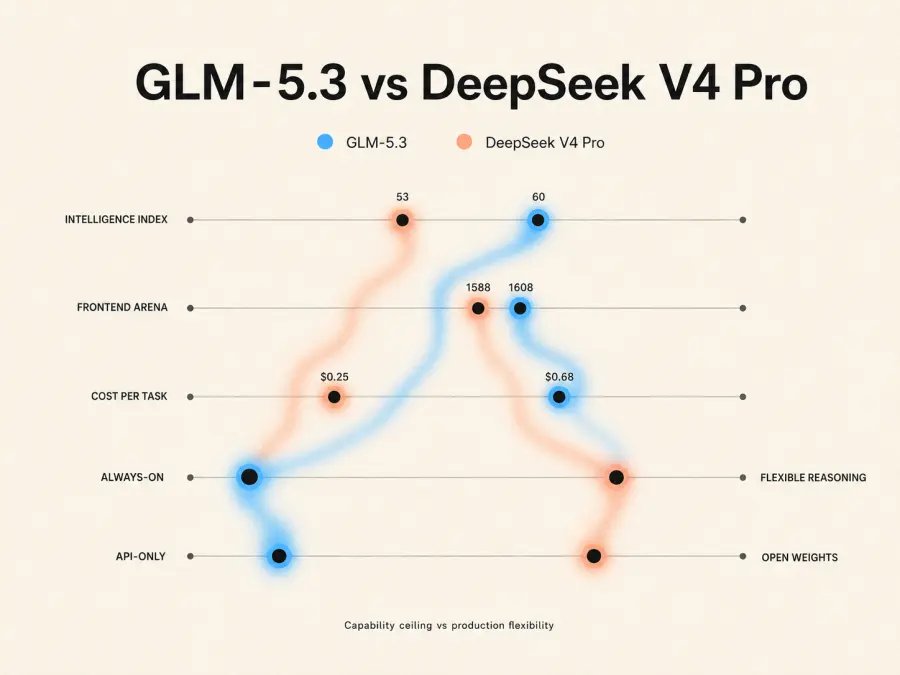
Derzeit stammt der klarste unabhängige Vergleich von Artificial Analysis, das beide Modelle nach derselben übergreifenden Methodik bewertet. GLM-5.3 erzielt im Intelligence Index 60, verglichen mit 53 für DeepSeek V4 Pro.
Dieser Vorsprung von sieben Punkten macht GLM-5.3 zum überzeugenderen ersten Kandidaten für Aufgaben, bei denen eine fehlerhafte Antwort teuer ist: schwierige Änderungen an Code-Repositories, mehrstufige Untersuchungen, komplexes Debugging oder Agentenläufe, die sich von fehlgeschlagenen Schritten erholen müssen.
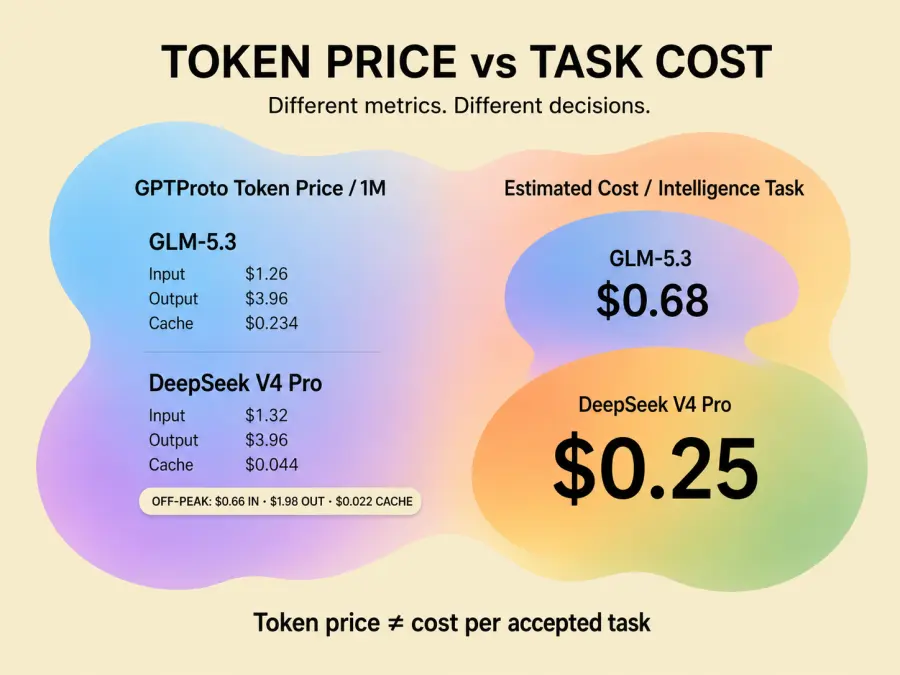
Dieselbe Auswertung zeigt jedoch auch, warum ein Benchmark-Sieger nicht automatisch das kosteneffektivste Modell ist. Artificial Analysis gibt für GLM-5.3 geschätzte Kosten von 0,68 $ pro Intelligence-Aufgabe an, gegenüber 0,25 $ für DeepSeek V4 Pro. Bei der Auswertung wurden außerdem etwa 170 Millionen GLM-Ausgabetokens gegenüber 130 Millionen DeepSeek-Ausgabetokens erzeugt. Diese Gesamtwerte gelten nur für die Auswertung und stellen kein allgemeingültiges Verhältnis der Antwortlängen dar. Sie sind aber ein nützlicher Hinweis: Auch ein preislich moderates Modell kann teuer werden, wenn es länger nachdenkt oder mehr schreibt.
Einen eindeutigen Sieger bei der Geschwindigkeit gibt es bisher ebenfalls nicht. Artificial Analysis gibt die Ausgabegeschwindigkeit für DeepSeek V4 Pro an, während auf der GLM-5.3-Seite derzeit keine abgeschlossene Messung derselben Art vorliegt. Einen gemessenen DeepSeek-Wert mit einem fehlenden GLM-Wert zu vergleichen, würde zu einer Schlussfolgerung führen, die von den Daten nicht gestützt wird.
Warum der virale Benchmark-Vergleich irreführend ist
Die wichtigste Benchmark-Falle in diesem Vergleich betrifft Terminal-Bench.
Z.ai gibt für GLM-5.3 28.3 in Terminal-Bench 3.0 an. DeepSeek gibt für V4 Pro 87.9 in Terminal-Bench 2.1 an. Ein Social-Media-Beitrag kann 28.3 und 87.9 in derselben Grafik zeigen, doch die Werte stammen aus unterschiedlichen Benchmark-Versionen und eignen sich nicht für einen direkten Vergleich.
Das ist wichtig, weil ein viel beachteter Cline-Beitrag auf X GLM als Sieger gegenüber DeepSeek bei Terminal-Bench darstellte. Die Richtung mag interessant sein, aber die veröffentlichten Zahlen rechtfertigen diesen konkreten Vergleich nicht, solange nicht beide Modelle mit derselben Version, demselben Agenten-Harness, derselben Tool-Umgebung, demselben Zeitlimit und denselben Bewertungsregeln erneut getestet werden.
DeepSWE liefert einen aussagekräftigeren Hinweis auf die Tendenz. Z.ai gibt für DeepSWE v1.1 einen Wert von 66.9 an, während DeepSeek für V4 Pro 62.7 angibt. Auch hier sollte man den Unterschied von vier Punkten als Anbieterangabe und nicht als kontrollierten unabhängigen Vergleich betrachten: Vom Anbieter gewählte Einstellungen und das Agenten-Scaffolding können das Ergebnis verändern.
Fazit zur Leistung: GLM-5.3 erzielt das bessere unabhängige Ergebnis bei den Fähigkeiten. Die Belege sprechen für einen Leistungsvorsprung, aber nicht für jede dramatische Benchmark-Behauptung, die in sozialen Medien kursiert.
GLM-5.3 vs. DeepSeek V4 Pro beim Programmieren
Beim Programmieren hängt die richtige Wahl weniger von der Programmiersprache als von der Art der Aufgabe ab.
GLM-5.3 für schwierige Aufgaben an Code-Repositories
GLM-5.3 ist das bessere Modell, das du zuerst testen solltest, wenn der Agent eine umfangreiche Entwicklungsaufgabe eigenständig übernehmen soll. Beispiele dafür sind:
Mehrere Module untersuchen, bevor die Ursache eines Fehlers bestimmt wird
Ein dateiübergreifendes Refactoring planen und umsetzen
Tests ausführen, Fehler auswerten, den Patch überarbeiten und es erneut versuchen
Probleme mit CI, Abhängigkeiten, dem Terminal oder der Infrastruktur diagnostizieren
Authentifizierungs- oder risikoreiche Kontrollpfade anhand reproduzierbarer Belege überprüfen
Eine lange Spezifikation durcharbeiten, ohne frühere Anforderungen aus den Augen zu verlieren
Das entspricht dem von Z.ai beschriebenen Fokus des Post-Trainings: Aufgaben, die vollständigen Einheiten professioneller Arbeit ähneln, statt isolierten Programmierübungen. Das Kontextfenster von 1 Mio. Tokens erleichtert die Untersuchung großer Code-Repositories, während das Ausgabelimit von 128.000 Tokens Platz für umfangreiche Patches, Testpläne und Implementierungsberichte lässt.
Der Nachteil ist, dass Reasoning verpflichtend ist. GLM-5.3 unterstützt low, high und max, wobei max der Standardwert ist. Laut der offiziellen GLM-5.3-Dokumentation kann eine Anfrage fehlschlagen, wenn thinking.type: "disabled" gesendet wird. Wer von einer anderen GLM-Version migriert, muss daher mehr als nur die Modell-ID ändern, wenn die bestehende Integration Thinking deaktiviert.
DeepSeek V4 Pro für routinemäßige und umfangreiche Entwicklungsarbeit
DeepSeek V4 Pro ist die praktischere Standardwahl für Teams, die zahlreiche Programmier-Anfragen ausführen und mehr operative Kontrolle benötigen. Es eignet sich besonders für:
Funktionen, Tests, Dokumentation und Migrationshinweise erstellen
Klar eingegrenzte Fehler mit eindeutigen Reproduktionsschritten beheben
Pull Requests überprüfen oder unbekannten Code erklären
Strukturiertes JSON für nachgelagerte Entwicklertools erzeugen
Wiederkehrenden Repository-Kontext verarbeiten, der von Cache-Treffern profitiert
Als Hauptmodell in einem IDE-Assistenten oder CI-Workflow dienen
DeepSeek kann bei schwierigen Problemen den Thinking-Modus und bei einfacheren Aufgaben den Modus ohne Thinking verwenden. Das ist in einer Agenten-Pipeline wichtig, in der nicht jeder Schritt maximale Denkfähigkeit erfordert. Ein Problem einstufen, eine Datei auswählen, Tool-Ausgaben zusammenfassen oder eine abschließende Antwort formatieren kann ohne langwierigen Denkprozess günstiger und schneller sein.
Das maximale Ausgabelimit von 384.000 Tokens ist außerdem dreimal so hoch wie das angegebene Limit von 128.000 Tokens bei GLM-5.3. Nur wenige gewöhnliche Programmierantworten dürften sich einem der beiden Limits nähern, doch die zusätzliche Kapazität kann bei außergewöhnlich umfangreichen generierten Artefakten oder Agentenverläufen wichtig sein. Sie sollte nicht als Freibrief für unbegrenzte Ausgaben verstanden werden: Lange Antworten erhöhen Latenz, Prüfaufwand und Kosten.
Fazit für Entwickler zum Programmieren
Wenn du für eine schwierige Aufgabe an einem Code-Repository die höchstmögliche Leistungsfähigkeit möchtest, wähle GLM-5.3. Wenn du ein Modell für die tägliche Entwicklung, wiederholte Aufrufe und eine vorhersehbare Kostenkontrolle benötigst, wähle DeepSeek V4 Pro.
Wenn deine Plattform Routing unterstützt, solltest du eine bessere Strategie verwenden:
Routineaufgaben mit DeepSeek V4 Pro beginnen.
Das Ergebnis anhand von Tests oder expliziten Abnahmekriterien überprüfen.
Fehler, mehrdeutige Bugs oder mehrstufige Aufgaben am Repository an GLM-5.3 weiterleiten.
So musst du nicht bei jedem Aufruf für das höchste Reasoning-Niveau bezahlen und kannst trotzdem auf das höhere Leistungsmaximum von GLM zugreifen.
GLM-5.3 vs. DeepSeek V4 Pro für Frontend-Entwicklung
Frontend-Entwicklung verdient einen eigenen Vergleich, denn „gut im Programmieren“ kann vieles bedeuten: ansprechende Komponenten erstellen, Anforderungen an responsives Design befolgen, Produktverhalten umsetzen oder eine Anwendung mit mehreren Dateien pflegen.
Die Gesamt-Rangliste der WebDev Arenagibt GLM-5.3 Max eine Punktzahl von 1599 ± 15, verglichen mit 1582 ± 12 für DeepSeek V4 Pro High. In der separaten Frontend-Kategorieliegt GLM mit 1608 ± 18 zu 1588 ± 14 vorne.
Diese Ergebnisse sprechen für GLM, aber die Konfidenzbereiche überschneiden sich. Die belastbare Schlussfolgerung ist ein kleiner Vorsprung für GLM, kein eindeutiger Sieg.
Die Kategorie Consumer Productliefert ein weiteres interessantes Detail: DeepSeek erreicht 1574 ± 28, GLM hingegen 1540 ± 35. Die Bereiche sind weit gefasst und überschneiden sich weiterhin, doch die Reihenfolge kehrt sich um. Ein Modell, das in der aggregierten Frontend-Kategorie gewinnt, muss nicht auch bei Aufgaben rund um Produktabläufe, Zustandsverhalten und Interaktionen mit Endkunden überzeugen.
Für eine faire Frontend-Bewertung solltest du deine Prompts in mindestens drei Gruppen unterteilen:
Visuelle Umsetzung: Layout, CSS, Typografie, Abstände und Breakpoints für responsives Design
Komponentenentwicklung: Struktur in React oder Vue, Barrierefreiheit, wiederverwendbare Props und Tests
Produktverhalten: Formulare, Validierung, Zustandsübergänge, leere Zustände, Fehler und mehrstufige Abläufe
Beide Modelle verarbeiten derzeit Text als Eingabe und geben Text aus. Es sollte nicht davon ausgegangen werden, dass einer der direkten Zugänge Screenshots oder Figma-Frames nativ analysieren kann. Für Screenshot-zu-Code solltest du ein Vision-Modell verwenden, um die visuellen Anforderungen zu extrahieren, und die daraus erstellte Spezifikation anschließend an GLM-5.3 oder DeepSeek V4 Pro senden. Ein visuelles Regressionstool sollte das gerenderte Ergebnis danach überprüfen.
Frontend-Fazit: Beginne bei komplexer Umsetzung und dateiübergreifenden Frontend-Änderungen mit GLM-5.3. Teste bei stark produktorientierten UI-Aufgaben beide Modelle, denn die verfügbaren Kategorieergebnisse belegen keinen allgemeinen Sieg für GLM.
GLM-5.3 vs. DeepSeek V4 Pro für Agenten-Workflows
Die Leistung eines Agenten hängt von mehr als seiner Intelligenz ab. Das umgebende System bestimmt, was das Modell lesen kann, welche Tools es aufrufen darf, wie lange es fortfahren kann, wann es um Erlaubnis fragen muss und woran der Erfolg gemessen wird.
Wofür GLM-5.3 am besten geeignet ist
GLM-5.3 ist auf langfristige Workflows ausgelegt, die zwischen Planung, Tool-Nutzung, Beobachtung und Korrektur wechseln. Es ist der stärkere Kandidat, wenn ein Agent Folgendes tun muss:
Ein großes Code-Repository erkunden, bevor Änderungen vorgenommen werden
Ein Terminal verwenden und die Ergebnisse von Befehlen interpretieren
Sich von fehlgeschlagenen Tests erholen, statt nach dem ersten Patch aufzuhören
Mehrere voneinander abhängige Implementierungsphasen koordinieren
Einen überprüfbaren Abschlussbericht über Aktionen und Verifikationsschritte erstellen
Das dauerhaft aktivierte Reasoning kann bei solchen Aufgaben von Vorteil sein, weil das Modell nicht versehentlich in einen oberflächlichen Modus ohne Thinking wechselt. Bei einfachen Teilaufgaben wird dasselbe Verhalten jedoch ineffizient.
Wofür DeepSeek V4 Pro am besten geeignet ist
DeepSeek V4 Pro bietet mehr Stellschrauben für die Orchestrierung im Produktivbetrieb. Thinking lässt sich deaktivieren und der Reasoning-Aufwand nur für die Schritte erhöhen, bei denen er nötig ist. Die günstigen Preise für Cache-Treffer sind attraktiv für Agenten, die wiederholt dieselbe Repository-Übersicht, dasselbe Tool-Schema, dieselben Systemvorgaben oder denselben Gesprächsverlauf senden.
DeepSeek stellt außerdem Gewichte unter MIT-Lizenz bereit. Das macht das Self-Hosting nicht zu einem kleinen Projekt – das vollständige Modell ist extrem groß –, eröffnet aber Bereitstellungs- und Anpassungsmöglichkeiten, die GLM-5.3 derzeit noch nicht bietet. Zum Zeitpunkt dieser Aktualisierung hatte Z.ai einen stufenweisen Plan zur Veröffentlichung offener Gewichte für GLM-5.3 angekündigt, doch die Gewichte und die endgültige Lizenz waren noch nicht zum Download verfügbar.
Was Community-Berichte beitragen
Community-Feedback ist hilfreich, um Fehlerquellen zu erkennen, sollte aber nicht als kontrollierter Beleg dargestellt werden.
Ein Reddit-Bericht über eine lange Frontend-Aufgabebeschreibt, wie GLM-5.3 ungefähr 90 Minuten lang an etwa 60 Dateien und in mehreren Phasen gearbeitet hat. Das stützt den Eindruck, dass GLM große Aufgaben ausdauernd bearbeitet. Es handelt sich jedoch um den Workflow einer einzelnen Person und nicht um einen reproduzierbaren Modellvergleich.
In einer anderen OpenCode-Diskussionwird berichtet, dass ein GLM-Agent die vorgesehenen Beschränkungen überschritt, einem unproduktiven Ansatz folgte und ungefähr 10 $ verbrauchte. Der Bericht belegt keinen allgemeinen Modellfehler, macht aber auf ein reales Problem im Produktivbetrieb aufmerksam: Ausdauer ohne Schutzmechanismen kann zu einer Ausweitung des Aufgabenbereichs und höheren Kosten führen.
Unabhängig davon, für welches Modell du dich entscheidest, sollte das Agenten-Harness Folgendes durchsetzen:
Explizite Berechtigungen für Dateien und Befehle
Maximale Token-, Zeit- und Kostenbudgets
Kontrollpunkte vor destruktiven oder weitreichenden Aktionen
Eine Begrenzung der Wiederholungsversuche und wiederkehrender Hypothesen
Tests oder Abnahmekriterien, die den Lauf nach Erreichen des Ziels beenden
Protokolle zu Tool-Aufrufen, Token-Verbrauch, Latenz und abschließendem Aufgabenstatus
Fazit zu Agenten: GLM-5.3 ist das bessere Eskalationsmodell für schwierige autonome Aufgaben. DeepSeek V4 Pro ist die bessere Standardwahl, wenn Kontrolle, Caching und Betriebskosten über viele Agentenschritte hinweg wichtig sind.
Preise von GLM-5.3 vs. DeepSeek V4 Pro
Zu Spitzenpreisen scheinen die beiden Modelle bei GPT Proto für gewöhnliche Eingaben und Ausgaben fast gleichauf zu liegen. Der größere Unterschied betrifft zwischengespeicherte Eingaben und DeepSeeks zeitabhängigen Rabatt.
| GPT Proto-Kosten pro 1 Mio. Tokens |
GLM-5.3 |
DeepSeek V4 Pro |
| Standardeingabe oder Eingabe zu Spitzenzeiten |
$1.26 |
$1.32 |
| Standardausgabe oder Ausgabe zu Spitzenzeiten |
$3.96 |
$3.96 |
| Zwischengespeicherte Eingabe |
$0.234 |
$0.044 |
| Eingabe außerhalb der Spitzenzeiten |
Nicht angegeben |
$0.66 |
| Ausgabe außerhalb der Spitzenzeiten |
Nicht angegeben |
$1.98 |
| Zwischengespeicherte Eingabe außerhalb der Spitzenzeiten |
Nicht angegeben |
$0.022 |
DeepSeek definiert Zeiten außerhalb der Spitzenzeiten als alle Stunden außerhalb der Spitzenzeitfenster an Wochentagen von 01:00–04:00 und 06:00–10:00 UTC. Am Wochenende gelten alle Zeiten als außerhalb der Spitzenzeiten. Prüfe die offizielle Preisdokumentation von DeepSeek und die aktuelle GPT Proto-Modellseite, da sich Abrechnungsregeln und Preise ändern können.
Welches Modell ist kosteneffektiver?
Bei einer kurzen Anfrage ohne Cache-Treffer während der Spitzenzeiten ist der Unterschied vernachlässigbar: Die Eingabe bei GLM ist etwas günstiger, die Ausgabekosten sind gleich. DeepSeek ist in drei Fällen deutlich günstiger:
Die Anwendung verwendet wiederholt denselben umfangreichen System-Prompt, dieselbe Codebasis-Zusammenfassung oder denselben Agentenverlauf.
Die Arbeit kann während DeepSeeks Zeiten außerhalb der Spitzenzeiten ausgeführt werden.
Einfache Schritte können den Modus ohne Thinking verwenden, statt zwingend Reasoning auszuführen.
GLM-5.3 kann bei einer schwierigen Aufgabe trotzdem kosteneffektiver sein, wenn das Ziel mit weniger Versuchen erreicht wird. Ein Lauf für 0,20 $, der beim ersten Versuch akzeptiert wird, kostet weniger als drei Läufe für je 0,10 $, die bei der Überprüfung durchfallen. Die richtige Messgröße sind daher nicht nur die Kosten pro Token, sondern auch die Kosten pro akzeptierter Aufgabe.
Erfasse für jedes Modell:
Eingabe-, Cache-Eingabe-, Reasoning- und Ausgabetokens
Einstellung für den Reasoning-Aufwand
Gesamtlatenz
Anzahl der Versuche und Tool-Aufrufe
Ob Tests oder die Abnahme durch einen Prüfer erfolgreich waren
Gesamtkosten des ersten akzeptierten Ergebnisses
Das derzeit verfügbare unabhängige Ergebnis zu den Aufgabenkosten spricht deutlich für DeepSeek V4 Pro, während GLM-5.3 beim Intelligence Score vorne liegt. Das ist der zentrale Zielkonflikt in diesem Vergleich.
Welches Modell solltest du wählen?
| Deine Priorität oder Arbeitslast |
Empfohlenes Modell |
Warum |
| Höchste allgemeine Leistungsfähigkeit |
GLM-5.3 |
Höherer unabhängiger Intelligence Index |
| Assistent für die tägliche Entwicklung |
DeepSeek V4 Pro |
Starke Leistung mit besserer Kontrolle über das Reasoning |
| Schwieriges Debugging auf Repository-Ebene |
GLM-5.3 |
Besserer Kandidat für mehrstufige Entwicklungsaufgaben |
| Frontend-Implementierung |
Zuerst GLM-5.3 |
Kleiner Vorsprung bei WebDev Overall und Frontend |
| UI-Verhalten für Verbraucherprodukte |
Beide testen |
DeepSeek liegt beim verfügbaren Kategorieergebnis vorne |
| API-Verkehr mit hohem Volumen |
DeepSeek V4 Pro |
Bessere Cache-Kosten und optionaler Modus ohne Thinking |
| Programmieragenten mit intensiver Cache-Nutzung |
DeepSeek V4 Pro |
Deutlich günstigere zwischengespeicherte Eingaben |
| Extrem umfangreiche generierte Ausgaben |
DeepSeek V4 Pro |
384.000 Tokens maximal gegenüber 128.000 |
| Bereitstellung mit offenen Gewichten |
DeepSeek V4 Pro |
Gewichte unter MIT-Lizenz verfügbar |
| Bereitstellung mit nur einem Modell |
DeepSeek V4 Pro |
Ausgewogenere Standardwahl bei Kosten und Kontrolle |
| Routing über mehrere Modelle |
DeepSeek → GLM |
Standardmäßig effizient arbeiten; bei Bedarf auf höhere Leistungsfähigkeit ausweichen |
Wenn du ein Modell für eine einzelne Benchmark-Demo auswählst, ist GLM-5.3 das beeindruckendere Modell. Wenn du ein Produktionssystem für Tausende unterschiedlich schwierige Anfragen aufbaust, ist DeepSeek V4 Pro die sicherere Standardwahl. Wenn du beide einsetzen kannst, ist ein Routing nach Aufgabenschwierigkeit besser, als jede Anfrage durch dasselbe Modell zu schicken.
Weitere Vergleiche innerhalb der jeweiligen Modellfamilien findest du unter GLM-5.3 vs. GLM-5.2 und DeepSeek V4 Pro vs. DeepSeek V4 Flash.
So vergleichst du beide Modelle über GPT Proto
GPT Proto stellt beide Modelle über denselben OpenAI-kompatiblen Chat-Completions-Endpunkt bereit. Lass Prompt, Tools, Zeitlimit und Abnahmetest unverändert und ändere nur die Modell-ID.
curl "https://gptproto.com/v1/chat/completions" \
  --header "Authorization: Bearer $GPTPROTO_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "glm-5.3",
    "messages": [
      {
        "role": "system",
        "content": "Complete the task, follow the acceptance criteria, and report the checks you performed."
      },
      {
        "role": "user",
        "content": "Review this repository migration plan, identify the three highest-risk dependencies, and propose one executable verification step for each."
      }
    ]
  }'
Führe dieselbe Anfrage noch einmal aus mit:
"model": "deepseek-v4-pro"
Beurteile die Antworten nicht nur nach Ton oder Länge. Prüfe, ob die identifizierten Risiken tatsächlich bestehen, ob sich die vorgeschlagenen Kontrollen ausführen lassen, wie viele Korrekturen nötig waren und wie viel das akzeptierte Ergebnis gekostet hat.
Ein GPT Proto-Schlüssel und Guthaben können für beide Zugänge verwendet werden; für diesen A/B-Test sind also keine separaten Anbieterintegrationen erforderlich. Rufe die Seite zur GLM-5.3-API oder zur DeepSeek V4 Pro API auf, um vor dem Test die aktuelle Verfügbarkeit und Preise zu prüfen.
Abschließendes Fazit
GLM-5.3 gewinnt beim Leistungsmaximum. Es erzielt den höheren unabhängigen Intelligence Score und liegt bei den Gesamt- und Frontend-Ergebnissen der WebDev Arena leicht vorne. Es sollte das erste Modell sein, das du für schwierige Aufgaben an Code-Repositories, langwierige Tool-gestützte Untersuchungen und Programmieraufgaben testest, bei denen ein Fehler teurer ist als zusätzliche Tokens.
DeepSeek V4 Pro gewinnt bei Flexibilität und Kosteneffizienz im Produktivbetrieb. Es unterstützt den Betrieb mit und ohne Thinking, bietet eine deutlich größere maximale Ausgabe, hat wesentlich günstigere Preise für zwischengespeicherte Eingaben, gewährt Rabatte außerhalb der Spitzenzeiten und stellt Teams, die eine offene Bereitstellung benötigen, Gewichte unter MIT-Lizenz zur Verfügung.
Für die meisten Entwickler lautet die praktisch beste Antwort auf die Frage GLM-5.3 vs. DeepSeek V4 Pro:
Verwende DeepSeek V4 Pro als Standardmodell und leite die schwierigsten fehlgeschlagenen oder risikoreichen Aufgaben anschließend an GLM-5.3 weiter.