最後你將會得到什麼
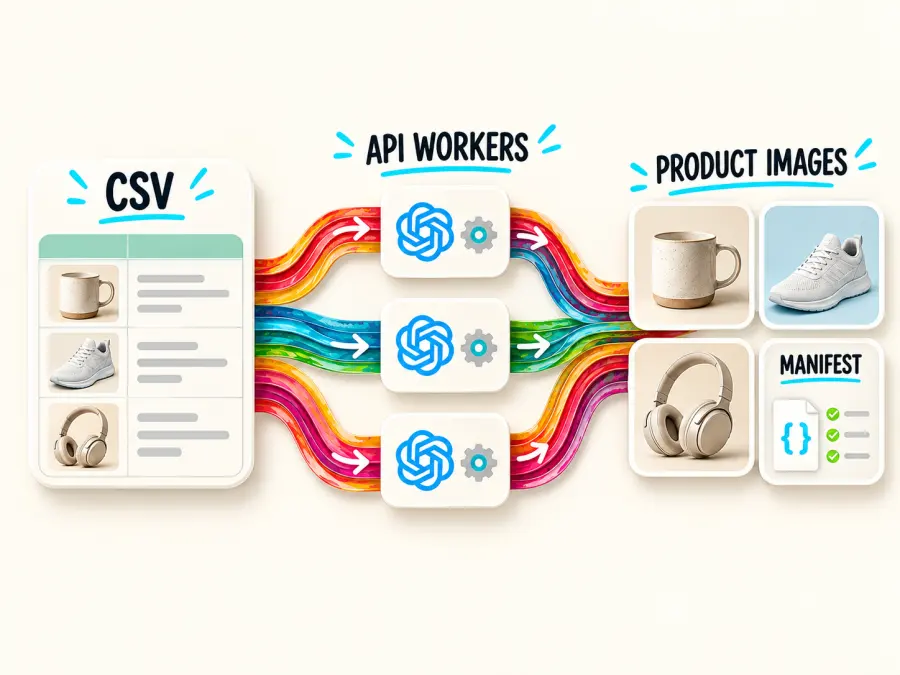
你會從兩個檔案開始:
指令碼執行時,會自動再建立兩個項目:
流程很直接:
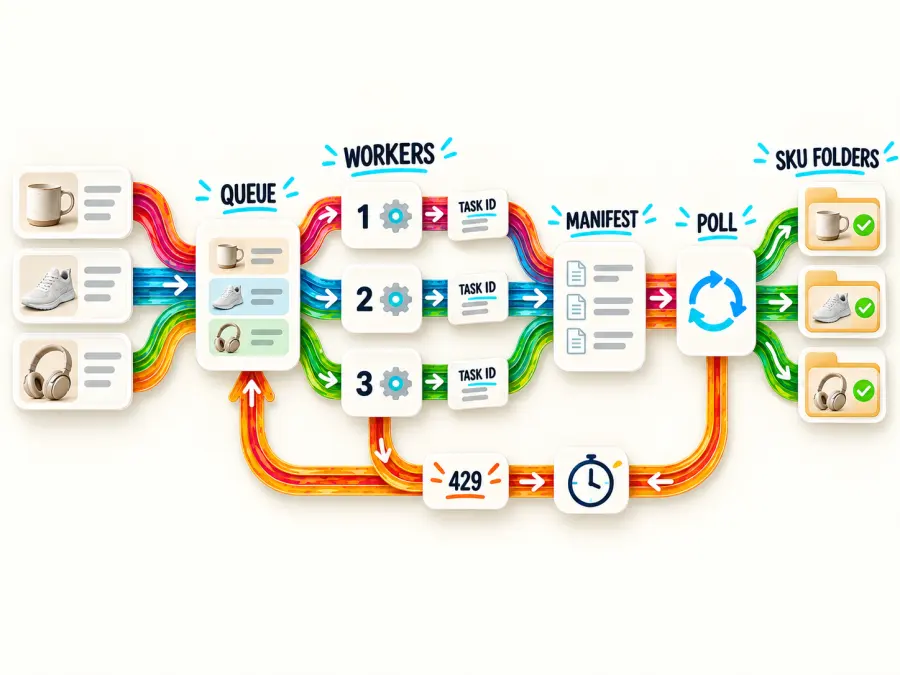
products.csv → Python 指令碼 → GPT Image 2 API → 下載的圖片
                         ↘ manifest.json
從本指南的三個範例產品開始。等它們能順利運作後,再把範例資料列替換成你真實的產品目錄。
本指南使用的初學者術語
| 術語 |
白話解釋 |
| API |
讓你的指令碼不需透過聊天視窗,就能傳送指令給 GPT Image 2 的方式。 |
| API 金鑰 |
一組私密密碼,用來識別你的 GPT Proto 帳戶並授權 API 使用。 |
| SKU |
你自己為單一產品設定的唯一代碼,例如 MUG-001。它也會用在輸出檔名中。 |
| 請求 |
指令碼傳送給 API 的一則訊息。在此工作流程中,一個產品通常會建立一個生成請求。 |
| 任務或預測 ID |
生成請求被接受後傳回的收據編號。指令碼會用它來檢查結果。 |
| 輪詢 |
每隔幾秒向結果端點詢問任務是否已完成。 |
| 並行處理 |
同時處理的產品數量。三個 worker 表示最多同時有三個進行中的工作。 |
| Manifest |
一份本機記錄,包含每個 SKU、任務 ID、結果與錯誤。它可讓中斷的指令碼安全地繼續執行。 |
| Base64 |
以長文字字串表示的影像資料。必須先解碼,才能變成一般的影像檔案。 |
API 工作流程類似在餐廳取餐。第一個請求是下訂單。傳回的任務 ID 是取餐號碼。輪詢會檢查餐點是否準備好。輸出 URL 是完成品可取回的位置。Manifest 就是你的收據簿。
ChatGPT 能一次生成多張產品圖片嗎?
ChatGPT 可以在一次對話中建立多張圖片,因此適合視覺探索和少量手動變化。它不是可靠的產品目錄流程:沒有 CSV 佇列、穩定的 SKU 對應檔案、並行控制或重試 manifest。
當問題是「我要如何建立多張產品圖片,並知道哪個檔案屬於哪個產品?」時,API 會更合適。
| 需求 |
ChatGPT 介面 |
GPT Image 2 API 工作流程 |
| 探索單一概念 |
適合 |
可行,但需要更多設定 |
| 處理 CSV 產品目錄 |
手動 |
自動化 |
| 為每個 SKU 使用不同提示詞 |
重複性高 |
一列資料變成一個請求 |
| 控制檔名與資料夾 |
手動下載 |
確定性的命名 |
| 接續失敗的工作 |
手動檢查 |
以 manifest 為基礎 |
| 與 DAM、PIM 或商店整合 |
有限 |
專為程式碼整合設計 |
像是「ChatGPT 一次生成多張圖片」這類搜尋,經常混雜兩種不同目標:同一個提示詞的數個變化版本,以及為不同產品生成多張圖片。當成本、檔案歸屬和重新執行成為考量時,這個區別就很重要。
「GPT Image 2 API 批次」可能代表什麼
人們用「批次」來指三種不同的模式:
1. 同一個提示詞的多個變化版本
將 n 設為 1 到 10 之間。當設計師想為同一個產品和構圖取得多個候選版本時,這很實用。它不會為十個 SKU 建立各產品專屬的提示詞。
2. 同時發出多個獨立請求
從檔案讀取多個產品,並為每一列送出一個請求。一個小型的 ThreadPoolExecutor 可提供受控的並行處理。這是本教學使用的模式,因為每個產品都可以有自己的名稱、顏色、材質、角度和背景。
3. OpenAI 的非同步 Batch API
OpenAI 的直接 Batch API 接受 JSONL 請求檔案,使用獨立的速率池,提供 50% 折扣,並在 24 小時內完成。OpenAI Batch API 指南 列出 /v1/images/generations 和 /v1/images/edits 為支援的端點。
那是另一項 OpenAI 功能。不要假設 GPT Proto 也有相同的 JSONL Batch 端點。下方的 GPT Proto 工作流程使用其文件記載的圖片端點和預測狀態路由。
你需要什麼
你需要一台電腦、Python 3、一組 GPT Proto API 金鑰,以及一個文字編輯器。Visual Studio Code 很方便,但任何能儲存純文字檔案的編輯器都可以。
1. 檢查是否已安裝 Python
在 macOS 或 Linux 上開啟 Terminal,或在 Windows 上開啟 PowerShell,然後執行:
python --version
如果 Windows 顯示無法辨識 python,請試試:
py --version
如果出現像是 Python 3.11.8 的結果,表示 Python 已就緒。如果兩個指令都無法使用,請安裝目前的 Python 3 版本,並啟用將 Python 加入系統路徑的選項。
2. 建立專案資料夾
建立一個名為 gpt-image-bulk 的資料夾。在其中建立這兩個空檔案:
bulk_product_images.py
products.csv
將本指南的完整 Python 指令碼貼到第一個檔案。將下方顯示的範例 CSV 貼到第二個檔案。除非你變更指令碼中的路徑,否則這兩個檔案必須放在同一個資料夾。
3. 建立並儲存你的 API 金鑰
在 GPT Proto 建立帳戶、加值,並產生一組 API 金鑰。API 金鑰應該像密碼一樣謹慎處理。不要把它發布在文章中、上傳到 GitHub,或直接貼到 Python 檔案裡。
將金鑰暫時儲存在環境變數中。在 macOS 或 Linux 上,執行:
export GPTPROTO_API_KEY="your-key-here"
在 Windows PowerShell 上,執行:
$env:GPTPROTO_API_KEY="your-key-here"
這個變數通常只在目前的終端機視窗中有效。如果你關閉該視窗並開啟另一個,請在執行指令碼前重新設定。
4. 安裝唯一需要的 Python 套件
指令碼使用 requests 與 API 通訊並下載圖片。使用下列指令安裝:
python -m pip install requests
需要用到 py 指令的 Windows 使用者,請改為執行 py -m pip install requests。
5. 將你的產品加入 CSV
CSV 代表「逗號分隔值」。這是一種簡單的試算表格式,Excel、Google Sheets 和大多數型錄工具都能匯出。每列加入一個產品:
建立 products.csv,每個產品一列:
sku,name,color,material,angle,background,avoid
MUG-001,可堆疊咖啡馬克杯,霧面海軍藍,炻器,四分之三視角,柔和暖灰,蒸氣或手
BAG-014,小巧斜背包,森林綠,荔枝紋皮革,正面四分之三視角,淺米色,道具或模特兒
LAMP-207,可攜式桌燈,奶油色,粉體塗裝鋁,正面,乾淨白色,可見電線或額外物品
每個欄位都有其用途:
| 欄位 |
輸入內容 |
範例 |
sku |
唯一的產品代碼 |
MUG-001 |
name |
簡短的產品名稱 |
可堆疊咖啡馬克杯 |
color |
精確的可見顏色或表面處理 |
霧面海軍藍 |
material |
主要可見材質 |
炻器 |
angle |
想要的相機視角 |
四分之三視角 |
background |
型錄背景 |
柔和暖灰 |
avoid |
圖片不應包含的物品或錯誤 |
蒸氣或手 |
請完全按照所示保留標題列,因為 Python 指令碼會尋找這些欄位名稱。每個 SKU 都必須是唯一的。如果產品名稱或欄位包含逗號,請從試算表程式匯出檔案,以確保值正確加上引號。
請使用簡短、事實性的欄位,而不是在每一列寫入不同的長提示詞。指令碼會將這些欄位與相同的攝影規則結合,這有助於讓型錄看起來一致。
步驟 1:建立可重複使用的產品提示詞
產品提示詞應將隨 SKU 變動的事實,與適用於整個型錄的規則分開。這讓提示詞修訂變得可衡量:只需變更共用範本一次,重新產生一組小型測試集,並與上一個版本比較。
def build_prompt(row):
    return f"""建立一張型錄商品照片。
產品:{row['name']}
顏色:{row['color']}
材質:{row['material']}
視角:{row['angle']}
背景:{row['background']}

讓商品置中,具備真實比例與材質紋理。
使用柔和棚燈、自然的接觸陰影,並保留充足的裁切安全空間。
不要有文字、標誌、標籤、人物或額外物品。
也避免:{row.get('avoid', '無')}。
回傳單一商品圖片,不要拼貼或縮圖表。"""
你不需為每個產品編輯這個函式。當指令碼讀取馬克杯列時,{row['name']} 會變成 可堆疊咖啡馬克杯;當它讀取包款列時,同一個預留位置會變成 小巧斜背包。這稱為範本:結構保持不變,而產品資料會改變。
「單一商品圖片」這項指示有助於防止模型將要求變成拼貼。關於相機視角、裁切、燈光、陰影和背景的共用指示,能讓不同產品看起來像同一份型錄,而不是互不相關的圖片。
如果初始結果不一致,請先編輯共用規則。例如,將「充足的裁切安全空間」替換為「產品應填滿方形畫布約 75%」。在將變更套用到整個檔案之前,先在三個不同產品類型上測試。
對於真正的品牌產品,文字轉圖像最適合概念照或一般商品。如果精確的幾何形狀、包裝或標籤位置很重要,請使用已核准的產品參考圖進行圖像編輯;該工作流程會稍後說明。
步驟 2:開始佇列前先測試單一產品
先從一個產品開始,n=1,quality="low",以及常見尺寸,例如 1024x1024。低品質適合在支付最終品質生成費用前檢查構圖。
以下 cURL 指令是一個小型 API 測試。cURL 是一種命令列工具,用於傳送網頁請求。這個指令使用 Bash 語法,因此在設定 API 金鑰後,請將其貼到 macOS 或 Linux 的終端機中。Windows 初學者可以略過手動 cURL 測試,並使用本指南後面的跨平台 Python 指令碼。
curl --request POST \
  --url "https://gptproto.com/api/v3/openai/gpt-image-2/text-to-image" \
  --header "Authorization: Bearer $GPTPROTO_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "prompt": "置中的啞光海軍藍石器咖啡馬克杯,四分之三目錄視角,柔和攝影棚光線,暖灰色背景,自然接觸陰影,無文字或道具",
    "n": 1,
    "quality": "low",
    "size": "1024x1024",
    "enable_sync_mode": false,
    "response_format": "url"
  }'
以下是重要行的含義:
| 欄位 |
含義 |
Authorization |
傳送您的私人 API 金鑰,讓 GPT Proto 知道是哪個帳戶發出請求。 |
prompt |
描述您想要的產品圖片。 |
n: 1 |
針對此提示要求一個結果。 |
quality: low |
第一次測試使用成本較低的草稿設定。 |
size: 1024x1024 |
要求正方形圖片。 |
enable_sync_mode: false |
先傳回任務收據,而不是讓請求保持開啟直到生成完成。 |
response_format: url |
當圖片準備好時傳回下載連結。 |
成功的第一個回應是一個 JSON 物件,其中在 data.id 中包含預測 ID。JSON 只是 API 使用的一種結構化文字格式。它可能看起來像這個簡短的範例:
{
  "data": {
    "id": "abc123",
    "status": "created",
    "urls": {
      "get": "https://gptproto.com/api/v3/predictions/abc123/result"
    }
  }
}
此回應不是圖片。它確認工作已被接受。複製傳回給您的真實 ID,並查詢其結果:
curl --request GET \
  --url "https://gptproto.com/api/v3/predictions/abc123/result" \
  --header "Authorization: Bearer $GPTPROTO_API_KEY"
將 abc123 替換為您的任務 ID。如果 data.status 仍是 created 或 processing,請等待幾秒鐘,然後再次執行 GET 指令。當它變成 completed 時,data.outputs 會包含生成的輸出。完整的 Python 指令碼會自動執行這些檢查,因此您不需要為每個產品重複此手動程序。
請參閱 GPT Proto GPT Image 2 文字轉圖片參考,以了解目前的請求和回應欄位。
在一個產品通過這些檢查之前,請勿啟動完整目錄:
裁切後留有足夠空間,適用於每個店面版位。
顏色和材質足夠接近預期用途。
背景和接觸陰影符合目錄風格。
沒有出現虛構的標誌、標籤、道具或重複產品。
結果路由和下載程式碼都能在您的環境中運作。
如果測試傳回 401 Unauthorized,首先要檢查 API 金鑰和 Authorization 標頭。如果傳回 403,請檢查模型存取權和帳戶餘額。在此單一項目測試成功之前,請勿繼續進行完整目錄。
步驟 3:避免「尺寸必須為 16 的倍數」錯誤
GPT Image 2 接受常見的預設尺寸和有效的自訂尺寸。對於自訂尺寸,兩邊都必須是 16 的倍數,最長邊不能超過 3,840 像素,長寬比不能超過 3:1,且圖片必須包含 655,360 到 8,294,400 個像素。總解析度高於 2560×1440 的輸出在 API 文件中標記為實驗性。
「兩邊都必須是 16 的倍數」是指寬度和高度都必須能被 16 整除且沒有餘數。像 1024、1200、1536 和 2048 這類數字可通過檢查。像 1000 這樣的數字則不行。此規則適用於寬度和高度,不僅是最長邊。
在傳送付費請求之前進行驗證:
def validate_size(size):
    if size == "auto":
        return

    width, height = map(int, size.lower().split("x"))
    pixels = width * height

    if width % 16 or height % 16:
        raise ValueError("GPT Image 2 寬度和高度必須是 16 的倍數")
    if max(width, height) > 3840:
        raise ValueError("最長邊不能超過 3840 像素")
    if max(width, height) / min(width, height) > 3:
        raise ValueError("長寬比不能超過 3:1")
    if not 655_360 <= pixels <= 8_294_400:
        raise ValueError("總像素數超出支援的範圍")
1200x1200 是有效的,因為兩邊都能被 16 整除。1000x1000 則不是。如果店面最終需要 1000x1000,請以 1024x1024 生成,並在核准後調整大小。
支援的預設尺寸包括 1024x1024、1536x1024、1024x1536、2048x2048、2048x1152、3840x2160,以及 2160x3840。
步驟 4:使用受控並行,而非無界迴圈
並行是指指令碼同時處理多少個產品。把 worker 想成結帳櫃檯:一個 worker 處理一個進行中的產品;三個 worker 可讓最多三個產品一起在系統中流通。
若迴圈啟動數百個 worker,可能會觸及速率限制、耗用記憶體,並讓失敗復原變得更困難。一開始先使用兩或三個。只有在檢查帳戶行為與完成時間之後,再增加數量。
from concurrent.futures import ThreadPoolExecutor, as_completed

with ThreadPoolExecutor(max_workers=3) as pool:
    futures = [pool.submit(process_product, row) for row in products]
    for future in as_completed(futures):
        print(future.result())
你不需要了解 Python 執行緒,也能使用這個範例。 max_workers=3 是重要設定。如果你持續收到 429 錯誤,請將它降低為 2 或 1。如果長時間測試執行時沒有速率限制錯誤,你可以謹慎嘗試更大的值。
模型供應商發佈的速率限制,不一定就是中介 API 帳戶的限制。請將 429 Too Many Requests 及其 Retry-After 標頭視為作用中 GPT Proto 金鑰的真實依據。請讓並行數保持可設定,而不是在程式碼中嵌入過於積極的數字。
OpenAI 也會公佈直接模型存取的分層限制。這些數字是有用的背景資訊,但不應被當成 GPT Proto 的速率限制。
步驟 5:正確儲存 URL 與 Base64 結果
GPT Proto 支援此端點的 response_format="url" 與 response_format="b64_json"。
初學者應先使用 url。API 會傳回一般圖片連結,指令碼會將檔案下載到 generated 資料夾。請立即下載,因為結果 URL 是交付連結,不是永久資產儲存空間。將核准的檔案儲存在你自己的產品媒體資料夾、DAM 或物件儲存空間。
Base64 是傳遞同一張圖片另一種方式:回應會包含非常長的字串,而不是 URL。當系統必須將所有資料保留在 JSON 內時很有用,但必須先將文字轉回二進位圖片位元組,檔案才能開啟。這個工作流程的第一版不需要使用 Base64。
若要輸出 Base64,請將字串解碼為位元組:
import base64
from pathlib import Path

def save_base64_image(value, destination):
    # Also accepts a data URI such as data:image/png;base64,...
    encoded = value.split(",", 1)[1] if value.startswith("data:") else value
    Path(destination).write_bytes(base64.b64decode(encoded, validate=True))
常見的 GPT Image 2 Base64 解碼錯誤,是將編碼後的文字直接寫入 .png 檔案。有效的圖片檔包含解碼後的二進位位元組,而不是 API 傳回的 JSON 字串。
如果你直接使用 OpenAI 而不是 GPT Proto,請注意 GPT 圖像模型會傳回 b64_json;OpenAI 的 圖像生成指南 指出,GPT 圖像模型不支援 URL 回應格式。供應商之間的差異,就是回應解析應與你實際呼叫的端點相符的原因。
步驟 6:重試而不建立重複圖片
API 要求可能因為帳戶送出工作太快、網路中斷,或生成本身被拒絕而失敗。重複每個失敗命令很誘人,但這可能建立重複圖片。
對每個要求而言,重試的安全性並不相同。POST 會建立新任務;GET 只會檢查既有任務。
一個 GET 狀態查詢可安全重試,因為它不會建立另一張圖片。
一個 POST 若收到明確的 429 拒絕,可以等待 Retry-After 後再試一次。
一個 POST 連線逾時是模稜兩可的。伺服器可能已接受工作,即使用戶端錯過了回應。盲目重複可能建立並計費一筆重複項目。
已完成、失敗或被審核阻擋的工作,不應自動再次提交。
下方的指令碼會在提交後立即將任務 ID 寫入 manifest.json。下一次執行時,它會輪詢該既有任務,而不是再次提交相同的 SKU。如果提交最後處於未知的網路狀態且沒有任務 ID,該記錄會標記為 manual_check;在重試之前,請先確認帳戶歷史記錄。
請使用帶有抖動的指數退避來安全重試。當 API 送出 Retry-After 時請遵守它,設定延遲上限,並限制嘗試次數。重複失敗應寫入 manifest,而不是進入無限迴圈。
步驟 7:處理 image_generation_user_error
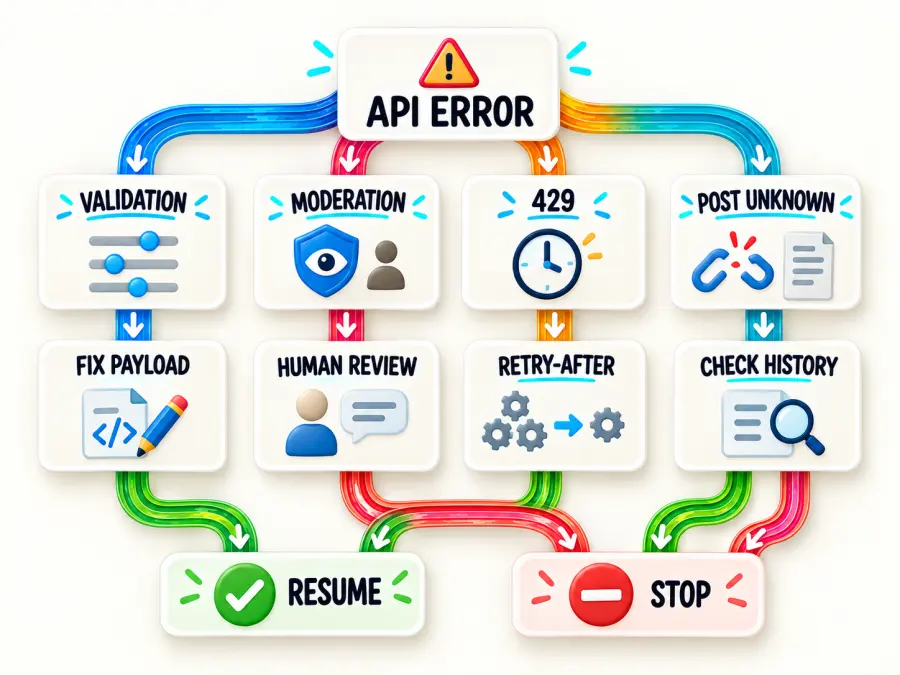
image_generation_user_error 是一個類別,不是完整的診斷。它表示要求無法生成,原因與輸入或要求有關。在決定要變更什麼之前,請先閱讀內部的錯誤碼與訊息。
典型動作如下:
| 錯誤訊號 |
可能動作 |
moderation_blocked 或政策詳細資料 |
檢查提示詞與任何參考圖片;不要原樣重試 |
| 無效尺寸 |
執行本機驗證並修正尺寸 |
| 無效參數或不支援的格式 |
將承載內容與目前的端點參考進行比對 |
驗證失敗(401) |
檢查金鑰值與授權標頭 |
權限或餘額失敗(403) |
檢查模型存取權與餘額;不要使用自動退避 |
速率限制(429) |
遵守 Retry-After、降低並行數、設定重試上限 |
伺服器錯誤(500) |
記錄要求,並僅在了解重複風險時重試 |
不要透過刪除詞語直到要求溜過審核來「修正」審核錯誤。請確認產品、預期用途、參考素材與提示詞符合供應商的政策。
對初學者來說,當工作失敗時,請依下列順序處理:
在 manifest.json 中找到 SKU。
閱讀其 error 欄位,而不是立即再次提交產品。
如果訊息指出尺寸或參數,請修正該值。
如果是 429,請降低 IMAGE_WORKERS 並等待後再繼續。
如果是政策或審核錯誤,請手動檢查產品與提示詞。
如果狀態是 manual_check,請在刪除記錄之前檢查任務歷史記錄;原始要求可能已經存在。
步驟 8:維護適合團隊使用的生成資訊清單
資訊清單不是您需要設定的 API 功能。它是由指令碼在您的電腦上建立的 JSON 檔案。您可以把它想成生成記錄。
對團隊或企業而言,只有圖片資料夾並不夠。資訊清單會將每個素材連結到 SKU、提示詞、設定、任務 ID、狀態、輸出路徑和錯誤。
範例記錄:
{
  "MUG-001": {
    "sku": "MUG-001",
    "status": "completed",
    "task_id": "prediction-id",
    "quality": "low",
    "size": "1024x1024",
    "prompt": "建立一張型錄產品照片...",
    "files": ["generated/MUG-001-01.png"],
    "error": null
  }
}
在此記錄中,completed 表示圖片已生成並下載。task_id 是 API 收據編號。files 會告訴團隊圖片儲存的位置。如果生成失敗,error 會包含所需資訊,以便決定應該修正、重試或審核該 SKU。
這讓審核者有穩定的交接依據。它也讓您能夠只重新生成被拒絕的項目、比較提示詞版本,並將素材追溯回建立它的請求。對於較大的團隊,請將相同欄位儲存在資料庫中,並新增審核者、核准狀態、提示詞版本、活動和權利備註。
用於批次產品生成的完整 Python 腳本
以下腳本整合了整個工作流程。它使用目前的 GPT Proto v3 文字轉圖像端點與預測結果路由,每個 SKU 傳送 n=1,預設為三個 worker,並從 manifest.json 恢復已知任務。
這段程式碼比基本的 API 示範更長,因為它為您執行多項安全檢查:
在送出請求前檢查圖像尺寸。
一旦 API 接受產品,就立即儲存任務 ID。
等待每張圖像完成,無須您手動執行 GET 命令。
下載 URL 結果並解碼 Base64 結果。
限制一次處理的產品數量。
記錄失敗,並在重新啟動後繼續已知任務。
第一次執行時,請直接複製腳本,不要變更其功能。您只需要提供 products.csv 和 API 金鑰。頂端的設定——SIZE、QUALITY、WORKERS,以及 POLL_TIMEOUT——可以之後再調整。
import base64
import csv
import json
import os
import random
import re
import threading
import time
from concurrent.futures import ThreadPoolExecutor, as_completed
from pathlib import Path
from urllib.parse import urlparse

import requests

API_ROOT = "https://gptproto.com/api/v3"
SUBMIT_URL = f"{API_ROOT}/openai/gpt-image-2/text-to-image"
RESULT_URL = f"{API_ROOT}/predictions/{{task_id}}/result"

CSV_PATH = Path(os.getenv("PRODUCTS_CSV", "products.csv"))
OUTPUT_DIR = Path(os.getenv("IMAGE_OUTPUT_DIR", "generated"))
MANIFEST_PATH = Path(os.getenv("IMAGE_MANIFEST", "manifest.json"))

SIZE = os.getenv("IMAGE_SIZE", "1024x1024")
QUALITY = os.getenv("IMAGE_QUALITY", "low")
WORKERS = int(os.getenv("IMAGE_WORKERS", "3"))
POLL_TIMEOUT = int(os.getenv("IMAGE_POLL_TIMEOUT", "900"))

API_KEY = os.environ["GPTPROTO_API_KEY"]
HEADERS = {
    "Authorization": f"Bearer {API_KEY}",
    "Content-Type": "application/json",
}

manifest_lock = threading.Lock()


class SubmissionStateUnknown(RuntimeError):
    """The POST may have reached the server, but no task ID was received."""


def validate_size(size):
    if size == "auto":
        return
    if not re.fullmatch(r"\d+x\d+", size.lower()):
        raise ValueError("Size must look like 1024x1024 or be 'auto'")

    width, height = map(int, size.lower().split("x"))
    pixels = width * height
    if width % 16 or height % 16:
        raise ValueError("GPT Image 2 width and height must be multiples of 16")
    if max(width, height) > 3840:
        raise ValueError("The longest edge cannot exceed 3840 pixels")
    if max(width, height) / min(width, height) > 3:
        raise ValueError("Aspect ratio cannot exceed 3:1")
    if not 655_360 <= pixels <= 8_294_400:
        raise ValueError("Total pixels are outside the supported range")


def build_prompt(row):
    return f"""Create one catalog product photograph.
Product: {row['name']}
Color: {row['color']}
Material: {row['material']}
View: {row['angle']}
Background: {row['background']}

Keep the product centered with realistic proportions and material texture.
Use soft studio lighting, a natural contact shadow, and generous crop-safe space.
No text, logos, labels, people, or extra objects.
Also avoid: {row.get('avoid', 'none')}.
Return a single product image, not a collage or contact sheet."""


def load_manifest():
    if not MANIFEST_PATH.exists():
        return {}
    return json.loads(MANIFEST_PATH.read_text(encoding="utf-8"))


manifest = load_manifest()


def save_record(sku, **changes):
    with manifest_lock:
        record = manifest.setdefault(sku, {"sku": sku})
        record.update(changes)
        temporary = MANIFEST_PATH.with_suffix(".json.tmp")
        temporary.write_text(
            json.dumps(manifest, indent=2, ensure_ascii=False),
            encoding="utf-8",
        )
        temporary.replace(MANIFEST_PATH)


def parse_json(response):
    try:
        return response.json()
    except ValueError:
        return {"raw_response": response.text[:1000]}


def api_error(response):
    payload = parse_json(response)
    return RuntimeError(
        f"HTTP {response.status_code}: {json.dumps(payload, ensure_ascii=False)}"
    )


def submit(prompt):
    payload = {
        "prompt": prompt,
        "n": 1,
        "quality": QUALITY,
        "size": SIZE,
        "enable_sync_mode": False,
        "response_format": "url",
    }

    # Retry only a definite 429 rejection. A connection failure is ambiguous:
    # the job may exist even though this client did not receive its ID.
    for attempt in range(5):
        try:
            response = requests.post(
                SUBMIT_URL,
                headers=HEADERS,
                json=payload,
                timeout=(10, 180),
            )
        except requests.RequestException as exc:
            raise SubmissionStateUnknown(str(exc)) from exc

        if response.status_code != 429:
            if response.status_code >= 400:
                raise api_error(response)
            body = parse_json(response)
            data = body.get("data", body)
            task_id = data.get("id")
            if not task_id:
                raise RuntimeError(f"Submission returned no data.id: {body}")
            return task_id

        if attempt == 4:
            raise api_error(response)
        retry_after = response.headers.get("Retry-After")
        delay = float(retry_after) if retry_after and retry_after.isdigit() else 2**attempt
        time.sleep(min(30, delay) + random.random())

    raise RuntimeError("Submission retry loop ended unexpectedly")


def get_result(task_id):
    deadline = time.monotonic() + POLL_TIMEOUT
    delay = 2.0

    while time.monotonic() < deadline:
        try:
            response = requests.get(
                RESULT_URL.format(task_id=task_id),
                headers=HEADERS,
                timeout=(10, 60),
            )
        except requests.RequestException:
            time.sleep(delay + random.random())
            delay = min(10, delay * 1.5)
            continue

        if response.status_code == 429 or response.status_code >= 500:
            retry_after = response.headers.get("Retry-After")
            wait = float(retry_after) if retry_after and retry_after.isdigit() else delay
            time.sleep(min(30, wait) + random.random())
            delay = min(10, delay * 1.5)
            continue
        if response.status_code >= 400:
            raise api_error(response)

        body = parse_json(response)
        data = body.get("data", body)
        status = str(data.get("status", "")).lower()

        if status in {"completed", "succeeded"}:
            outputs = data.get("outputs") or []
            if not outputs:
                raise RuntimeError(f"Completed task returned no outputs: {body}")
            return outputs
        if status in {"failed", "canceled", "cancelled"}:
            raise RuntimeError(json.dumps(data.get("error") or body, ensure_ascii=False))

        time.sleep(delay)
        delay = min(10, delay * 1.25)

    raise TimeoutError(f"Task {task_id} exceeded {POLL_TIMEOUT} seconds")


def filename_part(value):
    cleaned = re.sub(r"[^A-Za-z0-9._-]+", "-", value.strip())
    return cleaned.strip("-._") or "product"


def extension_from_response(response, url):
    content_type = response.headers.get("Content-Type", "").split(";", 1)[0]
    by_type = {"image/png": ".png", "image/jpeg": ".jpg", "image/webp": ".webp"}
    if content_type in by_type:
        return by_type[content_type]
    suffix = Path(urlparse(url).path).suffix.lower()
    return suffix if suffix in {".png", ".jpg", ".jpeg", ".webp"} else ".png"


def save_output(output, sku, index):
    OUTPUT_DIR.mkdir(parents=True, exist_ok=True)
    stem = f"{filename_part(sku)}-{index:02d}"

    if isinstance(output, dict):
        output = output.get("url") or output.get("b64_json") or output.get("data")
    if not isinstance(output, str):
        raise TypeError(f"Unsupported output value: {output!r}")

    if output.startswith(("http://", "https://")):
        response = requests.get(output, timeout=(10, 180))
        response.raise_for_status()
        destination = OUTPUT_DIR / f"{stem}{extension_from_response(response, output)}"
        destination.write_bytes(response.content)
        return str(destination)

    encoded = output.split(",", 1)[1] if output.startswith("data:") else output
    destination = OUTPUT_DIR / f"{stem}.png"
    destination.write_bytes(base64.b64decode(encoded, validate=True))
    return str(destination)


def process_product(row):
    sku = row["sku"].strip()
    prompt = build_prompt(row)
    previous = manifest.get(sku, {})

    if previous.get("status") == "completed":
        return sku, "skipped: already completed"
    if previous.get("status") == "manual_check" and not previous.get("task_id"):
        return sku, "skipped: verify task history before resubmitting"
    if previous.get("status") == "failed":
        return sku, "skipped: review the recorded error before retrying"

    task_id = previous.get("task_id")

    try:
        if not task_id:
            task_id = submit(prompt)
            save_record(
                sku,
                status="submitted",
                task_id=task_id,
                quality=QUALITY,
                size=SIZE,
                prompt=prompt,
                files=[],
                error=None,
            )

        save_record(sku, status="processing")
        outputs = get_result(task_id)
        files = [save_output(value, sku, i) for i, value in enumerate(outputs, 1)]
        save_record(sku, status="completed", files=files, error=None)
        return sku, f"completed: {', '.join(files)}"

    except SubmissionStateUnknown as exc:
        save_record(
            sku,
            status="manual_check",
            task_id=None,
            quality=QUALITY,
            size=SIZE,
            prompt=prompt,
            files=[],
            error=f"Submission state unknown: {exc}",
        )
        return sku, "manual check required"
    except TimeoutError as exc:
        # Keep the task ID. The next run will poll this job instead of submitting
        # the SKU again, so a slow generation does not become a duplicate.
        save_record(sku, status="poll_timeout", task_id=task_id, error=str(exc))
        return sku, f"poll timed out; resume task {task_id} on the next run"
    except Exception as exc:
        save_record(sku, status="failed", task_id=task_id, error=str(exc))
        return sku, f"failed: {exc}"


def main():
    validate_size(SIZE)
    if WORKERS < 1:
        raise ValueError("IMAGE_WORKERS must be at least 1")

    with CSV_PATH.open(newline="", encoding="utf-8-sig") as handle:
        products = list(csv.DictReader(handle))

    required = {"sku", "name", "color", "material", "angle", "background"}
    missing = required - set(products[0]) if products else required
    if missing:
        raise ValueError(f"CSV is missing columns: {sorted(missing)}")

    skus = [row["sku"].strip() for row in products]
    if not all(skus):
        raise ValueError("Every CSV row must have a non-empty SKU")
    if len(skus) != len(set(skus)):
        raise ValueError("CSV contains duplicate SKUs; make each SKU unique before running")

    with ThreadPoolExecutor(max_workers=WORKERS) as pool:
        futures = [pool.submit(process_product, row) for row in products]
        for future in as_completed(futures):
            sku, message = future.result()
            print(f"[{sku}] {message}")


if __name__ == "__main__":
    main()
如何執行腳本:新手逐步操作
1. 確認兩個輸入檔案
開啟你的 gpt-image-bulk 資料夾,並確認其中包含:
請勿將腳本儲存為 bulk_product_images.py.txt。如果你的編輯器隱藏副檔名,請先檢查檔案類型再繼續。
2. 在該資料夾中開啟終端機
終端機必須指向與這兩個檔案相同的資料夾。你可以使用 cd 加上資料夾路徑,例如:
cd path/to/gpt-image-bulk
你可以使用 macOS/Linux 上的 pwd 或 PowerShell 中的 Get-Location 來確認目前資料夾。
3. 設定 API 金鑰並安裝 requests
使用設定區段顯示的指令設定 GPTPROTO_API_KEY。然後,如果你還沒安裝 requests,請安裝它:
python -m pip install requests
4. 執行檔案
在 macOS、Linux 及大多數 Python 安裝環境中:
python bulk_product_images.py
在 Windows 上,如果你的 Python 指令是 py,請使用這個:
py bulk_product_images.py
第一個產品可能需要一些時間才能完成。當 API 正在生成時,終端機不一定已經凍結。當任務完成時,你應該會看到類似以下的內容:
[MUG-001] completed: generated/MUG-001-01.png
[BAG-014] completed: generated/BAG-014-01.png
[LAMP-207] completed: generated/LAMP-207-01.png
資料夾現在會包含 generated/ 與 manifest.json。開啟生成的圖片,並將每一張與對應的 CSV 資料列進行比對。然後用文字編輯器開啟 manifest.json,確認每個成功的 SKU 都有 "status": "completed"。
5. 了解再次執行時會發生什麼事
腳本會先讀取 manifest.json,然後才傳送新請求。已完成的 SKU 會被跳過。先前在輪詢期間停止的任務會保留其任務 ID,並再次接受檢查。標記為 manual_check 或 failed 的記錄不會自動提交。
這是刻意設計的。它可避免「再次執行指令」變成「再次為每張成功的圖片付費」。如果某筆失敗記錄可以安全重試,請在檢閱其錯誤後,只從 manifest.json 中移除該 SKU 的記錄。除非你刻意想重新提交整個目錄,否則不要刪除整份 manifest。
6. 從草稿進入最終圖片
第一次執行時,請將 IMAGE_QUALITY=low 與 IMAGE_WORKERS=2 或 3。檢閱草稿,並只將已核准的產品資料列複製到名為 products-final.csv 的新檔案中。
若要在 macOS 或 Linux 上另外進行最終執行,請使用新的輸出與 manifest 名稱,讓草稿檔案保持不變:
PRODUCTS_CSV=products-final.csv \
IMAGE_OUTPUT_DIR=generated-final \
IMAGE_MANIFEST=manifest-final.json \
IMAGE_QUALITY=high \
python bulk_product_images.py
在 Windows PowerShell 中,請先設定相同的值,然後執行腳本:
$env:PRODUCTS_CSV="products-final.csv"
$env:IMAGE_OUTPUT_DIR="generated-final"
$env:IMAGE_MANIFEST="manifest-final.json"
$env:IMAGE_QUALITY="high"
py bulk_product_images.py
這會在 generated-final/ 中產生最終圖片,同時保留草稿圖片與草稿 manifest 以供比較。
適用於批次工作的 GPT Image 2 定價
GPT Image 2 定價以權杖為基礎,因此對每個工作而言,並不存在一個誠實的單一「每張產品圖片成本」。文字輸入、參考圖片輸入、輸出尺寸、品質,以及結果數量都會影響總額。
對初學者來說,「每百萬個權杖」是一種計費單位,不是每月訂閱,也不是要求你事先購買一百萬個權杖。你的提示會變成文字輸入權杖。用於編輯的參考產品照片會變成圖片輸入權杖。生成的圖片會變成圖片輸出權杖。文字轉圖片請求不會有參考圖片輸入費用,因為沒有上傳來源圖片。
在撰寫本文時,GPT Proto 模型頁面列出以下每百萬個權杖的費率:
| 權杖類別 |
GPT Proto 所列費率 |
OpenAI 標準費率 |
| 文字輸入 |
$4.00 |
$5.00 |
| 圖片輸入 |
$6.40 |
$8.00 |
| 快取圖片輸入 |
$1.60 |
$2.00 |
| 圖片輸出 |
$24.00 |
$30.00 |
這比所列的 OpenAI 標準權杖費率低 20%。價格可能會變動,因此在發布報價或開始大量執行前,請查看 即時的 GPT Image 2 模型頁面。
OpenAI 的定價參考也提供了常見尺寸的實用僅輸出範例。一張 1024x1024 圖片在低品質下約為 $0.006,中品質約為 $0.053,高品質約為 $0.211;一張 1536x1024 或 1024x1536 圖片則分別約為 $0.005、$0.041 和 $0.165。輸入權杖另計。請查看目前的 OpenAI API 定價頁面,不要將這些數字視為永久不變。
若要估算整個目錄的成本,請先執行 20 個品項的試驗,反映真實的產品組合。記錄實際支出、已核准圖片比率,以及重新生成比率。然後計算:
預估目錄成本 =
  每次嘗試的平均 API 成本
  × 每張已核准圖片的平均嘗試次數
  × 產品數量
重新生成比率很容易被忽略。一個需要四次嘗試的便宜草稿,成本可能高於控制得更好、且在第一或第二次嘗試就獲得核准的中品質工作。
何時應使用參考圖片而非文字轉圖片
當產品是通用款、圖片是概念性,或確切包裝不需要與可銷售品項相符時,適合使用純文字轉圖片。它不應成為精確 SKU 呈現的預設做法。
當你需要保留現有產品的形狀、顏色、包裝或設計語言時,請使用 GPT Image 2 圖片編輯端點。根據官方格式文件,GPT Image 2 最多接受 16 張 PNG、WebP 或 JPEG 參考圖片,每張低於 50 MB,並且會自動使用高輸入保真度。GPT Proto 的供應商格式端點接受圖片 URL 或 Base64 資料 URI;請參閱其 GPT Image 2 圖片編輯參考。
良好的參考圖片集包括:
一張乾淨的產品正面或四分之三角度照片。
當形狀不明確時,提供第二個角度。
針對重要材質紋理或控制項的特寫。
在提示中清楚標示的燈光與背景獨立風格參考。
參考圖片能提升控制力,但無法保證標籤、小字或產品尺寸達到像素級精確。在發布前,應由人工審閱者將生成的素材與來源產品進行比對。
企業與團隊使用的正式環境檢查清單
在從試行轉向批次生成之前:
鎖定一個提示版本並將其儲存在 manifest 中。
使用一個不可變的 SKU 作為主要資產鍵。
以低品質產生草稿;僅將已核准的構圖以最終設定渲染。
將 worker 數量保持為可設定,並在重複出現 429 回應後降低。
在輪詢之前儲存任務 ID。
立即下載每個暫時性結果 URL。
區分 failed、manual_check 與 completed 狀態。
切勿原樣重試內容審核、權限或餘額錯誤。
檢查樣本結果的幾何、顏色、標籤、陰影、裁切與重複物件。
保留來源/參考素材的權利並記錄審查核准。
將 API 金鑰保存在秘密管理器或環境變數中,而不是 CSV 或儲存庫。
在將目錄自動化之前進行提示開發時,GPT Image 2 提示範例 可協助建立視覺方向。在規模化執行之前,將選定的方向轉換為結構化欄位。
從小型目錄切片開始
API 呼叫是簡單的部分。可靠的批次生成來自將一個產品與一個變體分開、限制並行數、驗證輸入、儲存預測 ID,並讓每次執行都可恢復。
先從 10 到 20 個具代表性的 SKU 以低品質開始。衡量核准率與重新生成率,修正共用提示,然後才擴大佇列。你可以在 GPT Image 2 模型頁面 檢視目前參數與定價,或從 GPT Proto 首頁 建立帳戶,當你準備好執行腳本時。