Qwen 3.7 Plus vs Qwen 3.8 Max : Réponse rapide
| Cas d'usage |
Meilleur choix |
Pourquoi |
| Meilleure qualité globale de réponse |
Qwen 3.8 Max |
Il devance largement dans les évaluations indépendantes d'intelligence et d'agents de codage. |
| Charges de travail API courantes |
Qwen 3.7 Plus |
Prix catalogue inférieur et vitesse de sortie mesurée nettement plus élevée. |
| Codage difficile au niveau du dépôt |
Qwen 3.8 Max |
Meilleures performances sur des tâches d'ingénierie logicielle indépendantes. |
| Codage frontend |
Qwen 3.8 Max |
Bon classement dans WebDev Arena et meilleur raisonnement visuel. |
| Classification ou extraction à grand volume |
Qwen 3.7 Plus |
La qualité de Max est souvent inutile pour des tâches contraintes et répétables. |
| Agents visuels |
Qwen 3.8 Max |
Roboflow a constaté un large avantage de précision sur six évaluations de vision. |
| Coût par token le plus bas |
Qwen 3.7 Plus |
L'entrée commence à un cinquième du prix catalogue international de Max. |
| Réponses longues et traces d'agents étendues |
Qwen 3.8 Max |
La sortie maximale est de 131 072 tokens, soit le double de la limite de Plus. |
Notre verdict : Qwen 3.8 Max remporte la comparaison des capacités. Qwen 3.7 Plus l'emporte comme option économique par défaut. Pour de nombreux systèmes de production, la configuration la plus judicieuse consiste à router les requêtes normales vers Plus et à escalader les cas difficiles vers Max.
Qu'est-ce qui a changé de Qwen 3.7 Plus à Qwen 3.8 Max ?
Qwen 3.7 Plus est positionné comme un modèle de production moins coûteux et plus rapide. Qwen 3.8 Max est l'option phare pour le raisonnement complexe, le codage, les agents et le travail multimodal.
La documentation officielle de Qwen 3.7 Plus liste une fenêtre de contexte de 1 million de tokens, la réflexion hybride, l'appel de fonctions, la sortie structurée, la recherche web et la mise en cache des prompts. La documentation de Qwen 3.8 Max conserve la même échelle d'entrée mais augmente la longueur maximale de sortie et ajoute un contrôle plus direct sur l'effort de raisonnement.
| Spécification |
Qwen 3.7 Plus |
Qwen 3.8 Max |
| ID du modèle |
qwen3.7-plus |
qwen3.8-max |
| Période de sortie |
Mai/Juin 2026 |
Août 2026 |
| Architecture |
397B de paramètres au total, 17B actifs |
2,4T de paramètres au total, 95B actifs |
| Entrées |
Texte, image, vidéo |
Texte, image, vidéo |
| Sortie |
Texte |
Texte |
| Fenêtre de contexte |
1 000 000 tokens |
1 000 000 tokens |
| Entrée maximale |
991 808 tokens |
991 808 tokens |
| Sortie maximale |
65 536 tokens |
131 072 tokens |
| Longueur maximale de réflexion |
262 144 tokens |
262 144 tokens |
| Appel de fonctions |
Oui |
Oui |
| Sortie structurée |
Oui |
Oui |
| Fine-tuning |
Non |
Non |
| Poids ouverts |
Aucune version ouverte correspondante |
Poids Qwen3.8 2.4T-A95B publiés séparément |
L'API gérée qwen3.8-max et les poids Qwen3.8-2.4T-A95B publiés séparément appartiennent à la même famille, mais peuvent différer en termes de service, de limites et de fonctionnalités. Un déploiement auto-hébergé ne reproduira pas nécessairement tous les résultats cloud.
Tarification de Qwen 3.7 Plus vs Qwen 3.8 Max
La tarification Alibaba Cloud varie selon la région, la longueur du contexte, la mise en cache et les remises temporaires. Le tableau ci-dessous utilise les prix catalogue internationaux durables affichés pour le déploiement de Singapour plutôt qu'une promotion à court terme.
| Modèle et taille de la requête |
Entrée par 1M tokens |
Sortie par 1M tokens |
| Qwen 3.7 Plus, jusqu'à 256K d'entrée |
$0.40 |
$1.60 |
| Qwen 3.7 Plus, plus de 256K à 1M d'entrée |
$1.20 |
$4.80 |
| Qwen 3.8 Max |
$2.00 |
$6.00 |
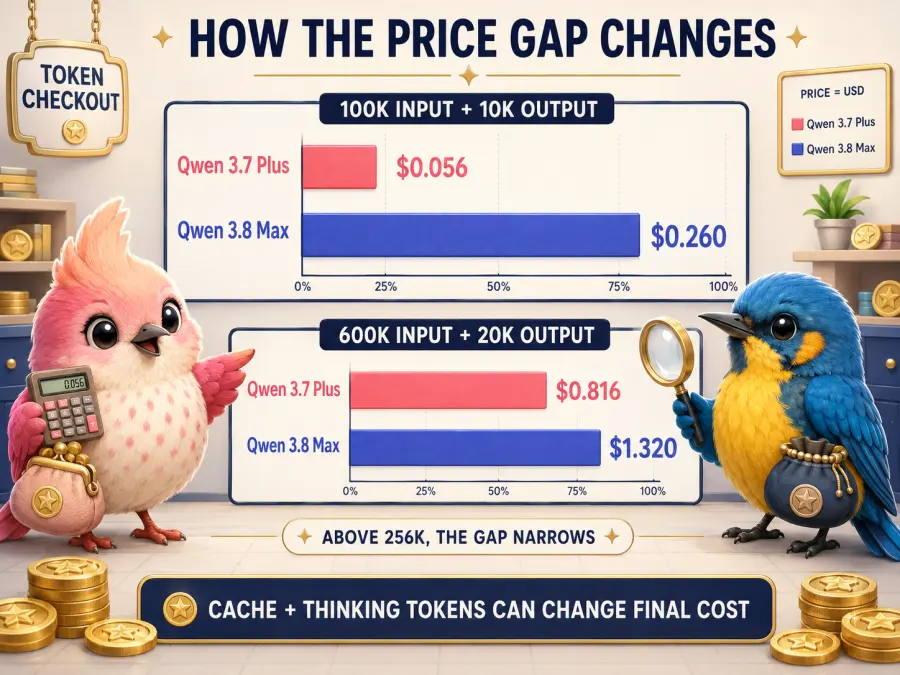
Plus est cinq fois moins cher pour l'entrée uniquement dans son palier de contexte inférieur. Au-delà de 256K tokens d'entrée, son prix international augmente et l'écart se réduit.
Voici deux exemples simplifiés avant mise en cache, tokens de réflexion ou frais spécifiques à la plateforme :
Une requête avec 100K tokens d'entrée et 10K tokens de sortie coûte environ $0.056 sur Qwen 3.7 Plus et $0.260 sur Qwen 3.8 Max.
Une requête avec 600K tokens d'entrée et 20K tokens de sortie coûte environ $0.816 sur Qwen 3.7 Plus et $1.320 sur Qwen 3.8 Max.
La longueur de la requête, la sortie, les hits de cache et les tentatives modifient tous la facture effective. Consultez la page de tarification officielle de Model Studio pour votre région.
 GPT Proto affiche actuellement Qwen 3.8 Max à $1.80 par million de tokens d'entrée et $5.40 par million de tokens de sortie, avec des tarifs distincts d'écriture et de lecture du cache. Confirmez les chiffres actuels sur la
Performance : Qwen 3.8 Max est plus fort mais plus lent
La comparaison indépendante la plus claire provient d'Artificial Analysis. Sa comparaison directe des modèles indique :
| Mesure indépendante |
Qwen 3.7 Plus |
Qwen 3.8 Max |
| Indice d'intelligence |
39 |
58 |
| Vitesse de sortie |
56.1 tokens/s |
20.7 tokens/s |
| Temps jusqu'au premier token |
2.17 s |
2.51 s |
Max produit de meilleurs résultats sur un large éventail d'évaluations, mais Plus génère des réponses beaucoup plus rapidement. Le temps jusqu'au premier token est relativement proche ; la différence plus importante apparaît après le début de la génération.
Pour un chat ou un assistant IDE, 56 tokens par seconde peuvent sembler beaucoup plus réactifs que 21. Pour une revue hors ligne qui évite une erreur grave, Max peut justifier l'attente. La latence dépend aussi de la charge du fournisseur, de la longueur du prompt et de la localisation, alors testez le point de terminaison de production.
Lequel est meilleur pour le codage ?
Pour le codage, Qwen 3.8 Max est globalement le meilleur modèle. Qwen 3.7 Plus reste le choix pratique pour des travaux plus courts et bien délimités.
Utilisez Plus pour les explications de fonctions, l'échafaudage de tests unitaires, la conversion de données, les clients API répétitifs et les modifications ciblées avec des exigences explicites. Utilisez Max pour tracer des bugs multi-fichiers, planifier des migrations, examiner une logique sensible à la sécurité, résoudre des ambiguïtés ou faire fonctionner un agent sur un dépôt.
L'indice Coding Agent v1.4 d'Artificial Analysis a utilisé la même configuration de test Claude Code pour les deux modèles. Ses résultats publiés montrent une avance substantielle de Max :
| Résultat de l'agent de codage |
Qwen 3.7 Plus |
Qwen 3.8 Max |
| Indice Coding Agent |
38 |
61 |
| DeepSWE |
19% |
52% |
| Terminal-Bench v2.1 |
72% |
84% |
| SWE-Atlas-QnA |
24% |
48% |
| Coût enregistré par tâche |
$6.30 |
$3.23 |
| Temps enregistré par tâche |
10.7 min |
29.9 min |
Plus a le prix par token le plus bas et a terminé plus rapidement, mais Max a enregistré un coût inférieur par tâche terminée dans cette évaluation. Le taux de réussite, la mise en cache, la composition de la sortie et les tentatives peuvent l'emporter sur le prix catalogue. Cela ne prouve pas que Max est toujours moins cher ; cela montre que le prix par token est un mauvais indicateur du coût de réalisation d'un travail logiciel difficile.
Dans un test indépendant de bugs cachés partagé par Paweł Huryn, 11 modèles ont affronté 105 bugs cachés dans deux dépôts et ont été jugés en aveugle. Qwen 3.8 Max en a corrigé 19 en environ 148 minutes pour un coût rapporté proche de 31 $. Il n'était pas le vainqueur global, mais a corrigé un bug de manière unique. Plus n'a pas été testé, donc il s'agit d'une preuve concernant Max, pas d'une comparaison directe.
Max est plus susceptible de justifier son coût lorsqu'un patch échoué crée un autre cycle de revue. Plus est plus efficace lorsque la tâche est déjà décomposée et facile à vérifier.
Lequel est meilleur pour le codage frontend ?
Qwen 3.8 Max est le choix le plus solide pour le codage frontend, en particulier lorsque le prompt inclut des captures d'écran, des contraintes de mise en page ou des critères d'acceptation visuels.
En date du 21 août 2026, le classement frontend préliminaire de WebDev Arena plaçait Qwen 3.8 Max quatrième avec un score de 1675 ± 14. Les classements Arena évoluent à mesure que les votes s'accumulent, il faut donc y voir un instantané daté plutôt qu'un rang permanent.
La comparaison de vision en six tâches de Roboflow a également trouvé une différence significative :
| Résultat de vision |
Qwen 3.7 Plus |
Qwen 3.8 Max |
| Moyenne sur six évaluations |
67.4% |
84.0% |
| OCR |
86.5% |
92.8% |
| Raisonnement visuel, faible effort |
39.7% |
73.5% |
| Temps de réponse moyen |
7.0 s |
18.0 s |
| Coût rapporté par échantillon |
$0.0008 |
$0.0074 |
L'avantage visuel de Max compte lorsqu'un agent compare une page rendue à une référence, lit du texte dans une capture d'écran ou diagnostique des problèmes de mise en page. Plus reste préférable pour la génération de composants simples à partir d'un système de design uniquement textuel.
Les classements visuels dépendent de la vue de vote. Arena a placé Max deuxième dans une vue contrôlée par style le 21 août et sixième sans contrôle de style le 27 août. Son placement exact dépend donc du paramètre d'évaluation.
Lequel est meilleur pour les développeurs qui créent des agents ?
Les deux modèles prennent en charge l'appel de fonctions et la sortie structurée. Tous deux acceptent les images et la vidéo. Qwen 3.7 Plus utilise la réflexion hybride : le raisonnement est activé par défaut, mais les développeurs peuvent le désactiver ou définir un budget de réflexion lorsque cela est pris en charge. Qwen 3.8 Max expose des niveaux reasoning_effort tels que low, medium et xhigh dans l'API Alibaba Cloud, avec xhigh documenté comme valeur par défaut.
Un raisonnement plus long peut consommer plus de tokens et ajouter de la latence. Commencez par le paramètre le plus bas qui réussit votre évaluation, puis augmentez-le pour les requêtes difficiles. Vérifiez la prise en charge du fournisseur, car un paramètre Alibaba Cloud n'est pas automatiquement disponible via chaque point de terminaison compatible.
Max obtient de meilleurs scores dans la comparaison des agents de codage, et sa sortie maximale de 131 072 tokens est le double de la limite de Plus. Plus reste un bon coordinateur pour les appels d'outils fréquents et à faible risque tels que la classification, la vérification de schéma ou la sélection simple d'outils.
La prise en charge par lots nécessite une vérification de région. Les interfaces par lots de Plus peuvent avoir un plafond de contexte inférieur. Le batch de Max est documenté pour Pékin, mais pas pour Singapour ou les déploiements mondiaux.
Quel modèle est plus rentable ?
Qwen 3.7 Plus est plus rentable pour les requêtes prévisibles et faciles. Qwen 3.8 Max peut être plus rentable pour les tâches difficiles s'il réduit les échecs, les tentatives et la revue humaine.
Utilisez trois mesures : le coût par token, où Plus gagne ; le coût par tâche réussie, qui dépend de la difficulté et des tentatives ; et le coût d'une mauvaise réponse, qui peut favoriser Max pour les modifications de code et les actions d'outils à conséquences.
Si Plus nécessite plusieurs tentatives et une revue par un développeur, Max peut être moins cher malgré son tarif plus élevé. Cependant, envoyer chaque requête d'extraction ou de formatage à Max paie pour une qualité que l'application n'utilise peut-être pas.
Construisez un ensemble de test représentatif avec une condition de réussite claire, puis enregistrez la latence, les tokens, les tentatives et le succès final. Comparez le flux de travail terminé, pas seulement la première ligne de facture.
Travail sur contexte long, vidéo et multimodal
Les deux modèles annoncent une fenêtre de contexte de 1 million de tokens. Plus convient à l'extraction à partir de grands ensembles de documents lorsque les réponses sont courtes et bien spécifiées, bien que son tarif international change au-delà de 256K d'entrée. Max est meilleur pour la synthèse inter-documents, les preuves contradictoires et les rapports longs.
Les deux pages officielles listent l'entrée image et vidéo. Max est plus sûr pour l'interprétation visuelle qui guide les actions ; Plus est moins cher pour l'OCR simple ou l'extraction de métadonnées. Testez les limites et formats des médias chez le fournisseur réel.
Une stratégie pratique de routage en production
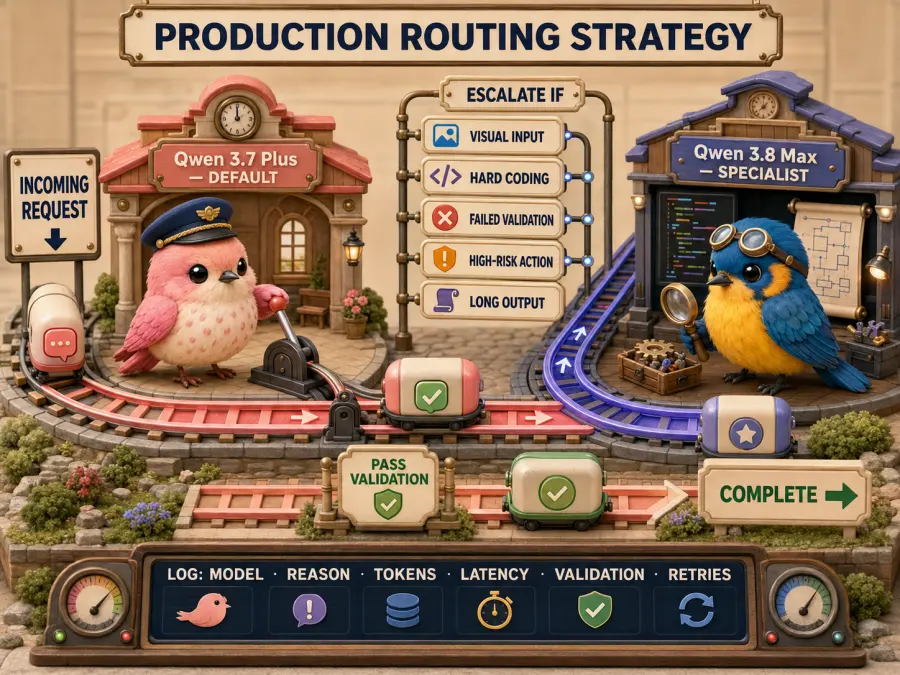
La meilleure décision entre Qwen 3.7 Plus et Qwen 3.8 Max peut être d'utiliser les deux.
Routez vers Qwen 3.7 Plus par défaut lorsque la requête est courte, contrainte, à faible risque ou facile à vérifier. Escaladez vers Qwen 3.8 Max lorsqu'une ou plusieurs de ces conditions s'appliquent :
La requête inclut une capture d'écran, un diagramme ou une vidéo qui doit être interprétée avec précision.
Une tâche de codage s'étend sur plusieurs fichiers ou nécessite le débogage d'une cause racine inconnue.
Une première tentative avec Plus échoue à la validation ou renvoie une faible confiance.
L'agent peut effectuer une action irréversible ou coûteuse.
La tâche nécessite une réponse générée très longue.
La revue humaine coûte plus que la différence de prix du modèle.
Enregistrez le modèle sélectionné, la raison du routage, les tokens, la latence, le résultat de validation et les tentatives. Le trafic réel montrera quelles règles permettent d'économiser.
Comment appeler Qwen 3.8 Max sur GPT Proto
Note éditoriale avant publication : GPT Proto a préparé la page du modèle Qwen 3.8 Max, mais le point de terminaison doit passer un test de fumée en direct avant que cette section ne soit publiée comme API disponible. D'ici là, remplacez le titre par « Qwen 3.8 Max arrive sur GPT Proto », conservez le lien vers la page du modèle et supprimez la commande ci-dessous.
Une fois le modèle actif, la requête compatible OpenAI suivante peut être utilisée comme test de connectivité de base :
curl --request POST "https://gptproto.com/v1/chat/completions" \
  --header "Authorization: Bearer $GPTPROTO_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "qwen3.8-max",
    "messages": [
      {
        "role": "user",
        "content": "Review this implementation plan and identify the highest-risk failure points."
      }
    ]
  }'
Commencez par le texte et confirmez l'ID du modèle, les champs d'utilisation, la latence et les erreurs. Testez séparément les contrôles de raisonnement, les médias, l'inférence par lots et les champs spécifiques au fournisseur.
Consultez la page API de Qwen 3.8 Max pour la disponibilité et la tarification actuelles.
Verdict final : Qwen 3.7 Plus ou Qwen 3.8 Max ?
Choisissez Qwen 3.8 Max si vous voulez le meilleur modèle de cette comparaison. Son avance est plus nette dans les résultats d'intelligence indépendants, les tâches d'agents de codage, l'évaluation frontend, le raisonnement visuel et la longueur maximale de sortie.
Choisissez Qwen 3.7 Plus si votre charge de travail est routinière, à grand volume, sensible à la latence ou facile à valider. Il produit des tokens beaucoup plus rapidement dans la mesure d'Artificial Analysis et a un prix catalogue de départ bien inférieur.
Utilisez Plus par défaut et Max comme voie d'escalade. Si un seul modèle peut être déployé, Max est le choix le plus sûr axé sur la qualité ; Plus est le meilleur choix axé sur le budget.