GLM-5.2 vs Kimi K3 en un coup d'œil
| Catégorie |
GLM-5.2 |
Kimi K3 |
Gagnant pratique |
| Architecture |
MoE de 753 milliards de paramètres, environ 40 milliards actifs par jeton |
MoE de 2,8 billions de paramètres, 16 experts sur 896 activés |
Kimi K3 par son échelle ; la taille seule ne prouve pas la qualité |
| Fenêtre de contexte |
1 million de jetons |
1 million de jetons |
Égalité |
| Sortie maximale |
128 000 jetons |
Jusqu'à 1 million de jetons lorsqu'il est configuré explicitement |
Kimi K3 |
| Entrée |
Texte |
Texte, images et vidéos |
Kimi K3 |
| Contrôle du raisonnement |
Plusieurs modes ; High et Max sur GPT Proto |
Réflexion toujours active avec des niveaux d'effort low, high et max ; max par défaut |
Dépend du point de terminaison et de la tâche |
| Fonctionnalités pour développeurs |
Appel de fonctions, JSON, mise en cache, MCP |
Appel de fonctions, JSON, mise en cache, chargement dynamique d'outils, vision |
Kimi K3 pour les agents multimodaux ; sinon, écart réduit |
| Poids ouverts |
Disponibles dès maintenant sous licence MIT |
Disponibles sous la licence personnalisée Kimi K3 |
GLM pour une licence permissive et une empreinte réduite ; Kimi pour un plafond de capacités plus élevé |
| Tarif officiel de l'API par million de jetons |
$1,40 en entrée, $0,26 en entrée mise en cache, $4,40 en sortie |
$3 en entrée, $0,30 en entrée mise en cache, $15 en sortie |
GLM-5.2 |
| Cas d'utilisation idéal |
Revue de code courante, refactorisation de dépôts, automatisation à grande échelle, auto-hébergement |
Tâches agentiques difficiles, débogage visuel, frontend, développement 3D et développement de jeux |
Dépend de la tâche |
| Empreinte de l'auto-hébergement |
753 milliards au total / environ 40 milliards actifs |
2,8 billions au total / 104 milliards actifs ; environ 1,56 To ; au moins 64 accélérateurs recommandés |
GLM-5.2 pour la plupart des déploiements privés |
Les spécifications proviennent de la documentation et de la fiche du modèle GLM-5.2, ainsi que de la fiche du modèle Kimi K3, de sa licence et de son rapport technique. Les deux modèles publient désormais leurs poids. La différence pratique n'est donc plus ouvert contre fermé ; elle réside dans la licence MIT contre une licence personnalisée, et dans un modèle de 753 milliards de paramètres contre un modèle de 2,8 billions ayant une empreinte de déploiement beaucoup plus importante.
Les benchmarks de codage favorisent Kimi K3, mais lisez les notes
La comparaison publiée par Moonshot donne à Kimi K3 une nette avance sur les benchmarks de codage les plus pertinents pour les agents :
| Benchmark |
Kimi K3 |
GLM-5.2 |
Écart |
| DeepSWE |
67,5 |
46,2 |
+21,3 K3 |
| Terminal-Bench 2.1 |
88,3 |
82,7 |
+5,6 K3 |
| Program Bench |
77,8 |
63,7 |
+14,1 K3 |
| FrontierSWE |
81,2 |
67,3 |
+13,9 K3 |
| SWE-Marathon |
42,0 |
13,0 |
+29,0 K3 |
| Kimi Code Bench 2.0 |
72,9 |
64,2 |
+8,7 K3 |
Ces chiffres sont publiés par le fournisseur, et non par un laboratoire indépendant dans le cadre d'une comparaison contrôlée en face à face. Les notes du benchmark de Moonshot indiquent que les modèles ont parfois fonctionné avec des frameworks d'agents différents, notamment Kimi Code, Claude Code et Codex. Les scores de FrontierSWE ont également été recalculés à partir des résultats bruts. Cela ne rend pas les résultats inutiles, mais signifie qu'un écart de 10 points ne peut pas être attribué au seul modèle de base.
Les données indépendantes vont dans la même direction, avec une conclusion plus limitée et plus crédible. Artificial Analysis attribue à Kimi K3 un score de 57 sur son Intelligence Index, contre 51 pour GLM-5.2 Max. L'organisme estime également le prix combiné à $2,31 par million de jetons pour K3 et à $0,90 pour GLM, selon une répartition de 7:2:1 entre entrée mise en cache, entrée fraîche et sortie.
Mon interprétation : Kimi K3 est le gagnant en matière de capacités. Les données ne sont pas suffisamment fiables pour affirmer qu'il est toujours meilleur, mais elles sont assez cohérentes pour que je donne à K3 la priorité lors d'une tâche de codage exceptionnellement difficile. Le principal argument en faveur de GLM-5.2 est économique, pas académique.
Un véritable test de jeu 3D rend la différence visible
Les scores de codage sont abstraits. Une scène 3D ne l'est pas. Elle révèle si le modèle sait coordonner la disposition, le comportement de la caméra, l'éclairage, l'interaction, l'état et les itérations visuelles, plutôt que de simplement produire des fichiers syntaxiquement valides.
Une comparaison sur X a fourni le même prompt de monde en 3D à Kimi K3, GLM-5.2 et Claude Opus 4.8, puis présenté les résultats pour une évaluation à l'aveugle. Il s'agit d'une démonstration qualitative, et non d'un benchmark : un prompt, une seule exécution et une configuration d'agent susceptible d'influencer le résultat. Son intérêt est de permettre au lecteur d'inspecter les mondes réels plutôt que de faire confiance à un score.
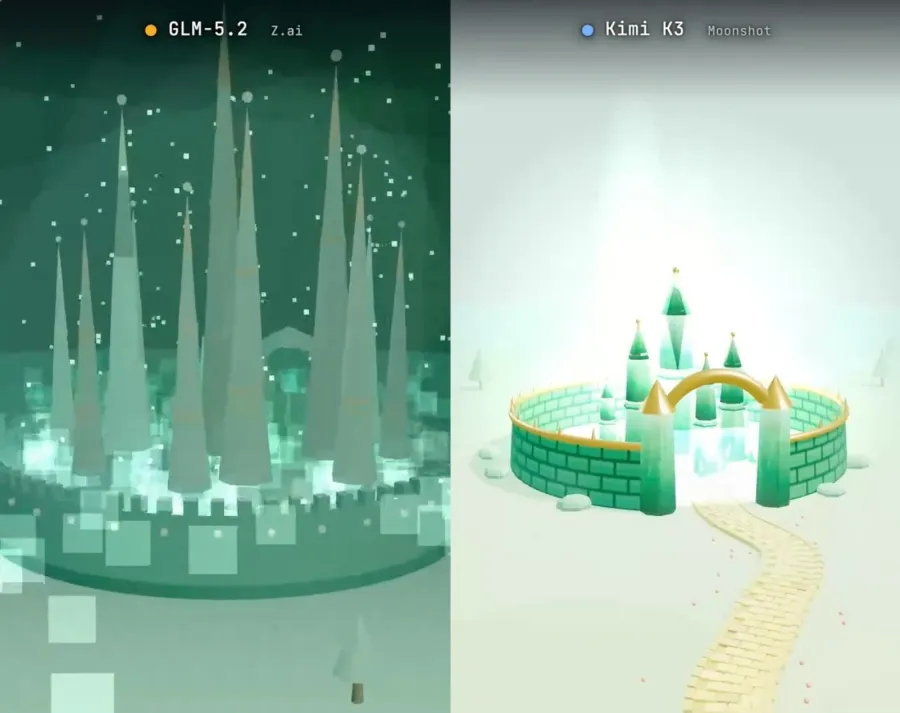
K3 dispose d'un avantage structurel pour ce type de travail. Il accepte nativement les images et les vidéos : un agent peut donc effectuer le rendu de la scène, renvoyer la capture d'écran au modèle et lui demander de corriger les problèmes de chevauchement, d'espacement, de contraste ou de cadrage de la caméra. Moonshot appelle cela un flux de travail avec vision intégrée dans sa boucle, dans son blog technique consacré à K3. GLM-5.2 fonctionne uniquement avec du texte. Un outil de navigateur externe peut décrire les captures d'écran ou fournir des journaux, mais cela ajoute un composant supplémentaire et un autre point où des informations peuvent être perdues.
Il ne faut toutefois pas écarter GLM en tant que modèle de codage de jeux. Dans un cas présenté par la communauté sur Reddit, un développeur est parti d'un dossier vide et a demandé à GLM-5.2, exécuté via le mode plan de Claude Code, de créer un jeu de type Animal Crossing en HTML, JavaScript et Three.js. Le résultat comptait environ 2 800 lignes et reliait les déplacements, les dialogues des PNJ, la pêche, une économie, une boutique, un musée, des logements, des meubles et LocalStorage. L'exécution rapportée a utilisé environ 11,7 millions de jetons d'entrée et 138 000 jetons de sortie, avec 29 minutes et 43 secondes de temps d'API et 1 heure et 21 minutes de temps écoulé.
L'auteur a également signalé des bogues et des problèmes d'équilibrage. Tant mieux. Cette imperfection rend l'exemple plus utile qu'une démonstration promotionnelle parfaitement soignée. Il montre que GLM-5.2 peut assembler un prototype cohérent ; il ne montre pas que le code est prêt pour la production ni qu'il surpasse K3.
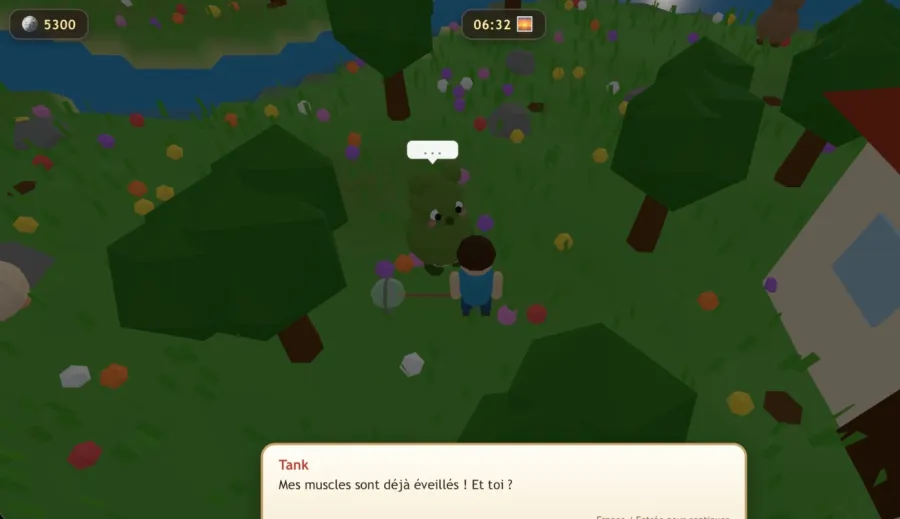
Pour le code de jeu, la 3D interactive ou le travail frontend guidé par des captures d'écran, je choisirais Kimi K3. Pour une boucle de jeu spécifiée par du texte, lorsque le coût compte davantage que les itérations visuelles, GLM-5.2 reste un choix crédible.
Quel modèle est le meilleur pour la revue de code et la correction de bogues ?
Les tests A/B publics directs de GLM-5.2 contre Kimi K3 pour la revue de code restent peu nombreux. Il est important de le dire clairement. Les tableaux de benchmarks évaluent la résolution de problèmes et l'exécution par les agents, mais ils ne nous indiquent pas si l'un ou l'autre modèle détectera le bogue d'autorisation dans votre pull request sans inonder la revue de commentaires stylistiques.
Pour la correction de bogues difficiles, K3 dispose de données plus convaincantes. Son avance sur DeepSWE, Program Bench et SWE-Marathon suggère de meilleures performances lorsqu'un modèle doit inspecter une base de code, établir un plan, modifier des fichiers, exécuter des outils et récupérer après des tentatives échouées. La vision native compte également lorsque le problème est visible dans un navigateur, un écran mobile, un graphique ou une vue CAO.
Pour les revues quotidiennes, je commencerais par GLM-5.2. Z.ai le recommande explicitement pour les audits de projets, la refactorisation sur un horizon long, les migrations d'API et les travaux soumis à des règles de lint, de compilation, de test et de dépendances. Son guide officiel encourage les développeurs à définir des limites telles que “ne pas introduire de dépendances” et “ne pas modifier les contrats d'API”, puis à exiger la vérification de la compilation, du lint et des tests. Cela ressemble à un véritable flux de revue.
Le coût renforce cet argument. La plupart des pull requests ne sont pas des problèmes de type SWE-Marathon. Il est difficile de justifier le supplément tarifaire de K3 pour renommer une méthode, ajouter des tests ou examiner une modification CRUD courante. Confiez les revues ordinaires à GLM et ne faites remonter à K3 que les échecs ambigus, les défauts visuels ou les problèmes persistants impliquant plusieurs fichiers.
Tarification de l'API : Kimi K3 vaut-il davantage que GLM-5.2 ?
Aux tarifs officiels, GLM-5.2 coûte $1,40 par million de jetons d'entrée fraîche, $0,26 pour l'entrée mise en cache et $4,40 pour la sortie. Kimi K3 coûte respectivement $3, $0,30 et $15. L'entrée fraîche de Kimi coûte environ 2,1 fois plus cher, tandis que sa sortie coûte environ 3,4 fois plus cher.
Prenons l'exemple d'une tâche de codage globale qui consomme 1 million de jetons d'entrée fraîche et 100 000 jetons de sortie au cours de sa boucle agentique :
| Charge de travail |
GLM-5.2 |
Kimi K3 |
| 1 million d'entrée fraîche + 100 000 de sortie |
$1,84 |
$4,50 |
| 1 million d'entrée mise en cache + 100 000 de sortie |
$0,70 |
$1,80 |
Ces estimations excluent les nouvelles tentatives, les frais d'outils externes et les taxes. Elles supposent également que le fournisseur reconnaît le préfixe répété comme pouvant être mis en cache. Moonshot indique des taux d'accès au cache supérieurs à 90 % dans les charges de travail de codage, mais votre résultat dépend de prompts stables et de la conservation de l'historique des conversations.
K3 vaut-il la différence ? Pour une tâche difficile où un échec coûte deux heures à un ingénieur, oui. Pour la revue de code continue ou la maintenance de dépôts en masse, généralement non. Un avantage indépendant de 6 points en matière d'intelligence ne justifie pas automatiquement un prix combiné des jetons 2,6 fois supérieur.
Fonctionnalités d'API que les développeurs remarqueront vraiment
Les deux modèles offrent une fenêtre de contexte d'un million de jetons, l'appel de fonctions, le streaming, les sorties structurées et la mise en cache du contexte. Tous deux peuvent être utilisés derrière un client compatible OpenAI. Les différences apparaissent dans l'exploitation.
Kimi K3 accepte le texte, les images et les vidéos via son service hébergé, prend en charge le chargement dynamique d'outils et peut renvoyer des sorties très longues. Il réfléchit toujours, mais la fiche actuelle du modèle documente désormais les niveaux d'effort de raisonnement `low`, `high` et `max`, avec `max` par défaut. Les agents doivent néanmoins conserver le message complet de l'assistant, y compris l'historique de réflexion, entre les tours ; remplacer un autre modèle par K3 au milieu d'une session peut déstabiliser la sortie.
K3 peut également se montrer trop proactif. Moonshot recommande des instructions système plus strictes ou un fichier AGENTS.md lorsque le modèle ne doit pas prendre de décisions en dehors d'une limite définie. Cet avertissement compte en production. Un modèle qui corrige des problèmes connexes sans autorisation peut sembler consciencieux dans une démonstration et devenir un risque dans un dépôt réglementé.
GLM-5.2 est plus simple à budgétiser. Les développeurs peuvent sélectionner des modes de raisonnement au lieu de payer une réflexion maximale à chaque requête. Il prend en charge MCP et est déjà distribué sous licence MIT : les équipes peuvent donc inspecter, ajuster ou auto-héberger les poids dès aujourd'hui. Le compromis concerne la multimodalité : le modèle de base accepte uniquement le texte. Si votre boucle de codage dépend de captures d'écran, vous aurez besoin d'un autre composant de vision ou devrez choisir K3.
Déploiement de poids ouverts : MIT contre la licence Kimi K3
Les deux modèles peuvent désormais être téléchargés, mais ils n'offrent pas les mêmes conditions de déploiement.
GLM-5.2 utilise la licence MIT. Kimi K3 utilise une licence personnalisée qui autorise largement l'utilisation, la modification, l'ajustement, le déploiement et la redistribution, mais ajoute des conditions pour les grandes entreprises Model-as-a-Service et les très grands produits commerciaux. Une start-up qui crée un assistant de codage interne et une plateforme d'inférence à chiffre d'affaires élevé ne sont pas soumises à la même analyse de la licence K3.
L'écart matériel est tout aussi important. GLM-5.2 possède 753 milliards de paramètres au total, dont environ 40 milliards actifs par jeton. Kimi K3 possède 2,8 billions de paramètres au total, dont 104 milliards actifs, et un dépôt officiel d'environ 1,56 To. Moonshot recommande au moins 64 accélérateurs. K3 offre un plafond de capacités plus élevé ; GLM constitue un projet d'auto-hébergement plus pratique pour la plupart des équipes.
Cela modifie le verdict, mais pas la stratégie de routage. Utilisez GLM pour les charges de travail de codage courantes, sensibles au coût ou privées. Faites remonter les tâches à K3 lorsque le raisonnement visuel ou la difficulté de la tâche justifie une facture d'API ou une empreinte d'infrastructure plus lourde.
Comparaison des API de codage GLM-5.2 vs Kimi K3 sur GPT Proto
GPT Proto expose les deux modèles via un point de terminaison compatible OpenAI. Vous pouvez ouvrir la page du modèle GLM-5.2, la page du modèle Kimi K3, ou parcourir le catalogue complet des modèles. L'avantage pratique n'est pas un nouvel agent de codage, mais la possibilité d'envoyer la même requête aux deux modèles avec une seule clé et de comparer les sorties avant de définir vos règles de routage.
Installez le SDK Python OpenAI actuel, exportez votre clé et exécutez ce script :
python3 -m pip install --upgrade "openai>=1.0"
export GPTPROTO_API_KEY="your-key-here"
import os
from pathlib import Path

from openai import OpenAI


client = OpenAI(
    api_key=os.environ["GPTPROTO_API_KEY"],
    base_url="https://api.gptproto.com/v1",
)

task = """Review this Python function for correctness and security.
Return: (1) confirmed bugs, (2) a corrected implementation, and
(3) three pytest tests. Do not report style-only issues.

from pathlib import Path

def read_user_file(root: str, filename: str) -> str:
    path = Path(root) / filename
    return path.read_text(encoding="utf-8")
"""

models = ["glm-5.2", "kimi-k3.0"]

for model in models:
    response = client.chat.completions.create(
        model=model,
        messages=[
            {
                "role": "system",
                "content": (
                    "You are a senior application-security reviewer. "
                    "State uncertainty and avoid speculative findings."
                ),
            },
            {"role": "user", "content": task},
        ],
    )
    output = response.choices[0].message.content or ""
    Path(f"review-{model}.md").write_text(output, encoding="utf-8")
    print(f"Saved review-{model}.md")
L'exemple peut être exécuté tel quel après avoir défini GPTPROTO_API_KEY. Il demande aux deux modèles de détecter le risque de traversée de chemin et de produire des tests, puis enregistre des revues Markdown distinctes. Si un identifiant de modèle change pendant le déploiement, copiez l'identifiant actuel affiché sur sa page de modèle GPT Proto.
En production, ne choisissez pas un gagnant à partir d'un seul prompt. Constituez un ensemble de 20 à 50 tâches issues de vos propres dépôts, masquez les secrets et évaluez les problèmes confirmés, les faux positifs, le taux de réussite des tests, le nombre total de jetons et le temps écoulé. La page d'accueil de GPT Proto est le point de départ pour créer la clé API partagée.
Lequel choisir ?
Choisissez Kimi K3 si votre tâche combine le codage avec des captures d'écran ou des vidéos, si vous créez une expérience frontend ou 3D, ou si un échec complexe en plusieurs étapes coûte plus cher que les jetons supplémentaires. Ne choisissez ses poids que si votre équipe peut prendre en charge l'infrastructure et a examiné la licence Kimi K3.
Choisissez GLM-5.2 pour la revue de code courante, les audits de dépôts, la refactorisation, les migrations et l'automatisation du codage à grande échelle. Il reste le meilleur choix par défaut pour l'auto-hébergement lorsque la licence MIT, une empreinte réduite et un coût prévisible comptent davantage que le plafond de capacités supérieur de K3.
Pour une charge de travail mixte, effectuez un routage plutôt que de prêter allégeance : GLM-5.2 en premier, Kimi K3 en cas d'escalade. La publication des poids de K3 offre davantage de contrôle sur le déploiement ; elle n'efface pas l'avantage économique et opérationnel de GLM.