Por qué «parece triste» suele producir una expresión de IA plana
Una palabra emocional describe un estado. El video necesita cambios.
Si un prompt comienza y termina con «muy triste», Seedance 2.5 no tiene una razón clara para modificar las cejas, los párpados, la boca, la respiración o la postura de un segundo a otro. El resultado puede ser atractivo, pero el rostro suele quedarse fijo en una sola expresión.
Tres errores de prompt causan la mayoría de los videos emocionales planos:
El prompt nombra la emoción, pero no sus efectos físicos visibles.
El personaje alcanza la máxima intensidad en el primer segundo y no queda progresión emocional.
Caminar, dialogar, mover las manos, mover la cámara y los eventos del fondo compiten con el rostro por la atención.
Sustituye las instrucciones abstractas por comportamientos observables:
| Indicación débil |
Indicación visible mejorada |
| Parece muy triste. |
Sus cejas internas se elevan, sus párpados inferiores se tensan y mantiene los labios apretados. |
| Se vuelve tímido. |
Baja la mirada, encoge los hombros y aprieta los dedos alrededor del cuaderno. |
| Empieza a llorar. |
La humedad aparece primero; una lágrima cae solo después de que no logra mantener la compostura. |
| Está nervioso. |
Traga saliva, respira superficialmente y evita brevemente el contacto visual. |
| Está enfadada. |
Su mandíbula se tensa antes de endurecer la mirada, mientras una fosa nasal se dilata con una respiración controlada. |
La conclusión es sencilla: describe lo que una cámara puede ver, no lo que solo el personaje puede sentir.
La fórmula de actuación emocional para Seedance 2.5
Un prompt fiable para crear videos realmente expresivos tiene siete partes:
Detonante emocional

+ intento de suprimir la reacción

+ filtración facial involuntaria

+ respuesta respiratoria y corporal

+ escalada cronometrada

+ recuperación contenida

+ restricciones de cámara y continuidad
La resistencia es la parte que más prompts omiten. Un personaje que llora, se sonroja o grita de inmediato muestra una emoción. Un personaje que intenta impedir la reacción y fracasa la interpreta.
Por ejemplo, no escribas solo «su rostro se enrojece cuando descubren que le gusta alguien». Dale una intención contradictoria: quiere parecer tranquilo. Esa resistencia crea evasión del contacto visual, un rubor tardío, un intento fallido de hablar, dedos tensos y una sonrisa contenida. Esas pequeñas reacciones hacen creíble la emoción mayor.
No acumules todas las señales posibles en cada etapa. Elige dos o tres acciones faciales, una respuesta respiratoria y una pequeña acción corporal para cada momento emocional. Más instrucciones pueden generar más conflictos, no más realismo.
Convierte las emociones en acciones faciales visibles
Usa esta tabla como biblioteca de indicaciones. Elige las señales que encajen con el plano en lugar de copiar una fila completa.
| Emoción |
Ojos y cejas |
Boca y mandíbula |
Respiración y cuerpo |
| Contener las lágrimas |
Párpados inferiores brillantes; las cejas internas se elevan y se juntan gradualmente |
Aprieta los labios; tiembla el labio inferior; se tensa la barbilla |
Traga una vez; respiración irregular; ligero temblor de hombros |
| Vergüenza |
Baja la mirada; breve vistazo hacia arriba entre las pestañas |
Separa los labios sin hablar; muerde suavemente el labio inferior; sonrisa contenida |
Los hombros se encogen; los dedos se tensan; la respiración se entrecorta |
| Ira contenida |
Mirada fija; las cejas descienden de forma desigual |
Aprieta la mandíbula; aplana los labios |
Respiración nasal controlada; hombros rígidos; las manos permanecen quietas |
| Miedo |
Los ojos se abren antes de explorar el entorno; los párpados superiores permanecen tensos |
Separa los labios; la mandíbula se bloquea brevemente |
La respiración se corta; el pecho permanece tenso; el cuerpo se inclina ligeramente hacia atrás |
| Risa contenida |
Los párpados se entrecierran; la mirada se desvía brevemente |
Primero se eleva una comisura de la boca; los labios vuelven a comprimirse |
El aire escapa por la nariz; los hombros dan un pequeño espasmo |
| Alivio |
Se libera la tensión de las cejas; los ojos se suavizan y vuelven a enfocarse |
Separa los labios antes de una pequeña exhalación; la mandíbula se relaja |
Bajan los hombros; la respiración se alarga; la postura se abre |
Palabras como contenido, vacilante, involuntario, gradual y casi imperceptible ayudan a controlar la intensidad. No sustituyen la acción física. «Una expresión emocional sutil» sigue siendo vaga; «le tiembla la barbilla casi imperceptiblemente mientras mantiene la mirada baja» se puede dirigir.
Ejemplo 1: Contener las lágrimas — Prompt de imagen a video
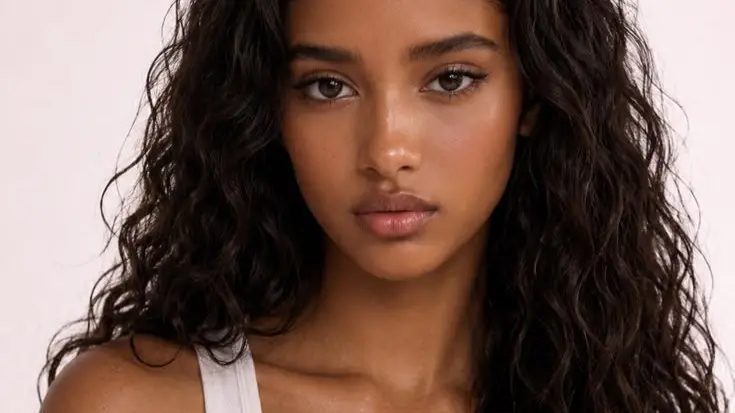
Este ejemplo comienza con la imagen de un personaje conocido y anima una progresión emocional de 15 segundos. La imagen de referencia debe definir el rostro, la edad, el peinado, la ropa, los accesorios y la composición iniciales. El prompt debe dedicar la mayoría de sus palabras a la actuación y la continuidad, no a rediseñar a la persona.
[image]
[video]
Línea temporal emocional
| Tiempo |
Momento emocional |
Señales visibles |
| 0–3 s |
Mantener la compostura |
Labios apretados, barbilla tensa, ojos brillantes, un trago |
| 3–5 s |
El control comienza a fallar |
Las cejas internas se elevan, tiembla el labio inferior y se acumula humedad |
| 5–10 s |
Desmoronamiento contenido |
Cierra los ojos, las lágrimas caen de forma irregular y la respiración se vuelve temblorosa |
| 10–12 s |
Recuperación física |
Baja la cabeza, respira temblorosamente y se seca las lágrimas con la manga |
| 12–15 s |
Consecuencias emocionales |
Vuelve a abrir los ojos húmedos, aparta la mirada y la tristeza permanece |
Prompt de imagen a video para copiar y pegar
@Image 1 define la identidad exacta del personaje, la estructura facial, el peinado, la ropa, los accesorios, la edad y el aspecto general. Conserva a la misma persona durante todo el video. No rediseñes, embellezcas, envejezcas ni sustituyas al personaje.

Crea un primer plano cinematográfico continuo de 15 segundos basado en @Image 1. El personaje está frente a alguien emocionalmente importante, justo fuera de cámara, e intenta desesperadamente no llorar.

[0–3 s — intenta mantener la compostura]
Al principio, el personaje mantiene una expresión controlada. Sus labios se aprietan, la mandíbula se tensa ligeramente y los músculos de la barbilla se contraen. Traga una vez y toma una respiración pequeña e inestable. Sus ojos se vuelven gradualmente brillantes, pero todavía no caen lágrimas.

[3–5 s — la compostura empieza a fallar]
Las cejas internas se elevan y se juntan sutilmente. Los párpados inferiores se tensan, la nariz se enrojece ligeramente y el labio inferior comienza a temblar involuntariamente. Una comisura de la boca se curva un poco hacia abajo antes que la otra. La humedad se acumula lentamente a lo largo de los párpados inferiores.

[5–10 s — desmoronamiento emocional contenido]
El personaje intenta una vez más suprimir la emoción, pero fracasa. Cierra los ojos con fuerza, el entrecejo se contrae de forma natural y las lágrimas empiezan a rodar por las mejillas a velocidades ligeramente distintas. La boca tiembla en un sollozo silencioso y contenido. Pequeños temblores involuntarios recorren la barbilla, la garganta y los hombros mientras la respiración se vuelve irregular.

[10–12 s — recupera el aliento]
El personaje baja la cabeza, respira temblorosamente por los labios entreabiertos y se seca suavemente las lágrimas con la manga o con la tela suave de su ropa. El gesto debe parecer espontáneo, vacilante e imperfecto.

[12–15 s — recuperación frágil]
Levanta lentamente la cabeza e intenta recuperar el control. Aprieta los labios, traga y aparta de la cámara sus ojos húmedos y enrojecidos. El llanto comienza a disminuir, pero la tristeza sigue siendo visible en su respiración, su mirada y la tensión facial.

Mantén la composición original y el estilo visual de @Image 1. Usa un primer plano cerrado a la altura de los ojos, movimiento realista de la piel, parpadeo natural, lágrimas físicamente precisas, respiración sutil y microexpresiones contenidas. Mantén estable el fondo, con solo un ligero movimiento ambiental natural.

Sin cortes, sin cambios de identidad, sin rediseño facial, sin cambios de peinado o ropa, sin llanto exagerado repentino, sin actuación melodramática, sin lágrimas artificiales simétricas, sin movimientos rápidos de cabeza, sin rasgos faciales deformados, sin piel con filtro de belleza y sin personas adicionales entrando en el encuadre.
La imagen inicial importa. Un retrato completamente alegre obliga al modelo a recorrer demasiada distancia antes del primer momento emocional. Un rostro ya cubierto de lágrimas elimina la preparación. El mejor fotograma inicial se sitúa entre ambos extremos: párpados inferiores brillantes, labios apretados y ligera tensión en la barbilla, pero sin que haya caído ninguna lágrima.
Si la imagen de origen es un retrato de medio cuerpo o cuerpo entero, conserva ese encuadre y solicita un acercamiento lento hacia un primer plano. No combines el acercamiento con caminar, girarse y hacer grandes gestos con las manos. El rostro es la escena.
Ejemplo 2: Un chico tímido cuyo amor secreto es descubierto
Este ejemplo de texto a video usa una emoción diferente, pero la misma estructura:
Descubrimiento → Bloqueo → Evitar el contacto visual → El rubor se extiende
→ Mirada accidental → Mordisco suave del labio → Consecuencias tímidas
El detalle importante es la demora. El rubor debe comenzar alrededor de las orejas y extenderse gradualmente por las mejillas y la nariz. Una piel roja brillante instantánea parece un filtro. Los ojos húmedos deben sugerir vulnerabilidad sin convertir la escena en llanto.
Prompt de texto a video para copiar y pegar
Crea un primer plano cinematográfico continuo de 12 segundos de un joven tímido de 18 años cuyo amor secreto acaba de ser descubierto por alguien que está fuera de cámara.

Tiene un aspecto amable y juvenil, cabello oscuro, suave y ligeramente despeinado, piel natural y clara, y ropa informal sencilla. Está de pie en un pasillo escolar tranquilo junto a una ventana, con una suave luz de última hora de la tarde. Una nota de amor manuscrita y doblada sobresale parcialmente entre las páginas del cuaderno que sostiene contra el pecho.

[0–2 s — realización repentina]
Alguien fuera de cámara nota la nota de amor oculta y lo mira con complicidad. El joven se queda inmóvil durante un instante. Sus ojos se abren ligeramente y la respiración se le corta al comprender que han descubierto su secreto.

[2–5 s — evasión avergonzada]
Baja inmediatamente la mirada hacia el suelo, incapaz de mantener el contacto visual. Sus hombros se encogen ligeramente y sus dedos aprietan el cuaderno. Separa los labios como si quisiera explicarse, pero no logra pronunciar palabra.

[5–8 s — el rubor se extiende]
Un rubor natural comienza en las puntas de las orejas y se extiende gradualmente por las mejillas y el puente de la nariz. El color se intensifica visiblemente, pero sigue siendo realista y no caricaturesco. Sus párpados inferiores se tensan un poco y sus ojos se vuelven brillantes, con leves lágrimas de intensa vergüenza y vulnerabilidad, sin llegar a llorar.

[8–10 s — intenta ocultar sus sentimientos]
Mira brevemente hacia arriba entre las pestañas, se encuentra accidentalmente con la mirada de la otra persona y vuelve a bajar los ojos de inmediato. Se lleva suavemente el labio inferior entre los dientes, intentando contener una sonrisa nerviosa e involuntaria. La barbilla le tiembla casi imperceptiblemente.

[10–12 s — consecuencias emocionales tímidas]
Abraza el cuaderno con más fuerza contra el pecho, gira ligeramente el rostro y libera el labio inferior. Sus mejillas permanecen profundamente sonrojadas. Mantiene los ojos bajos y húmedos, mientras las comisuras de la boca conservan una sonrisa avergonzada y contenida, apenas perceptible, que revela que sus sentimientos son genuinos.

Actuación naturalista de imagen real, atmósfera íntima de transición a la adultez, textura realista de la piel, movimiento facial sutil, respiración visible, parpadeo natural, poca profundidad de campo, luz suave de ventana y desenfoque delicado del fondo. Primer plano estático a la altura de los ojos con un acercamiento extremadamente lento. Enfócate principalmente en el cambio emocional gradual de sus ojos, labios, mejillas y respiración.

Sin diálogo, sin reacción exagerada de anime, sin rostro rojo brillante instantáneo, sin marcas de rubor caricaturescas, sin lágrimas recorriendo las mejillas, sin llanto histérico, sin sonrisa amplia, sin expresión seductora, sin mordisco exagerado del labio, sin distorsión facial, sin cambios de identidad y sin cortes de cámara.
Dos frases evitan errores habituales aquí. Brillantes, con lágrimas leves ... sin llegar a llorar separa la humedad emocional de una escena de llanto. Se lleva suavemente el labio inferior entre los dientes mantiene la acción lo bastante pequeña para evitar la distorsión de la boca.
Prompts emocionales de texto a video frente a imagen a video
La línea temporal emocional se puede reutilizar en ambos modos, pero el prompt no debe asumir la misma carga de trabajo.
| Componente del prompt |
Texto a video |
Imagen a video o flujo de trabajo con referencia |
| Identidad del personaje |
Describe la edad, el aspecto, el cabello, la ropa y el papel |
Deja que la imagen subida defina la identidad |
| Escenario |
Describe el lugar, la hora y la iluminación |
Conserva la fuente o añade solo el contexto necesario |
| Enfoque principal del prompt |
Personaje, escena y actuación |
Actuación, ritmo y continuidad de identidad |
| Riesgo principal |
Cambios de personaje o identidad genéricos |
Desviación facial, distorsión de la boca o rediseño de la imagen de origen |
| Mejor uso |
Crear una escena completa desde cero |
Animar un personaje establecido |
El flujo de trabajo completo de Seedance 2.5 de ByteDance admite referencias multimodales amplias, incluidas hasta 30 imágenes, 10 videos y 10 clips de audio, según los detalles oficiales del lanzamiento. Esa capacidad del proveedor es más amplia que la de todas las rutas de terceros.
En el momento de redactar este artículo, la página principal de la API de Seedance 2.5 en GPT Proto expone públicamente texto a video con controles de prompt, relación de aspecto, duración, resolución, audio, cámara y semilla. Usa el prompt de imagen a video anterior únicamente en una interfaz que ofrezca realmente una entrada de imagen o referencia. No pegues @Image 1 en un endpoint que solo acepte texto esperando que entienda una imagen que nunca se subió.
Cómo lograr que un video emocional parezca cinematográfico y no teatral
Mantén la cámara cerca. Un primer plano a la altura de los ojos o un plano medio corto proporciona suficientes píxeles para que los cambios faciales sigan siendo visibles. Un plano general puede funcionar para el lenguaje corporal, pero no es la opción predeterminada adecuada cuando los ojos y el labio inferior sostienen la escena.
Usa un único movimiento de cámara contenido. Un acercamiento muy lento o una ligera deriva de cámara en mano añade presencia sin competir con la actuación. Las órbitas, los zooms y los movimientos rápidos de cabeza dificultan la estabilidad facial.
Introduce asimetría en la reacción. Una comisura puede caer antes que la otra. Una lágrima puede salir primero de un ojo. El personaje puede mirar hacia arriba y bajar la mirada inmediatamente después. Los cambios faciales perfectamente sincronizados suelen parecer sintéticos.
Dirige la respiración. Contener el aliento, tragar una vez, inhalar con temblor o bajar los hombros después de exhalar conecta el rostro con el cuerpo. Es especialmente útil cuando el cambio emocional debe mantenerse sutil.
Deja consecuencias. No termines en el punto máximo de la emoción. Dedica los dos o tres segundos finales a la recuperación: el personaje suelta el labio, parpadea con los ojos húmedos, aparta la mirada o intenta estabilizar la respiración. La emoción residual suele convencer más que la expresión más intensa.
Por qué tus expresiones faciales de Seedance 2.5 siguen viéndose mal
| Problema |
Causa probable |
Ajuste del prompt |
| El rostro permanece plano |
Solo se usaron palabras emocionales abstractas |
Añade cambios visibles en los ojos, las cejas, la boca, la mandíbula y la respiración |
| El personaje llora de inmediato |
El prompt no tiene preparación |
Reserva la primera etapa para la resistencia y la humedad tardía |
| La actuación parece melodramática |
Demasiadas señales intensas ocurren a la vez |
Usa contenido, vacilante y menos acciones por etapa |
| Las lágrimas parecen artificiales |
Aparecen simétricamente o en exceso |
Retrasa la primera lágrima y varía el momento entre ambos ojos |
| La boca se deforma al morder el labio |
La indicación física es demasiado intensa |
Sustituye «muerde con fuerza» por «se lleva suavemente el labio inferior entre los dientes» |
| El personaje subido cambia |
El prompt vuelve a describir o rediseña a la persona |
Indica que la referencia define la identidad y el aspecto |
| Desaparecen los detalles faciales |
El movimiento amplio o una cámara muy activa compiten por la atención |
Usa un primer plano y un único movimiento lento de cámara |
| La emoción desaparece después de un segundo |
El prompt define un punto máximo, pero no un estado final |
Añade un intento de recuperación y una mirada o respiración residual |
Cuando una generación falla, cambia una variable cada vez. Si fallan las lágrimas, revisa solo su momento. Si la actuación es demasiado intensa, reduce el número de señales simultáneas. Si la identidad cambia, simplifica el movimiento y refuerza la instrucción de conservar la referencia. Reescribir todo el prompt después de cada intento dificulta saber qué cambio funcionó.
Plantilla reutilizable de prompt de expresiones emocionales para Seedance 2.5
[Instrucciones de referencia e identidad, si hay una entrada de referencia disponible]

Crea un único [primer plano / plano medio corto] cinematográfico continuo de [duración] segundos.

El personaje acaba de [detonante emocional], pero intenta [resistencia].

[0–X s — reacción inicial]
[Describe dos o tres reacciones visibles de los ojos, las cejas, la boca, la respiración o las manos.]

[X–X s — la emoción se filtra]
[Describe microexpresiones involuntarias, comportamiento de la mirada y cambio físico gradual.]

[X–X s — punto máximo emocional]
[Describe una liberación controlada sin actuación exagerada.]

[X–X s — consecuencias]
[Describe el intento de recuperación, la respiración residual y la mirada final.]

Cámara:
[Elige el encuadre y un único movimiento de cámara contenido.]

Continuidad:
[Indica qué detalles de identidad, ropa, fondo, iluminación y composición deben permanecer sin cambios.]

Evitar:
[Cambio emocional instantáneo, actuación exagerada, distorsión facial, cambio de identidad, movimiento rápido de cabeza, reacciones artificiales simétricas y acción de fondo no relacionada.]
Para una actuación de plano único de 10–15 segundos, normalmente bastan cuatro etapas cronometradas. Para una narración más larga de 30 segundos, usa el tiempo adicional para un detonante externo o un segundo momento narrativo, en lugar de estirar la misma reacción facial durante todo el clip. Seedance 2.5 admite oficialmente hasta 30 segundos por generación y dirección basada en marcas de tiempo, pero ByteDance también señala limitaciones actuales en movimientos físicos complejos y escenas con varios sujetos interactuando. Mantén la escena acotada cuando la prioridad sea la actuación facial. Consulta la descripción oficial del modelo Seedance 2.5 para conocer el resumen actualizado de las capacidades del proveedor.
Cómo generar un video emocional con Seedance 2.5 en GPT Proto
Abre la página del modelo Seedance 2.5 y elige la tarea de texto a video.
Pega el prompt emocional completo. Configura la relación de aspecto, la duración, la resolución, la preferencia de audio, el comportamiento de la cámara y la semilla que muestran los controles en vivo.
Genera la primera versión y evalúa solo cuatro aspectos: el ritmo emocional, la estabilidad del rostro, el realismo físico y si los dos segundos finales conservan las consecuencias emocionales.
Revisa la etapa más débil en lugar de sustituir todo el prompt.
Los desarrolladores pueden enviar el mismo prompt de texto a video mediante la ruta del modelo. El endpoint siguiente está confirmado por la ruta activa del modelo; utiliza el panel de parámetros actual como fuente de verdad si cambian los valores disponibles.
curl --location 'https://gptproto.com/api/v3/bytedance/dreamina-seedance-2-5-260628/text-to-video' \
  --header 'Authorization: GPTPROTO_API_KEY' \
  --header 'Content-Type: application/json' \
  --data '{
    "prompt": "Create a single continuous 12-second cinematic close-up of a shy young man whose secret crush has just been discovered. He freezes, lowers his gaze, gradually blushes, gently catches his lower lip, and ends with moist eyes and a restrained embarrassed smile. Natural skin texture, subtle breathing, no dialogue, no cartoon blush, no tears falling, no camera cuts.",
    "aspect_ratio": "16:9",
    "duration": 12,
    "resolution": "720p",
    "generate_audio": false,
    "camera_fixed": false,
    "seed": -1
  }'
Si quieres comparar otros modelos de video con la misma línea temporal emocional, mantén constantes el prompt, la duración, el encuadre y la política de semillas; después, explora la colección de modelos de video de IA. Una comparación justa pregunta qué modelo conserva el arco emocional, no cuál produjo el fotograma inicial más bonito.