Claude 與 ChatGPT 在 2026 年的程式開發比較:哪個更適合除錯、前端、Python 與大型程式碼庫?
Claude 還是 ChatGPT 更擅長寫程式? Claude 通常更適合互動式開發、前端迭代,以及跨整個儲存庫的推理。搭配 Codex 的 ChatGPT 通常在終端機密集任務與長時間自主作業方面更強。對於例行生成、Python 腳本與獨立除錯而言,所選模型、提供的上下文,以及執行程式碼的能力,比品牌本身更重要。 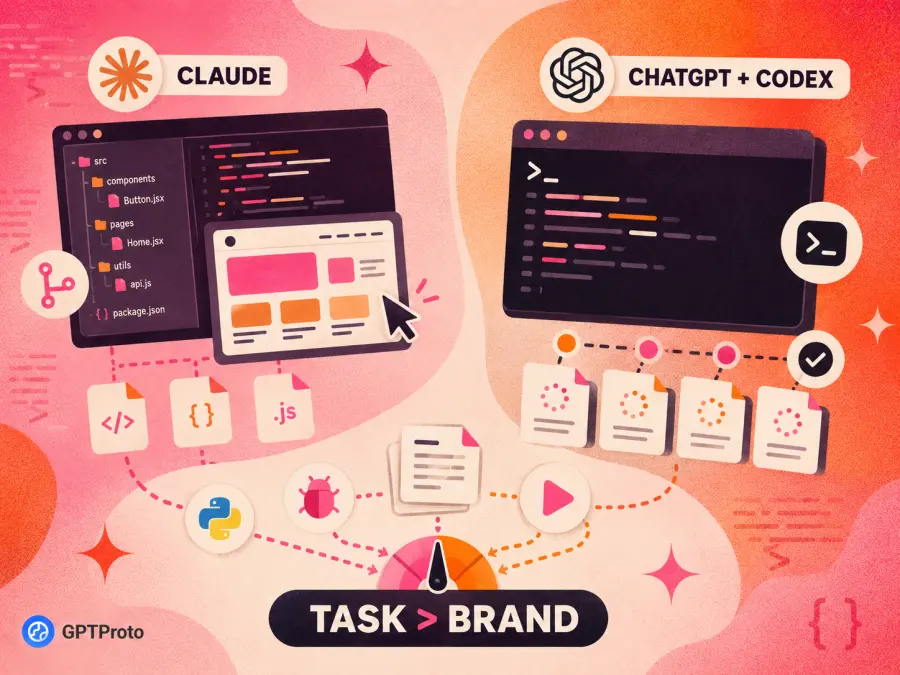
一份實用的 Claude 與 ChatGPT 程式開發比較,也必須區分 Claude Code 與 Codex,以及 Claude API 與 GPT API。本指南採用最新文件、已發表的基準測試,以及已揭露的第三方測試——而非宣稱的 GPTProto 實測。
Claude 與 ChatGPT 用於編程:快速結論
最佳選擇取決於你的編程方式,以及你希望 AI 獨立完成多少任務。
| 編程任務 |
較佳起點 |
原因 |
| 小型函式與指令碼 |
平手 |
提示品質與模型等級通常比供應商更重要 |
| 互動式結對編程 |
Claude Code |
快速回饋與深度終端機自訂 |
| 長時間自主編程工作 |
Codex |
強大的委派審查與背景工作流程 |
| 前端與 UI 生成 |
Claude |
在視覺實作與迭代方面略有品質優勢 |
| 終端機重度除錯 |
ChatGPT/Codex |
GPT-5.6 Sol 在共同的 Terminal-Bench 比較中略占上風 |
| 全儲存庫重構 |
Claude Opus 5 |
強大的程式碼遷移與多檔案工程效能 |
| Python 開發 |
平手 |
贏家會因任務、函式庫、測試與儲存庫存取權而改變 |
| 大型程式碼庫 |
Claude,略占優勢 |
強大的儲存庫推理能力,不過兩個系列現在都支援超大型上下文 |
| 入門級編程訂閱 |
ChatGPT Plus |
其公布的 Codex 額度通常更容易估算與延展 |
| API 部署 |
取決於模型等級 |
每個可接受結果的成本,比最便宜的單次請求更重要 |
若需要緊密協作與大型相互關聯的變更,請選擇 Claude。若你偏好委派與審查,請選擇搭配 Codex 的 ChatGPT。API 團隊應評估個別模型,而不是把任一供應商視為單一固定產品。
我們在比較什麼:Claude、ChatGPT、Claude Code 還是 Codex?
Claude 與 ChatGPT 的差異始於產品介面。
Claude.ai 與 ChatGPT 是通用應用程式,用於解釋、生成與審查程式碼。Claude Code 與 Codex 是編程代理,能檢查儲存庫、編輯檔案、執行命令與測試,並修正失敗。這使任務從「撰寫程式碼」轉變為「產生並驗證可運作的變更」。
API 是另一層:外圍應用程式會選擇檔案與工具、執行命令、傳回錯誤,並決定工作何時完成。因此,一個能在聊天中寫出正確函式的模型,在代理內部的行為可能不同。公平的 Claude AI 與 ChatGPT 比較必須同時評估模型及其工作環境。
目前用於編程的 Claude 與 GPT 模型
最新的 Claude 與 ChatGPT 編程指南必須比較同等級的模型。 Anthropic 建議 大多數複雜工作負載使用 Claude Opus 5,特別嚴苛的長程工作則使用 Fable 5.1。 OpenAI 將 GPT-5.6 Sol 定位為其複雜編程旗艦,並以 Terra 與 Luna 應對較輕量的工作負載。
| 模型 |
最適合的編程用途 |
上下文視窗 |
主要取捨 |
| Claude Fable 5.1 |
嚴苛、長時間執行的代理式編程 |
100 萬個 token |
Claude API 價格最高且延遲較慢 |
| Claude Opus 5 |
複雜編程、遷移與儲存庫工作 |
100 萬個 token |
比中階模型更貴 |
| Claude Sonnet 5 |
低延遲的日常編程 |
100 萬個 token |
最艱難工程任務的上限較低 |
| GPT-5.6 Sol |
複雜編程、代理與終端機工作 |
105 萬個 token |
成本與延遲高於較小的 GPT 模型 |
| GPT-5.6 Terra |
日常開發與正式環境任務 |
105 萬個 token |
在最艱難的工作上不如 Sol |
| GPT-5.6 Luna |
專注的指令碼與大量轉換 |
105 萬個 token |
不適用於最模糊的工程任務 |
你可以在 GPT Proto 上查看目前的 Claude 模型系列 與 OpenAI 模型系列。對於困難的編程工作負載,最相關的個別頁面是 Claude Fable 5.1、Claude Opus 5 與 GPT-5.6 Sol。對於例行正式環境工作,GPT-5.6 Terra 是更經濟的比較基準。
依工作負載匹配模型,然後衡量取得可接受結果所需的總成本。
編程基準測試實際顯示什麼
目前的基準測試證據並不支持任何一方全面勝出。Claude 在某些儲存庫與程式碼生成評估中領先,而 GPT-5.6 Sol 則在共同的終端機基準測試中略占上風。
| 基準測試 |
Claude 結果 |
GPT 結果 |
顯示的意義 |
| Terminal-Bench 2.1 |
Fable 5.1:85.02% |
GPT-5.6 Sol:85.77% |
GPT 在終端機式代理任務中略占優勢 |
| SWE-bench Verified |
Opus 5:97.00% |
GPT-5.6 Sol:96.20% |
兩者在真實儲存庫問題上都極具競爭力 |
| Vibe Code Bench |
Fable 5.1:90.26% |
GPT-5.6 Sol:80.50% |
Claude 在端到端應用程式生成方面展現優勢 |
| LiveCodeBench |
Fable 5.1:90.52% |
— |
程式碼問題解決能力強,但並非完整的產品比較 |
這些結果來自 Vals 對 Claude Fable 5.1、Claude Opus 5 與 GPT-5.6 Sol 的評估,但仍需要背景脈絡。
例如,Fable 5.1 在評估時使用了伺服器端 Claude 備援來處理拒答。Vals 報告指出,當備援輔助的任務被計為失敗時,其 Terminal-Bench 2.1 分數從 85.02% 降至 79.03%。評估設定也不同:Fable 5.1 與 GPT-5.6 Sol 使用了最大努力程度,而 Opus 5 在 Terminal-Bench 中使用高努力程度。
Claude 在程式碼生成、遷移與應用程式建構評估中表現特別出色。GPT-5.6 Sol 在儲存庫問題解決方面緊追在後,並在共同的終端機基準測試中略微領先。這些差距可能會因不同的代理、工具或程式碼庫而反轉。
Claude 與 ChatGPT 的程式碼生成比較
對於小型且明確指定的程式碼生成任務,Claude 與 ChatGPT 的表現非常接近,沒有可靠且通用的勝出者。當提示中包含相關需求時,兩者都能生成函式、資料轉換、API 處理常式、測試案例,以及小型應用程式。
Claude 是進行實作規劃與跨多個檔案協調的良好起點。ChatGPT 在聚焦的腳本、結構化輸出,以及具有精確定義完成標準的任務上同樣實用。在 Codex 中,GPT 模型可以實作並驗證變更,而不只是建議程式碼。
在比較 Claude 或 ChatGPT 用於程式設計時,請給兩者相同的語言與相依套件版本、可編輯檔案、預期行為、相容性限制,以及必要測試。如果程式碼第一次嘗試就能通過,較短的答案可能仍然更好。衡量的是可接受的輸出,而不是回應看起來有多厲害。
Claude 與 ChatGPT 的除錯比較
Claude 與 ChatGPT 的除錯比較並非單一比較。除錯一段貼上的堆疊追蹤,與在陌生儲存庫中找出散布的迴歸問題並不相同。 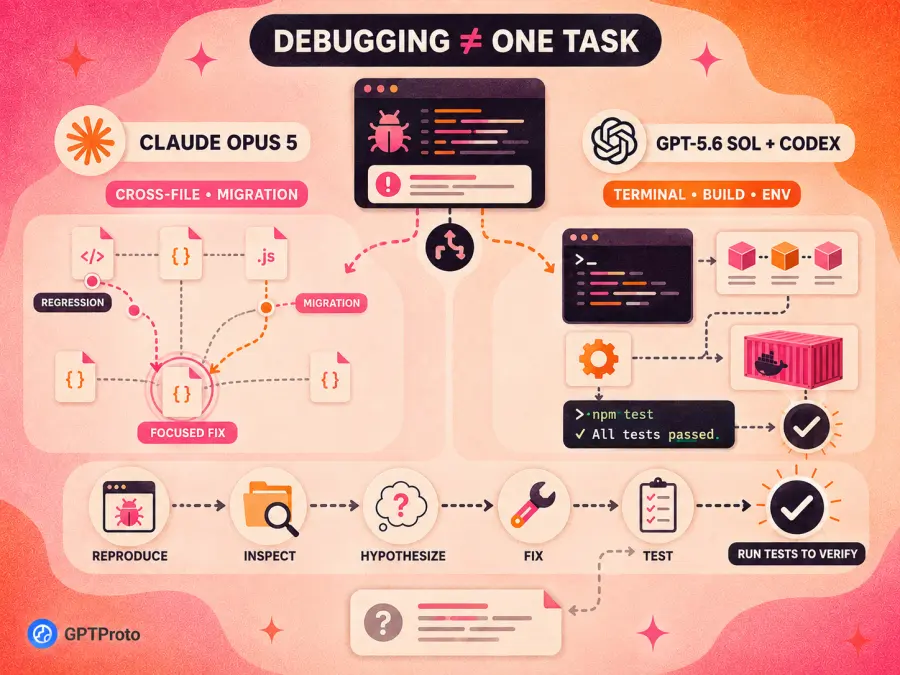
對於單一錯誤訊息,兩款產品通常都能解釋可能原因並提出檢查建議。結果很大程度上取決於使用者是否提供周圍的程式碼、執行階段版本、相依套件版本、輸入資料,以及完整錯誤,而不只是最後一行。
對於終端機、相依套件、建置與環境問題,搭配 Codex 的 GPT-5.6 Sol 是強而有力的起點。它在 Terminal-Bench 上的些微領先顯示,其擅長需要命令列互動的任務,儘管在報告設定下與 Fable 5.1 的差距不到一個百分點。
對於跨檔案的邏輯錯誤、遷移與架構性迴歸,Claude Opus 5 是合理的首選。它在儲存庫與程式碼遷移方面的強勁結果顯示,當修復取決於理解多個模組之間的關係時,它能有效發揮作用。
實務上,除錯品質取決於代理程式能否重現失敗、檢查相關檔案、形成可測試的假設、套用聚焦的修正,並執行受影響的測試。如果它無法存取環境,請將其答案視為假設,而非已驗證的修正。
Claude 與 ChatGPT 的前端程式設計比較
Claude 在前端程式設計上略有品質上的優勢,尤其是當任務涉及將視覺方向轉譯為元件、版面配置、響應式行為、動畫或互動狀態時。關於 Claude Opus 5 的早期報告也強調了全端應用程式建置的改善,包括視覺與互動方面的工作。
這並不代表每個 Claude 輸出都會看起來精緻。當需求簡報含糊時,兩款產品都可能退回使用通用卡片、漸層,以及桌機優先的版面配置。請給它們相同的設計參考、視埠尺寸、框架、品牌規則、互動狀態、無障礙需求,以及驗收標準。
兩個模型都不應只根據原始碼來評判自身的視覺輸出。當代理程式能啟動頁面、檢查螢幕截圖、將其與參考進行比較,並修改 CSS 時,表現會有所提升。Claude 可能提供更好的第一次嘗試;更好的工作流程是包含視覺驗證的流程。
Claude 與 ChatGPT 的 Python 比較
在 Python 方面,Claude 與 ChatGPT 之間沒有通用的勝出者,因為「Python 程式設計」涵蓋的範圍從十行的檔案重新命名腳本,到大型 Django 服務或機器學習管線都有。
| Python 任務 |
較佳起點 |
| 小型自動化腳本 |
Claude 或 ChatGPT 皆可 |
| 資料清理與轉換 |
像 Sonnet 5 或 GPT-5.6 Terra 這類均衡模型 |
| 大型 Python 應用程式重構 |
Claude Opus 5 |
| CLI、套件或環境疑難排解 |
搭配 Codex 的 GPT-5.6 Sol |
| Notebook 長篇說明 |
Claude 通常更容易理解 |
| 重複性的大量轉換 |
驗證後使用較小、較便宜的模型 |
在相同環境中評估兩者,並檢查相依性相容性、邊界案例、檔案處理、型別檢查、lint 檢查,以及 pytest 結果。清楚的說明不如已驗證的行為重要。
Claude 與 ChatGPT 的大型程式碼庫比較
對於許多全儲存庫分析、程式碼遷移與跨多檔案協調變更,Claude 是更強的首選。Claude Opus 5 在程式碼遷移與儲存庫基準測試中表現強勁,而 Fable 5.1 則適用於要求嚴苛、長時間執行的代理式工作。
然而,單靠上下文視窗大小並不能確立這項優勢。目前的 Claude 旗艦模型提供最高 100 萬個 Token 的上下文視窗,而 GPT-5.6 系列則提供約 105 萬個 Token。兩者都大到足以容納大量程式碼,但盲目插入整個儲存庫可能浪費 Token,並掩蓋相關的相依性。
大型程式碼庫的效能取決於代理程式能否掌握儲存庫結構、定位相關檔案、遵循專案指示、保留介面,並驗證其變更。有效的上下文選擇與壓縮,可能比宣稱的最大值更重要。
當任務涉及大規模遷移、架構推理,或跨相互連結模組的協調變更時,請選擇 Claude Opus 5。當任務定義明確、大量使用終端機,且適合較長時間的自主執行時,請選擇搭配 Codex 的 GPT-5.6 Sol。無論選擇哪一種,請將非常大型的變更拆分為可驗證的階段,並要求每個界線都有測試。
Claude Code 與 Codex:代理工具可能和模型本身一樣重要
即使不考慮預設模型,Claude Code 和 Codex 在工作流程上也有所不同。
| 面向 |
Claude Code |
Codex |
| 典型工作流程 |
互動式終端機開發 |
委派、執行與審查 |
| 儲存庫指示 |
CLAUDE.md |
AGENTS.md |
| 自訂化 |
深入的 hooks、skills 與代理設定 |
更多受管理的預設值與沙箱控制 |
| 回饋風格 |
快速且互動性高 |
更審慎且自主 |
| 適合對象 |
持續密切參與的開發者 |
背景工作、審查與平行任務 |
| 主要取捨 |
複雜工作階段可能很快耗盡額度 |
部分任務需要更長時間才能完成 |
Composio 的一項實用第三方測試有助於將外層工具與底層模型區分開來。評估者讓同一個 DeepSeek V4 Flash 模型分別透過 Claude Code 和 Codex 執行,使用 30 個相同的多應用程式任務、相同的託管 MCP 設定、最高推理能力,以及每項任務 900 秒的限制。
| 結果 |
Claude Code |
Codex |
| 通過任務 |
16/30 |
16/30 |
| 完成時間中位數 |
122.7 秒 |
245.0 秒 |
| 工具呼叫次數 |
358 |
448 |
| 預估總成本 |
$3.116 |
$1.294 |
| 每次成功成本 |
$0.195 |
$0.081 |
這兩個外層工具達到了相同的通過數量。Claude Code 的完成時間中位數約為一半,而 Codex 的成本約低 58%。完整的 Composio 比較支持一個有限的結論:在此設定中,Claude Code 提供更快的回饋,而 Codex 則能讓預算支撐更久。這並不能證明 Claude 模型更聰明,因為測試在兩個工具中使用了同一個第三方模型。
Claude Pro 使用率與 ChatGPT Pro 的比較
Claude Pro 使用率與 ChatGPT Pro 的比較經常被以誤導性的固定訊息次數來描述。兩家供應商都會根據所選模型、上下文長度、推理投入程度、工具與任務複雜度而改變消耗量。
目前最接近的價格比較如下:
| 每月價格 |
Anthropic 方案 |
OpenAI 方案 |
| $20 |
Claude Pro |
ChatGPT Plus |
| $100 |
Claude Max 5x |
ChatGPT Pro 5x |
| $200 |
Claude Max 20x |
ChatGPT Pro 20x |
Claude 用量 會在 Claude.ai、Claude Desktop 與 Claude Code 之間共用。其方案結合五小時工作階段限制與每週限制;使用者可以等待重置、升級,或啟用另行計費的使用額度。
ChatGPT Work 與 Codex 也會共用適用的使用額度。OpenAI 會公布每五小時視窗中本機 Codex 訊息的大略估計。對 GPT-5.6 Sol 而言,目前範圍約為 Plus 上的 10–100、Pro 5x 上的 50–500,以及 Pro 20x 上的 200–2,000。雲端任務可能比本機訊息消耗更多,而兩個看似相似的任務也可能使用不同用量。
這些是規劃範圍,並非保證。一項漫長的儲存庫任務可能比數次聚焦編輯消耗更多容量。在 $20 方案中,ChatGPT Plus 通常是持續使用代理時較安全的起點;密集使用 Claude Code 的使用者可能需要 Max 容量或使用額度。在 $100 與 $200 方案中,偏好的工作流程比表面上的倍數更重要。
給開發者的 Claude 與 ChatGPT API 比較
訂閱方案是為在 Claude 或 ChatGPT 產品內工作的人而設計。開發應用程式的開發者應改為比較 API 模型與用量計費。
| 工作負載 |
Claude 選項 |
GPT 選項 |
| 最困難的長程代理工作 |
Claude Fable 5.1 |
GPT-5.6 Sol |
| 複雜的日常程式開發 |
Claude Opus 5 |
GPT-5.6 Sol |
| 平衡的生產工作負載 |
Claude Sonnet 5 |
GPT-5.6 Terra |
| 大量且聚焦的任務 |
Claude Haiku 4.5 |
GPT-5.6 Luna |
官方 token 價格有助於選擇初始模型,但無法揭示程式開發工作流程的完整成本。能力更強的模型可能以較少重試次數完成。較便宜的模型對重複性任務可能很經濟,但如果工程師必須反覆修復其輸出,就會變得昂貴。
在你自己的任務集上,追蹤首次通過完成率、通過的測試、重試次數、人工介入、失敗的工具呼叫、總 token 數、時間,以及每個可接受結果的成本。勝出者可能因階段而異:Claude 可能負責儲存庫分析,GPT 負責大量使用終端機的實作,而較小的模型則處理重複性轉換。
你可以同時使用 Claude 與 GPT 模型嗎?
你不需要為每項程式開發工作負載只選一個供應商。應用程式可以根據複雜度、延遲、成本或涉及的工程工作類型來路由任務。
GPT Proto 透過單一 API 金鑰與共用餘額,提供對 Claude 與 GPT 模型系列的存取。這讓你能更輕鬆地將相同的評估任務傳送給兩家供應商、比較品質與成本,並在不需要維護個別供應商計費帳戶的情況下切換模型。
這並不表示 GPT Proto 金鑰會取代每個原生程式開發用戶端中的 Claude 或 ChatGPT 訂閱。開發者可以從自己的應用程式呼叫支援的 Claude 與 GPT API;用戶端相容性仍取決於自訂端點與請求結構支援。
用於程式開發該選 Claude 還是 ChatGPT:最終決定
如果你大部分時間都在互動式終端機工作流程中度過、重視前端實作,或需要模型在龐大且互相關聯的儲存庫中進行推理,請選擇 Claude。 Claude Opus 5 是大多數複雜開發工作的合理起點,而 Fable 5.1 則適用於最困難的長程任務。
如果你偏好委派與審查工作流程、大量使用終端機的自主任務,或希望程式開發功能整合在更廣泛的 ChatGPT 訂閱中,請選擇搭配 Codex 的 ChatGPT。 GPT-5.6 Sol 是處理困難工作的最強 GPT 選項,而 Terra 與 Luna 則可為更明確且重複性更高的任務降低成本。
就 API 開發而言,請用你自己的驗收測試來決定 Claude 或 ChatGPT 的程式開發選擇。針對可比較的等級執行相同任務、工具與測試,然後衡量成功結果、修正次數、延遲與成本。公開證據顯示兩個極具競爭力的系列——而不是一個永遠的冠軍。