LLM APIプロバイダーとは?
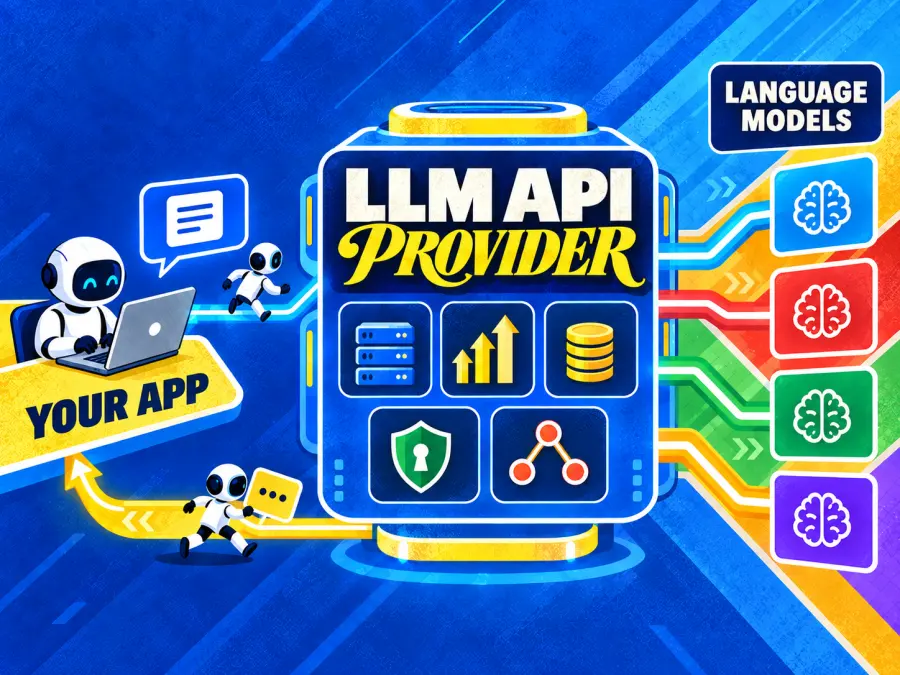
LLM APIプロバイダーは、開発者が基盤となる推論インフラストラクチャをプロビジョニングや運用することなく、言語モデルへのホスト型アクセスを提供します。プロバイダーは、デプロイメント、スケーリング、メータリング、認証、そしてプラットフォームによってはルーティング、オブザーバビリティ、安全管理、ファインチューニングなどを処理します。
このラベルは、いくつかの異なるビジネスを包含しています:
ファーストパーティモデルAPI:モデルラボが自社のフロンティアモデルを公開するなど、同じ企業が構築したモデルを提供します。
マルチモデルAPIプロバイダー:複数の作成者のモデルを1つのアカウント、多くの場合1つのAPI規約の下で提供します。
ルーターおよびゲートウェイ:価格、可用性、レイテンシ、またはユーザー定義のルールに基づいて、複数の基盤ホストのいずれかにリクエストを送信します。
マネージドクラウドAIプラットフォーム:モデルへのアクセスと、エンタープライズID、プライベートネットワーキング、ガバナンス、その他のクラウドサービスを組み合わせます。
推論スペシャリスト:選択されたオープンウェイトモデルを、速度、コスト、ファインチューニング、または専用デプロイメント向けに最適化します。
これらのカテゴリは重複しています。重要なのは単に「そのプロバイダーがそのモデルをリストしているか」ではなく、「アプリケーションが必要とするプロトコル、経済性、信頼性、制御を備えてそのモデルを提供できるか」という点です。
最高のLLM APIプロバイダーをランク付けした方法
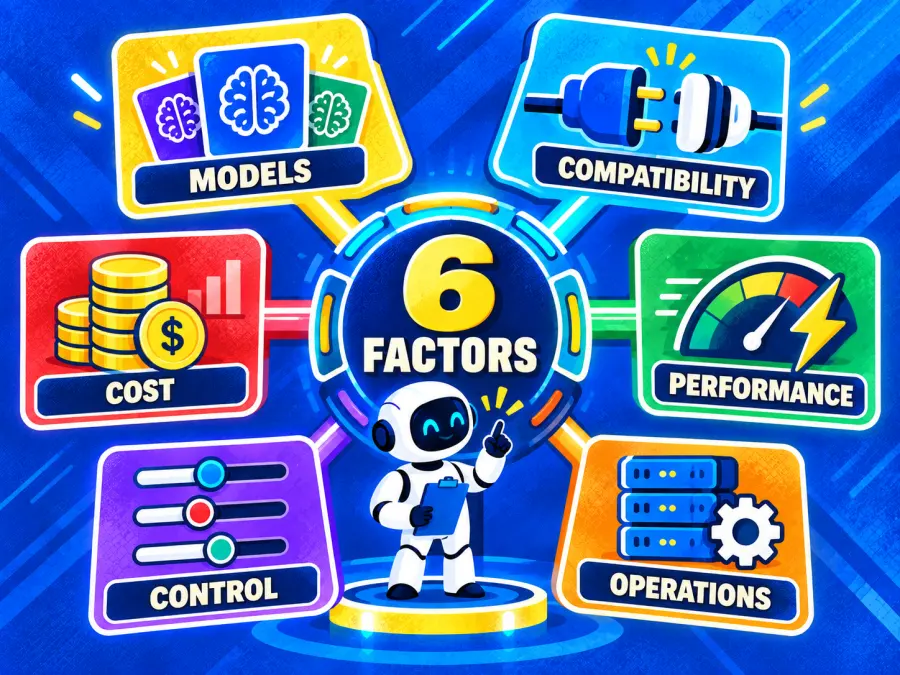
各プロバイダーを6つの要素グループで評価しました:
モデルの選択肢: 単なるカタログの数ではなく、有用なモデルの数と多様性
互換性: APIの一貫性、ツール、構造化出力、ストリーミング
実質コスト: トークン料金、プラットフォーム手数料、キャッシュ、バッチ割引、再試行
パフォーマンス: 最初のトークンまでの時間、スループット、テールレイテンシ、容量の挙動
制御: プロバイダーの固定、フォールバックルール、エラーセマンティクス、モデルのライフサイクル
運用: ID、リージョン、ネットワーキング、ガバナンス、ドキュメント、移行の容易さ
すべての要素で勝るプロバイダーはありません。当社の順位付けは、幅広いモデルへのアクセスを重視するチームにとって最適な汎用プラットフォームを優先し、その上で、より専門的なプロバイダーが適しているケースを特定しています。
LLM APIプロバイダー比較
| 順位 |
プロバイダー |
最適な用途 |
カタログの概要 |
APIアプローチ |
主なトレードオフ |
| 1 |
GPT Proto |
LLMおよびマルチモーダルモデル全体で単一のAPIキーを利用可能 |
レビュー時点で合計232モデル(うちテキストモデル124) |
対応LLM向けのOpenAI互換チャットエンドポイント、およびその他のモダリティ向けのタスク特化型API |
ハイパースケーラーと比較してエンタープライズエコシステムが小規模な新しいプラットフォーム |
| 2 |
OpenRouter |
LLMの選択肢を最大化し、プロバイダー間ルーティングを実現 |
80以上のプロバイダーによる500以上のモデル |
プロバイダーの優先順位付けとフォールバックを備えたOpenAI互換ルーティングAPI |
ルーティングにより、キャッシュ、パフォーマンスの一貫性、コスト帰属が複雑化する可能性がある |
| 3 |
Amazon Bedrock |
AWSガバナンスとエンタープライズ導入 |
Bedrockマーケットプレイスを通じて100以上のモデルを提供 |
Converse APIを含む一貫したマネージドインターフェース |
AWSの概念、リージョン制限、モデル固有の動作により複雑性が増す |
| 4 |
Together AI |
オープンウェイトモデル、ファインチューニング、実験 |
広範なオープンモデルカタログ |
OpenAI互換のサーバーレスAPIに加え、ファインチューニングや専用オプションを提供 |
モデルによって機能サポートが異なる |
| 5 |
Fireworks AI |
本番環境でのオープンモデル推論 |
100以上の利用可能なモデル |
サーバーレスおよび専用デプロイメントを備えたOpenAI互換API |
オープンモデルのワークロードに最適化されている |
| 6 |
GroqCloud |
厳選されたカタログによる非常に高速な生成 |
小規模で厳選されたモデルセレクション |
主にOpenAI互換のAPI |
選択肢が狭く、互換性にギャップがある場合がある |
カタログの合計数は目安であり、直接比較できるものではありません。企業によってモデルバージョン、モダリティ、プロバイダー、ファインチューニングのカウント方法が異なるためです。また、可用性は年次リストよりも速いペースで変化します。
1. GPT Proto — 総合的に最も優れたマルチモデルLLM APIプロバイダー
GPT Protoは、テキスト生成にとどまらない拡張性を持つ単一のアカウントとAPIキーを求める開発者にとって、第一の選択肢です。レビュー時点で、同社のカタログには124のテキストモデルに加え、画像、動画、音声オプションを含む232のモデルが掲載されていました。
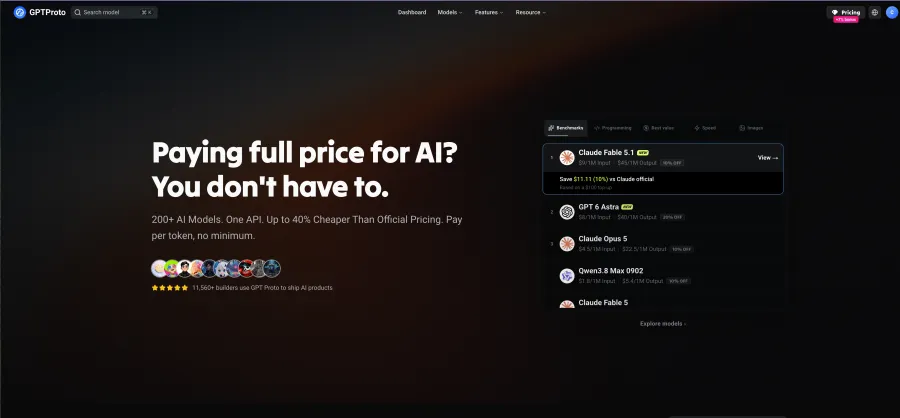
サポートされているLLMに対して、GPT ProtoはOpenAI互換のチャット補完パターンを提供しています。開発者はテキストモデルカタログを閲覧し、モデル固有の料金を確認し、統合前にモデルをテストすることができます。
各モデルページには、入力および出力料金が公開されています。例えば、GLM-5.3 APIは、レビュー時点で入力トークン100万あたり1.26ドル、出力トークン100万あたり3.96ドルと記載されており、これはZ.aiの直接料金よりも10%低い価格でした。価格は変更される可能性があるため、モデルページを確認してください。
GPT Protoがすべての企業にとってデフォルトの勝者となるわけではありません。Bedrockにはより強固なAWSガバナンスがあり、OpenRouterにはより広範なルーティングLLMカタログがあり、特定のオープンモデルにおいては専門プロバイダーの方が優れたパフォーマンスを発揮する可能性があります。GPT Protoの強みは、モデルファミリーとモダリティ全体にわたる実用的な幅広さにあります。
最適: SaaS製品、AIエージェンシー、本番環境へ移行するプロトタイプ、およびマルチモーダルアプリケーション。
注意点: OpenAI互換性はモデルおよびエンドポイント固有のものとして扱ってください。画像および動画モデルは、LLMチャット形式ではなく、タスク固有のリクエストボディを使用します。
2. OpenRouter — LLMカタログの幅広さとルーティングに最適
カタログの幅広さが最優先事項である場合、OpenRouterが最も強力な選択肢となります。公開されている製品は80以上のプロバイダーにまたがる500以上のモデルを網羅しています。単一のエンドポイントで基盤となるホスト間でリクエストをルーティングでき、開発者はプロバイダーの優先順位設定、フォールバックの許可、または自動選択を利用できます。
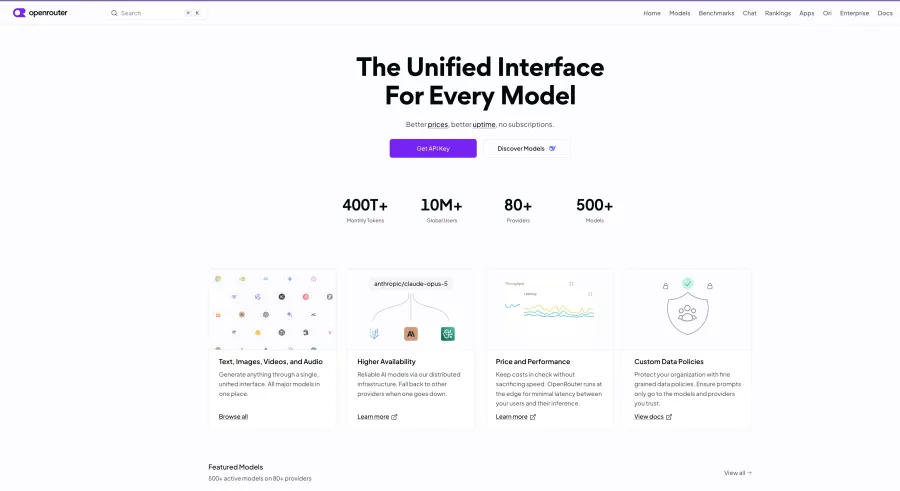
トレードオフとして、ルーティングがアプリケーションの動作の一部となります。同じモデル名でも、異なるホスト、ハードウェアスタック、またはモデルバリアントで実行される可能性があります。これにより、レイテンシ、サポートされるコンテキスト、エラー処理、プロンプトキャッシュの経済性が変化する可能性があります。また、OpenRouterは標準の従量課金プランのクレジット購入に対して5.5%の手数料を課しており、これは総コスト計算に含める必要があります。
最近の開発者による議論では、トラフィックがプロバイダー間を移動する際にキャッシュヒットの一貫性が低下するという報告がありました。別のコミュニティ分析では、数千件のターンが調査されました。これらの報告は逸話的なものですが、長いプロンプトを繰り返すチームは、デフォルトのルーティングに対して、プロバイダー固定およびフォールバック無効の設定をテストすべきです。
最適: モデルの発見、広範なLLMアクセス、フォールバックルーティング、およびリクエスト時にプロバイダーを選択することでメリットが得られるアプリケーション。
注意点: プラットフォーム手数料、プロバイダーレベルの違い、キャッシュミス、および自動フォールバックと決定論的なパフォーマンスの間の緊張関係。
3. Amazon Bedrock — AWS中心のエンタープライズに最適
Amazon Bedrockは、すでにAWS環境で運用している組織にとって、最も魅力的な選択肢です。Bedrock Marketplaceでは100種類以上のモデルへのアクセスが提供されており、Agents、Knowledge Bases、Guardrailsといったサービスが、モデルの推論をより大規模なマネージドスタックに接続します。
その中心的な価値は、モデルの数そのものではなくガバナンスにあります。AWSの顧客は、使い慣れたID管理、ログ記録、リージョン設定、ネットワーク、調達、セキュリティのパターンに合わせてモデルへのアクセスを調整できます。Converse APIは、サポートされているモデルに対してより一貫したメッセージベースのインターフェースを提供し、ベンダー間での統合の差異を軽減します。また、AWSは、このAPIを通じて送信されたコンテンツは保存されないと明言しており、これは企業による審査において重要な考慮事項となります。
一貫性があるといっても、すべてのモデルが同じように動作するわけではありません。可用性はリージョンによって異なり、機能のサポート状況も異なり、AWSアカウントやサービス制限といった概念が作業を複雑にする場合があります。APIキーとチャットエンドポイントのみを必要とする小規模なチームにとって、これらのコストはあまり合理的ではありません。
最適: 規制の厳しいワークロード、確立されたAWSチーム、および既存のクラウドガバナンスの境界内でモデルへのアクセスを求める企業。
注意点: リージョン固有の可用性、モデル固有の機能、サービス割り当て、およびクラウドアーキテクチャのオーバーヘッド。
4. Together AI — オープンウェイトモデルの実験とファインチューニングに最適
Together AIは、主にオープンウェイトモデルを扱うチームにとって強力なLLMモデルAPIプロバイダーです。そのサーバーレスサービスは、レプリカのプロビジョニングや最低デプロイコストのコミットメントなしで、トークン単位の料金体系を採用しています。また、このプラットフォームはファインチューニングと専用エンドポイントをサポートしており、迅速な評価から、より制御されたデプロイへの移行パスをチームに提供します。
OpenAI互換のインターフェースにより、標準的なチャットワークロードの移行負荷が軽減されます。Togetherは、関数呼び出しや構造化出力などの機能に対する能力指標も公開しています。これらの指標は、カタログ全体で機能サポートが均一ではないため重要です。単純な生成には優れているモデルでも、厳密なJSONや信頼性の高いツール呼び出しに依存するエージェントワークフローを満たせない可能性があるからです。
Togetherは、オープンモデルをファインチューニングし、ホストされたエンドポイントでテストし、後に専用サーバーを選択したいと考えるチームに対して、単なるルーター以上の深みを提供します。チームは依然として適切なモデル、提供モード、機能セットを選択する必要があります。これらのデプロイの選択肢を評価する別の方法として、提供モデルを決定する前にTogether AIの代替手段を比較検討してください。
最適: オープンモデルの研究、ファインチューニング、評価、およびサーバーレスから専用推論へ移行する可能性のあるチーム。
注意点: ツール、構造化出力、コンテキスト、および提供モードに対するモデルごとのサポート状況。
5. Fireworks AI — 本番環境でのオープンモデルデプロイに最適
Fireworks AIは、本番環境でのオープンモデルの提供に注力しています。100種類以上の利用可能なモデルをリストアップしており、サーバーレスアクセスと専用デプロイメントの両方を提供しています。そのAPIインターフェースにはOpenAI互換のChat CompletionsやResponses形式が含まれており、一般的なLLMアプリケーションに必要なコード変更を削減できます。
このプラットフォームは、チームが最初はトークン単位のサーバーレス推論から始め、後に安定したワークロードをより分離されたキャパシティへ移行させたい場合に特に適しています。バッチ推論は、待機可能なワークロードに対してサーバーレス料金の50%で提供されており、オフラインでのエンリッチメント、分類、要約、データ処理ジョブのための明確な最適化パスを構築できます。
独立した推論ベンチマークも、特定のプロバイダーに「速度」のラベルを永続的に割り当てるべきではない理由を示しています。パフォーマンスはモデル、リージョン、負荷、測定方法によって異なります。あるモデルの結果をプラットフォーム全体に当てはめるのではなく、現実的なプロンプトを使用して、特定のプロバイダーとモデルの組み合わせをテストしてください。
最適: 本番環境でのオープンモデル推論、専用キャパシティが必要となる可能性のあるワークロード、および遅延を許容できるバッチジョブ。
注意点: モデルごとのパフォーマンスのばらつき、およびサーバーレス、バッチ、専用デプロイメントのどれがワークロードに適しているかの判断。
6. GroqCloud — 低遅延テキスト生成に最適
GroqCloudはこのリストにおけるスペシャリストです。その特化したカタログはGroqの推論アーキテクチャ上で動作し、公開されている測定結果では、サポートされているモデルがトークン生成において常に最速クラスに位置しています。そのため、インタラクティブなエージェント、音声パイプライン、コーディングツールなど、ユーザーがわずかな遅延も感じ取ってしまうような体験において魅力的です。
Groqは自社のAPIを「ほぼOpenAI互換」と説明していますが、この限定的な表現が重要です。ドキュメントでは、logprobs、logit_bias、top_logprobs、messages[].nameなど、サポートされていないフィールドが明記されており、nは1に設定する必要があります。Flex処理ではより高いレート制限が可能ですが、キャパシティが利用できない場合には498 capacity_exceededレスポンスが返されることがあります。また、プレビューモデルは予告なく提供終了となる可能性があります。
サポートされているモデルがタスクに適合し、遅延が製品価値に直結する場合にGroqCloudを選択してください。フレームワークがすでにOpenAIアダプターを持っているという理由だけで選択してはいけません。
最適: リアルタイムアシスタント、エージェントループ、音声アプリケーション、およびサポートされているモデルにおける遅延に敏感な生成タスク。
注意点: モデルの選択肢が少ないこと、サポートされていないリクエストフィールド、キャパシティの挙動、およびプレビューモデルのライフサイクルリスク。
なぜ同じLLMでもプロバイダーによって挙動が異なるのか
2026年の測定調査「同じモデルが同じサービスではないとき(When Is the Same Model Not the Same Service?)」では、ホストされたモデルはプロバイダー固有のサービスオブジェクトとして扱うべきであると論じています。観測される挙動には、モデル名だけでなく、モデルのバリアント、プロトコル、コンテキスト容量、価格、遅延、スループット、信頼性、タスクの実現可能性が含まれます。
この区別により、開発者はより優れたLLM APIプロバイダーの比較フレームワークを得ることができます:
モデルの識別子とバージョン
2つのエンドポイントは、同じモデルファミリーを表示していても、異なるチェックポイント、量子化、精度レベル、または更新スケジュールで提供されている可能性があります。モデル識別子がバージョン固定されているか、またアップストリームのモデルが変更された場合に何が起こるかを確認してください。
ベースURLを超えた互換性
「OpenAI互換」とは、多くの場合、そのプロバイダーが一般的なチャット補完リクエストを受け入れることを意味します。しかし、すべてのパラメーター、ツールスキーマ、ストリーミングイベント、レスポンスフィールド、またはエラーコードのサポートを保証するものではありません。アプリケーションで実際に使用する機能に対してコントラクトテストを作成してください。
ルーティングとキャッシュの安定性
自動ルーティングは可用性を向上させますが、プロバイダーの切り替えによってプロンプトキャッシュの再利用率が低下する可能性があります。繰り返し発生するコンテキストが入力コストの大半を占める場合は、ルーティングされたトラフィックに対して固定ホストをテストしてください。100万トークンあたりの公称価格ではなく、タスク完了あたりの実効コストを比較しましょう。
レイテンシ、スループット、およびエラー
分布全体を測定してください。P50レイテンシは一般的な呼び出しを表しますが、P95やP99は遅延のテール部分を明らかにします。最初のトークンまでの時間(TTFT)を生成速度とは別に追跡してください。レート制限、タイムアウト、容量エラー、および再試行の成功率を記録しましょう。頻繁な再試行が必要な安価なエンドポイントは、計算リソースとユーザーの忍耐の両面で高くつく可能性があるためです。
同じ調査で、メリットを示す有用な指標が得られています。測定されたケースでは、ルーティングによってQwen3-32Bワークロードのコストが37.8%削減され、プロバイダーの選択によってDeepSeek-V3.2ワークロードのスループットが約90%向上しました。これらの結果はワークロード固有のものですが、プロバイダー層を個別に評価する価値がある理由を示しています。
どのLLM APIプロバイダーを選ぶべきか?
ランキングをショートリストとして活用し、ワークロードに応じて決定してください:
1つのキーで幅広いテキストおよびメディアモデルにアクセスするには、GPT Protoを選択してください。
LLMの選択肢とプロバイダーのルーティングを最大化するには、OpenRouterを選択してください。
AWSのガバナンスとマネージドサービスを利用するには、Amazon Bedrockを選択してください。
オープンモデルの実験とファインチューニングには、Together AIを選択してください。
本番環境でのオープンモデルデプロイには、Fireworks AIを選択してください。
サポートされているモデルでレイテンシに敏感な生成を行うには、GroqCloudを選択してください。
特定のプロプライエタリモデルが安定した依存関係にある場合は、比較対象にファーストパーティのAPIを含めてください。それ以外の場合は、短いデモプロンプトだけでなく、キャッシュされた会話、ツール呼び出し、構造化されたレスポンス、ピーク時の同時実行数、および障害発生時を想定して、少なくとも2つのプロバイダーをテストしてください。
1つのGPT Proto APIキーで複数のLLMにアクセスする方法
GPT Protoのテキストモデルカタログから開始し、モデルページを開いて、モデルのこのモデルを試すオプションを使用して、統合前に出力を確認してください。APIキーを作成した後、標準のチャット補完リクエストを送信します:
export GPTPROTO_API_KEY="replace_with_your_key"

curl https://gptproto.com/v1/chat/completions \
  -H "Authorization: Bearer $GPTPROTO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.3",
    "messages": [
      {
        "role": "user",
        "content": "Return a JSON comparison of two caching strategies."
      }
    ]
  }'
別の互換LLMを使用する場合は、modelの値を、そのモデルページに表示されている識別子に変更してください。モデルの選択はアプリケーション全体にハードコーディングするのではなく、設定ファイルで管理し、切り替える前に機能のサポート状況を検証してください。画像、動画、音声モデルは、それぞれのタスク固有のエンドポイントとリクエストボディを使用します。
最終結論
最適なLLM APIプロバイダーとは、適切なモデルを貴社のワークロードにとって信頼できるサービスへと昇華させてくれるプロバイダーのことです。モデルの品質が性能の上限を決定しますが、ユーザーが実際に体験する価値を左右するのは、互換性、キャッシュの挙動、レイテンシ、エラーハンドリング、ライフサイクルポリシー、そして総コストです。
日常的な幅広い用途において、今回比較した6つのプロバイダーの中で最もバランスの取れた出発点となるのはGPT Protoです。単一のキー、豊富なテキストモデルのカタログ、透明性の高いモデルページ、そして他の生成メディアAPIへのアクセスがその理由です。LLMのルーティングの幅広さではOpenRouterが、AWSのエンタープライズ管理機能ではAmazon Bedrockが、オープンモデルのライフサイクルの各段階においてはTogether AIとFireworks AIが、そして速度重視の推論ではGroqCloudがそれぞれ強みを発揮します。
貴社の運用ニーズに合致するプロバイダーのカテゴリーを絞り込み、その上で「プロバイダー・モデル・タスク」の組み合わせを正確にベンチマークしてください。2026年現在、選択すべき価値の単位は、ロゴやモデル名単体ではなく、そのサービス全体の組み合わせにあります。